

GitHub Actions与Checks同时排队失败时,如何区分平台故障?
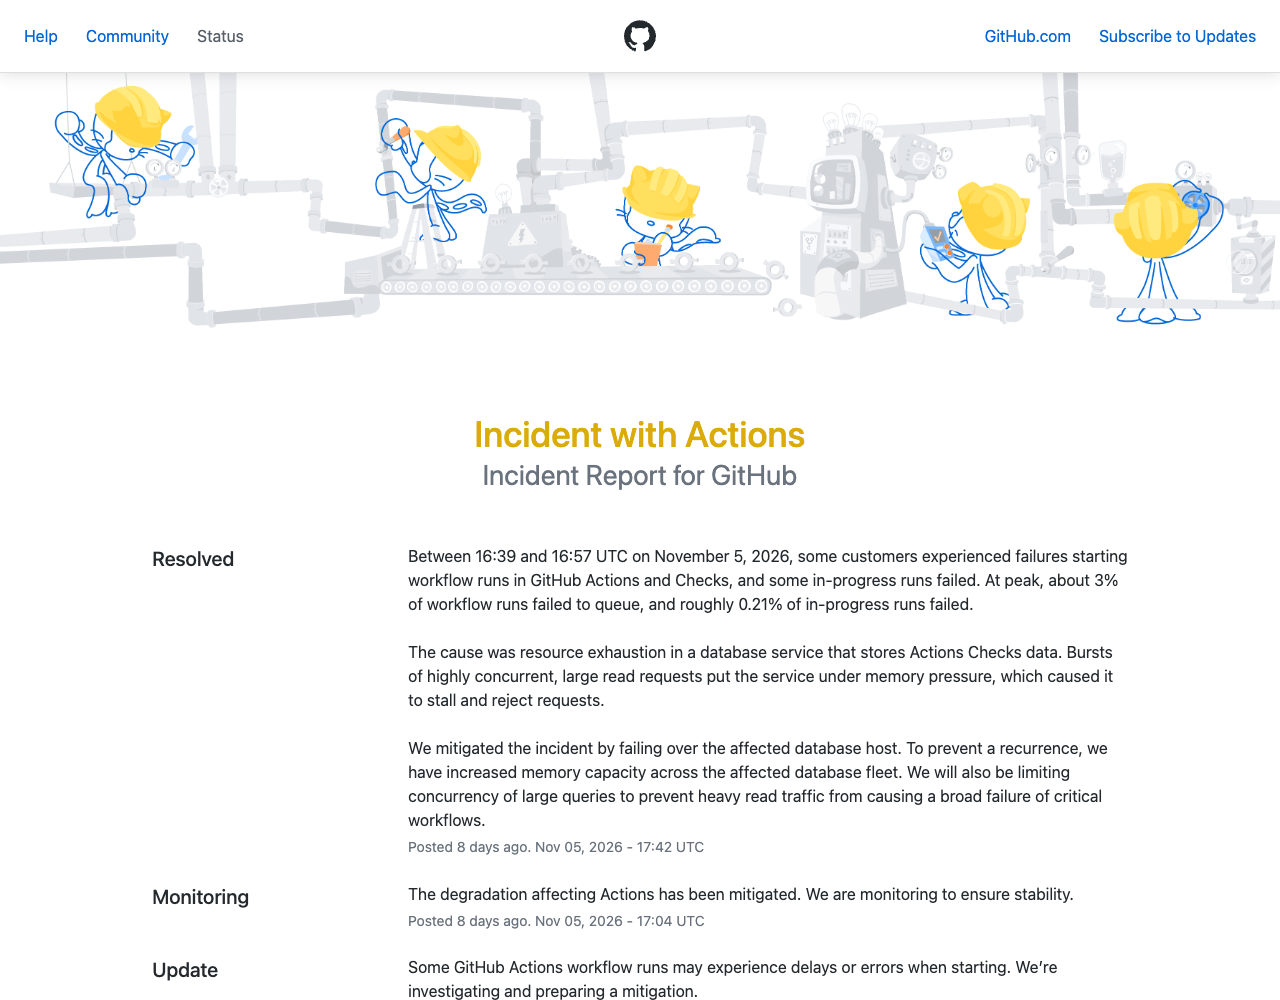
GitHub对11月5日Actions与Checks事件的新增复盘指出:数据库服务在高并发大读请求下耗尽资源,导致部分运行无法排队或执行失败。检查类似问题时,先比对平台事件时间与失败状态,再决定是否重试自己的工作流。
GitHub对11月5日Actions与Checks事件的新增复盘指出:数据库服务在高并发大读请求下耗尽资源,导致部分运行无法排队或执行失败。检查类似问题时,先比对平台事件时间与失败状态,再决定是否重试自己的工作流。
事件影响哪些运行状态
当次故障发生于11月5日16:39至16:57 UTC,即北京时间11月6日00:39至00:57。峰值约3%的工作流无法排队,约0.21%的执行中运行失败。
无法排队与执行后失败分别对应不同阶段。应核对具体运行是否已经生成、检查状态是否更新,以及是否已有作业开始执行,不把所有等待状态统一归为runner不足。
平台根因与应用错误怎样区分
本次复盘描述的根因是保存Actions Checks数据的数据库服务承受高并发大型读取,出现内存压力、停顿并拒绝请求。GitHub通过切换受影响数据库主机缓解问题。
如果自己的失败时间落在公告范围内,可结合平台状态与运行记录判断是否相关;若时间不符,仍需检查工作流权限、依赖、runner日志及具体错误,不能用历史事故解释所有后续问题。
恢复后重试应检查什么
先确认平台已恢复,再检查失败运行是否执行过会产生外部副作用的步骤。允许重试的流程按既有方法重新运行,保留原失败记录与日志,便于比较。
GitHub说明已增加相关数据库集群内存,并将限制大型查询的并发,避免繁重读取引发更广泛故障。这些是该事故的处置与改进措施,不是用户可以在工作流文件中设置的参数。
GitHub对11月9日Actions事件的新增复盘说明:数据库迁移后,新区域容量与速率限制不足导致请求被拒,部分运行在服务恢复后仍占用并发。排查自己的工作流时,应把平台状态、运行状态与应用代码错误分开核对。
GitHub Public monitoring支持为单条告警生成独立链接。在企业视图点击告警编号即可打开、收藏或分享对应URL,接收者仍需具备访问权限。
GitHub Secret Scanning新增cloudflare_access_service_token检测类型,可帮助发现仓库中的Cloudflare服务令牌。检测、向签发方报告、生成用户告警和实际吊销是不同动作;本篇说明新检测器与开发团队处置边界,不将功能发布写成已发生泄露。
GitHub公告Windows与Linux托管运行器将于2026年12月8日结束ARM32作业执行支持,包含原生AArch32用户空间执行。原因与Node 20支持结束及Node 24不支持ARM32有关;本篇说明受影响范围、迁移检查与尚未说明的截止时刻。
GitHub已于2026年11月13日05:43:56北京时间关闭邮件投递事件,确认其系统内邮件处理影响消除。紧邻进展仍提示受影响上游邮箱供应商可能延迟;本篇区分平台恢复、收件状态和登录验证流程,避免把事件关闭等同每封邮件送达。
GitHub已于2026年11月13日03:33:54北京时间确认Webhooks API事件解决,先前约1%客户流量出现超时与错误。本文说明恢复时间线、CI与智能体工作流的投递核对方法,以及尚未公开的根因边界。
GitHub邮件投递事件已进入监控,登录和邮箱验证出现恢复,但部分上游邮件供应商托管的邮箱仍可能延迟。截至2026年11月13日05:18北京时间,官方未宣布完全恢复;本文说明受影响流程、最新范围与登录排查边界。
GitHub更新11月9日Webhooks与Actions事故复盘,确认退化的Kafka broker导致队列延迟,部分Actions事件因超过30分钟而未启动。新增进展是根因、影响数据和告警改进;原故障已结束,不能把复盘更新时间写成今天再次宕机。
GitHub的Git操作与Pull Requests事件已于北京时间11月11日01:55确认恢复,PR触发的Actions曾延迟。团队应按目标提交核对PR检查和运行日志,再选择重跑范围,注意30天窗口、原提交和原触发者权限等限制。
GitHub将于12月8日起暂停多数一年无活动仓库的Dependabot告警,旧告警归档后仍可恢复。推送或手动启用会重启计时,强制安全配置与企业策略存在豁免,GitHub Enterprise Server不受此次规则影响。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



