

C++内存模型教学:资源与方法解析
C++内存模型的核心在于定义多线程下操作的可见性与顺序性,其关键概念包括Happens-Before关系、内存顺序(如seq_cst、acquire-release、relaxed)以及数据竞争的规避;通过共享计数器、生产者-消费者模型、双重检查锁定等实践案例,结合ThreadSanitizer、汇编观察和调试工具,能有效帮助学习者建立直观理解,掌握正确高效的并发编程方法。
C++内存模型的核心在于定义多线程下操作的可见性与顺序性,其关键概念包括Happens-Before关系、内存顺序(如seq_cst、acquire-release、relaxed)以及数据竞争的规避;通过共享计数器、生产者-消费者模型、双重检查锁定等实践案例,结合Thread Sanitizer、汇编观察和调试工具,能有效帮助学习者建立直观理解,掌握正确高效的并发编程方法。
C++内存模型的教育,在我看来,核心在于帮助学习者构建起对并发世界中数据可见性和操作顺序的直观理解。这不仅仅是记忆一些规则,更是一种思维模式的转变,即从单线程的“一切按部就班”到多线程的“一切皆有可能”的认知飞跃。有效的学习资源和教学方法,理应聚焦于概念的深度剖析、常见陷阱的揭示以及通过动手实践来固化这种直觉。
C++内存模型是现代并发编程的基石,但其抽象性和与底层硬件、编译器行为的紧密关联,使得它成为许多开发者,特别是初学者感到头疼的领域。要真正掌握它,我们不能仅仅停留在理论层面,必须深入其工作原理,并通过实践去验证和理解。
首先,要明确其存在的意义:它提供了一套规则,定义了在多线程环境下,一个线程对内存的写入何时对另一个线程可见,以及操作的顺序如何被保证。这套规则是编译器和硬件优化的“契约”,在保证程序正确性的前提下,赋予它们最大的优化自由度。教学上,我们应该从最简单的并发场景入手,比如一个共享计数器,逐步引入数据竞争的问题,然后引出内存模型提供的解决方案。通过对比无同步、互斥锁、到原子操作的不同实现,让学习者体会到性能与复杂度的权衡。
在我看来,教授C++内存模型,最关键的一步是可视化。抽象的概念如果能通过图表、动画来展示,其效果会好得多。例如,可以画出不同线程的本地缓存,数据如何在缓存和主内存之间同步,以及内存屏障(memory barrier)是如何强制同步的。同时,我们应该鼓励学生动手尝试那些“会出错”的代码,利用工具如Thread Sanitizer (TSan) 来发现并诊断数据竞争,这样比单纯地讲解理论要深刻得多。
C++内存模型的核心概念有哪些,它们如何影响并发编程?
C++内存模型的核心,在于它定义了多线程环境中操作的可见性和顺序性。理解这些概念,是编写正确且高效并发代码的关键。
首先是Happens-Before关系,这是所有并发序的基础。它不是指时间上的先后,而是逻辑上的因果关系。如果操作A Happens-Before 操作B,那么A的内存效果对B是可见的。这个关系可以通过多种方式建立,比如线程内部的顺序、互斥锁的加解锁、以及原子操作。它直接影响了并发编程的正确性,因为没有Happens-Before关系保证的操作顺序,编译器和硬件都有可能对其进行重排,导致意想不到的结果。
接着是内存顺序(std::memory_order),这是原子操作的精髓。它决定了原子操作如何与内存中的其他操作进行同步。
std::memory_order_seq_cst(顺序一致性):这是最严格、最直观的内存顺序。所有线程都看到相同的操作顺序,就像所有操作都发生在一个全局的单一时间线上。虽然易于理解和使用,但其代价是可能引入额外的同步开销。std::memory_order_acquire(获取)和std::memory_order_release(释放):这对搭档是构建高效同步机制的利器。release操作保证其之前的所有写入对acquire操作之后的所有读取都是可见的。它们共同建立了一个Happens-Before关系,但只在特定的同步点之间有效,比seq_cst更灵活,性能通常也更好。std::memory_order_relaxed(宽松):这是最弱的内存顺序。原子操作只保证其自身的原子性,不提供任何跨线程的同步或排序保证。这意味着编译器和硬件可以对其进行最大限度的重排。它适用于那些不需要同步其他内存操作,只关心原子变量自身值的场景。
这些内存顺序直接影响了数据竞争(Data Race)的规避。数据竞争是指两个或更多线程同时访问同一个内存位置,并且至少有一个是写入操作,同时没有足够的同步来保证访问顺序。C++标准明确规定,数据竞争会导致未定义行为(Undefined Behavior),这意味着你的程序可能会崩溃,也可能产生错误结果,甚至在不同机器或编译器上表现不同。理解这些概念,就是为了在设计并发程序时,能够选择合适的同步机制,避免未定义行为,确保程序的正确性和可预测性。
学习C++内存模型有哪些推荐的权威资源和实践工具?
要深入理解C++内存模型,选择正确的学习资源和利用有效的实践工具至关重要。我个人觉得,仅仅看书是不够的,你得动手,得去观察,去思考。
在书籍方面,Anthony Williams的《C++ Concurrency in Action》无疑是首选。这本书从并发编程的基础讲起,逐步深入到内存模型,对std::atomic和std::memory_order的讲解非常透彻,并提供了大量实用示例。如果你想了解最新的C++20并发特性,务必选择第二版。此外,Herb Sutter的博客和CppCon演讲也是宝藏,他常常能用清晰的语言和生动的例子解释复杂概念。虽然不是专门讲内存模型的,但Scott Meyers的《Effective Modern C++》中关于并发和原子操作的部分,也提供了很多实用的建议和陷阱规避方法。
对于标准文档,C++标准本身是最终的权威,但它的可读性对于初学者来说并不友好。不过,偶尔翻阅其中关于内存模型(特别是第6.9.2节“Memory model”和第32章“Concurrency support library”)的描述,能帮助你校准理解,避免误解。
在实践工具方面,有几样东西是我的“心头好”:
- Thread Sanitizer (TSan):这是我强烈推荐的工具。TSan是一个运行时数据竞争检测器,集成在GCC和Clang中。你只需在编译时加上
-fsanitize=thread,它就能在程序运行时帮你找出潜在的数据竞争和死锁。对于学习者来说,它能直观地告诉你哪里出了问题,比你冥思苦想半天要有效得多。 - 编译器(GCC, Clang, MSVC):它们不仅仅是编译工具,更是观察内存模型行为的窗口。通过查看原子操作编译后的汇编代码,你会对
lock前缀、内存屏障指令(如mfence,lfence,sfence)有更直观的认识。不同的std::memory_order如何影响生成的汇编代码,这是理解其底层开销的关键。 - 调试器(GDB, LLDB, Visual Studio Debugger):虽然调试并发问题本身就很困难,但它们能帮助你观察变量在不同线程中的值,以及线程的执行路径。结合TSan,你可以更好地定位问题。
- 各种在线编译器/沙盒:例如Compiler Explorer (godbolt.org),它能让你快速尝试不同编译器、不同优化级别下C++代码的汇编输出,对于理解
std::atomic的底层实现非常有帮助。
通过这些资源和工具的结合,你不仅能从理论上理解C++内存模型,更能通过实践去感受和验证它的行为,从而真正掌握它。
在C++内存模型的教学中,如何设计有效的实践案例和实验?
设计有效的实践案例和实验是C++内存模型教学成功的关键。光说不练假把式,对于这种抽象的知识,动手实践能带来远超理论讲解的理解深度。我的经验是,要从简单、直观的例子开始,逐步引入复杂性,并始终强调“为什么会这样”和“如何避免错误”。
首先,可以从共享计数器的例子入手。
- 无同步的计数器:让多个线程同时对一个全局
int变量进行递增操作。学生会很快发现计数结果不正确,甚至每次运行结果都不同。这就是最直观的数据竞争演示。 - 使用
std::mutex的计数器:引入互斥锁来保护计数器,展示如何通过锁来保证正确性,但同时也要指出锁的开销。 - 使用
std::atomic的计数器(seq_cst):展示如何用原子操作实现正确的计数器,并解释其与互斥锁的性能差异。 - 使用
std::atomic的计数器(relaxed):可以尝试使用relaxed模式,但要明确指出,对于简单的计数器,relaxed的写入和读取可能导致其他操作的可见性问题(虽然计数器本身的值是原子更新的)。这可以引出acquire-release的必要性。
其次,生产者-消费者模型是展示acquire-release语义的绝佳案例。
- 基于
std::mutex和条件变量:先实现一个经典的生产者-消费者,让学生理解同步的基本模式。 - 基于
std::atomic和内存顺序:然后,尝试用std::atomic来构建一个无锁或部分无锁的队列。例如,一个生产者向队列写入数据,并用std::atomic以data_ready release模式设置标志;消费者以acquire模式读取标志,如果为真则读取数据。这个例子能清晰地展示acquire-release如何建立Happens-Before关系,保证数据的可见性。
再者,双重检查锁定(Double-Checked Locking, DCL)是一个经典的陷阱,非常适合作为教学案例。
- 错误的DCL实现:展示一个没有正确使用原子操作或内存屏障的DCL,并解释为什么它在某些情况下会失效(编译器或硬件重排导致先分配内存但未完全构造的对象被另一个线程看到)。
- 正确的DCL实现:然后,展示如何使用
std::atomic(通常是acquire-release语义)来正确实现DCL,强调memory_order_acquire和memory_order_release在这里的作用。这个例子能很好地说明内存模型的复杂性和微妙之处。
最后,可以设计一些内存重排的“模拟”实验。虽然直接在所有硬件上观察到内存重排很困难,但可以通过精心设计的代码,在特定条件下(例如,通过循环多次运行,或者在特定架构上)增加其发生的概率。例如,两个线程分别写入两个独立的原子变量,然后另一个线程读取它们,通过观察读取顺序是否与写入顺序一致来推断是否存在重排。配合Thread Sanitizer,这些实验会更有说服力。
这些实践案例,关键在于引导学生去思考:为什么会出错?如何修复?修复后的代码是如何利用内存模型规则来保证正确性的?通过这种方式,他们才能真正内化这些知识,而不仅仅是停留在表面。
深入解析C++中动态数组的初始化机制,涵盖new操作符的不同用法、基本类型与类对象的初始化差异,以及为何在现代C++开发中应优先使用std::vector。
C++类构造与析构函数详解 C++这门语言,可以说是从C语言这棵大树上衍生出的高级果实,如今的应用普及度有目共睹。作为一种静态类型的通用编程语言,它厉害的地方在于融合了多种编程哲学——无论是传统的面向过程,还是主流的面向对象,乃至数据抽象、泛型编程这些高级概念,它都能很好地支持。正因为这份卓越的扩展
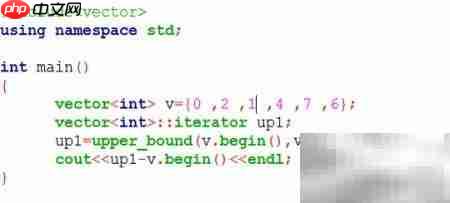
C++中std::upper_bound用法解析 在C++标准模板库(STL)的算法工具箱里,upper_bound() 绝对算得上是一把精准的“探针”。它的核心任务很明确:在一个已经排好序的区间 [first, last) 内,帮你快速定位到第一个**严格大于**指定值 value 的那个元素。这
C++中“常”概念全景解析:从对象、成员到指针与引用 在C++的世界里,“常量性”是一个强大的保障机制。它不仅仅是一个const关键字那么简单,而是构建健壮、安全程序的重要基石。今天,我们就来系统梳理一下围绕“常”的一系列概念:常成员、常对象、常指针与常引用。理解它们,是写出高质量C++代码的关键一
直接用SQLiteCAPI绑定结构体需要手动处理字段展平与顺序对齐,ORM库虽省代码但存在隐式行为风险。小项目建议原生绑定,中大型项目可搭配编译期校验使用轻量ORM。绑定std::string需传指针与长度,注意生命周期;浮点字段比较需设误差范围。
编程是编写程序指令,让设备按意图运行,常用Python、C等语言或Scratch图形化编程。学习编程能跟上科技时代,锻炼自学与解决问题能力,提升逻辑思维,代表行动力,推动事物前进。各司其职,编程者尽本分。
编程被争论是否为艺术。从定义看,编程是技能表达,但并非所有编程都是应用开发。写代码如音乐、文章,有独特风格。好代码需耐心与逻辑能力。编程是艺术,但应用开发不等同于编程艺术。
解决编程问题后的痛快、完成作品的成就感、获取知识的满足感,以及用代码实现简化生活的惊喜与踏实,这些是编程独有的乐趣,只有真正写代码的人才能体会其中的酸甜苦辣、惊喜与满足,令人回味无穷。
Scratch图形化编程以拖拽积木块方式启蒙少儿编程思维,无需记忆代码语法。通过素材库、即时反馈和社区协作,帮助孩子在创作中理解顺序执行、条件判断等核心概念,锻炼逻辑、创造力和问题解决能力。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



