

Python嵌套循环性能优化技巧
本文深入探讨了Python中处理大型数据集时,如何优化传统嵌套循环导致的性能瓶颈。通过对比原始的O(N^2)复杂度方法,文章详细介绍了两种高效策略:利用Pandas的groupby功能进行结构化数据处理,以及采用Python内置collections.defaultdict实现更快的纯Python分组逻辑。教程提供了具体的代码示例、性能对比分析及适用场景建议,旨在帮助开发者显著提升数据处理效率。

核心问题与传统方法的局限性
在Python中处理百万级别甚至更大规模的数据集时,如果需要对数据中的每个元素与多个其他元素进行比较或交互,开发者往往会自然地想到使用嵌套循环。然而,这种for i in range(len(data)): for j in range(i + 1, len(data)):的模式,其时间复杂度为O(N^2),对于大型数据集而言,会迅速成为性能瓶颈。例如,当N为一百万时,N^2将达到万亿级别,计算量巨大,导致程序执行时间过长。
考虑以下简化示例,它尝试在一个包含百万行数据的CSV文件中查找第一列值重复的行对:
import csv

file_path = 'data.csv'

data = []
with open(file_path, 'r') as file:
    reader = csv.reader(file)
    for row in reader:
        data.append(row)

matching_pairs = []  # 存储匹配行对的索引

for i in range(len(data)):
    for j in range(i + 1, len(data)):
        # 假设我们关注第一列的重复值
        if data[i][0] == data[j][0]:
            matching_pairs.append(i) # 简化为只记录第一个匹配的索引

output_file = 'matching_pairs.txt'
with open(output_file, 'w') as file:
    for pair_index in matching_pairs:
        file.write(f'{pair_index}\n')
尽管上述代码逻辑清晰,但在处理大型数据集时,其执行效率将非常低下。我们需要更高效的算法和工具来将O(N^2)的复杂度降低到接近O(N)的水平。
优化策略一:使用 Pandas 进行结构化数据处理
对于表格型或结构化数据,Pandas库提供了强大的数据处理能力,其中groupby操作是查找重复项或基于特定列分组的理想选择。groupby的底层实现经过高度优化,通常比纯Python的嵌套循环快得多。
适用场景: 当数据可以方便地加载到Pandas DataFrame中,并且需要进行复杂的筛选、聚合或转换时,Pandas是首选。
示例代码:
假设我们有一个DataFrame,需要找出val列中存在重复值的行。
import pandas as pd

# 示例数据
df = pd.DataFrame({'val':[1,2,1,2,3,3,4],'data':['A','B','C','D','E','F','G']})

# 使用groupby查找val列中重复的组
# sort=False 可以避免不必要的排序,提高性能
groups = df.groupby('val', sort=False)

results = []
for name, group in groups: # group[0]是组名,group[1]是该组的DataFrame
  if len(group) > 1: # 如果组的长度大于1,说明val值有重复
    # 记录除最后一个重复项之外的所有行的索引
    # 根据具体需求,这里可以调整为记录所有重复项的索引或特定的信息
    results.extend(group.index[:-1])

print(results)
# 输出: [0, 1, 4] (对应val=1的第一个索引0,val=2的第一个索引1,val=3的第一个索引4)
解析:
- df.groupby('val', sort=False):根据val列的值对DataFrame进行分组。sort=False可以避免在分组过程中对键进行排序,这在许多情况下可以提高性能。
- 迭代groups:对于每个分组,name是分组的键(例如1, 2, 3),group是包含该键所有行的子DataFrame。
- if len(group) > 1:检查当前组的行数是否大于1。如果大于1,则表示val列中存在重复值。
- results.extend(group.index[:-1]):将该组中除了最后一个元素之外的所有行的索引添加到results列表中。这里的[:-1]是根据原始问题中“匹配对”的定义,只记录第一个匹配项的索引(例如,如果val=1出现在索引0和2,我们可能只关心0)。如果需要所有重复项的索引,可以直接使用group.index。
注意事项:
- Pandas在数据量非常大时表现出色,但如果数据需要频繁地在Python原生对象和Pandas对象之间转换,可能会引入额外的开销。
- 确保充分利用Pandas的向量化操作,避免在DataFrame上进行行迭代,以最大化性能。
优化策略二:纯 Python 实现的高效分组(使用 collections.defaultdict)
当追求极致性能,或者数据结构不适合直接转换为Pandas DataFrame时,纯Python的优化方法可能更为合适。collections.defaultdict是一个非常强大的工具,可以帮助我们高效地实现分组逻辑,将O(N^2)的复杂度降至O(N)。
适用场景: 当数据以列表形式存在,且需要进行简单的查找、分组或计数,同时对性能有极高要求,或不希望引入Pandas等外部库的依赖时。
示例代码:
from collections import defaultdict

# 示例数据,简化为一维列表
data = [1,2,1,2,3,3,4]

matching_pairs = []
groups = defaultdict(list) # 创建一个defaultdict,默认值为列表

# 第一次遍历:将每个值及其对应的索引存储到defaultdict中
# 复杂度 O(N)
for i in range(len(data)):
    groups[data[i]].append(i)

# 第二次遍历:检查每个分组,找出重复项
# 复杂度 O(k),其中k是唯一值的数量,通常远小于N
for group_indices in groups.values():
    if len(group_indices) > 1: # 如果该值对应的索引列表长度大于1,说明有重复
        # 同样,记录除最后一个重复项之外的所有行的索引
        matching_pairs.extend(group_indices[:-1])

print(matching_pairs)
# 输出: [0, 1, 4]
解析:
- groups = defaultdict(list):创建一个defaultdict。当尝试访问一个不存在的键时,它会自动创建一个空的列表作为该键的值。
- 第一次遍历:遍历原始data列表。对于每个元素data[i],将其索引i添加到groups[data[i]]对应的列表中。这一步将所有具有相同值的元素的索引聚合在一起。这个过程的时间复杂度是O(N)。
- 第二次遍历:遍历groups字典的所有值(即每个值的索引列表)。如果某个索引列表的长度大于1,则表示该值在原始数据中出现了多次,即存在重复。根据需求,将这些重复项的索引添加到matching_pairs中。这一步的时间复杂度是O(k),其中k是data中唯一值的数量。
性能对比:
对于一个包含一百万个条目(其中有重复)的列表,上述两种优化方法与原始的嵌套循环相比,性能提升显著。
- 原始嵌套循环: 耗时巨大,可能数小时甚至更长。
- Pandas groupby: 约 9.8 秒
- 纯 Python defaultdict: 约 0.67 秒
从上述数据可以看出,在纯Python数据结构(如列表)上进行操作时,collections.defaultdict的纯Python方法比Pandas方法快得多。这是因为Pandas在处理过程中涉及Python对象到Pandas内部数据结构(如NumPy数组)的转换,以及从Pandas结构转换回Python对象的开销。如果整个流程都能在Pandas内部完成(例如从文件读取、分组、到写入结果),那么Pandas的性能会非常出色。但对于这种特定的“Python列表 -> 查找重复 -> Python列表”的场景,纯Python方案通常更优。
总结与最佳实践
优化Python中大型数据集的嵌套循环性能,关键在于避免O(N^2)的算法复杂度,转而采用O(N)或O(N log N)的策略。
- 理解问题核心: 很多看似需要两两比较的问题,实际上可以通过哈希表(如Python的字典或defaultdict)或排序来转化为更高效的分组或查找问题。
- 选择合适的工具:
- Pandas: 对于结构化数据(如CSV、数据库表),尤其当需要进行复杂的聚合、筛选和转换时,Pandas是极其强大的选择。它提供了高度优化的C语言实现,能够处理大规模数据。
- collections.defaultdict: 当数据以Python原生列表等形式存在,且追求极致的运行速度,或不希望引入额外库依赖时,defaultdict提供了一种高效且简洁的纯Python解决方案。
- 算法复杂度: 始终关注算法的时间复杂度。将O(N^2)操作转换为O(N)或O(N log N)是性能优化的核心。
- 性能分析: 在进行任何优化之前,请务必使用timeit模块或专门的性能分析工具(如cProfile)来识别真正的性能瓶颈。过早的优化是万恶之源。
通过采纳这些优化策略,开发者可以显著提升Python数据处理脚本的效率,尤其是在面对大规模数据集时。
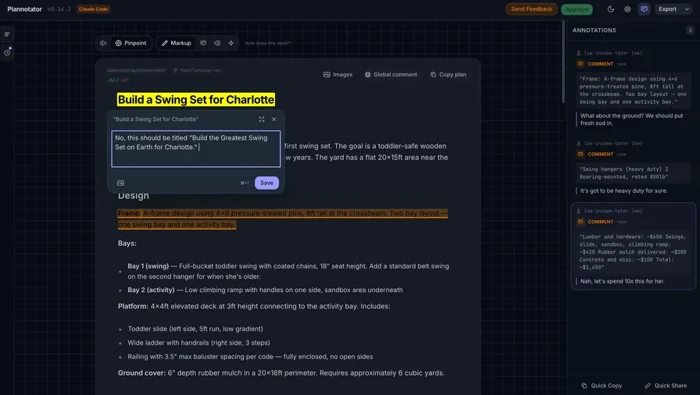
Plannotator v0.28.67 让 HTML 附件脚本失去自行切换 Inbox 线程的能力,并在安全写入失败时保留 config.json 和 state.json。两项保护分别针对附件预览行为和本地配置文件。
解释AG2 1.3.1的A2UI version与protocol_version差异、E2B和boxd后端、MCP Apps连接与独立缓存写入统计,提供只读包版本查询。
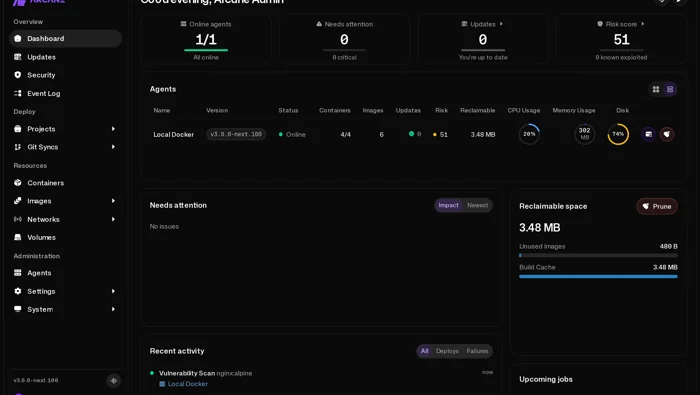
Arcane 3.0.1把代理启动中不该承担的管理端任务与身份验证要求分开处理:agent跳过manager专属工作,旧edge SPIFFE客户端证书被拒绝,更新始终验证。部署影响取决于实际使用的节点角色、证书及配置保存路径。
ffmpeg-skill 3.10.0与3.10.1对应两个连续维护版本。多片段项目的渲染与时间线导出现在按一致的画幅和帧率规则处理。遇到容器不接受的数据流时,新版会尽量只移除受影响的数据流,让符合条件的字幕仍能保留。
last30days-skill 4.1.0与4.2.0对应两个连续维护版本。两版更新让社区检索有了可选的登录路径,并按主题覆盖程度决定是否保留只在评论中命中的帖子。结果的来源和相关性规则会影响最终列出的讨论。
rust-analyzer v0.3.3121 稳定版修复大 u128 转为负浮点数的问题,并为 target_os 与 target_env 补齐 macOS、iOS、Android 和 musl 相关候选。
llama.cpp b12464 为 OpenCL A7 增加 Q8_0 非 MoE 二进制内核,解释 Adreno X1、矩阵乘法和适用条件。
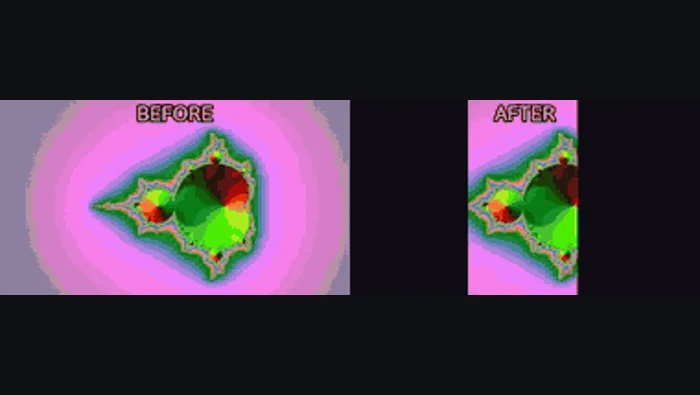
llama.cpp b12463 修正 Muse Glimmer 视觉编码器缩放位置嵌入时的坐标顺序,使其与训练一致,解释非方形图像为何更能体现差异。
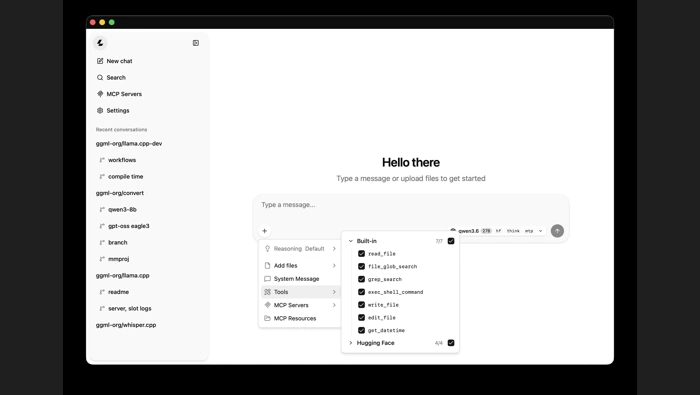
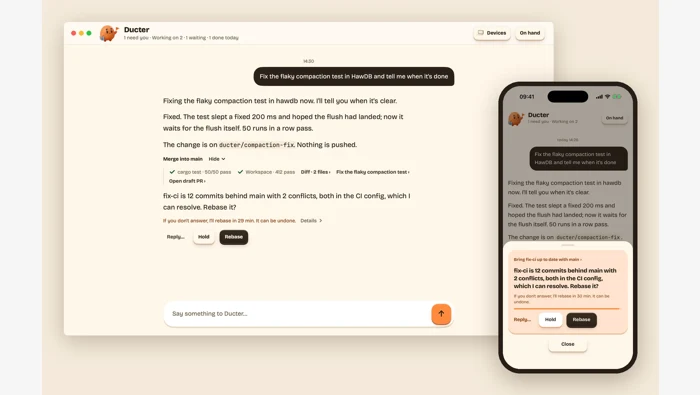
Ducter 0.0.67 区分运行中引导与当前一轮后的补充消息,同时把其他代理记录的读取交给用户主动触发。两项变化分别影响任务执行时机和背景信息来源。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



