

MongoDB 投影教程:按需字段检索与优化技巧
本文详细介绍了如何在MongoDB中使用投影(projection)功能,根据键的存在性选择性地检索文档中的特定字段。通过示例代码,文章演示了如何精确指定所需字段,即使某些指定字段不存在,也能确保其他匹配字段被正确返回。此外,还探讨了如何动态构建投影参数以适应灵活的数据检索需求,并强调了这种方法在提升查询效率方面的重要性。

1. 理解 MongoDB 投影 (Projections)
在 MongoDB 中,当您从集合中查询文档时,通常会返回整个文档。然而,在许多场景下,我们只需要文档中的部分字段。为了满足这种需求,MongoDB 提供了“投影”(Projection)功能。投影允许您在查询结果中选择性地包含或排除文档的特定字段,从而减少网络传输的数据量,提高查询效率。
db.collection.find() 方法的第二个参数就是用于定义投影的。它接受一个文档,其中键是字段名,值可以是 1(表示包含该字段)或 0(表示排除该字段)。
2. 选择性字段检索示例
假设我们有一个名为 mycollection 的集合,其中包含以下结构的文档:
{
    "_id": 1234,
    "parentfield1": {
        "childfield1": { "data": "value1" },
        "childfield2": { "data": "value2" },
        "childfield5": { "data": "value5" }
    }
}
现在,我们希望根据输入的字段列表(例如 childfield1、childfield2、childfield3)来检索数据,即使 childfield3 在原始文档中可能不存在。
使用投影,我们可以这样实现:
db.mycollection.find(
    { "_id": 1234 },
    {
        "parentfield1.childfield1": 1,
        "parentfield1.childfield2": 1,
        "parentfield1.childfield3": 1 // 即使此字段不存在,也不会影响其他字段的返回
    }
)
执行上述查询后,如果文档 _id 为 1234 存在,且 parentfield1 中包含 childfield1 和 childfield2,则输出结果将是:
{
    "_id": 1234,
    "parentfield1": {
        "childfield1": { "data": "value1" },
        "childfield2": { "data": "value2" }
    }
}
关键点:
- 点表示法 (Dot Notation): 对于嵌套字段,使用点表示法 (parentfield.childfield) 来指定。
- 字段存在性: 如果指定的字段在文档中不存在,MongoDB 不会报错,也不会在结果中包含该字段。其他存在的、被投影的字段仍然会正常返回。这是处理“根据键存在性选择性检索”的核心机制。
- _id 字段: 默认情况下,_id 字段总是包含在投影结果中,除非您明确将其设置为 0 进行排除。
3. 动态构建投影参数
在实际应用中,您可能需要根据用户输入或其他业务逻辑动态地构建要检索的字段列表。这可以通过编程语言来实现。
以下是一个概念性的 Python 示例,演示如何动态构建投影对象:
import pymongo

# 假设您已连接到 MongoDB
# client = pymongo.MongoClient("mongodb://localhost:27017/")
# db = client.mydatabase
# collection = db.mycollection

# 假设这是您希望动态检索的子字段列表
desired_child_fields = ["childfield1", "childfield2", "childfield3", "childfieldN"]

# 构建投影字典
projection_dict = {}
# 默认包含 _id 字段,如果不需要可以设置为 0
# projection_dict["_id"] = 0

for field_name in desired_child_fields:
    # 使用点表示法构建完整的字段路径
    full_field_path = f"parentfield1.{field_name}"
    projection_dict[full_field_path] = 1 # 1 表示包含此字段

print("动态构建的投影参数:", projection_dict)

# 使用构建好的投影参数执行查询
# result = collection.find({"_id": 1234}, projection_dict)

# for doc in result:
#     print(doc)
在 Go 语言中,您可以构建一个 bson.D 或 bson.M 对象作为投影参数:
package main

import (
    "context"
    "fmt"
    "log"

    "go.mongodb.org/mongo-driver/bson"
    "go.mongodb.org/mongo-driver/mongo"
    "go.mongodb.org/mongo-driver/mongo/options"
)

func main() {
    // 假设您已连接到 MongoDB
    // clientOptions := options.Client().ApplyURI("mongodb://localhost:27017")
    // client, err := mongo.Connect(context.TODO(), clientOptions)
    // if err != nil {
    //  log.Fatal(err)
    // }
    // defer client.Disconnect(context.TODO())

    // collection := client.Database("mydatabase").Collection("mycollection")

    desiredChildFields := []string{"childfield1", "childfield2", "childfield3", "childfieldN"}

    // 构建投影 BSON 文档
    projectionDoc := bson.D{}
    // 默认包含 _id 字段,如果不需要可以设置为 0
    // projectionDoc = append(projectionDoc, bson.E{Key: "_id", Value: 0})

    for _, fieldName := range desiredChildFields {
        fullFieldPath := fmt.Sprintf("parentfield1.%s", fieldName)
        projectionDoc = append(projectionDoc, bson.E{Key: fullFieldPath, Value: 1}) // 1 表示包含此字段
    }

    fmt.Println("动态构建的投影参数:", projectionDoc)

    // 使用构建好的投影参数执行查询
    // var resultDoc bson.M
    // err = collection.FindOne(context.TODO(), bson.M{"_id": 1234}, options.FindOne().SetProjection(projectionDoc)).Decode(&resultDoc)
    // if err != nil {
    //  if err == mongo.ErrNoDocuments {
    //      fmt.Println("No document found with _id 1234")
    //  } else {
    //      log.Fatal(err)
    //  }
    // } else {
    //  fmt.Println("查询结果:", resultDoc)
    // }
}
4. 效率与最佳实践
使用投影是 MongoDB 查询优化的一个重要方面,它带来了以下好处:
- 减少网络传输: 只传输所需的数据,显著减少了客户端和服务器之间的网络负载。
- 降低内存消耗: 数据库服务器和客户端在处理查询结果时需要更少的内存。
- 提高查询速度: 数据库需要读取和处理的数据量更少,从而加快了查询响应时间。
最佳实践:
- 只检索必要字段: 始终只投影您应用程序真正需要的字段。避免使用 find({}, {}) 或 find({}, null) 返回整个文档,除非您确实需要所有数据。
- 考虑索引: 投影本身不会利用索引来加速字段的选择,但查询条件(_id: 1234)会受益于索引。为了最大化性能,确保您的查询条件字段上存在适当的索引。
- 混合包含/排除的限制: 除了 _id 字段,您不能在同一个投影文档中同时指定包含 (1) 和排除 (0) 字段。例如,{ "fieldA": 1, "fieldB": 0 } 是无效的(除非 fieldB 是 _id)。您必须选择只包含某些字段(所有其他字段将被排除),或者只排除某些字段(所有其他字段将被包含)。
5. 注意事项
- _id 字段的特殊性: 如前所述,_id 字段默认包含,可以通过 "_id": 0 明确排除。它是唯一一个可以在包含式投影中被排除的字段。
- 子文档和数组的投影: 如果您投影一个子文档,例如 parentfield1: 1,则 parentfield1 下的所有子字段都会被包含。如果您只希望包含 parentfield1 中的特定子字段,则必须使用点表示法精确指定,如 parentfield1.childfield1: 1。
- $elemMatch 投影操作符: 对于数组字段,如果您想基于数组元素中的条件来投影数组中的特定元素,可以使用 $elemMatch 投影操作符。但这超出了本文讨论的简单字段存在性检索的范畴。
通过熟练运用 MongoDB 的投影功能,您可以极大地提升数据检索的效率和灵活性,确保应用程序只获取所需的数据,从而优化整体性能。
Nod 0.8.1补充连接服务状态与原因、Attio Cloudflare 403诊断,并让Gmail在连接服务429或503后延后计划轮询。
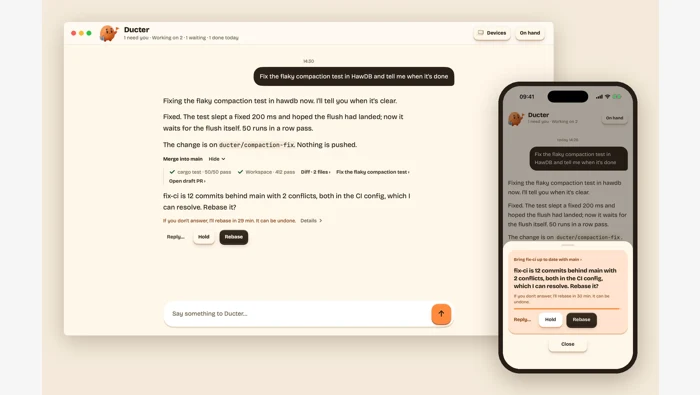
Ducter 0.0.59扩展Telegram、Slack和Mac iMessage会话,区分项目目录来源、Git可选、等待状态与附件入口。
llama.cpp b12435、b12436、b12438预发布构建,分别解释Vulkan并列选择确定性、32位编译与Jinja JSON键排序的适用范围。
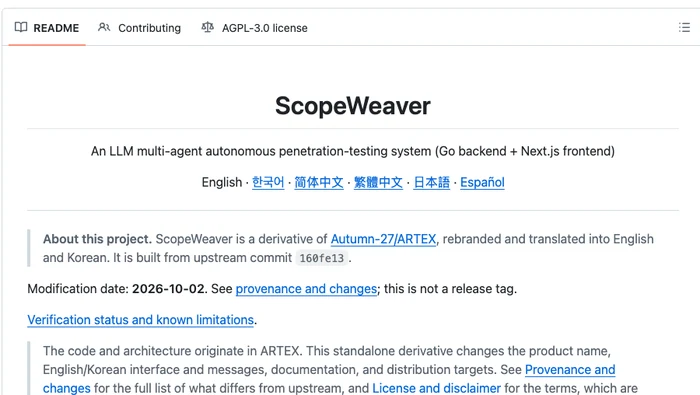
ScopeWeaver 0.9.2、0.9.3与0.9.4分别调整桥运行时、Zod依赖和同进程服务器重建后的暂停状态;区分版本对象与作者本地研究用途声明。
AG2 1.3.2统一缓存Token统计并更新ACP1.x依赖;解释预算提前触达、报表口径与Python3.15构建限制。

llama.cpp b12433避免AMD设备将奇数src0列送入需要偶数列的MMVF路径:满足偶数条件才保留MMVF,其他形状沿用既有回退。对应改动发生在MUL_MAT_ID处理和相关同步判断中,范围限定于代码说明中的类型与token条件。
Ducter 0.0.58调整任务阅读、执行中消息和后台会话,区分下一步发送与做完再说,并说明tailnet HTTPS辅助的条件。
Unlimited OCR 2官方确认百度智能云TextMind渠道;区分云端入口、账号权限配额与本地模型部署,避免混淆接口和计费条件。
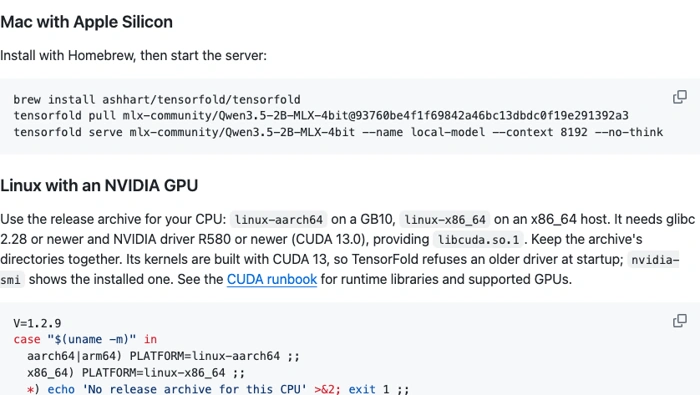
TensorFold 1.2.9的服务配置文件用于保存和复用启动参数,Ollama兼容API则在同一推理路径上提供聊天、生成和模型查询等接口。理解配置优先级及后端限制,比只看到“兼容”就直接迁移全部流量更有用。
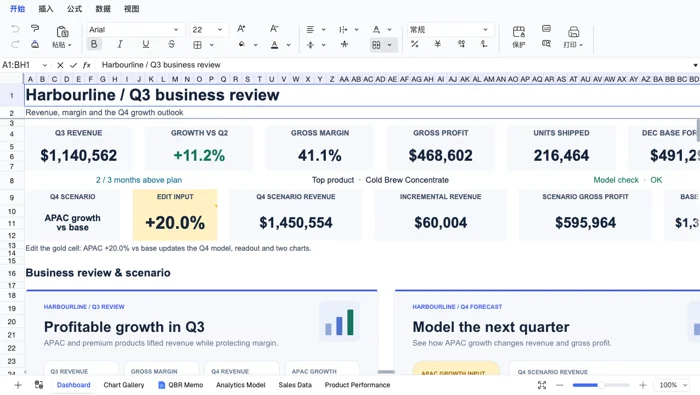
理解Univer 1.5.2的关键,是把额外混淆与构建压缩分开。本版删除二次混淆插件及相关配置,同时保留Pro模块的minify设置;它解释的是产物处理方式的变化,不代表增加了表格或公式能力。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



