

PHP分帧处理技巧分享
PhpStorm 是 JetBrains 推出的专业 PHP 集成开发环境,可在 Mac 上完成代码编写、智能检查、重构、调试、测试和数据库管理。它支持主流 PHP 框架、Composer、Git、Docker 与远程解释器。
数据分帧的核心目的是避免内存溢出和超时,通过fread()、fgets()、生成器等方式实现文件、数据库和网络流的分块处理,确保PHP在资源受限下稳定处理大数据。
数据分帧的核心目的是避免内存溢出和超时,通过fread()、fgets()、生成器等方式实现文件、数据库和网络流的分块处理,确保PHP在资源受限下稳定处理大数据。
在PHP中,数据分帧(或者说数据分块处理)的核心目的,是把那些体积庞大、一次性加载或处理会耗尽系统资源(主要是内存和执行时间)的数据,拆分成一个个小而可控的“帧”或“块”来逐步处理。这就像吃一头大象,你不可能一口吞下,而是要一块一块地来。这样做能有效规避PHP脚本常见的内存溢出、执行超时等问题,让程序在资源有限的环境下也能稳定高效地处理大数据。
解决方案
PHP实现数据分帧处理,主要围绕着如何从数据源(文件、数据库、网络流等)中以增量、非阻塞的方式获取数据。最直接的方法就是利用PHP的文件操作函数,如fread()或fgets(),结合循环来读取指定大小或指定行的数据。对于数据库结果集,则可以通过迭代器模式或yield关键字(生成器)来逐行处理,避免一次性加载所有结果。而网络数据流,比如接收大的POST请求体,则可以通过php://input配合fread()来实现分块读取。
举个例子,如果你要处理一个几个GB大小的日志文件:
function processLargeFileInFrames(string $filePath, int $frameSize = 4096): void
{
    if (!file_exists($filePath) || !is_readable($filePath)) {
        echo "文件不存在或不可读。\n";
        return;
    }

    $handle = fopen($filePath, 'r');
    if (!$handle) {
        echo "无法打开文件。\n";
        return;
    }

    echo "开始处理文件:{$filePath}\n";
    $frameCount = 0;
    while (!feof($handle)) {
        $frame = fread($handle, $frameSize);
        if ($frame === false) {
            echo "读取文件失败。\n";
            break;
        }
        if (empty($frame)) { // 可能读到文件末尾了,但feof还没设置为true
            break;
        }

        $frameCount++;
        echo "处理第 {$frameCount} 帧,大小:" . strlen($frame) . " 字节。\n";
        // 这里是你的业务逻辑,对 $frame 进行处理
        // 例如:解析日志行,存储到数据库,发送到消息队列等
        // processLogFrame($frame);
        // 模拟耗时操作
        // usleep(100);
    }

    fclose($handle);
    echo "文件处理完毕。\n";
}

// 调用示例:
// processLargeFileInFrames('large_log.txt', 8192); // 每次读取8KB这个例子展示了通过fread()分块读取文件的基本思路。每一次循环,我们只将文件的一部分内容加载到内存中,处理完后再读取下一部分,从而避免了内存压力。
为什么在PHP中进行数据分帧处理如此重要?理解大数据挑战与PHP的限制
在PHP的运行环境里,数据分帧处理的重要性怎么强调都不过分。我们知道,PHP脚本通常是“运行到结束”的模式,这意味着一个脚本在处理请求时,所有数据都会在内存中进行操作,直到脚本执行完毕或达到内存限制。一旦数据量超出了memory_limit设置的值,或者处理时间超出了max_execution_time,脚本就会直接报错并中断。这对于处理一些“重量级”任务,比如导入导出百万级数据、分析大型日志文件、处理高并发的实时数据流等,简直是致命的。
一个几百兆甚至上G的文件,你如果尝试用file_get_contents()一次性读入内存,那几乎是必然会触及内存上限的。即使内存足够,长时间的CPU密集型操作也可能导致脚本超时。分帧处理就是为了应对这些挑战。它将大任务拆解成小任务,每次只处理一小部分数据,这样不仅能显著降低单次处理的内存占用,还能在每次处理完一个“帧”后,有机会进行一些中间状态的保存或者资源释放,甚至可以配合异步任务队列来提升整体的吞吐量和稳定性。这不仅仅是性能优化,更是保证程序健壮性和可扩展性的基石。
PHP中实现文件数据分帧的具体技术细节和陷阱
处理文件数据分帧,PHP提供了多种工具,但每种都有其适用场景和需要注意的坑。
fread():固定大小分块读取- 优点: 简单直接,适合处理二进制文件或结构化不强的文本文件。你可以精确控制每次读取的字节数。
- 缺点: 如果处理的是文本文件,特别是多行文本,
fread()可能会在行的中间截断数据,导致你拿到的“帧”是不完整的行。这在需要按行解析的场景下是个大问题。 - 陷阱: 字符编码。如果文件是UTF-8编码,一个中文字符可能占3个字节。你设定的
frameSize如果是100字节,可能正好截断了一个中文字符,导致解析错误或乱码。处理时需要额外逻辑来确保字符完整性,或者在处理文本文件时避开fread()。
fgets():按行读取- 优点: 完美解决了
fread()在文本文件中截断行的问题,每次读取直到换行符或文件末尾。对于日志文件、CSV文件等按行组织的数据非常友好。 - 缺点: 无法控制读取的字节数。如果某一行特别长,比如几MB甚至几十MB,那么单行读取仍然可能导致内存压力。
- 陷阱: 同样是长行问题,如果一行数据过长,
fgets()的默认缓冲区可能不足,需要通过stream_set_read_buffer()调整,或者自己实现一个带缓冲区的按行读取逻辑。
- 优点: 完美解决了
fgetcsv():针对CSV文件- 优点: 直接解析CSV格式,自动处理字段分隔符、引号包裹等细节,非常方便。
- 缺点: 仅限于CSV文件。
- 陷阱: 同样可能遇到超长行或超大字段的问题。此外,如果CSV文件编码不规范,可能需要先用
iconv或mb_convert_encoding进行转码。
SplFileObject:面向对象的文件操作- 优点: 提供了面向对象的方式来操作文件,支持迭代器模式,可以像遍历数组一样遍历文件行,代码更优雅。
- 缺点: 底层仍然是基于
fgets()等函数,所以其优缺点也类似。 - 代码示例(
fgets()):
function processLargeTextFileByLines(string $filePath): void
{
    if (!file_exists($filePath) || !is_readable($filePath)) {
        echo "文件不存在或不可读。\n";
        return;
    }

    $handle = fopen($filePath, 'r');
    if (!$handle) {
        echo "无法打开文件。\n";
        return;
    }

    echo "开始按行处理文件:{$filePath}\n";
    $lineNumber = 0;
    while (($line = fgets($handle)) !== false) {
        $lineNumber++;
        echo "处理第 {$lineNumber} 行,长度:" . strlen($line) . " 字节。\n";
        // 这里是你的业务逻辑,对 $line 进行处理
        // processTextLine($line);
        // 模拟耗时操作
        // usleep(50);
    }

    fclose($handle);
    echo "文件按行处理完毕。\n";
}

// 调用示例:
// processLargeTextFileByLines('large_text_data.txt');
一个常见的误区是,为了避免fread()截断行,有人可能会尝试在读取到帧后,向后查找第一个换行符,然后将剩余部分和下一帧拼接。这虽然能解决问题,但会增加逻辑复杂性,并且频繁的fseek()操作在某些文件系统上可能效率不高。更好的做法是,根据数据类型选择合适的读取方式:结构化文本文件用fgets()或fgetcsv(),二进制或非结构化数据用fread()。
如何在处理数据库或API响应时有效应用数据分帧策略?
数据分帧不仅仅是文件处理的专利,在处理数据库查询结果集或大型API响应时,同样至关重要。这里的“帧”可能不是固定的字节数,而是逻辑上的“一批记录”或“一个数据包”。
数据库查询结果集的分帧:
逐行获取: 最常见且高效的方法。使用PDO或MySQLi时,不要一次性
fetchAll()所有结果,而是通过循环调用fetch()方法逐行获取数据。这能确保每次只有一行数据被加载到内存中。function processLargeQueryResult(PDO $pdo, string $sql): void { $stmt = $pdo->query($sql); if (!$stmt) { echo "查询失败。\n"; return; } echo "开始处理数据库查询结果。\n"; $recordCount = 0; while ($row = $stmt->fetch(PDO::FETCH_ASSOC)) { $recordCount++; echo "处理第 {$recordCount} 条记录。\n"; // 这里是你的业务逻辑,对 $row 进行处理 // processDatabaseRecord($row); // 模拟耗时操作 // usleep(20); } echo "数据库查询结果处理完毕。\n"; } // 示例: // $pdo = new PDO('mysql:host=localhost;dbname=test', 'user', 'pass'); // processLargeQueryResult($pdo, "SELECT * FROM very_large_table");使用生成器(
yield): PHP的生成器是处理大数据集的神器。它可以让你写出看起来像返回数组的函数,但实际上是按需生成值,极大地节省内存。当处理大型数据库结果集时,将fetch()操作封装在生成器中,可以实现惰性加载。function getRecordsGenerator(PDO $pdo, string $sql): Generator { $stmt = $pdo->query($sql); if (!$stmt) { throw new Exception("查询失败。"); } while ($row = $stmt->fetch(PDO::FETCH_ASSOC)) { yield $row; } } // 使用生成器处理: // try { // $pdo = new PDO('mysql:host=localhost;dbname=test', 'user', 'pass'); // echo "开始使用生成器处理数据库查询结果。\n"; // $recordCount = 0; // foreach (getRecordsGenerator($pdo, "SELECT * FROM very_large_table") as $record) { // $recordCount++; // echo "处理第 {$recordCount} 条记录。\n"; // // processDatabaseRecord($record); // // usleep(20); // } // echo "使用生成器处理完毕。\n"; // } catch (Exception $e) { // echo "错误:" . $e->getMessage() . "\n"; // }分批次查询(
LIMIT和OFFSET): 如果你的数据库驱动不支持逐行迭代(虽然现代的几乎都支持),或者你需要显式地控制批次大小,可以使用LIMIT和OFFSET。但这有个缺点,随着OFFSET的增大,查询性能可能会急剧下降。SELECT * FROM large_table LIMIT 1000 OFFSET 0; SELECT * FROM large_table LIMIT 1000 OFFSET 1000; -- 循环执行直到没有结果
更好的方式是基于上次处理的最后一个ID(如果ID是自增且有序的)进行查询,避免
OFFSET的性能问题:SELECT * FROM large_table WHERE id > [last_processed_id] ORDER BY id ASC LIMIT 1000;
API响应或网络数据流的分帧:
php://input读取POST请求体: 当接收到非常大的POST请求(例如文件上传或大型JSON数据),直接file_get_contents('php://input')会占用大量内存。此时,可以使用fopen('php://input', 'r'),然后结合fread()来分块读取请求体。// 假设这是一个处理大型POST请求的脚本 // if ($_SERVER['REQUEST_METHOD'] === 'POST' && isset($_SERVER['CONTENT_LENGTH']) && $_SERVER['CONTENT_LENGTH'] > 0) { // $inputHandle = fopen('php://input', 'r'); // if ($inputHandle) { // $bufferSize = 4096; // $totalRead = 0; // echo "开始分帧读取POST请求体。\n"; // while (!feof($inputHandle) && $totalRead < $_SERVER['CONTENT_LENGTH']) { // $chunk = fread($inputHandle, $bufferSize); // if ($chunk === false || empty($chunk)) { // break; // } // $totalRead += strlen($chunk); // echo "读取到 " . strlen($chunk) . " 字节的请求体帧。\n"; // // 对 $chunk 进行处理,例如保存到临时文件或流式解析 // // processApiChunk($chunk); // } // fclose($inputHandle); // echo "POST请求体读取完毕,总计读取 {$totalRead} 字节。\n"; // } // }- 处理流式API响应: 如果你通过
curl或其他HTTP客户端获取到一个大型API响应,并且该API支持流式传输,你可以配置客户端将响应直接写入文件,或者在收到数据时通过回调函数逐块处理,而不是等待整个响应下载完毕。例如,GuzzleHttp库就支持流式响应。
在这些场景下,分帧处理的核心思想都是一样的:避免一次性将所有数据加载到内存,转而采用迭代、生成或分块读取的方式,以应对大数据带来的内存和性能挑战。这需要开发者对数据源的特性、PHP的内存管理机制以及业务需求有深入的理解,才能选择最合适的分帧策略。
PHP 8.6.0 RC7已提供源码和Windows预发布构建,用于开发者测试兼容性与回归问题,不适合直接替换生产环境。发布经理预计PHP 8.6.0正式版在11月19日推出;这一日期仍是发布计划。
Yandex官网入口是https://www.yondex.net/,该平台支持多语言切换、智能搜索匹配、虚拟键盘变更及实时翻译,提供地图、图片、新闻、购物等垂直服务,并具备账户同步、隐私管理、个性化首页和云存储等功能。
详细介绍如何使用PHP PDO扩展连接MySQL数据库,包含完整的代码示例、DSN配置方法及异常处理技巧,帮助开发者快速建立稳定安全的数据库连接。
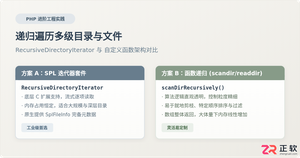
深入解析在PHP中递归遍历多级目录文件的两种核心方案:基于SPL标准库的RecursiveDirectoryIterator高效流式迭代,与基于scandir/opendir的自定义递归函数实现,剖析执行机制、内存表现与实战避坑指南。
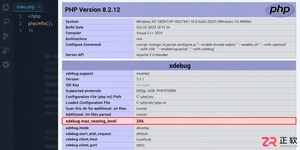
遇到PHP递归报错时,不要盲目调大max_nesting_level。本文教你区分Xdebug限制、内存耗尽和正则递归错误,提供代码级的终止条件优化与迭代替代方案,彻底解决栈溢出问题。
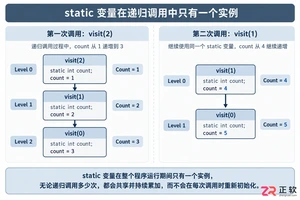
本文分析PHP递归中static变量导致的状态污染及引用传递引发的共享数据修改问题。提供具体的代码复现、缓存键设计建议及调试打印技巧,帮助开发者避免隐蔽的逻辑错误。
解析PHP递归函数在树形数据处理中的性能瓶颈,提供预加载数据消除I/O、使用显式栈替代深层递归的实战方案,帮助开发者在代码可读性与执行效率间做出合理取舍。
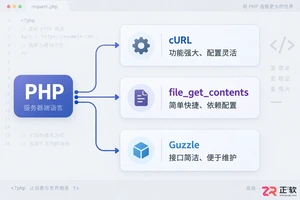
详解PHP中发送HTTP请求的常用方法,包括原生cURL配置、file_get_contents流操作及Guzzle库的使用,提供GET/POST请求的完整代码示例与注意事项。
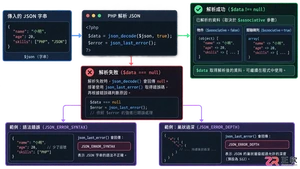
本文详解PHP中json_decode处理嵌套JSON数据的机制,对比对象与数组模式的取值差异,提供防止空指针错误的健壮代码示例,帮助开发者快速定位解析失败原因。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



