

来聊聊近期火爆的几个大模型和自动驾驶概念
近期大模型各种应用依然火爆,10月初前后出现了一系列颇有噱头的文章,试图把大模型应用于自动驾驶。和很多朋友最近也聊了很多相关的话题,写这篇文章,一方面是发现其实包括我在内,在过去其实都混淆了一些很相关但其实不同的概念,另一方面从这些概念延伸出来有一些有意思的思考,值得和大家一起分享和探讨。大(语言)模型这无疑是目前最为火爆的一个方向,也是论文最为集中的热点。那大语言模型究竟能怎么帮助到自动驾驶?一方面是像GPT-4V一样,通过和图像的对齐,提供极其强大的语义理解能力,这里暂时按下不表;另一方面便是把LLM
近期大模型各种应用依然火爆,10月初前后出现了一系列颇有噱头的文章,试图把大模型应用于自动驾驶。和很多朋友最近也聊了很多相关的话题,写这篇文章,一方面是发现其实包括我在内,在过去其实都混淆了一些很相关但其实不同的概念,另一方面从这些概念延伸出来有一些有意思的思考,值得和大家一起分享和探讨。
大(语言)模型
这无疑是目前最为火爆的一个方向,也是论文最为集中的热点。那大语言模型究竟能怎么帮助到自动驾驶?一方面是像GPT-4V一样,通过和图像的对齐,提供极其强大的语义理解能力,这里暂时按下不表;另一方面便是把LLM作为agent去直接实现驾驶行为。后者其实也是目前最为sexy的研究方向,和embodied AI这一系列工作有着千丝万缕的联系。
目前看到的绝大部分后一类工作都是将LLM:1) 直接使用 2) 通过supervised learning的方式微调 3) 通过reinforcement learning的方式微调 用于驾驶任务。本质上并没有逃脱出之前基于learning方法去驾驶的范式框架。那其实很直接的一个问题就是,为什么用LLM做这件事情可能会更好?直觉上来说用语言去开车是一个很低效而啰嗦的事情。后来有一天突然想明白了LLM其实通过语言实现了一个对agent的pretrain!之前RL很难具有泛化性很重要的一个原因是难以统一起来各种不同的任务,去用各种通用的数据去pretrain,只能是每种任务from scratch训练,但是LLM很好解决了这样的问题。但其实也有几个并没有很好解决的问题:1) 完成pretrain之后,一定要保留语言作为输出的接口吗?这其实在很多任务中带来了很多的不便,也一定程度上造成了冗余的计算量。2) LLM as agent的做法上仍然没有克服现有RL类model free方法的本质问题,所有model free有的问题这样的方法仍然存在。最近也看到一些model based + LLM as agent的尝试,这可能会是一个有意思的方向。
最后想吐槽的一句各篇paper的是:并不是接上LLM,让LLM输出一个reason就能让你的模型变得可解释。这个reason仍然是可能胡说八道的。。。原先不会有保障的东西,并不会因为输出一句话就变得有保障了。
大(视觉)模型
纯粹的大视觉模型其实目前仍然没有看到那神奇的“涌现”时刻。谈到大视觉模型,一般有两个可能的所指:一个是基于CLIP或者DINO或者SAM这样海量的web data预训练实现的超强视觉信息特征提取器,这大大提升了模型的语义理解能力;另一个是指以GAIA为代表的world model实现的对(image, action,etc...)的联合模型。
前者其实我认为只是沿着传统的思路继续linear scale up的结果,目前很难看到对自动驾驶量变的可能性。后者其实在今年Wayve和Tesla的不断宣传之下,不断走入了研究者的视野。大家在聊world model的时候,往往夹杂着这个模型是端到端(直接输出action)且和LLM是相关联的。其实这样的假设是片面的。对于world model的我的理解也是非常有限,这里推荐一下Lecun的访谈和 @俞扬 老师的这篇model based RL的survey,就不展开了:
俞扬:关于环境模型(world model)的学习
https://zhuanlan.zhihu.com/p/533855468
纯视觉自动驾驶
这其实很容易理解,是指仅依赖于视觉传感器的自动驾驶系统。这其实也是自动驾驶最美好的一个终极愿望:像人一样靠一双眼睛来开车。这样的概念一般都会和上述两个大模型联系起来,因为图像复杂的语义需要很强的抽象能力来提取有用的信息。在Tesla最近不断的宣传攻势下,这个概念也和下面要提到的端到端重合起来。但其实纯视觉驾驶有很多种实现的路径,端到端自然是其中的一条,但也不是仅有的一条。实现纯视觉自动驾驶最为困难的问题就是视觉天生对于3D信息的不敏感,大模型也并未本质上改变这一点。具体体现在:1) 被动接收电磁波的方式使得视觉不像其他传感器可以测量3D空间中的几何信息;2) 透视使得远处的物体对于误差的敏感程度极高。这对于下游默认在一个等误差的3D空间中实现的planning和control来说非常不友好。但是,人靠视觉开车等同于人能准确估计3D距离和速度吗?我觉得这才是纯视觉自动驾驶除了语义理解之外,值得深入研究的representation的问题。
端到端自动驾驶
这个概念是指从传感器到最终输出的控制信号(其实我认为也可以广义地包括到更上游一层planning的路点信息)使用一个联合优化的模型。这既可以是像早在80年代的ALVINN一样输入传感器数据,直接通过一个神经网络输出控制信号的直接端到端方法,也可以有像今年CVPR best paper UniAD这样的分阶段端到端方法。但是这些方法的一个共同要点都是通过下游的监督信号能够直接传递给到上游,而不是每个模块只有自己自定的优化目标。整体来说这是正确的一个思路,毕竟深度学习就是靠着这样的联合优化发家的。但是对于自动驾驶或者通用机器人这种往往复杂程度极高,且和物理世界打交道的系统来说,工程实现和数据组织和利用效率上都存在很多需要克服的难题。
Feed-Forward端到端自动驾驶
这个概念好像很少有人提到,但其实我发现端到端本身的存在是有价值的,但是问题在于对于观测这种Feed-Forward的使用方式。包括我在内,其实之前也都会默认端到端驾驶一定是Feed-Forward形式的,因为目前99%基于深度学习的方法都假设了这样的结构,也就是说最终关心的输出量(比如控制信号)u = f(x),x是传感器的各种观测。这里f可以是一个很复杂的函数。但其实,我们在某些问题里,我们希望能够使得最终的输出量满足或接近某些性质,这样Feed-Forward的形式便很难给出这样的保证。所以能还有一种方式我们可以写成u* = argmin g(u, x) s.t. h(u, x) <= c 这样的约束优化形式(某种意义上来说,这也算引入了反馈,姑且不准确地叫做Feedback端到端自动驾驶吧)。其实在CV领域也有一些工作是试图将这两者的优势结合起来,比如我比较熟悉的通过Implict Function构造导数的方式,这在之前的文章里面多次提到过。这样的范式其实我认为才会是取两家之长的一个完美端到端方案。
随着大模型的发展,这种直接式的Feed-Forward端到端自动驾驶的方案又迎来了一波复兴。大模型当然是非常强大的,但是我抛出一个问题希望大家来想想:如果大模型端到端是万能的,那是不是意味着大模型就应该可以端到端下围棋/五子棋呢?类似AlphaGo的范式就应该已经毫无意义了?相信大家也都知道这个答案是否定的。当然这种Feed-Forward的方式可以作为一个快速的近似求解器,在大部分场景下取得不错的结果。
以目前公开了自己使用了Neural Planner的各家方案来看,neural的部分只是为后续的优化方案提供了若干初始化的proposal去缓解后续优化高度非凸的问题。这本质上和AlphaGo里的fast rollout做的事情是一模一样的。但是AlphaGo不会把后续的MCTS搜索叫做一个“兜底”方案。。。
最后,希望这些能够帮助大家理清这些概念之间的区别与联系,大家在讨论问题的时候也能够明确在说的究竟是什么东西。。。
原文链接:https://mp.weixin.qq.com/s/_OjgT1ebIJXM8_vlLm0v_A
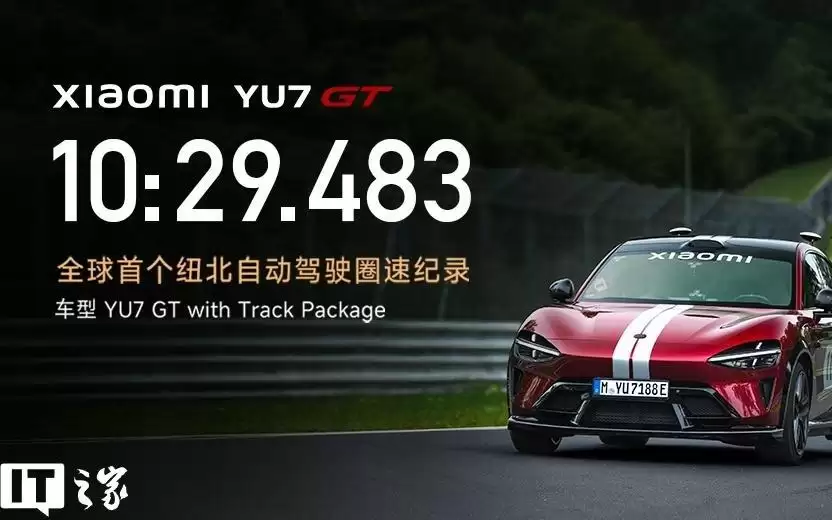
小米YU7GT在纽博格林北环以自动驾驶模式跑出10分29秒483,创全球量产车自动驾驶圈速纪录。胡峥楠表示,这体现小米入局汽车的梦想:电能替代化学能,智能替代人工。纽北因此将小米列为三大顶级合作伙伴之一。该成绩相当于老司机水平,但仅是起点。
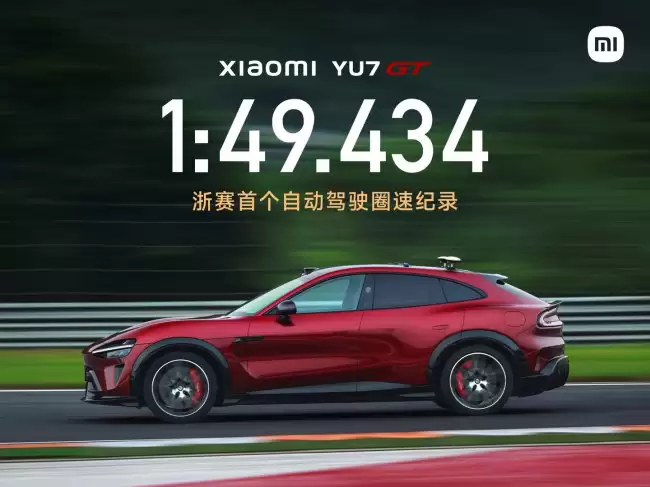
小米YU7GT在浙江国际赛车场以1分49秒434创下自动驾驶圈速纪录,此前于纽博格林北环也取得全球首个自动驾驶圈速成绩。该车最大马力1003匹,零百加速2.92秒,CLTC续航705km,基于897V碳化硅高压平台,全程无人干预。
曹操出行与自动驾驶企业MayMobility达成战略合作,在欧洲探索Robotaxi商业化。双方将联合开展可行性研究,优先在欧洲试点,由曹操出行负责运营,MayMobility提供自动驾驶技术支撑,共同推进无人驾驶出租车服务落地。
由中、欧、英、美、加、日六方牵头的联合国自动驾驶系统全球技术法规获批发布,首次从产品全生命周期明确核心技术指标,将安全管理、试验验证及持续监控纳入制造商义务,提供完整评估方法,使各国自动驾驶车辆拥有统一标准,推动产业化从碎片化走向体系化。
大众与博世在自动驾驶领域合作或告终,因项目进展缓慢、成本压力大且缺乏竞争力。大众计划另寻供应商采购软硬件,目标将技术普及至亲民车型。L3级自动驾驶预计2030年成为新车标准配置。
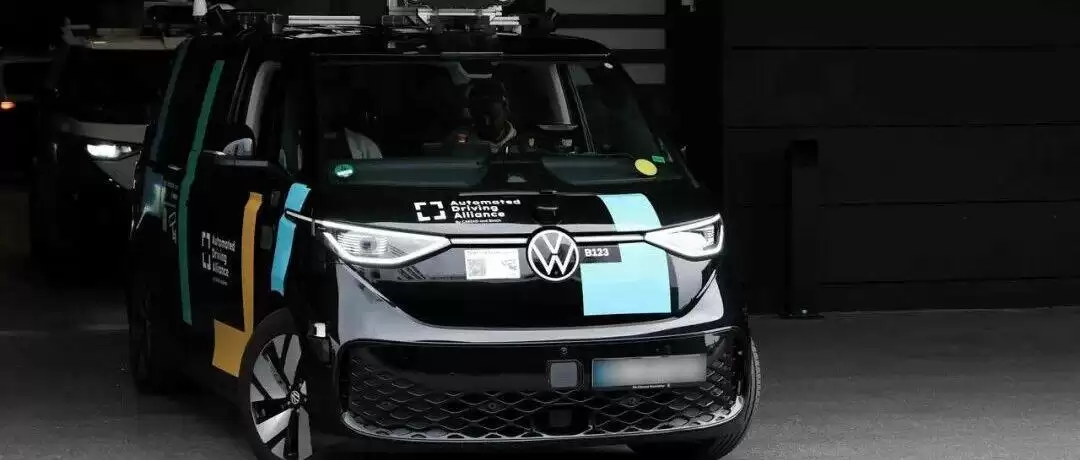

大众集团计划终止与博世在自动驾驶领域的合作,因15亿欧元投入未达预期。同时,大众酝酿激进重组,全球裁员或扩至10万人,并拟中期关停4家德国工厂,方案将于7月提交监事会。

理想汽车调整组织架构,将产品部电动本体团队并入整车研发部门,自动驾驶终端团队并入基座模型研发部门,旨在简化产品决策流程,减少沟通层级,从而提升产品定义效率与协同能力,以应对市场竞争。
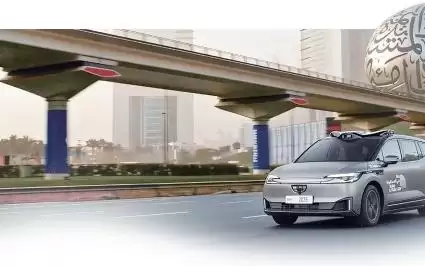
全球首个自动驾驶系统全球技术法规由中国牵头制定并发布,明确了核心技术指标与管理要求,为智驾安全落地提供统一规则,助力中国车企降低海外合规成本,推动智能新能源汽车加速全球化进程。






Windows 10 是一款微软推出的经典操作系统,拥有硬件兼容性与多任务处理能力。它更偏向把系统状态查看和常用调节动作放在一起,适合需要持续观察和微调设备状态的场景。

极度公式是一款跨平台专业LaTeX公式识别编辑软件,支持OCR公式识别和多平台编辑。和使用说明,避免使用,享受完整功能与稳定支持。做扫描整理、文字提取和表格转换时,它能把识别后的处理步骤接得更顺,资料录入这类场景会省下不少时间。
