

大模型走捷径「刷榜」?数据污染问题值得重视
生成式AI元年,大家的工作节奏快了一大截。特别是,今年大家都在努力卷大模型:最近国内外科技巨头、创业公司都在轮番推出大模型,发布会一开,个个都是重大突破,每一家都是刷新了重要Benchmark榜单,要么排第一,要么第一梯队。在兴奋于技术进展速度之快后,很多人发现似乎也有些不对味:为什么排行榜第一人人有份?这是个什么机制?于是乎,「刷榜」这个问题也开始备受关注。近日,我们关注到朋友圈和知乎社区对大模型「刷榜」这一问题的讨论越来越多。特别是,知乎一篇帖子:如何评价天工大模型技术报告中指出很多大模型用领域内数据
生成式 AI 元年,大家的工作节奏快了一大截。
特别是,今年大家都在努力卷大模型:最近国内外科技巨头、创业公司都在轮番推出大模型,发布会一开,个个都是重大突破,每一家都是刷新了重要 Benchmark 榜单,要么排第一,要么第一梯队。
在兴奋于技术进展速度之快后,很多人发现似乎也有些不对味:为什么排行榜第一人人有份?这是个什么机制?
于是乎,「刷榜」这个问题也开始备受关注。
近日,我们关注到朋友圈和知乎社区对大模型「刷榜」这一问题的讨论越来越多。特别是,知乎一篇帖子:如何评价天工大模型技术报告中指出很多大模型用领域内数据刷榜的现象?引起了大家的讨论。
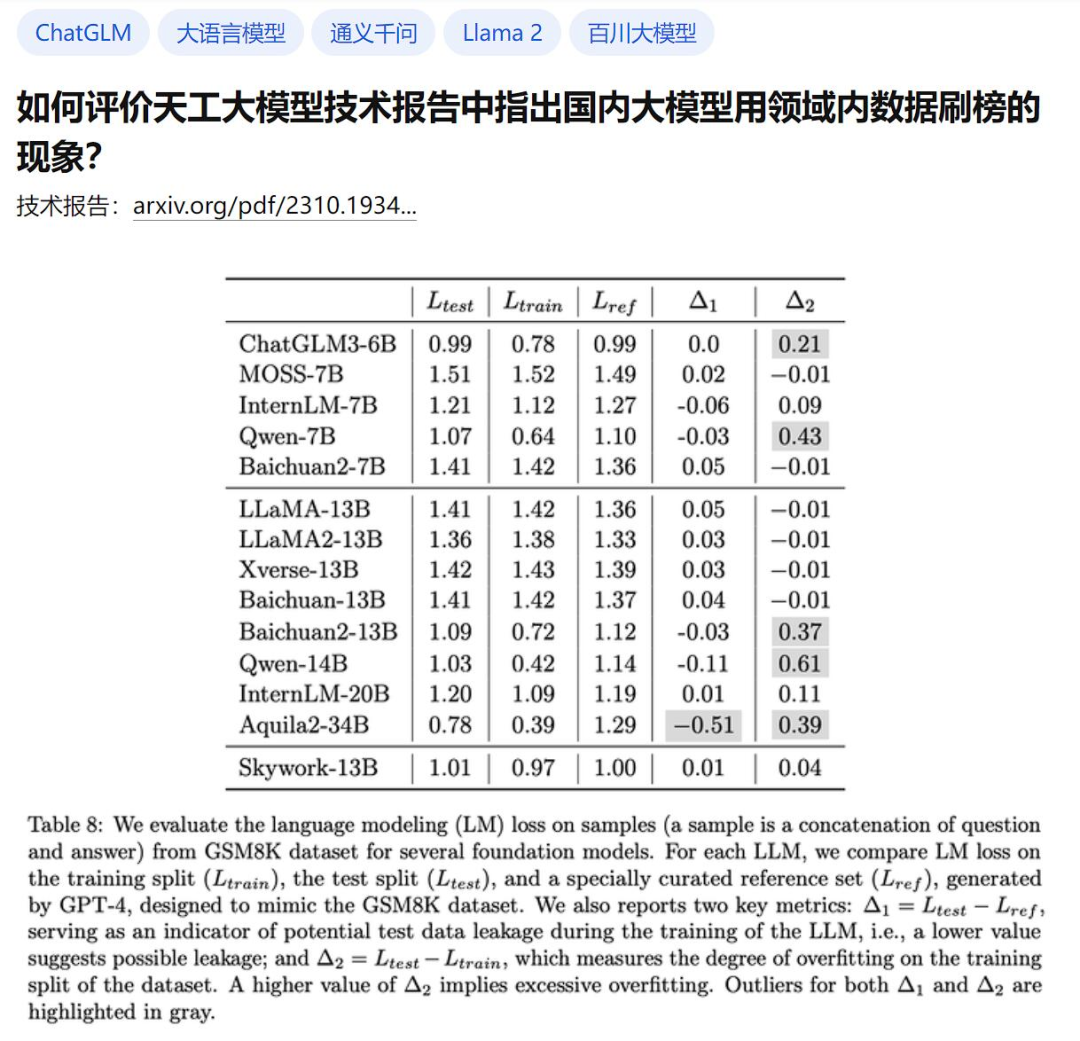
链接:https://www.zhihu.com/question/628957425
多家大模型刷榜机制曝光
该研究来自昆仑万维的「天工」大模型研究团队,他们上个月底把一份技术报告发布在了预印版论文平台 arXiv 上。
论文链接:https://arxiv.org/abs/2310.19341
论文本身是在介绍 Skywork-13B,这是天工的一个大型语言模型(LLM)系列。作者引入了使用分段语料库的两阶段训练方法,分别针对通用训练和特定领域的增强训练。
和往常有关大模型的新研究一样,作者表示在流行的测试基准上,他们的模型不仅表现出色,而且在很多中文的分支任务上取得了 state-of-art 水平(就是业内最佳)。
重点是,该报告还验证了下很多大模型的真实效果,指出了一些其他一些国产大模型存在投机取巧的嫌疑。说的就是这个表格 8:
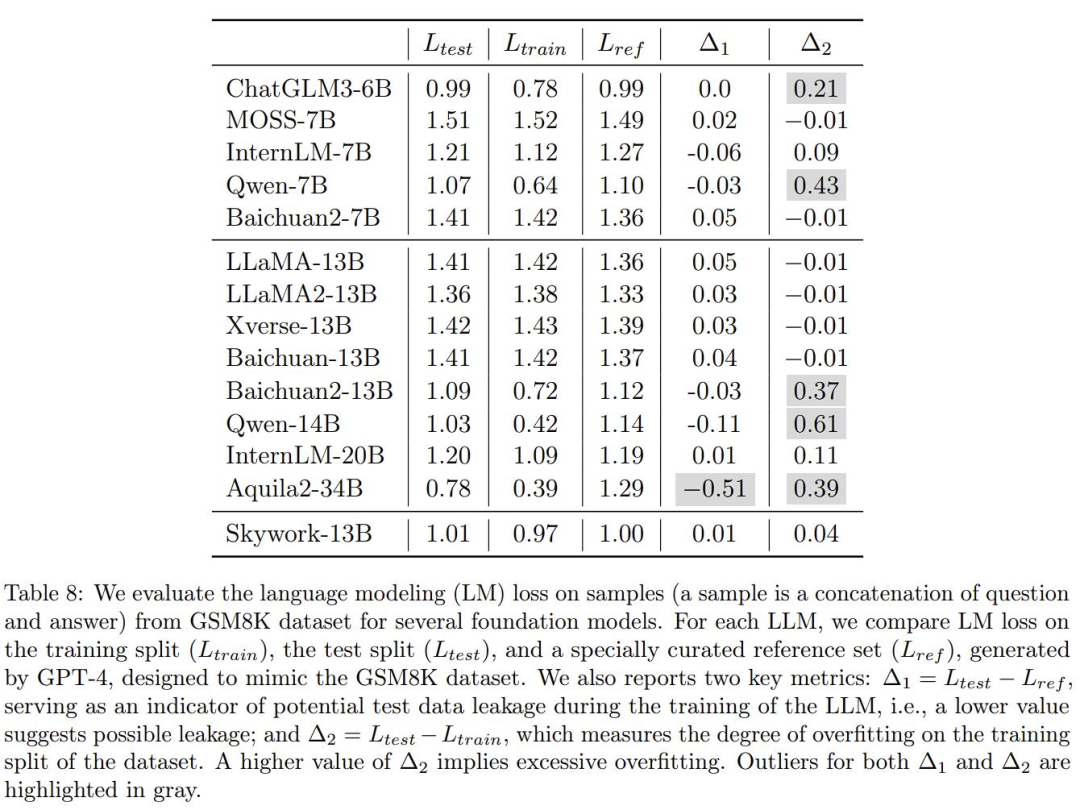
在这里,作者为了验证目前业内几个常见大模型在数学应用问题基准 GSM8K 上的过拟合程度,使用 GPT-4 生成了一些与 GSM8K 形式上相同的样本,人工核对了正确性,并让这些模型在生成的数据集,和 GSM8K 原本的训练集、测试集上比了比,计算了损失。然后还有两个指标:
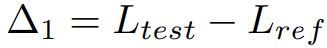
Δ1 作为模型训练期间潜在测试数据泄漏的指标,较低的值表明可能存在泄漏。没有用测试集训练,那数值应该为零。
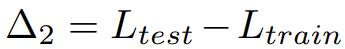
Δ2 衡量数据集训练分割的过度拟合程度。较高的 Δ2 值意味着过拟合。如果没有用训练集训练过,那数值应该为零。
用简单的话来解释就是:如果有模型在训练的时候,直接拿基准测试里面的「真题」和「答案」来当学习资料,想以此来刷分,那么此处就会有异常。
好的,Δ1 和 Δ2 有问题的地方,上面都贴心地以灰色突出显示了。
网友对此评论道,终于有人把「数据集污染」这个公开的秘密说出来了。
也有网友表示,大模型的智力水平,还是要看 zero-shot 能力,现有的测试基准都做不到。
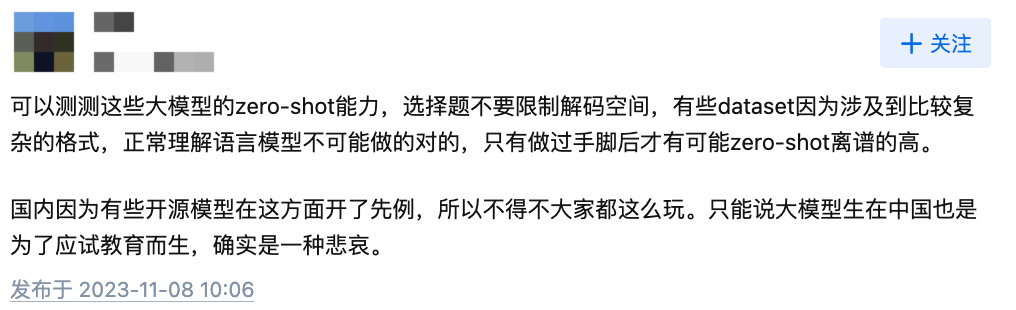
图:截图自知乎网友评论
在作者与读者中互动中,作者也表示,希望「让大家更理性看待刷榜这个事情,很多模型和 GPT4 的差距还很大」。
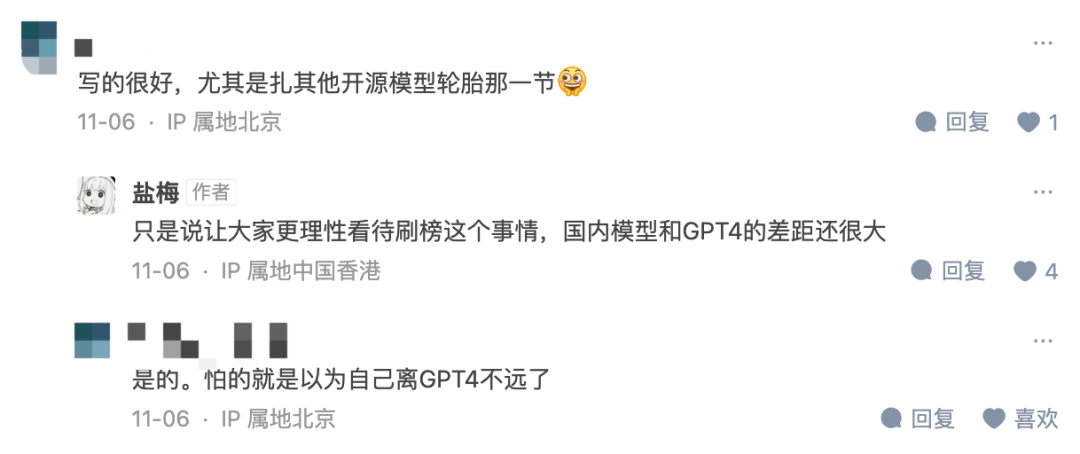
图:截图自知乎文章 https://zhuanlan.zhihu.com/p/664985891
数据污染问题值得重视
其实,这并不是一时的现象。自从有了 Benchmark,此类问题时常会有发生,就像今年 9 月份 arXiv 上一篇极具嘲讽意味的文章标题指出的一样 Pretraining on the Test Set Is All You Need。
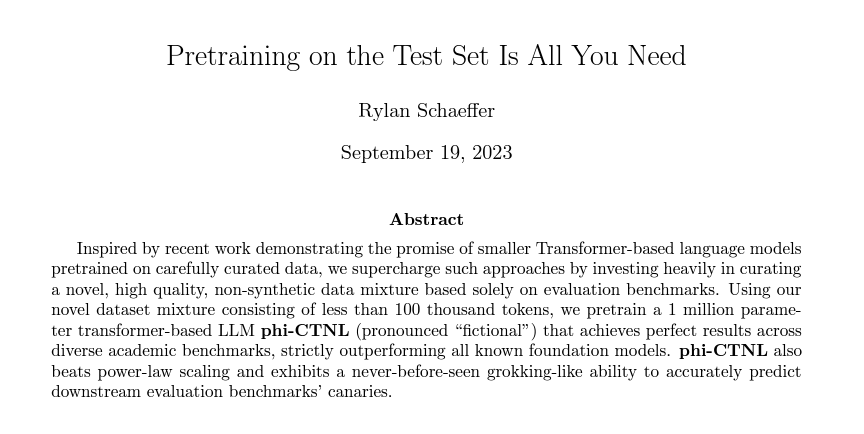
除此之外,最近人民大学、伊利诺伊大学香槟分校一个正式研究同样指出了大模型评估中存在的问题。标题很扎眼《Don't Make Your LLM an Evaluation Benchmark Cheater》:
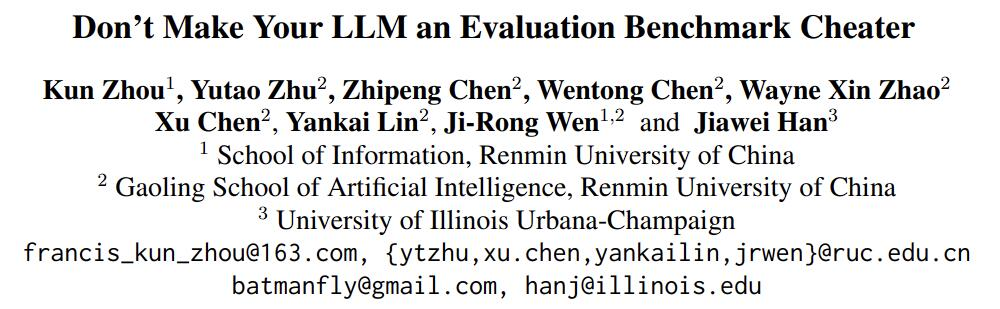
论文链接:https://arxiv.org/abs/2311.01964
论文指出,当前火热的大模型领域让人们关心基准测试的排名,但其公平性和可靠性正在受到质疑。其中主要的问题就是数据污染和泄露,这样的问题可能会被无意识地触发,因为我们在准备预训练语料库时可能不知道未来的评估数据集。例如,GPT-3 发现预训练语料库中包含了 Children's Book Test 数据集,LLaMA-2 的论文曾提到提取了 BoolQ 数据集中的上下文网页内容。
数据集是需要很多人花费大量精力收集、整理和标注的,优质的数据集如果优秀到能被用于评测,那自然也有可能会被另一些人用于训练大模型。
另一方面,在使用现有基准进行评估时,我们评测的大模型的结果大多是通过在本地服务器上运行或通过 API 调用来获得的。在此过程中,没有严格检查任何可能导致评估绩效异常提高的不当方式(例如数据污染)。
更糟糕的是,训练语料库的详细组成(例如数据源)通常被视为现有大模型的核心「秘密」。这就更难去探究数据污染的问题了。
也就是说,优秀数据的数量是有限的,在很多测试集上,GPT-4 和 Llama-2 也不一定就没问题。比如在第一篇论文中提到的 GSM8K,GPT-4 在官方 technical report 里提到过使用了它的训练集。
你不是说数据很重要吗,那么用「真题」刷分的大模型,性能会不会因为训练数据更优秀而变得更好呢?答案是否定的。
研究人员实验发现,基准泄漏会导致大模型跑出夸张的成绩:例如 1.3B 的模型可以在某些任务上超越 10 倍体量的模型。但副作用是,如果我们仅使用这些泄露的数据来微调或训练模型,这些专门应试的大模型在其他正常测试任务上的表现可能会受到不利影响。
因此作者建议,以后研究人员在评测大模型,或是研究新技术时应该:
- 使用更多来自不同来源的基准,涵盖基本能力(例如文本生成)和高级能力(例如复杂推理),以全面评估 LLM 的能力。
- 在使用评估基准时,在预训练数据和任何相关数据(例如训练和测试集)之间执行数据净化检查非常重要。此外,还需要报告评估基准的污染分析结果作为参考。如有可能,建议公开预训练数据的详细组成。
- 建议应采用多样化的测试提示来减少提示敏感性的影响。在基准数据和现有预训练语料库之间进行污染分析,提醒任何潜在的污染风险也很有意义。为了进行评估,建议每次提交都附有一份特殊的污染分析报告。
最后想说,好在这个问题开始逐渐引起大家的关注,无论是技术报告、论文研究还是社区讨论,都开始重视大模型「刷榜」的问题了。
对此,你有什么看法与有效建议呢?
在开始之前,先确认硬件已经就位:关机,把新硬盘装上,再重新开机。开机后第一件事,就是检查系统是否识别到了新设备。用 dmesg | grep ad2 看一眼,如果输出类似 ad2: 9765MB [19841/16/63] at ata1-master UDMA33 这样的信息,说明新硬盘已经被成功
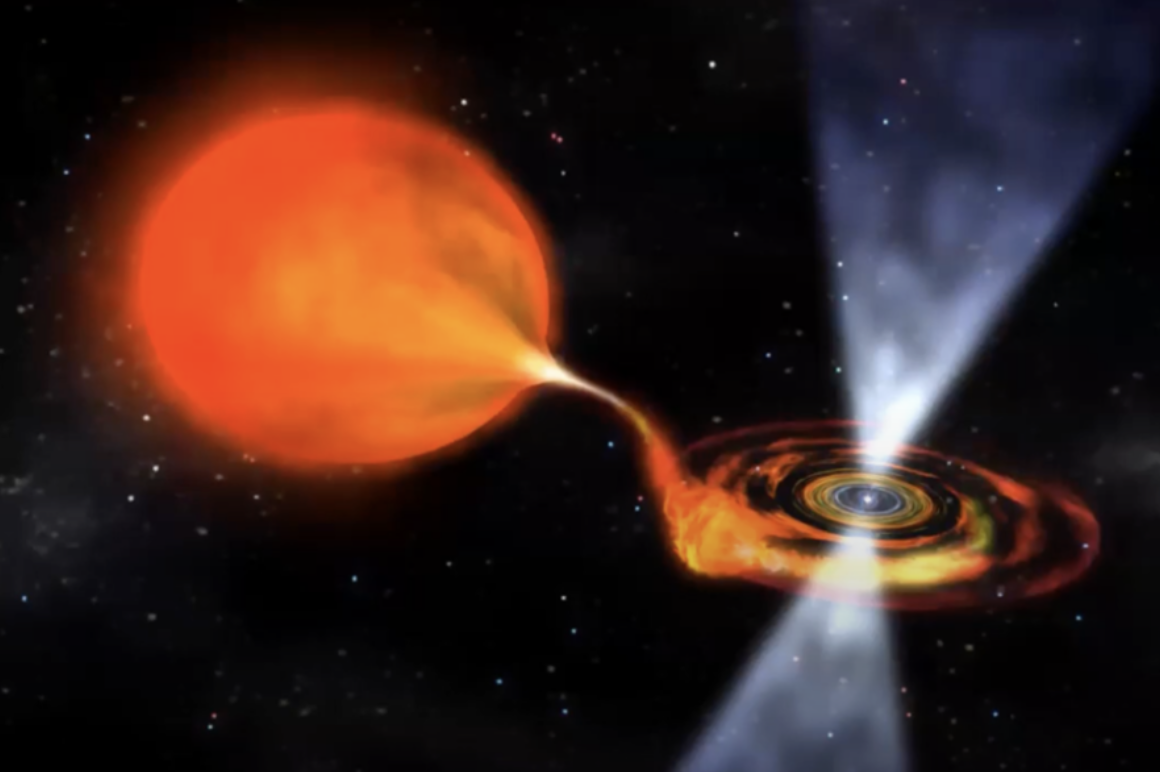
7月25日消息 天文学界最近有一项挺有意思的发现。根据中国科学院发布的信息,由南京天文光学技术研究所研究员王靓团队,联合国家天文台研究员罗阿理等人,利用LAMOST望远镜第十次公开的海量光谱数据,再结合多种测光数据,成功揪出了两颗全新的共生星,同时还锁定了12颗“仅吸积共生星”的候选体。这成果可不只
5月30日,华为推出了全新的AI模型——盘古UltraMoE,该模型的参数量达到了7180亿。作为一款接近万亿参数的MoE(MixtureofExperts)模型,它在整个训练过程中完全基于华为的昇腾AI平台完成,标志着华为在超大规模模型训练方面取得了重要进展。盘古UltraMoE的成功训练离不开盘古团队研发的一系列创新技术。例如,Depth-ScaledSandwich-Norm(DSSN)稳定架构的引入,显著改善了超大规模模型训练期间出现的梯度异常及
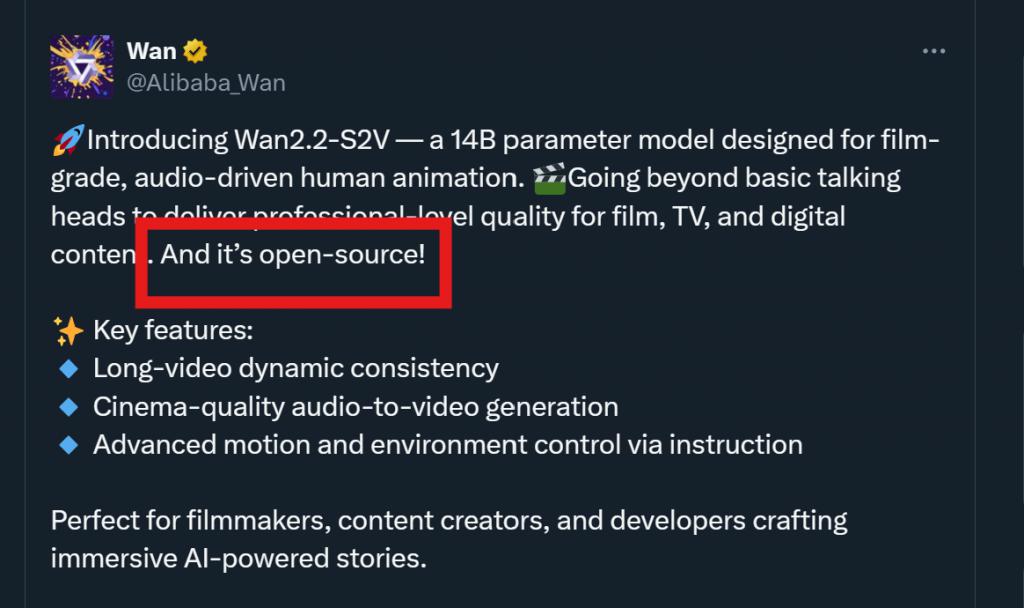
AI视频生成正迎来属于“通义”的高光时刻!就在昨晚,阿里巴巴悄然推出了一款由音频驱动的14B视频大模型——Wan2.2-S2V。只需上传一张静态图片和一段音频,就能生成出面部表情生动、口型精准匹配、肢体动作流畅自然的电影级数字人视频,效果惊艳。实际效果展示如下:△来自@AIMIRAI46487更令人振奋的是,这款新模型一经发布便全面开源,现在所有人都可以免费在通义万相官网体验使用。据官方介绍,Wan2.2-S2V的核心优势包括:支持最长分钟级的单次视频生成,画面稳定且具有一致性;具备影院级别的音
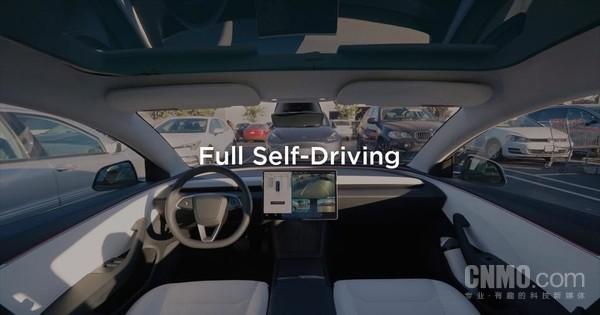
近日,有汽车领域博主爆料,特斯拉的FSD(完全自动驾驶)辅助系统将迎来一次重要升级,或将实现更真实的环境场景还原。在最新曝光的软件代码中,发现了大量新增的渲染模型,涵盖多种车辆与行人类型。这些新增模型包括救护车、消防车、垃圾清运车、校车、半挂式卡车、高尔夫球车、骑电动滑板车的行人、使用轮椅的行人、玩滑板的行人、推婴儿车的行人,以及道路清扫车、三轮车、拖车、火车和有轨电车等。这一系列高精度建模意味着FSD系统将能更准确识别并响应复杂交通参与者的行为。据CNMO掌握的消息,日本方面已为特斯拉FSD系统的落地扫
在千兆宽带、5G通信与云服务深度普及的2026年,大众普遍以为超大文件传输已步入“秒级时代”,但现实远未达到这般畅快。当面对数TB乃至数十TB级别的庞大数据集时,当下最可靠、最迅捷且兼顾安全性的传输方案,依然是“物理位移”——依靠人工携带存储介质完成跨地域交付。一位来自河南信阳的用户讲述了真实经历:他曾需将4TB资料从信阳送往郑州,首次尝试纯网络传输,系统预估总耗时近72小时;最终改用专人驱车运送,单程仅需约2.5小时,当天即完成取件与送达,整体效率显著超越线上方式。该实例迅速引发热议,多位资深IT博主随
大语言模型面对加密数据,即便最新的Qwen3也会感到压力!尽管当下各类推理模型在多种基准测试中表现优异,但在密码学这样对逻辑严谨性和细节准确性要求极高的专业领域,模型的推理能力还有待深入挖掘。密码学不仅要求模型具备高级数学运算能力和严密的逻辑推理链,还需要其能够精准辨识复杂加密模式中的潜在规律;成功解密要求模型拥有极强的综合推理能力。上海AILab等联合推出的CipherBank测评,使用大量真实隐私场景数据和多种密码算法,严苛挑战当前最先进的大模型。CipherBank的测评结果显示,目前的大语言模型





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



