

Python操作JSON数据方法解析
Python处理JSON依赖json模块,提供loads/dumps(字符串)和load/dump(文件)四函数,实现Python对象与JSON互转,注意类型映射、非字符串键、不可序列化对象等陷阱,大文件宜用ijson流式解析,结构验证可借助JSONSchema。
Python处理JSON依赖json模块,提供loads/dumps(字符串)和load/dump(文件)四函数,实现Python对象与JSON互转,注意类型映射、非字符串键、不可序列化对象等陷阱,大文件宜用ijson流式解析,结构验证可借助JSON Schema。
在Python中处理JSON数据,核心在于利用内置的json模块进行序列化(将Python对象转换为JSON格式的字符串)和反序列化(将JSON格式的字符串解析为Python对象)。这个模块提供了一套直观的API,让开发者能够轻松地在Python数据结构和JSON文本之间进行转换,无论是从网络请求获取JSON数据,还是将Python数据保存为JSON文件,都离不开它的帮助。
解决方案
Python内置的json模块是操作JSON数据的首选工具。它提供了一对核心函数用于字符串操作,以及一对用于文件操作。
1. 解析JSON数据(从JSON到Python对象)
当你拿到一个JSON格式的字符串或者文件,需要将其内容转换为Python可以识别的数据结构(通常是字典和列表)时,会用到以下方法:
json.loads(json_string): 这个函数用于将一个JSON格式的字符串(s代表string)解析成Python对象。import json json_str = '{"name": "张三", "age": 30, "isStudent": false, "courses": ["Math", "Physics"], "grades": {"Math": 90, "Physics": 85}}' try: data = json.loads(json_str) print("解析后的Python对象类型:", type(data)) print("姓名:", data["name"]) print("年龄:", data["age"]) print("第一门课程:", data["courses"][0]) except json.JSONDecodeError as e: print(f"JSON解析错误: {e}")这里需要注意的是,JSON中的
true、false、null会分别映射到Python的True、False、None。json.load(file_object): 如果你的JSON数据存储在一个文件中,这个函数(没有s,直接加载文件)可以直接从一个文件对象中读取并解析JSON数据。# 假设有一个名为 'data.json' 的文件,内容如下: # { # "city": "北京", # "population": 21540000, # "landmarks": ["故宫", "长城"] # } # 首先创建一个示例文件 with open('data.json', 'w', encoding='utf-8') as f: f.write('{"city": "北京", "population": 21540000, "landmarks": ["故宫", "长城"]}') with open('data.json', 'r', encoding='utf-8') as f: file_data = json.load(f) print("\n从文件加载的数据:", file_data) print("城市:", file_data["city"])
2. 生成JSON数据(从Python对象到JSON)
当你想把Python中的字典、列表等数据结构转换成JSON格式的字符串,以便存储、传输或与API交互时,会用到以下方法:
json.dumps(python_object): 这个函数用于将Python对象(s代表string)序列化成JSON格式的字符串。python_dict = { "product_id": "P001", "name": "智能手机", "price": 4999.99, "available": True, "features": ["拍照", "游戏", "通话"], "specs": {"RAM": "8GB", "Storage": "128GB"} } json_output_str = json.dumps(python_dict) print("\n生成的JSON字符串:", json_output_str) # 格式化输出,使其更具可读性 formatted_json_output = json.dumps(python_dict, indent=4, ensure_ascii=False) print("\n格式化后的JSON字符串:\n", formatted_json_output)indent参数可以指定缩进级别,让JSON输出更易读。ensure_ascii=False可以确保非ASCII字符(如中文)直接输出,而不是转义成\uXXXX形式。json.dump(python_object, file_object): 如果你想直接将Python对象序列化并写入文件,这个函数可以直接完成。new_data = { "user_id": "U007", "username": "coder_seven", "email": "seven@example.com", "settings": {"notifications": True, "theme": "dark"} } with open('user_profile.json', 'w', encoding='utf-8') as f: json.dump(new_data, f, indent=4, ensure_ascii=False) print("\n数据已写入 'user_profile.json' 文件。")写入文件时,同样推荐使用
indent和ensure_ascii=False来提高可读性和处理非ASCII字符。
小结: 记住s代表字符串(loads/dumps),没有s代表文件(load/dump),这样区分起来就容易多了。
在处理大型JSON文件时,Python有哪些高效策略?
处理大型JSON文件,特别是那些无法一次性加载到内存中的文件,确实是个挑战。如果直接使用json.load(),内存溢出是家常便饭。我的经验是,这时候需要一些更巧妙的策略。
首先,要明确“大型”的定义。如果文件只是几十MB,json.load()配合充足的内存可能还行。但如果到了几百MB甚至GB级别,那我们就得换个思路了。
一个非常实用的方法是流式解析(Streaming Parsing)。标准库的json模块设计上是读取整个JSON结构后才进行解析的,这对于大文件显然不适用。这时候,像ijson这样的第三方库就派上用场了。ijson库允许你以迭代器的方式解析JSON,只在需要时才读取和处理文件的一部分,极大地降低了内存占用。
举个例子,假设你有一个巨大的JSON文件,里面是一个包含成千上万个用户对象的数组:
[
  {"id": 1, "name": "Alice", "email": "alice@example.com"},
  {"id": 2, "name": "Bob", "email": "bob@example.com"},
  // ... 更多用户数据
]使用ijson,你可以这样迭代处理每个用户:
import ijson
import json # 用于打印美观

# 假设 large_users.json 已经存在并包含上述结构的大量数据
# 为了演示,我们先创建一个模拟的大文件
sample_data = [{"id": i, "name": f"User_{i}", "email": f"user_{i}@example.com"} for i in range(10000)]
with open('large_users.json', 'w', encoding='utf-8') as f:
    json.dump(sample_data, f)


print("\n使用 ijson 进行流式解析:")
try:
    with open('large_users.json', 'rb') as f: # 注意 'rb' 模式
        # 'item' 是 JSON 数组中的每个元素
        # 如果是 JSON 对象中的某个键,例如 {"data": [...]},则可能是 'data.item'
        for user_obj in ijson.items(f, 'item'):
            # 这里可以对每个 user_obj 进行处理,而不需要加载整个文件
            # print(user_obj) # 实际应用中可能不需要打印,而是进行业务逻辑处理
            if user_obj['id'] == 5000:
                print(f"找到 ID 为 5000 的用户: {user_obj['name']}")
                break # 找到目标后可以提前退出
except FileNotFoundError:
    print("错误: large_users.json 文件不存在。")
except Exception as e:
    print(f"ijson 解析发生错误: {e}")
这种方式的内存消耗几乎是恒定的,因为它一次只处理一个JSON对象。
另一个不那么“流式”但有时也有效的策略是分块读取文件,但这通常更适用于JSON Lines格式(每行一个独立的JSON对象)而不是单个巨大的JSON数组或对象。如果你的文件是JSON Lines格式,那么逐行读取然后用json.loads()解析每一行会非常高效。
最后,如果性能是极致追求,可以考虑一些用C语言编写的JSON库,比如ujson或orjson。它们在序列化和反序列化速度上通常比标准库快很多,尽管它们仍然会一次性加载整个JSON结构到内存。对于内存不是问题,但CPU是瓶颈的场景,它们能提供显著的加速。
总之,面对大文件,流式解析是首选,它能有效控制内存;如果文件结构允许,JSON Lines配合逐行读取也很好;而对于追求速度且内存充足的情况,可以考虑更快的C实现库。
Python对象与JSON数据类型映射的细节与常见陷阱
Python对象和JSON数据类型之间的映射,初看起来很简单,但深入细节会发现一些需要注意的地方,尤其是一些常见陷阱。理解这些映射关系对于避免序列化错误至关重要。
标准映射关系:
| Python类型 | JSON类型 | 备注 |
|---|---|---|
dict | object | JSON对象的键必须是字符串 |
list, tuple | array | Python的元组和列表都映射到JSON数组 |
str | string | |
int, float | number | Python的整数和浮点数映射到JSON数字 |
True | true | 布尔真 |
False | false | 布尔假 |
None | null | 空值 |
常见陷阱与解决方案:
非字符串键的字典:
- 陷阱: JSON对象的键必须是字符串。如果你的Python字典键是整数或其他非字符串类型,
json.dumps()在默认情况下会将其转换为字符串。这通常不是问题,但如果你期望键保持其原始类型,就可能导致混淆。 - 示例:
my_dict = {1: "value"}序列化后会变成{"1": "value"}。 - 解决方案: 确保在序列化前,字典的键都是字符串类型。如果需要,可以手动转换。
- 陷阱: JSON对象的键必须是字符串。如果你的Python字典键是整数或其他非字符串类型,
不可序列化的对象:
陷阱: 并非所有Python对象都能直接序列化为JSON。例如,
set集合、datetime对象、自定义类的实例等,默认情况下json模块无法处理它们,会抛出TypeError。示例:
import datetime
data_with_unserializable = {
    "name": "Test",
    "timestamp": datetime.datetime.now(),
    "items": {1, 2, 3} # 集合
}
# json.dumps(data_with_unserializable) # 这会抛出 TypeError
解决方案:
自定义序列化函数 (
default参数):json.dumps()和json.dump()都接受一个default参数,它是一个函数,当遇到无法序列化的对象时会被调用。你可以在这个函数中定义如何处理这些特殊类型。def default_serializer(obj): if isinstance(obj, datetime.datetime): return obj.isoformat() # 将datetime对象转换为ISO格式字符串 if isinstance(obj, set): return list(obj) # 将集合转换为列表 raise TypeError(f"Object of type {obj.__class__.__name__} is not JSON serializable") json_output = json.dumps(data_with_unserializable, default=default_serializer, indent=4, ensure_ascii=False) print("\n使用 default_serializer 后的 JSON:\n", json_output)自定义JSON编码器 (
json.JSONEncoder): 对于更复杂的场景,可以继承json.JSONEncoder并重写其default方法。class CustomEncoder(json.JSONEncoder): def default(self, obj): if isinstance(obj, datetime.datetime): return obj.isoformat() if isinstance(obj, set): return list(obj) return json.JSONEncoder.default(self, obj) # 让基类处理其他类型 json_output_encoder = json.dumps(data_with_unserializable, cls=CustomEncoder, indent=4, ensure_ascii=False) print("\n使用 CustomEncoder 后的 JSON:\n", json_output_encoder)
浮点数精度问题:
- 陷阱: JSON标准对数字的精度没有严格限制,但浮点数在计算机内部的表示方式决定了它们可能存在精度问题。当Python的
float类型序列化为JSON,再反序列化回来时,可能会出现微小的精度损失。 - 解决方案: 对于需要高精度计算的场景,尽量避免直接使用浮点数,可以考虑将数字转换为字符串进行存储,或者使用
decimal模块处理高精度数值,在序列化前将其转换为字符串。
- 陷阱: JSON标准对数字的精度没有严格限制,但浮点数在计算机内部的表示方式决定了它们可能存在精度问题。当Python的
编码问题 (
ensure_ascii):陷阱: 默认情况下,
json.dumps()会将所有非ASCII字符转义为\uXXXX形式。这在某些情况下可能不是你想要的,比如当你希望JSON文件直接包含UTF-8字符时。解决方案: 设置
ensure_ascii=False。chinese_data = {"message": "你好,世界!"} ascii_json = json.dumps(chinese_data) print("\n默认 ASCII 转义:", ascii_json) # {"message": "\u4f60\u597d\uff0c\u4e16\u754c\uff01"} utf8_json = json.dumps(chinese_data, ensure_ascii=False) print("禁用 ASCII 转义:", utf8_json) # {"message": "你好,世界!"}同时,在文件操作时,确保以
encoding='utf-8'模式打开文件。
理解这些细节和陷阱,能够帮助你更健壮、更灵活地处理Python和JSON之间的数据转换。
如何确保JSON数据的结构化和有效性?
确保JSON数据的结构化和有效性是数据处理中的一个关键环节,尤其是在API交互、数据存储或数据交换的场景下。仅仅能解析或生成JSON是不够的,我们还需要验证其内容是否符合预期。
1. 基本语法有效性(json.loads()自带的验证)
最基础的有效性检查,其实在你尝试用json.loads()或json.load()解析JSON数据时就已经完成了。如果JSON字符串或文件不符合JSON规范(例如,缺少引号、逗号、括号不匹配等),json模块会立即抛出json.JSONDecodeError。这是第一道防线,它确保了你处理的是合法的JSON文本。
import json

malformed_json = '{"name": "Alice", "age": 30,' # 缺少闭合括号
try:
    data = json.loads(malformed_json)
except json.JSONDecodeError as e:
    print(f"\n捕获到 JSON 语法错误: {e}")
这虽然能检查语法,但无法验证数据的“语义”——比如某个字段是否是数字,某个列表是否包含特定数量的元素。
2. 结构和内容有效性(JSON Schema)
要进行更深层次的验证,确保JSON数据不仅语法正确,而且其结构、数据类型和值范围都符合预设的规范,我们需要引入JSON Schema。JSON Schema是一种强大的工具,它用JSON自身来描述JSON数据的结构。你可以把它想象成XML的DTD或XSD,但它是为JSON设计的。
使用JSON Schema通常需要一个第三方库,例如jsonschema。
JSON Schema 的核心思想:
- 定义规则: 你会创建一个JSON对象,其中包含描述你的数据应该是什么样的规则(例如,
type、properties、required、minimum、maximum、enum等)。 - 验证数据: 然后,你使用
jsonschema库将你的JSON数据与这个Schema进行比对。如果数据不符合Schema定义的规则,验证器会抛出异常或返回错误列表。
示例:
假设我们期望的用户数据应该包含一个字符串name和一个整数age,并且age必须大于0。
from jsonschema import validate
from jsonschema.exceptions import ValidationError
import json

# 1. 定义 JSON Schema
user_schema = {
    "type": "object",
    "properties": {
        "name": {"type": "string", "description": "用户的姓名"},
        "age": {"type": "integer", "minimum": 0, "description": "用户的年龄,必须是非负整数"}
    },
    "required": ["name", "age"] # 规定 name 和 age 字段是必需的
}

# 2. 准备要验证的 JSON 数据
valid_user_data = {"name": "Bob", "age": 25}
invalid_user_data_missing_age = {"name": "Charlie"} # 缺少 age
invalid_user_data_wrong_type = {"name": "David", "age": "thirty"} # age 类型错误
invalid_user_data_negative_age = {"name": "Eve", "age": -5} # age 小于 minimum

print("\n开始 JSON Schema 验证:")

# 3. 进行验证
try:
    validate(instance=valid_user_data, schema=user_schema)
    print("Valid User Data: 验证通过!")
except ValidationError as e:
    print(f"Valid User Data: 验证失败!错误: {e.message}")

try:
    validate(instance=invalid_user_data_missing_age, schema=user_schema)
    print("Invalid User Data (missing age): 验证通过!")
except ValidationError as e:
    print(f"Invalid User Data (missing age): 验证失败!错误: {e.message}")

try:
    validate(instance=invalid_user_data_wrong_type, schema=user_schema)
    print("Invalid User Data (wrong age type): 验证通过!")
except ValidationError as e:
print(f"Invalid User Data (wrong age 
答案:try-except-else-finally结构通过分离正常执行、异常处理、成功分支和资源清理,实现精准错误捕获与资源管理。try块封装可能出错的代码,except按类型捕获特定异常并响应,else在无异常时执行成功逻辑,finally确保无论状态如何都完成清理工作,如关闭文件或释放资源,提升代码健壮性与可维护性。
最推荐的方式是使用Python内置的logging模块,它通过Logger、Handler、Formatter组件实现灵活的日志分级、格式化和多目标输出,远优于print()。

作为一种高级编程语言,Python以其简洁易学、多样化的库支持和强大的能力受到了广泛的开发者们的青睐。而一些常见的代码错误,例如缺少接口设计错误,可能会造成代码的低效和不可靠,甚至危及系统的健壮性和可维护性。在本文中,我们将探讨如何解决Python代码中缺少接口设计错误的问题。缺少接口设计错误在Python语言中,接口是指类或函数在程序中暴露给其
Python作为一种简单易学的编程语言,其语法规则十分严谨。其中一个常见问题是对代码空格的使用不规范,这经常会导致程序运行错误。以下是几种避免Python代码中空格使用不规范错误的方法:使用空格而不是制表符在Python中,程序中的缩进是代码结构的一部分,所以正确的缩进非常重要。通常情况下,缩进使用空格,而不是制表符,这是因为制表符在不同的编辑器中会有不同的
Ponytail面向已使用AI编程助手并希望优化代码质量的开发者,以及负责维护旧项目或审查AI生成代码的技术人员。它提供了一套可重复加载的开发判断规则,帮助用户减少冗余代码、梳理数据流并评估技术选型。虽然非编程人员也可提出任务,但仍需具备一定技术判断力来核对兼容性、行为逻辑及必要检查项。本文详解其在代码审查、旧项目维护及前端原生能力评估中的具体应用路径。
面向在Cursor或Codex中配置Impeccable技能的用户,解决安装后命令无法调用、菜单不显示或钩子无响应的问题。本文梳理从终端环境检查到工具重载的完整路径:确认Node.js与PATH配置,区分npx终端命令与聊天助手指令(如/impeccable audit),通过/impeccable check和update管理版本,利用/impeccable doctor修复配置漂移,并单独核对/hooks状态以排除权限干扰,避免盲目重装导致配置覆盖。
面向希望利用 DeepSeek SuperAgent 辅助开发但缺乏编程背景的用户,本文解析其实际使用门槛。虽然任务派发可通过自然语言完成,适合业务人员整理需求,但独立部署、环境配置及代码审阅仍需技术基础。文章说明安装时的账号权限管理要点,指导如何通过面板监控任务状态,并强调在无人负责技术维护时不宜盲目自动化,需由专业人员验收代码以确保安全。
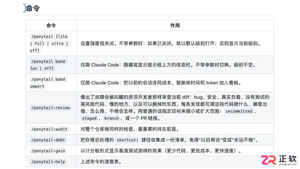
面向使用Claude Code进行开发的程序员,Ponytail插件旨在通过引导AI助手优先复用现有能力来控制新增代码规模。本文介绍其核心用途:在开发任务中减少不必要代码编写,通过“/ponytail-review”命令审查暂存改动的安全性与可维护性,以及利用“/ponytail-debt”整理带有明确限制的开发捷径和技术债务。使用前需根据安装方式确认宿主支持的具体命令和自动加载功能。
Impeccable面向已使用AI编程工具并希望优化界面清晰度的个人开发者、前端工程师及产品维护团队。它不要求用户精通设计术语,但需能明确描述用户目标与限制条件。本文介绍三类典型应用场景:个人开发者利用shape命令梳理需求边界,避免开发蔓延;团队通过document命令提取视觉规则至DESIGN.md以保持风格一致;维护者使用harden命令检查表单等界面的边缘状态。适用前提是手头有真实的界面设计或改进需求。
面向需要在无网或受限网络环境下使用Graphify的开发者,明确其离线运行的边界条件。纯代码构图和读取本地图谱可在依赖就绪后完全离线进行;文档语义处理需预先配置本地Ollama模型并指定后端。本文详解如何通过--code-only参数避免联网调用、如何准备本地模型环境,以及区分本地文件读取与远程MCP服务连接的关键步骤,帮助用户实现真正的本地化知识图谱构建。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



