

Spring Data @PersistenceCreator深度解析指南
@PersistenceCreator注解在SpringData中扮演着关键角色,它明确指示框架在从数据存储中物化持久化实体时应使用哪个构造函数或静态工厂方法。这对于处理包含final字段的实体尤为重要,因为它确保了这些字段在对象创建时能被正确初始化,从而避免“final字段未初始化”的编译错误,并为复杂的实体构造逻辑提供了清晰的指导。

@PersistenceCreator注解的作用
在Spring Data应用中,当框架从数据库加载数据并将其映射到Java实体对象时,它需要知道如何实例化这些对象。通常,Spring Data会尝试自动检测一个合适的构造函数来完成这一任务。然而,在某些场景下,这种自动检测机制可能不够明确,尤其是在实体类包含多个构造函数或定义了final字段时。
@PersistenceCreator注解正是为了解决这些问题而设计的。它允许开发者显式地标记一个构造函数或静态工厂方法,告诉Spring Data:“请使用这个方法来创建我的实体对象。”这对于以下情况至关重要:
- 处理final字段: 当实体类中包含final字段时,这些字段必须在构造函数中被初始化。如果没有一个明确的构造函数来接收并设置这些final字段的值,编译器会报错。@PersistenceCreator确保Spring Data使用指定的构造函数,并传入从数据存储中检索到的数据来初始化这些final字段。
- 多个构造函数: 如果一个实体类有多个构造函数,Spring Data可能无法确定应该使用哪一个。通过@PersistenceCreator,开发者可以明确指定一个作为持久化操作的首选构造函数。
- 静态工厂方法: 除了构造函数,@PersistenceCreator也可以用于标记一个静态工厂方法,允许通过更灵活的工厂模式来创建实体实例。
Spring Data的构造器解析算法
Spring Data在尝试物化实体对象时,遵循一套明确的构造器或工厂方法解析算法。理解这套算法对于正确使用@PersistenceCreator至关重要:
- 首选静态工厂方法: 如果实体类中存在一个被@PersistenceCreator注解标记的静态工厂方法,Spring Data将优先使用它来创建对象。
- 单一构造函数: 如果实体类中只有一个构造函数(无论是否有@PersistenceCreator注解),Spring Data将使用这个唯一的构造函数。
- 多构造函数与@PersistenceCreator: 如果存在多个构造函数,并且其中恰好有一个被@PersistenceCreator注解标记,那么Spring Data将使用这个被标记的构造函数。
- Java Record: 对于Java Record类型,Spring Data会自动使用其规范构造函数(canonical constructor)。
- 无参构造函数: 如果以上规则都不适用,并且实体类提供了一个无参构造函数,Spring Data将使用这个无参构造函数。此时,其他带有参数的构造函数将被忽略。
从上述规则可以看出,@PersistenceCreator注解在有歧义(如多个构造函数)或需要指定特定创建逻辑(如静态工厂方法)时,提供了明确的指导。
示例代码与应用
考虑一个User实体类,其中包含多个final字段。为了确保这些字段在从数据库加载数据时能够被正确初始化,我们需要一个接收所有这些字段作为参数的构造函数,并使用@PersistenceCreator来明确指定它。
import org.springframework.data.annotation.Id;
import org.springframework.data.annotation.PersistenceCreator;
import org.springframework.data.mongodb.core.mapping.Document;
import org.springframework.data.mongodb.core.mapping.Field;

@Document("users") // 假设这是一个MongoDB实体
public class User {
    @Id
    private final int id;
    @Field("user_name")
    private final String userName;
    private final String password;
    private final boolean active;
    private final String roles;
    @Field("from_phone_number_id")
    private final String fromPhoneNumberId;
    @Field("access_token")
    private final String accessToken;

    // 使用 @PersistenceCreator 标记此构造函数
    // 确保Spring Data在从数据库加载User对象时,使用此构造函数来初始化所有final字段
    @PersistenceCreator
    public User(int id, String userName, String password, boolean active, String roles, String fromPhoneNumberId,
                String accessToken) {
        this.id = id;
        this.userName = userName;
        this.password = password;
        this.active = active;
        this.roles = roles;
        this.fromPhoneNumberId = fromPhoneNumberId;
        this.accessToken = accessToken;
    }

    // 省略 getter 方法
    public int getId() { return id; }
    public String getUserName() { return userName; }
    public String getPassword() { return password; }
    public boolean isActive() { return active; }
    public String getRoles() { return roles; }
    public String getFromPhoneNumberId() { return fromPhoneNumberId; }
    public String getAccessToken() { return accessToken; }
}
在这个例子中,User类的所有字段都被声明为final。这意味着它们必须在构造函数中被初始化。通过在唯一的一个全参数构造函数上添加@PersistenceCreator注解,我们明确告诉Spring Data,当它从数据库中读取User数据时,应该调用这个特定的构造函数,并将查询到的字段值作为参数传递进去。这样,final字段的初始化问题便得到了优雅的解决。
注意事项与最佳实践
- 唯一性: 在一个实体类中,通常只应有一个构造函数或静态工厂方法被@PersistenceCreator注解标记。如果标记了多个,Spring Data可能会抛出异常或行为不可预测。
- 参数匹配: 被@PersistenceCreator标记的构造函数或工厂方法的参数名称和类型应尽可能与实体字段(或数据库列)的名称和类型匹配。Spring Data会尝试通过名称匹配来绑定数据。如果名称不匹配,可能需要使用@Field注解来指定数据库列名。
- 非必要情况: 如果你的实体类只有一个构造函数,或者只有一个无参构造函数且没有final字段,那么@PersistenceCreator通常不是强制性的,因为Spring Data的解析算法会自动选择它。然而,为了代码的清晰性和未来的可维护性,即使在这些情况下,显式地标记也是一个不错的实践。
- 与@Builder等模式结合: 在使用如Lombok的@Builder注解生成构建器模式时,通常会生成一个全参数构造函数。如果需要Spring Data使用这个构造函数,也应在其上添加@PersistenceCreator。
- 静态工厂方法: 考虑使用静态工厂方法来创建实体,尤其是在构造逻辑复杂或需要提供不同构造路径时。这可以提高代码的封装性和可读性。
总结
@PersistenceCreator注解是Spring Data提供的一个强大工具,用于精确控制实体对象的实例化过程。它解决了final字段初始化、多构造函数歧义等常见问题,确保了数据从持久化存储到Java对象模型的顺畅转换。通过理解其解析算法并遵循最佳实践,开发者可以构建出更加健壮、可维护的Spring Data应用程序。

GitHub合并故障中的“已缓解并监控”和“已解决”不能互换。前者表示影响已经采取措施缓解,仍在观察稳定性;后者是供应商正式结束这场事故的状态。11月13日的Pull Requests合并超时事件先进入监控,随后于北京时间11月14日02:29标记为已解决。
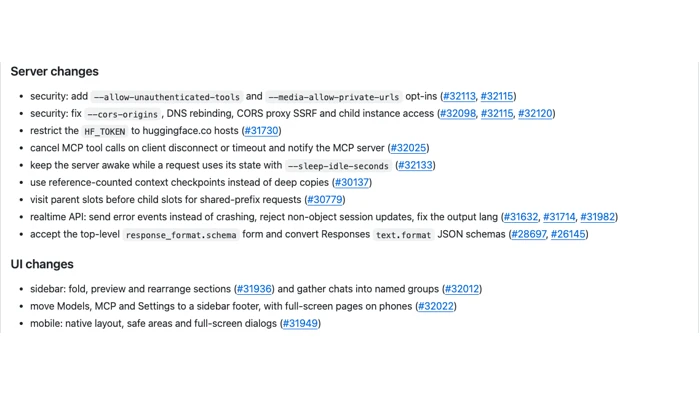
llama.cpp v1.0.0改善聊天组织、长消息编辑和附件预览;界面变化与底层API迁移、缓存及访问边界需要分别理解。
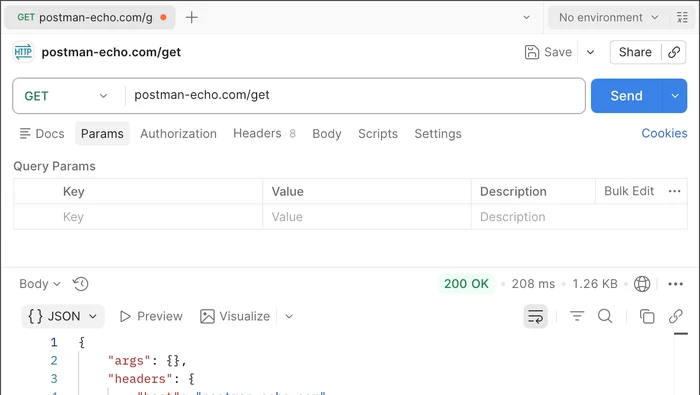
Postman 12.36.4 更新后仍有异常时,可按应用、API请求和平台服务区分问题范围,避免把补丁版本当作故障原因。
按正式、预发布和1.x维护渠道对应补丁,再结合Redis、Agent端点和Pinecone索引判断适用范围。
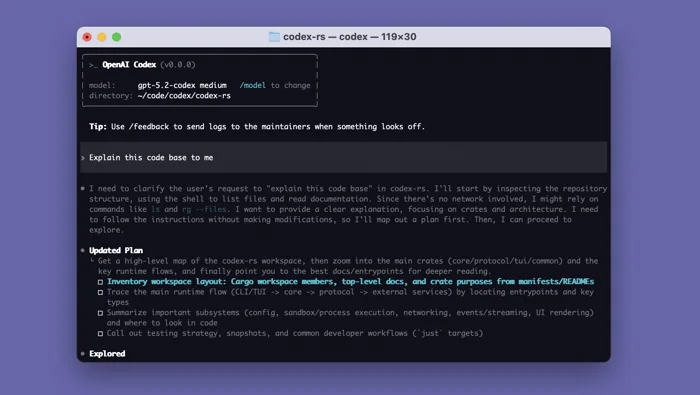
Codex CLI 0.169.0提供有明确说明的终端工作区能力;0.171.0-alpha.2为预发布,当前没有功能清单,选用时应分开评估。
llama.cpp b12345的预发布构建为Hexagon HTP后端增加Q5_0和Q5_1支持。选择模型时需要核对完整量化名称及实际运行后端,不能只看到“Q5”就视为同一种格式。
llama.cpp b12344的预发布构建调整了MCP工具调用的取消行为:客户端断连或调用超时时,服务器会向MCP服务发送带请求ID的取消通知。使用服务端工具的Web界面也属于这项变更范围。
GitHub对11月5日Actions与Checks事件的新增复盘指出:数据库服务在高并发大读请求下耗尽资源,导致部分运行无法排队或执行失败。检查类似问题时,先比对平台事件时间与失败状态,再决定是否重试自己的工作流。
GitHub对11月9日Actions事件的新增复盘说明:数据库迁移后,新区域容量与速率限制不足导致请求被拒,部分运行在服务恢复后仍占用并发。排查自己的工作流时,应把平台状态、运行状态与应用代码错误分开核对。
llama.cpp b12342新增面向少列矩阵计算的CUDA量化内核,覆盖2至24个src1列等场景,例如推测解码的验证阶段。新增内核针对Ampere及更新的NVIDIA GPU,并限定于发行说明列出的量化类型;它不是所有硬件与模型都会得到相同收益的通用开关。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



