当前位置:

首页 > 业界资讯 > PyTorch团队重写「分割一切」模型,比原始实现快8倍

PyTorch团队重写「分割一切」模型,比原始实现快8倍

我们该如何优化Meta的「分割一切」模型,PyTorch团队撰写的这篇博客由浅入深的帮你解答。从年初到现在,生成式AI发展迅猛。但很多时候,我们又不得不面临一个难题:如何加快生成式AI的训练、推理等,尤其是在使用PyTorch的情况下。本文PyTorch团队的研究者为我们提供了一个解决方案。文章重点介绍了如何使用纯原生PyTorch加速生成式AI模型,此外,文章还介绍了PyTorch新功能,以及如何组合这些功能的实际示例。结果如何呢?PyTorch团队表示,他们重写了Meta的「分割一切」(SAM)模型,

我们该如何优化 Meta 的「分割一切」模型,PyTorch 团队撰写的这篇博客由浅入深的帮你解答。
从年初到现在,生成式 AI 发展迅猛。但很多时候,我们又不得不面临一个难题:如何加快生成式 AI 的训练、推理等,尤其是在使用 PyTorch 的情况下。

本文 PyTorch 团队的研究者为我们提供了一个解决方案。文章重点介绍了如何使用纯原生 PyTorch 加速生成式 AI 模型,此外,文章还介绍了 PyTorch 新功能,以及如何组合这些功能的实际示例。

结果如何呢?PyTorch 团队表示,他们重写了 Meta 的「分割一切」 (SAM) 模型,从而使代码比原始实现快 8 倍,并且没有损失准确率,所有这些都是使用原生 PyTorch 进行优化的。 

PyTorch团队重写「分割一切」模型,比原始实现快8倍

博客地址:https://pytorch.org/blog/accelerating-generative-ai/

看完本文,你将了解到:

  • Torch.compile:PyTorch 模型编译器, PyTorch 2.0 加入了一个新的函数,叫做 torch.compile (),能够通过一行代码对已有的模型进行加速;
  • GPU 量化:通过降低运算精度来加速模型;
  • SDPA(Scaled Dot Product Attention ):内存高效的注意力实现方式;
  • 半结构化 (2:4) 稀疏性:一种针对 GPU 优化的稀疏内存格式;
  • Nested Tensor:Nested Tensor 把 {tensor, mask} 打包在一起,将非均匀大小的数据批处理到单个张量中,例如不同大小的图像;
  • Triton 自定义操作:使用 Triton Python DSL 编写 GPU 操作,并通过自定义操作符注册轻松将其集成到 PyTorch 的各种组件中。
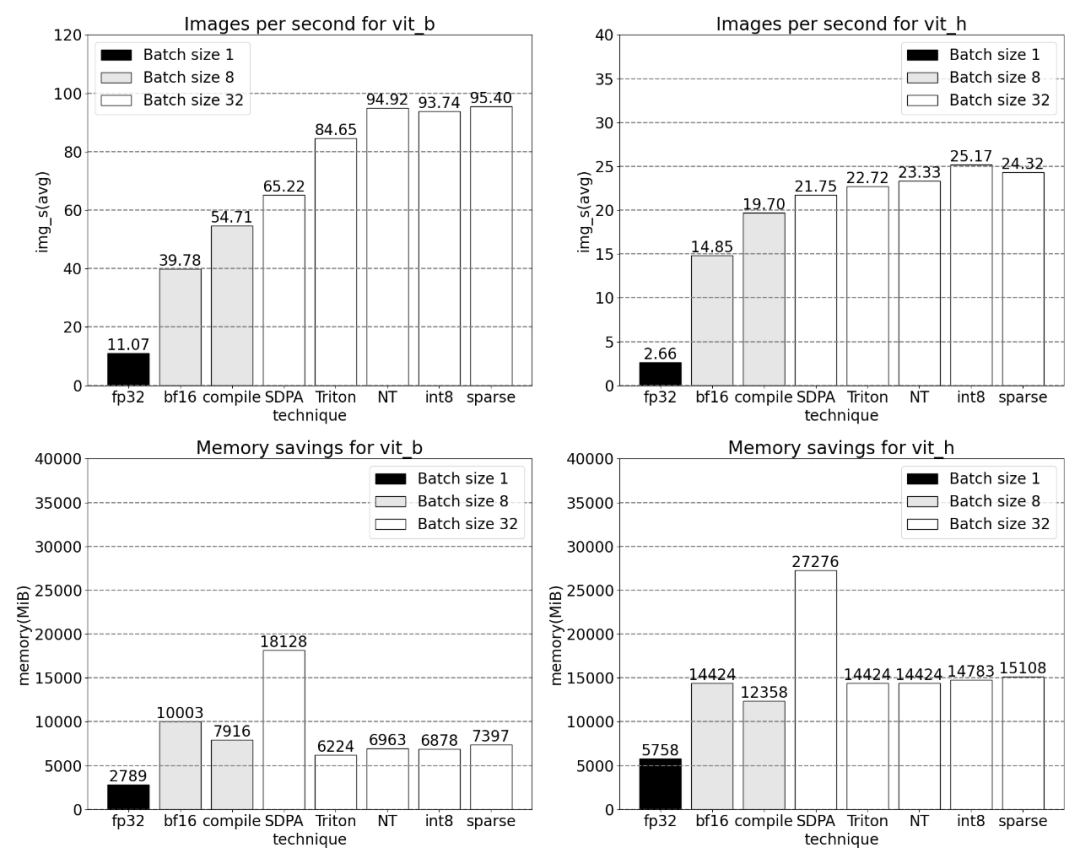
PyTorch团队重写「分割一切」模型,比原始实现快8倍

                                 PyTorch 原生特性所带来的吞吐量增加以及减少的内存开销。

SAM 由 Meta 提出,关于这项研究的更多内容请参考「CV 不存在了?Meta 发布「分割一切」AI 模型,CV 或迎来 GPT-3 时刻」。

PyTorch团队重写「分割一切」模型,比原始实现快8倍

接下来,文章介绍了 SAM 优化过程,包括性能分析、瓶颈识别,以及如何将这些新功能整合进 PyTorch 以解决 SAM 面临的这些问题。除此以外,本文还介绍了 PyTorch 的一些新特性:torch.compile、SDPA、Triton kernels、Nested Tensor 以及 semi-structured sparsity(半结构化稀疏)。

本文内容逐层深入,文章的最后会介绍快速版 SAM,感兴趣的小伙伴可以去 GitHub 上下载,此外,本文还通过 Perfetto UI 对这些数据进行了可视化,以此来阐释 PyTorch 每项特性的应用价值。

GitHub 地址:https://github.com/pytorch-labs/segment-anything-fast

对分割一切模型 SAM 的重写

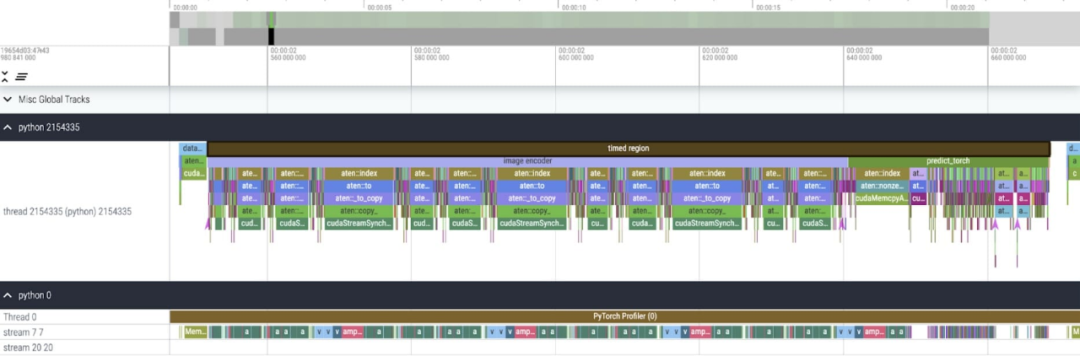
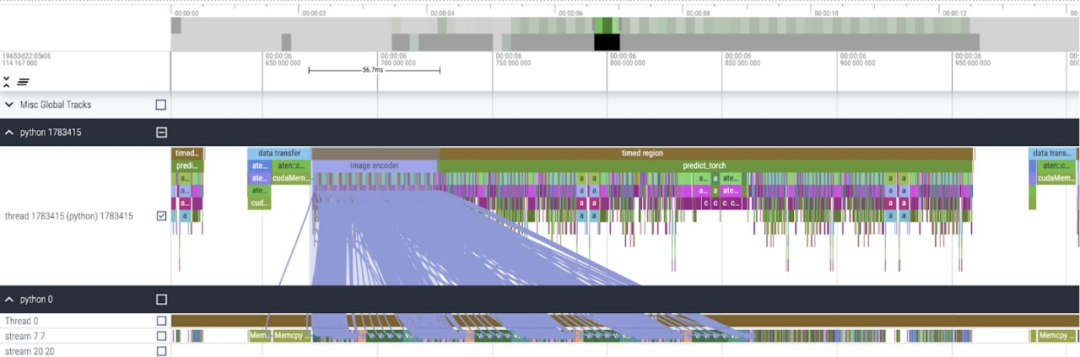
该研究表示,本文利用的 SAM 基线数据类型为 float32 dtype、batch 大小为 1,使用 PyTorch Profiler 查看内核跟踪的结果如下:

PyTorch团队重写「分割一切」模型,比原始实现快8倍

本文发现 SAM 有两个地方可以优化:

第一个是对 aten::index 的长调用,这是由张量索引操作(例如 [])产生的底层调用导致的。然而实际上 GPU 花费在 aten::index 上的时间相对较低,原因在于 aten::index 在启动两个内核的过程中,两者之间发生了阻塞 cudaStreamSynchronize。这意味着 CPU 会等待 GPU 完成处理,直到启动第二个内核。因而为了优化 SAM,本文认为应该致力于消除导致空闲时间的阻塞 GPU 同步。

第二个是 SAM 在矩阵乘法中花费了大量的 GPU 时间(上图中的深绿色),这在 Transformers 中很常见。如果能够减少 SAM 模型在矩阵乘法上花费的 GPU 时间,我们就可以显着加快 SAM 的速度。

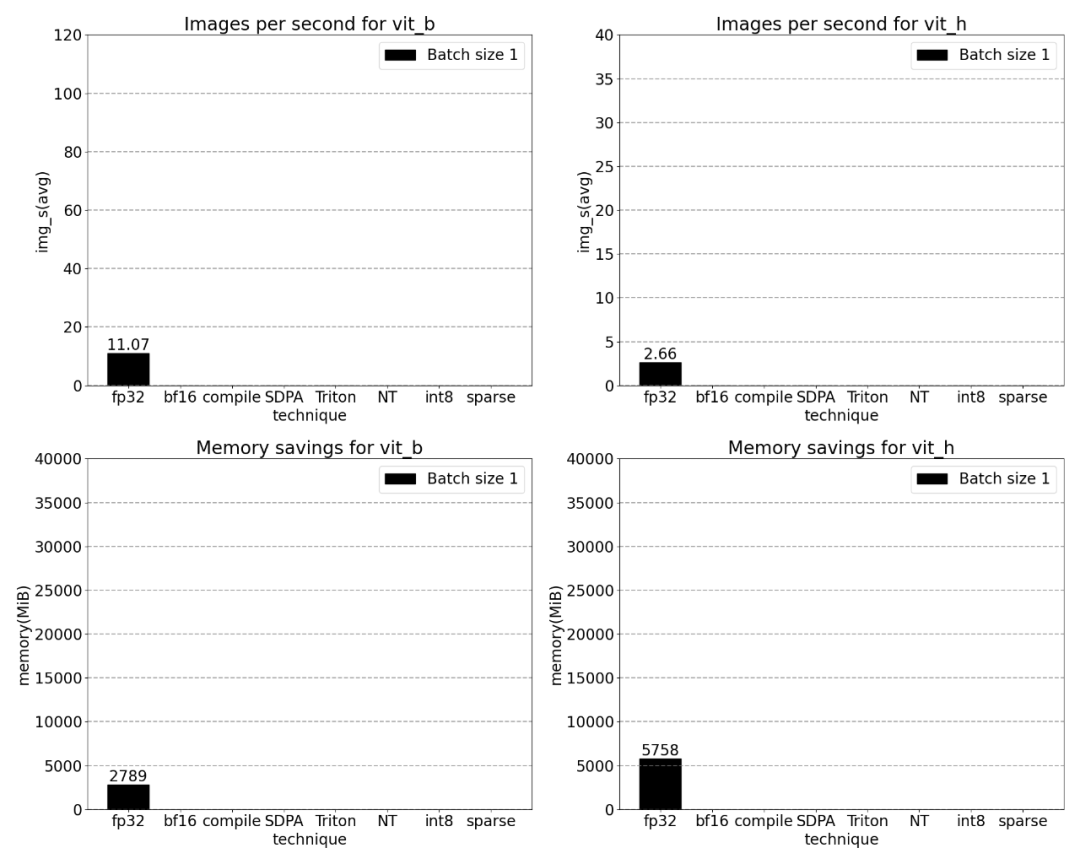
接下来本文用 SAM 的吞吐量 (img/s) 和内存开销 (GiB) 来建立基线。之后就是优化过程了。

PyTorch团队重写「分割一切」模型,比原始实现快8倍

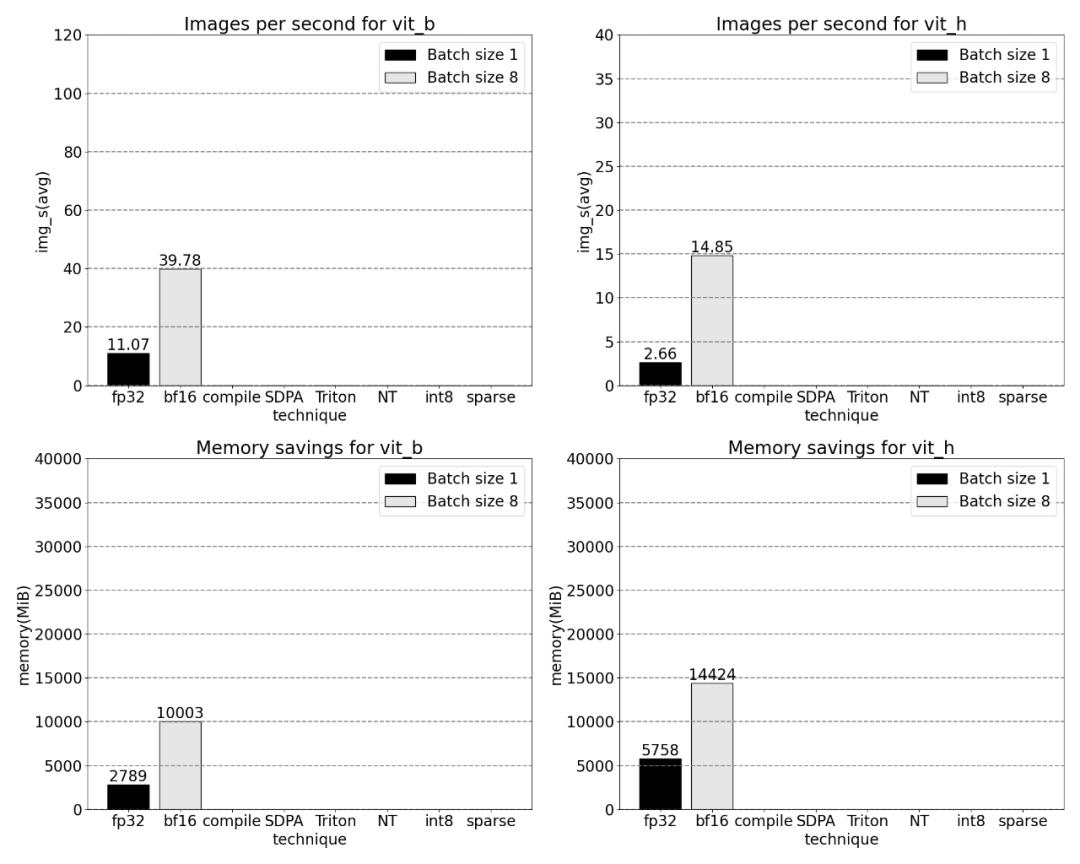
Bfloat16 半精度(加上 GPU 同步和批处理)

为了解决上述问题,即让矩阵乘法花费的时间更少,本文转向 bfloat16。Bfloat16 是常用的半精度类型,通过降低每个参数和激活的精度,能够节省大量的计算时间和内存。

PyTorch团队重写「分割一切」模型,比原始实现快8倍

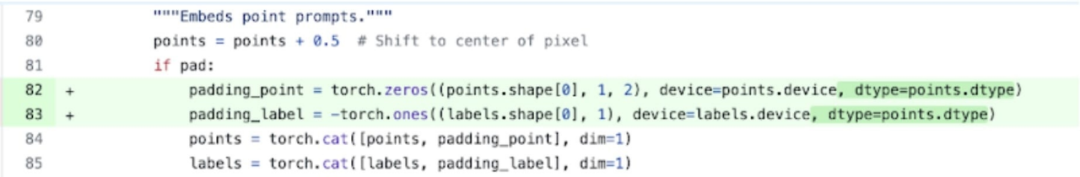
                             用 bfloat16 替换 padding 类型

此外,为了移除 GPU 同步,本文发现有两个位置可以优化。

PyTorch团队重写「分割一切」模型,比原始实现快8倍

PyTorch团队重写「分割一切」模型,比原始实现快8倍

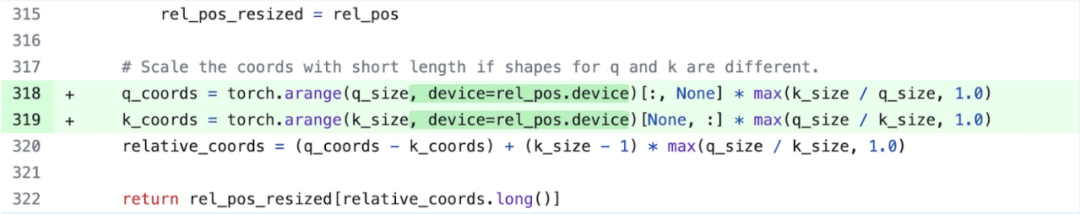
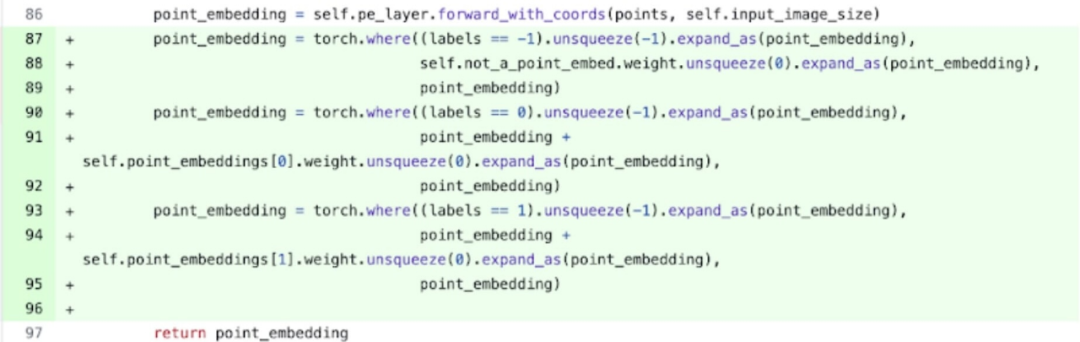
具体来说(参考上图更容易理解,出现的变量名都在代码中),该研究发现在 SAM 的图像编码器中,有充当坐标缩放器(coordinate scalers)的变量 q_coords 和 k_coords,这些变量都是在 CPU 上分配和处理的。然而,一旦这些变量被用来在 rel_pos_resized 中建立索引,这些索引操作就会自动的将这些变量移动到 GPU 上,这种复制会导致 GPU 同步。为了解决上述问题,该研究注意到可以使用 torch.where 重写这部分内容来解决问题,如上所示。

内核跟踪

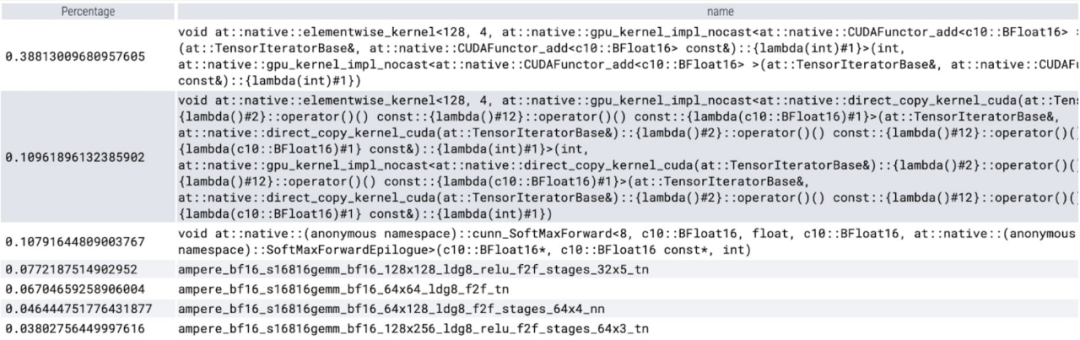
在应用了这些更改之后,本文注意到单个内核调用之间有着显著的时间间隔,尤其在小批量(这里为 1)时更为突出。为了更深入的了解这一现象,本文开始对批大小为 8 的 SAM 推理进行性能分析:

PyTorch团队重写「分割一切」模型,比原始实现快8倍

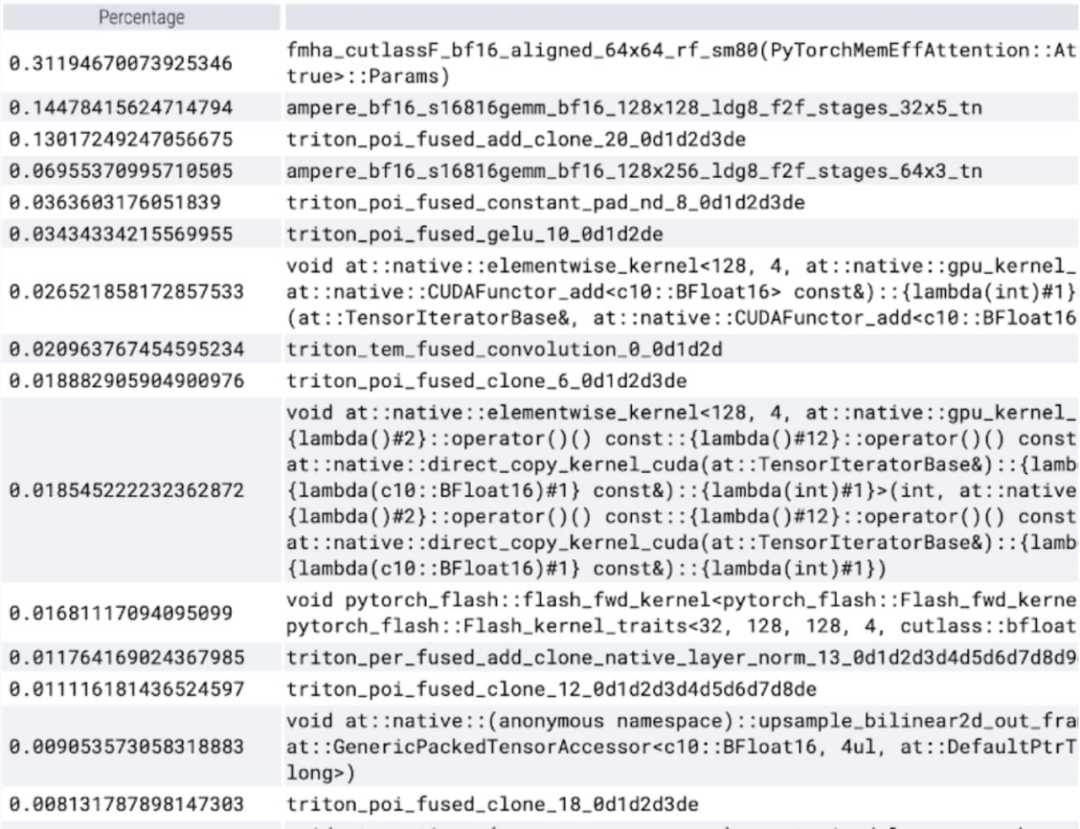
在查看每个内核所花费的时间时,本文观察到 SAM 的大部分 GPU 时间都花费在逐元素内核(elementwise kernels)和 softmax 操作上。

现在可以看到矩阵乘法的相对开销小了很多。

PyTorch团队重写「分割一切」模型,比原始实现快8倍

将 GPU 同步和 bfloat16 优化结合在一起,SAM 性能提高了 3 倍。

PyTorch团队重写「分割一切」模型,比原始实现快8倍

Torch.compile(+graph breaks 和 CUDA graphs)

本文发现在深入研究 SAM 的过程中有很多小的操作,他们认为使用编译器来融合操作有很大的好处,因而 PyTorch 对 torch.compile 做了以下优化:

  • 将 nn.LayerNorm 或 nn.GELU 等操作序列融合成一个单一的 GPU 内核;
  • 融合紧跟在矩阵乘法内核之后的操作,以减少 GPU 内核调用的数量。
通过这些优化,该研究减少了 GPU 全局内存往返次数(roundtrips),从而加快了推理速度。我们现在可以在 SAM 的图像编码器上尝试 torch.compile。为了最大限度地提高性能,本文使用了一些高级编译技术:

PyTorch团队重写「分割一切」模型,比原始实现快8倍

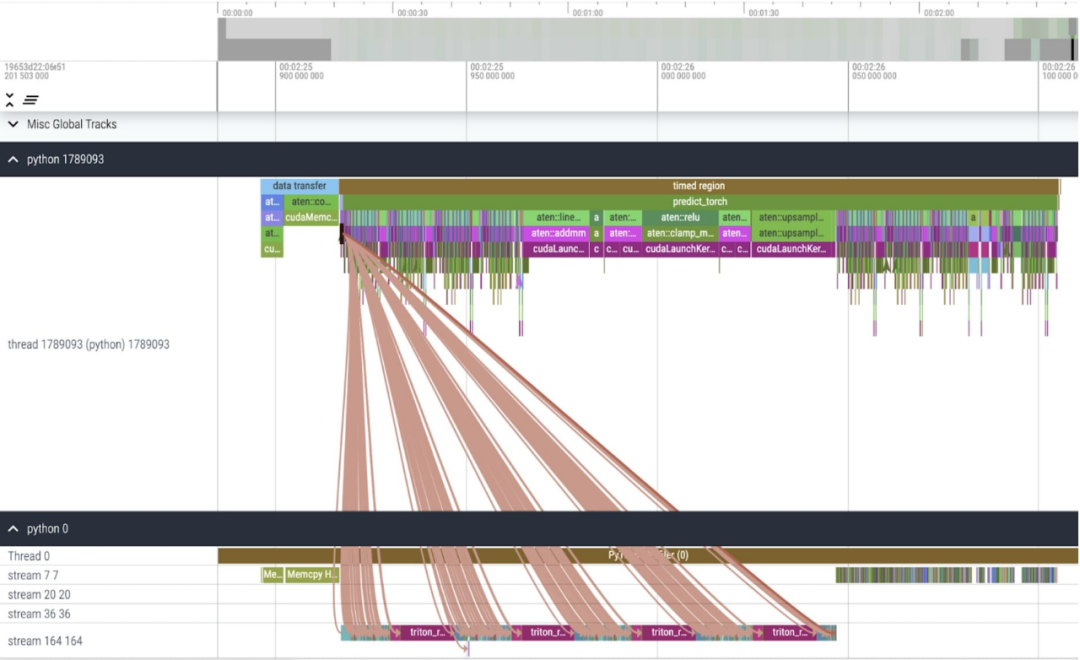
内核跟踪

PyTorch团队重写「分割一切」模型,比原始实现快8倍

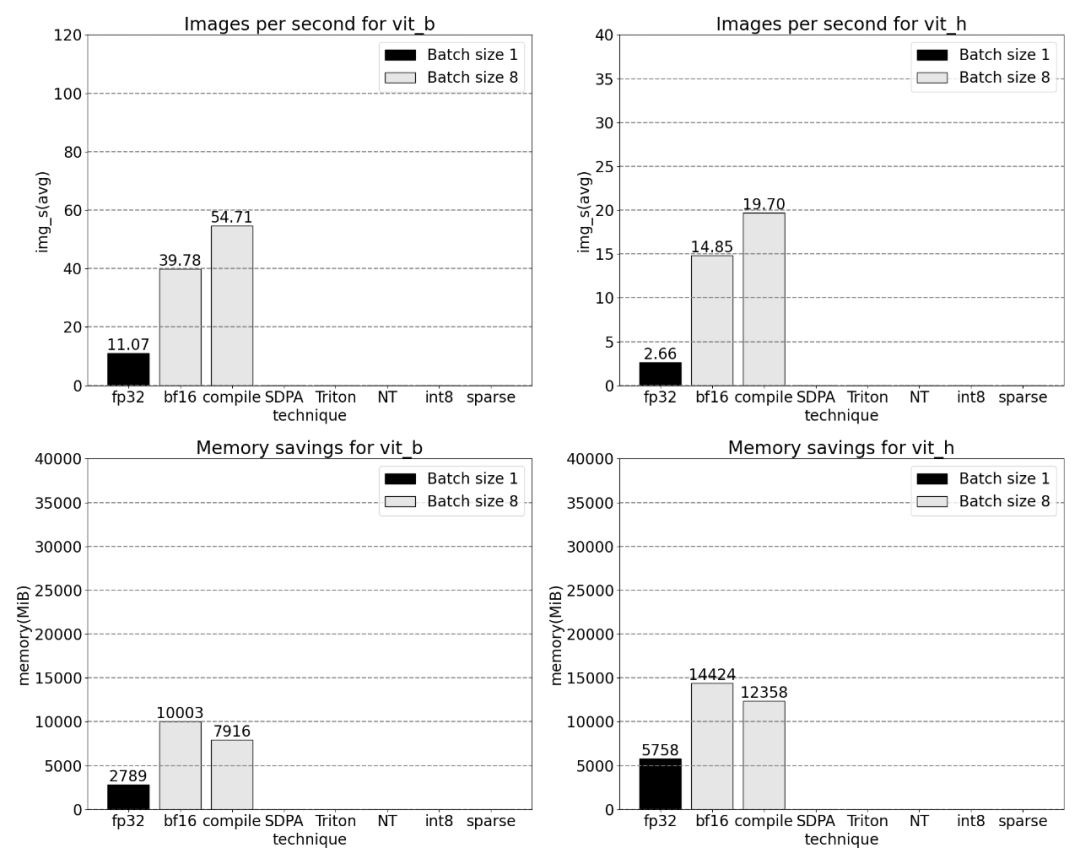
结果显示,torch.compile 工作得很好。 

PyTorch团队重写「分割一切」模型,比原始实现快8倍

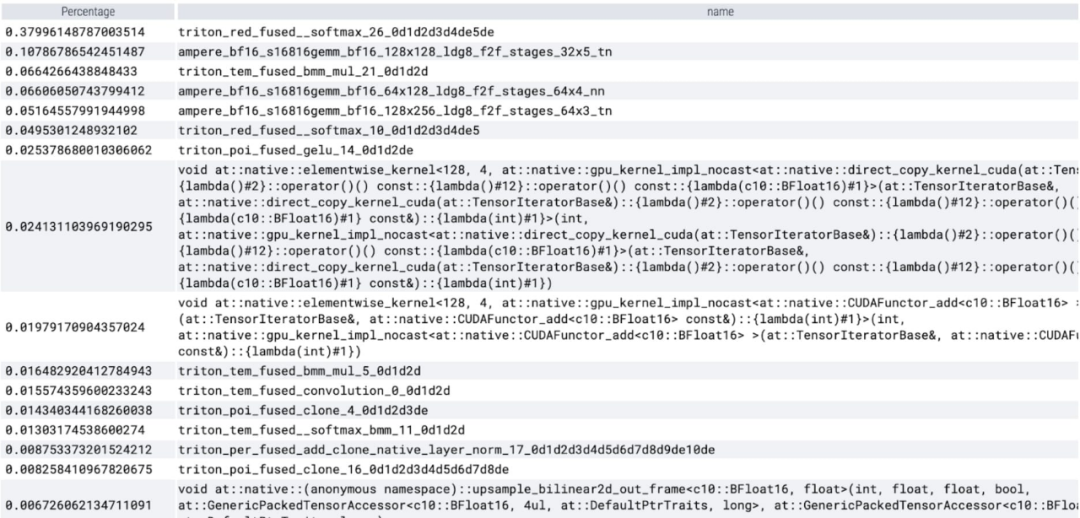
可以观察到 softmax 占了很大一部分时间,然后是各种 GEMM 变体。以下测量的是批大小为 8 及以上的变化。

PyTorch团队重写「分割一切」模型,比原始实现快8倍

SDPA: scaled_dot_product_attention

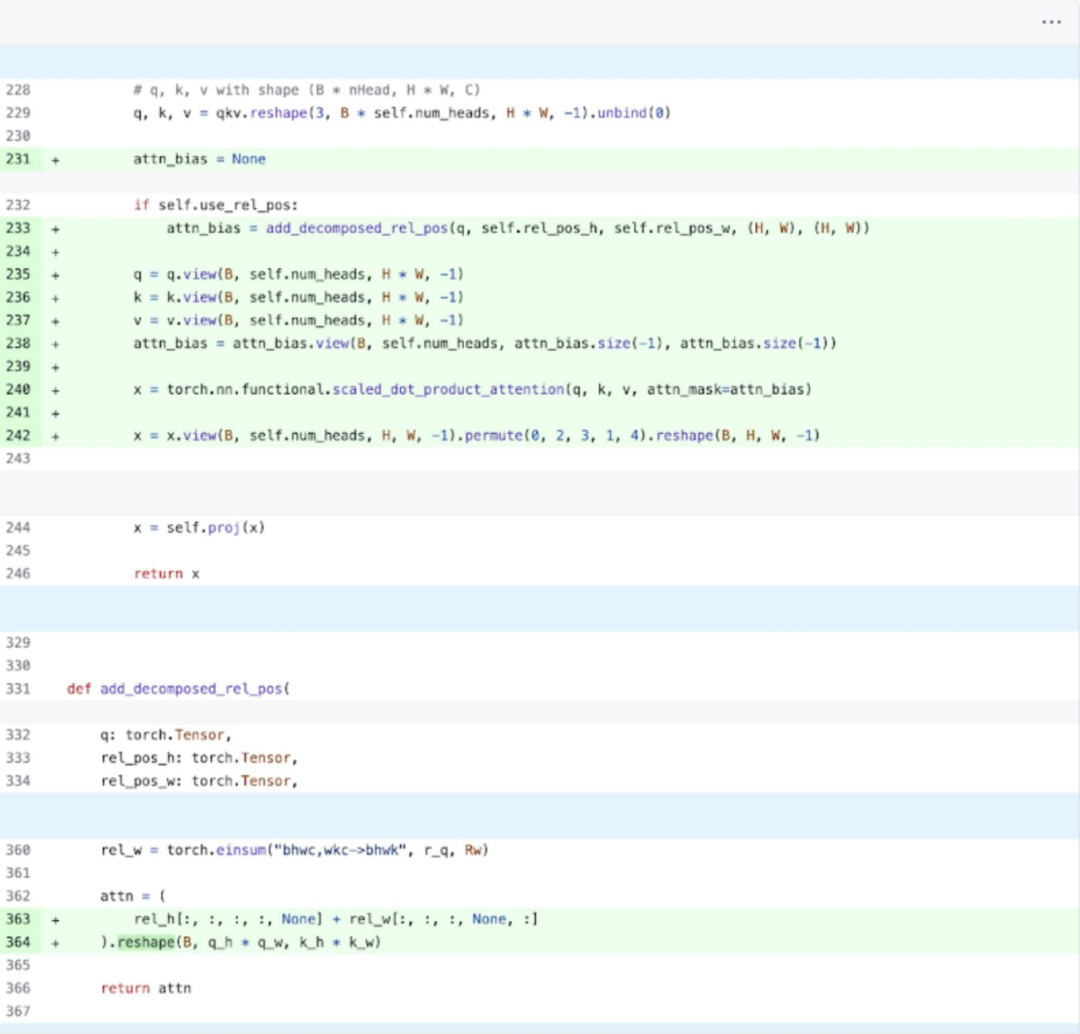
接下来,本文又对 SDPA(scaled_dot_product_attention)进行了实验,研究的重点是注意力机制。一般来讲,原生注意力机制在时间和内存上随序列长度呈二次方扩展。PyTorch 的 SDPA 操作基于 Flash Attention、FlashAttentionV2 和 xFormer 的内存高效注意力原理构建,可以显着加快 GPU 注意力。与 torch.compile 相结合,这个操作允许在 MultiheadAttention 的变体中表达和融合一个共同的模式。经过一小部分更改后,现在模型可以使用 scaled_dot_product_attention。

PyTorch团队重写「分割一切」模型,比原始实现快8倍

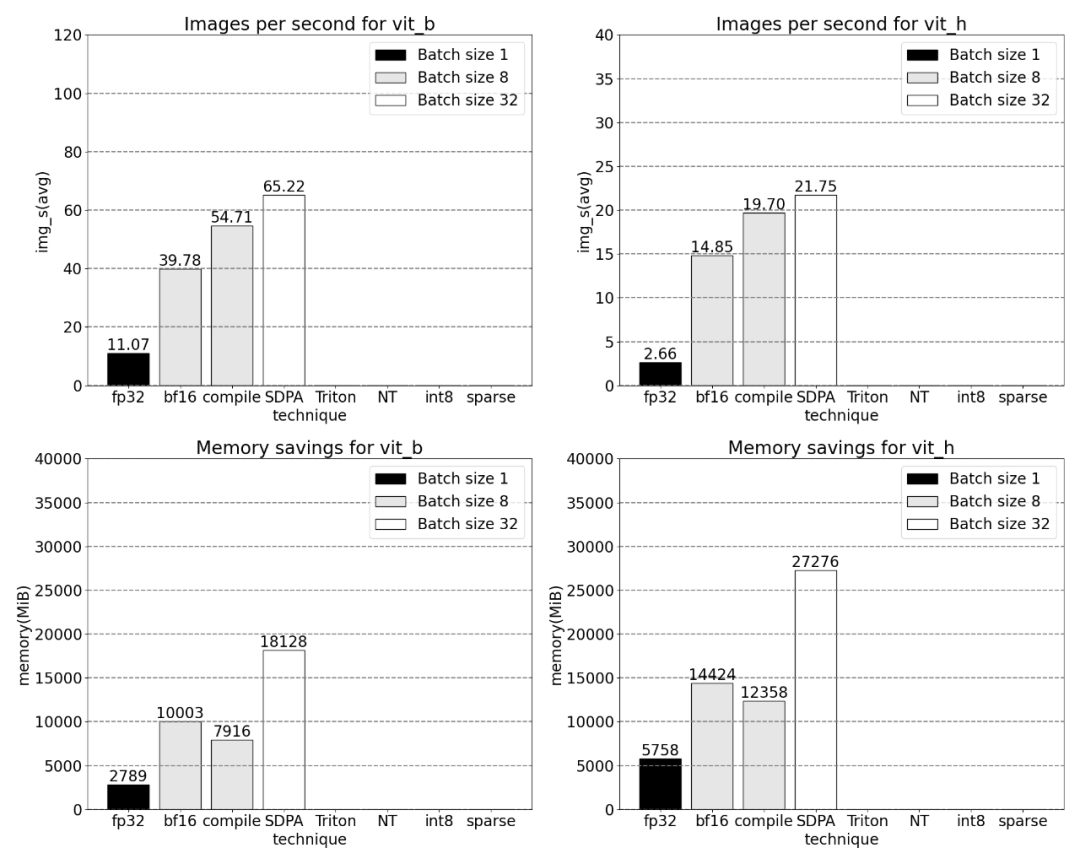
内核跟踪

现在可以看到内存高效的注意力内核占用了 GPU 上大量的计算时间:

PyTorch团队重写「分割一切」模型,比原始实现快8倍

使用 PyTorch 的原生 scaled_dot_product_attention,可以显著增加批处理大小。下图为批大小为 32 及以上的变化。

PyTorch团队重写「分割一切」模型,比原始实现快8倍

之后,该研究又实验了 Triton,NestedTensor 、批处理 Predict_torch, int8 量化,半结构化 (2:4) 稀疏性等操作。

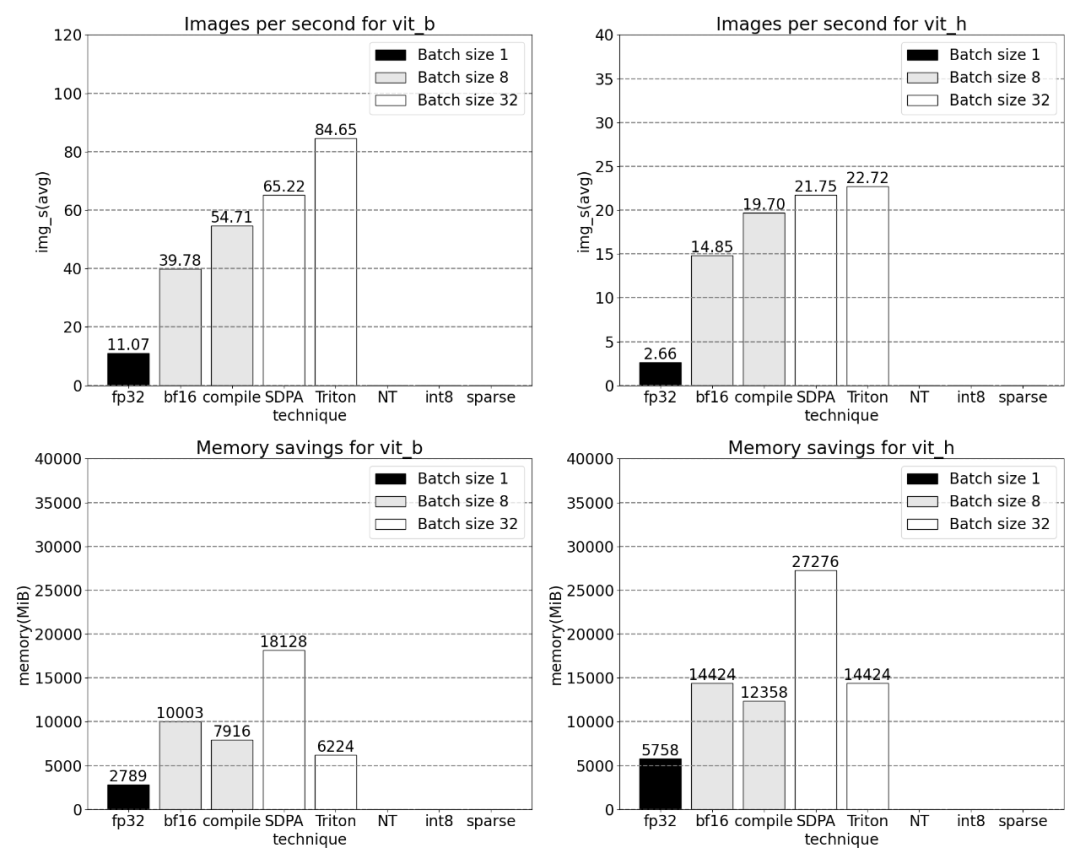
例如本文使用自定义 positional Triton 内核,观察到批大小为 32 的测量结果。

PyTorch团队重写「分割一切」模型,比原始实现快8倍

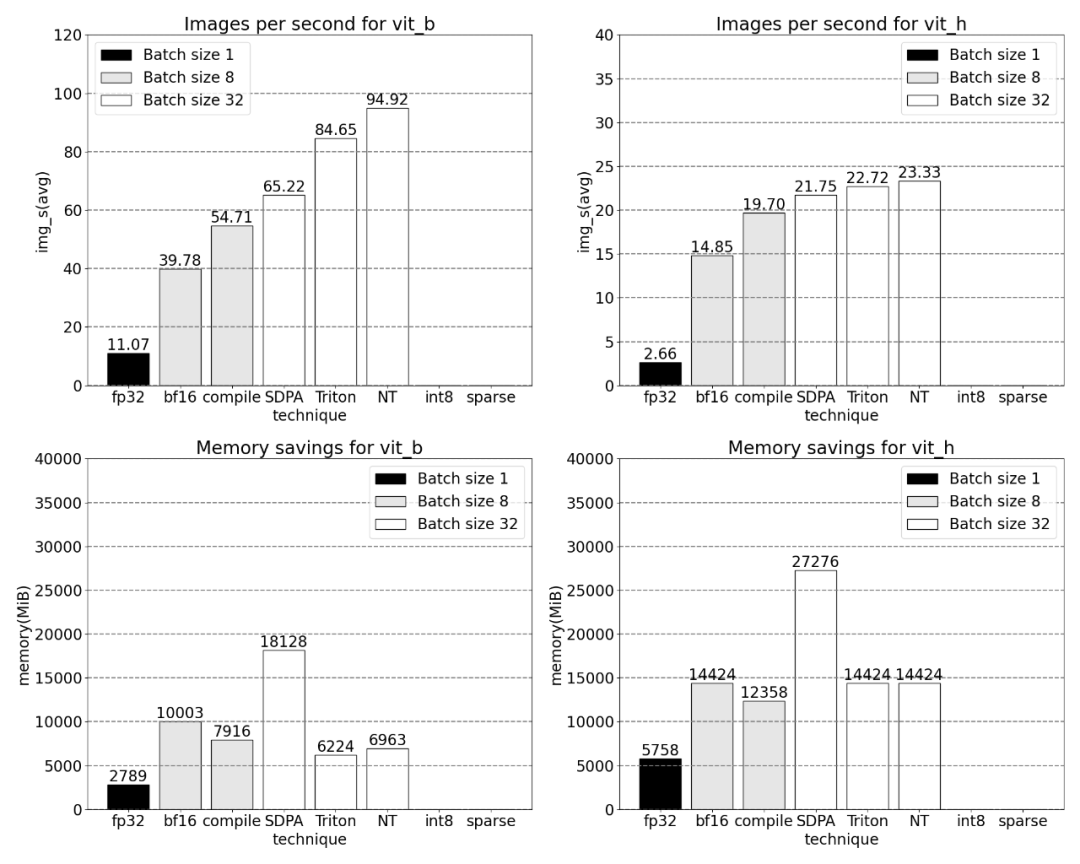
使用 Nested Tensor,批大小为 32 及以上的变化。

PyTorch团队重写「分割一切」模型,比原始实现快8倍

添加量化后,批大小为 32 及以上变化的测量结果。

PyTorch团队重写「分割一切」模型,比原始实现快8倍

文章的最后是半结构化稀疏性。该研究表示,矩阵乘法仍然是需要面对的一个瓶颈。解决的办法是使用稀疏化来近似矩阵乘法。通过稀疏矩阵(即将值归零)可以使用更少的位来存储权重和激活张量。该研究将张量中哪些权重设置为零的过程称为剪枝。剪枝掉较小的权重可以潜在地减小模型大小,而不会显着损失准确率。

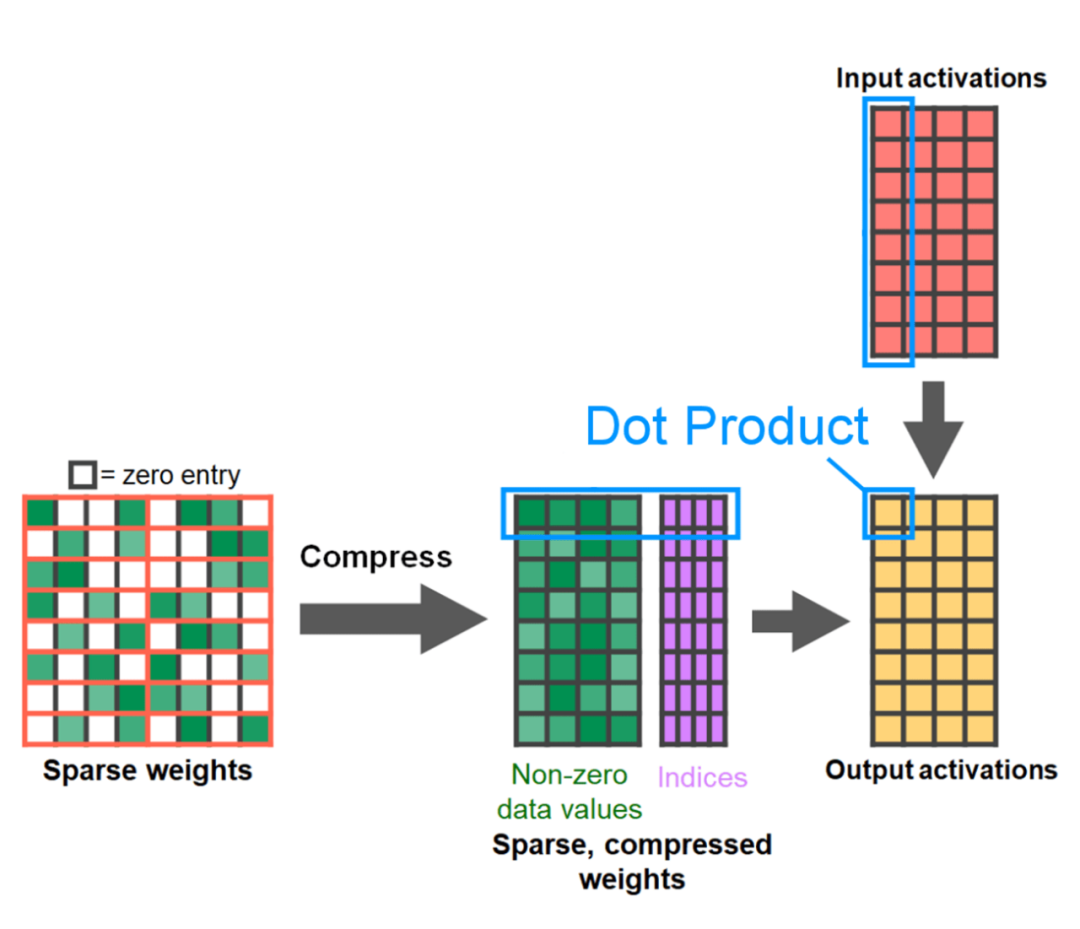
剪枝的方法多种多样,从完全非结构化到高度结构化。虽然非结构化剪枝理论上对精度的影响最小,但 GPU 在进行大型密集矩阵乘法方面尽管非常高效,然而在稀疏情况下可能还会遭受显着的性能下降。PyTorch 最近支持的一种剪枝方法旨在寻求平衡,称为半结构化(或 2:4)稀疏性。这种稀疏存储将原始张量减少了 50%,同时产生密集张量输出。参见下图的说明。

PyTorch团队重写「分割一切」模型,比原始实现快8倍

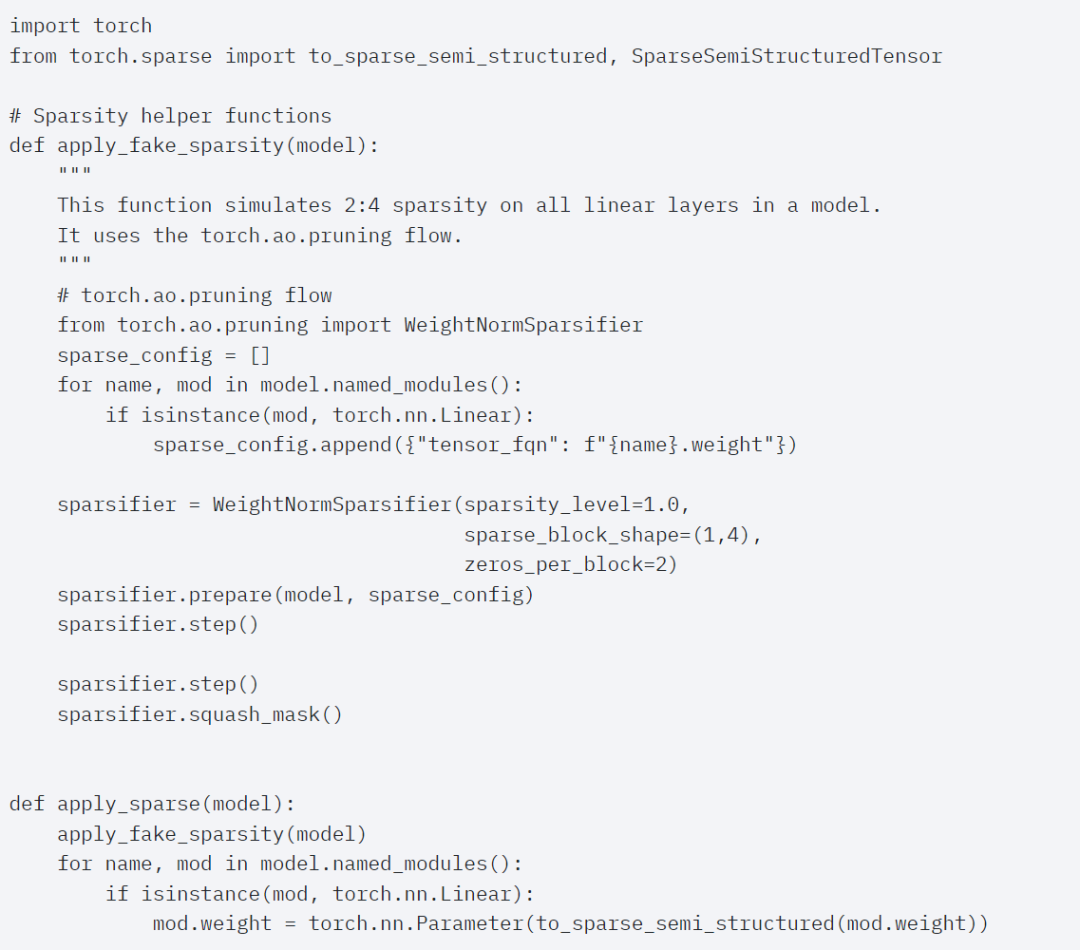
为了使用这种稀疏存储格式和相关的快速内核,接下来要做的是剪枝权重。本文在 2:4 的稀疏度下选择最小的两个权重进行剪枝,将权重从默认的 PyTorch(“strided”)布局更改为这种新的半结构化稀疏布局很容易。要实现 apply_sparse (model),只需要 32 行 Python 代码:

PyTorch团队重写「分割一切」模型,比原始实现快8倍

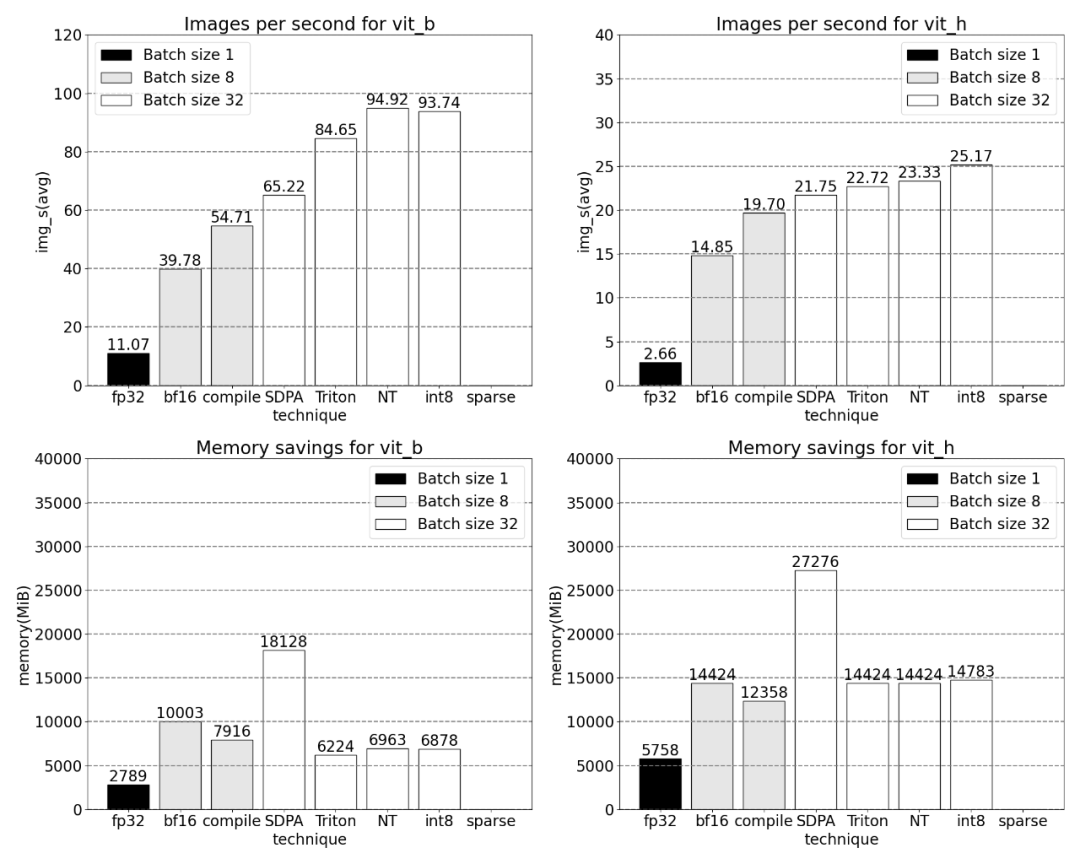
在 2:4 的稀疏度下,本文观察到 vit_b 和批大小为 32 时的 SAM 峰值性能:

图片

最后,一句话总结这篇文章:本文介绍了迄今为止在 PyTorch 上最快的 Segment Anything 实现方式,借助官方发布的一系列新功能,本文在纯 PyTorch 中重写了原始 SAM,并且没有损失准确率。

感兴趣的读者可以查看原博客了解更多内容。

参考链接:https://pytorch.org/blog/accelerating-generative-ai/
本文内容来源于互联网,如有侵权请联系删除。
作者最新文章
业界资讯
相关文章 更多
PyTorch中怎么加载本地权重文件_使用torch.load读取pth文件

使用torch.load加载.pth文件时常见问题包括路径错误、文件损坏、键名不匹配及设备映射不当。需通过os.path.exists检查路径,用map_location指定设备,并清洗键名前缀差异。确保文件完整性和模型结构一致,避免加载失败。
PyTorch 0.4 Windows支持,API全面升级

前言昨日,PyTorch官方在GitHub上发布了0.4.0版本,备受期待的Windows支持终于实现!现在,你可以轻松加入深度学习的队伍了!PyTorch官方在GitHub上发布了0.4.0版本,这一版本的最大亮点是正式支持Windows系统。新版本对API进行了彻底的重构,是今年最重要的更新之一。GitHub发布地址:https://github.com/pytorch/pytorch/releasesPyTorch官网:http://pytorch.org/此


Siri等明年!苹果WWDC25给AI交底:画小饼,继续熬

不求速胜,熬吧。

比特现金未来:可扩展性与支付潜力
比特现金未来:可扩展性与支付潜力

比特现金(BCH)的未来发展前景看好。凭借其可扩展性、支付采用、价值存储、智能合约和坚实的社区支持,比特现金有望在多个领域取得显著发展,成为一种多功能且广泛使用的加密货币。

ACH总量10亿,价值与用途详解
ACH总量10亿,价值与用途详解

ACH 总共发行了 10 亿枚,用于支付网关费用、治理投票和质押奖励。ACH 基于 BEP-20 标准,采用 PoS 机制,可通过私募、公募和生态系统分配获取,其价值受服务需求、实用性和市场趋势影响,可在币安、火币等交易所购买。

Coinbase Pro设置指南:下载、登录与自定义

Coinbase Pro 设置步骤:下载并安装软件后,打开并登录,点击右上角齿轮图标进入“首选项”。在首选项中,你可以调整界面、安全、通知、交易和API设置,完成后点击“保存”按钮确认更改。

IoTeX等基础设施如何赋能IoT生态
IoTeX等基础设施如何赋能IoT生态

IoTeX、DePHY和peaq是构建物联网生态系统的关键基础设施。IoTeX提供去中心化网络,确保物联网交易和数据的安全性。DePHY利用区块链技术实现频谱共享和自治管理。peaq促进设备间的数据标准化和共享。通过这些基础设施的协同作用,物联网生态系统实现了去中心化、安全、互操作性和自治,充分释放了物联网的潜力。


DOGE发行价多少
DOGE发行价多少

波场etf代码
波场etf代码

TRX浏览器查询地址
TRX浏览器查询地址

查看更多
精品专题 更多
装机必备
装机必备

正软商城装机必备专区,精选办公、浏览器、安全防护、影音播放、压缩解压、设计创作和系统工具等电脑常用正版软件,帮助用户快速完成新电脑软件配置。

Windows
Windows

正软商城Windows软件专区,汇集适用于Windows电脑的办公、设计、安全防护、影音播放、开发工具和系统优化软件,提供软件介绍、系统要求、正版授权及购买下载服务。

macOS软件
macOS软件

正软商城macOS软件专区,精选适用于Mac电脑的办公、设计、影音、效率、开发和系统工具,提供软件功能介绍、macOS兼容版本、正版授权及购买下载服务。

Mac软件 更多
灵活计算器
灵活计算器
macOS/iOS/Android

灵活计算器是一款笔记式算数应用,支持实时计算、动态关联和云端同步功能。记录、整理和输出之间的过渡会更自然,适合长期写作、做笔记或持续沉淀个人内容。

赤友清理大师
赤友清理大师
macOS

赤友清理大师是一款为 Mac 设计的智能清理优化工具,可精准扫描垃圾、大文件、重复文件等,释放磁盘空间。做扫描整理、文字提取和表格转换时,它能把识别后的处理步骤接得更顺,资料录入这类场景会省下不少时间。

极度公式
极度公式
Windows/macOS/Linux

极度公式是一款跨平台专业LaTeX公式识别编辑软件,支持OCR公式识别和多平台编辑。和使用说明,避免使用,享受完整功能与稳定支持。做扫描整理、文字提取和表格转换时,它能把识别后的处理步骤接得更顺,资料录入这类场景会省下不少时间。

WINDOWS 更多
Windows 10
Windows 10
Windows

Windows 10 是一款微软推出的经典操作系统,拥有硬件兼容性与多任务处理能力。它更偏向把系统状态查看和常用调节动作放在一起,适合需要持续观察和微调设备状态的场景。

极度公式
极度公式
Windows/macOS/Linux

极度公式是一款跨平台专业LaTeX公式识别编辑软件,支持OCR公式识别和多平台编辑。和使用说明,避免使用,享受完整功能与稳定支持。做扫描整理、文字提取和表格转换时,它能把识别后的处理步骤接得更顺,资料录入这类场景会省下不少时间。

密码键盘
密码键盘
Windows/macOS/iOS/Android

密码键盘是一款兼具安全性与便捷性的高效密码管理器。日常使用里的持续防护和信息管理会更突出,适合把安全控制放进长期使用流程中的场景。