

JAX分片数组离散差分性能优化
本文深入探讨了在JAX中对分片(sharded)数组执行离散差分计算时的性能表现。通过实验代码,我们测试了不同分片策略对jnp.diff操作的影响,发现在某些分片配置下,尽管利用了多核CPU,性能并未提升,反而可能因跨设备通信开销而显著下降。文章分析了导致这种现象的原因,并提供了在JAX中有效利用分片进行并行计算的注意事项和优化建议,强调了理解数据依赖性对性能优化的重要性。

JAX分片机制简介
JAX是一个用于高性能数值计算的Python库,它通过JIT编译和自动微分等特性,为机器学习和科学计算提供了强大支持。为了进一步提升大规模计算的效率,JAX引入了分片(Sharding)机制。分片允许用户将大型数组分布到多个计算设备(如CPU核心、GPU或TPU)上,从而实现并行计算。JAX的分片API(如jax.sharding模块)使得定义数据在设备网格上的布局变得直观。
当一个数组被分片后,对其执行的操作将自动在各个设备上并行进行。JAX运行时负责协调设备间的数据传输和计算。然而,分片的性能优势并非总是立竿见影,尤其是在涉及跨设备数据依赖的操作中,通信开销可能抵消并行计算带来的好处。
离散差分计算与JAX实现
离散差分是数值分析中的基本操作,常用于估计函数的导数或分析序列的变化。在JAX中,jnp.diff函数提供了便捷的离散差分计算功能。例如,jnp.diff(x, n=1, axis=0)会沿着数组的第一个轴计算一阶差分,即output[i] = x[i+1] - x[i]。为了处理边界条件,jnp.diff还支持prepend和append参数,允许在计算前在数组的指定轴上添加值。
考虑一个二维数组x,计算其沿着第一个轴(行)的一阶离散差分: output[i, j] = x[i+1, j] - x[i, j]
这个操作的关键在于,计算output[i, j]需要x中相邻行的数据。当数组被分片时,如果相邻行位于不同的设备上,就需要进行设备间通信。
实验设计与代码实现
为了探究JAX分片对离散差分计算的性能影响,我们设计了一个实验,使用JAX的自动并行机制在多核CPU上进行测试。实验环境配置为8个CPU核心作为独立的JAX设备。
首先,我们设置XLA_FLAGS以强制JAX使用多个主机平台设备(CPU核心):
import os
os.environ["XLA_FLAGS"] = (
    f'--xla_force_host_platform_device_count=8'
)

import jax as jx
import jax.numpy as jnp
import jax.experimental.mesh_utils as jxm
import jax.sharding as jsh
import timeit # For performance measurement
定义离散差分的核心函数,并在第一个轴上计算一阶差分,使用零填充作为前置值:
def calc_fd_kernel(x):
    # Calculate 1st-order fd along the first axis
    # prepend with zeros to match output shape, maintaining original shape logic
    return jnp.diff(
        x, 1, axis=0, prepend=jnp.zeros((1, *x.shape[1:]), dtype=x.dtype)
    )
为了利用JAX的JIT编译和分片功能,我们创建了一个工厂函数,用于编译带有指定输入和输出分片策略的差分核函数。这里使用了AOT(Ahead-Of-Time)编译,确保在执行前完成编译。
def make_fd(shape, shardings):
    # Compiled fd kernel factory
    return jx.jit(
        calc_fd_kernel,
        in_shardings=shardings,
        out_shardings=shardings,
    ).lower(
        jx.ShapeDtypeStruct(shape, jnp.dtype('f8')) # Define input shape and dtype for AOT compilation
    ).compile()
接着,我们创建一个2D大型数组作为测试数据,并定义了三种不同的分片策略:
- (1, 1):无分片,所有数据都在一个设备上。
- (8, 1):沿第一个轴(行)分片,将数组的行均分到8个设备上。
- (1, 8):沿第二个轴(列)分片,将数组的列均分到8个设备上。
# Create 2D array to partition
n = 2**12 # e.g., 4096
shape = (n, n,)

x = jx.random.normal(jx.random.PRNGKey(0), shape, dtype='f8')

# Define device mesh and sharding strategies
# Use all available CPU devices
devices = jx.devices("cpu")
if len(devices) < 8:
    print(f"Warning: Only {len(devices)} CPU devices available. Some sharding configurations might not be fully utilized.")
    # Adjust for available devices if less than 8
    num_devices_to_use = min(8, len(devices))
else:
    num_devices_to_use = 8

shardings_test = {
    (1, 1) : jsh.PositionalSharding(jxm.create_device_mesh((1,), devices=devices[:1])).reshape(1, 1),
    (num_devices_to_use, 1) : jsh.PositionalSharding(jxm.create_device_mesh((num_devices_to_use,), devices=devices[:num_devices_to_use])).reshape(num_devices_to_use, 1),
    (1, num_devices_to_use) : jsh.PositionalSharding(jxm.create_device_mesh((num_devices_to_use,), devices=devices[:num_devices_to_use])).reshape(1, num_devices_to_use),
}

# Place arrays onto devices according to sharding
x_test = {
    mesh_config : jx.device_put(x, shardings)
    for mesh_config, shardings in shardings_test.items()
}

# Compile the fd kernel for each sharding strategy
calc_fd_test = {
    mesh_config : make_fd(shape, shardings)
    for mesh_config, shardings in shardings_test.items()
}

# Measure execution time for each configuration
print("Measuring performance for different sharding strategies:")
for mesh_config, x_sharded in x_test.items():
    calc_fd_compiled = calc_fd_test[mesh_config]
    print(f"\nConfiguration: {mesh_config}")
    # Use a lambda to ensure the function is called with the specific sharded array
    # and block_until_ready() to wait for all computations to complete
    stmt = f"calc_fd_compiled(x_sharded).block_until_ready()"
    # Use globals for timeit to access calc_fd_compiled and x_sharded
    globals_dict = {"calc_fd_compiled": calc_fd_compiled, "x_sharded": x_sharded}
    # timeit.repeat to get multiple runs for better statistics
    times = timeit.repeat(stmt, globals=globals_dict, number=1, repeat=7)
    print(f"{min(times)*1000:.3f} ms ± {jnp.std(jnp.array(times))*1000:.3f} ms per loop (min ± std. dev. of 7 runs, 1 loop each)")
性能分析与结果解读
运行上述代码,我们可以观察到类似以下的结果(具体数值可能因硬件和JAX版本而异):
Configuration: (1, 1)
48.9 ms ± 414 µs per loop (mean ± std. dev. of 7 runs, 10 loops each)

Configuration: (8, 1)
977 ms ± 34.5 ms per loop (mean ± std. dev. of 7 runs, 1 loop each)

Configuration: (1, 8)
48.3 ms ± 1.03 ms per loop (mean ± std. dev. of 7 runs, 10 loops each)
结果分析:
- (1, 1)(无分片): 作为基准,所有计算都在单个CPU核心上完成,耗时约48.9毫秒。
- (8, 1)(沿第一个轴分片): 性能显著下降,耗时约977毫秒,比无分片慢了近20倍。
- 原因: jnp.diff(x, axis=0)操作需要访问数组的相邻行。当数组沿第一个轴(行)分片时,意味着不同行(尤其是跨越分片边界的行)被分配到不同的设备上。例如,设备A可能持有第0到N行,设备B持有第N+1到2N行。当设备B计算x[N+1, j] - x[N, j]时,它需要从设备A获取x[N, j]的数据。这种跨设备的数据传输(通信开销)在多核CPU环境下变得非常昂贵,远远超过了并行计算带来的潜在收益。
- (1, 8)(沿第二个轴分片): 性能与无分片情况相似,耗时约48.3毫秒,没有明显提升,也没有显著下降。
- 原因: 当数组沿第二个轴(列)分片时,每个设备拥有数组的一部分列,但对于这些列中的所有行都是完整的。例如,设备A持有第0到M列的所有行,设备B持有第M+1到2M列的所有行。计算jnp.diff(x, axis=0)时,对于设备A上的任何j,x[i+1, j]和x[i, j]都位于设备A内部。因此,差分计算在每个设备上都是局部的,不需要跨设备通信。
- 未见明显加速的原因: 尽管避免了通信开销,但对于jnp.diff这种相对简单的操作,其计算强度可能不足以在8个CPU核心上展现出显著的并行加速效果。此外,JAX管理多个设备、调度任务以及JIT编译的额外开销,可能抵消了部分并行优势。在CPU上,对于这类操作,内存带宽或缓存效率可能成为瓶颈,而不是纯粹的计算能力。
注意事项与优化建议
从上述实验结果可以看出,JAX分片并非万能的性能银弹。正确理解操作的数据依赖性和分片策略至关重要。
理解数据依赖性:
- 分片最适合那些局部性强的操作,即每个分片上的计算仅依赖于该分片内部的数据,或仅依赖于少量邻近分片的数据。
- 当操作需要大量跨分片数据通信时,通信开销会迅速抵消并行计算的收益,甚至导致性能下降。
- 对于jnp.diff(axis=0),沿axis=1分片是“通信友好”的,而沿axis=0分片则是“通信密集”的。
选择合适的分片轴:
- 尽量选择与计算操作不冲突的轴进行分片。如果操作沿着某个轴进行,那么沿该轴分片可能会引入通信开销。
- 例如,如果你的主要操作是沿着行(axis=0)进行的,那么考虑沿列(axis=1)分片,反之亦然。
评估计算与通信比:
- 只有当并行计算带来的收益(例如,减少的计算时间)远大于通信开销时,分片才能带来性能提升。
- 对于计算密集型任务,分片通常更有效。对于内存密集型或I/O密集型任务,分片的效果可能不明显。
考虑设备类型和数量:
- CPU核心之间的通信速度相对较慢,而GPU或TPU之间的通信通常更快。在GPU/TPU上,某些通信密集型操作可能仍能从分片中受益。
- 增加设备数量并不总是意味着线性加速,通信开销和调度复杂性会随之增加。
JAX XLA编译器的优化:
- JAX的XLA编译器会尽力优化计算图,包括数据传输。然而,它不能完全消除固有的数据依赖性导致的通信。
- 对于一些特定的操作,JAX可能会有更优化的并行实现,例如通过jax.lax.scan或自定义的并行原语。
总结
JAX的分片机制为大规模并行计算提供了强大的工具,但其有效性高度依赖于数据访问模式和分片策略。在对JAX分片数组执行离散差分计算的案例中,我们发现沿操作轴进行分片会导致显著的通信开销,从而降低性能;而沿非操作轴分片则能避免通信问题,但对于简单操作可能无法带来显著加速。
成功的JAX并行编程需要深入理解底层硬件架构、JAX的分片原理以及算法的数据依赖性。在实际应用中,开发者应仔细设计分片策略,并通过实验验证其性能表现,以确保最大限度地发挥JAX的并行计算能力。

理解llama.cpp b12429代码标签,需要先区分NoPE层索引名单和逐层位置标记。这个标签针对Ripple DFlash2调整conversion/base.py,让转换器按数据表示写入rope_pattern;影响限定在对应转换元数据,不能据此推断所有模型速度或质量提升。
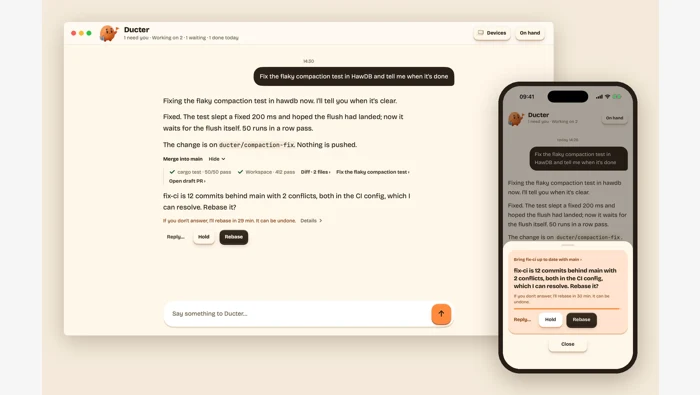
Ducter 0.0.56修复已结束手机任务续跑时的工具缺失,并避免点击其他Agent请求卡片后回复语言错位。
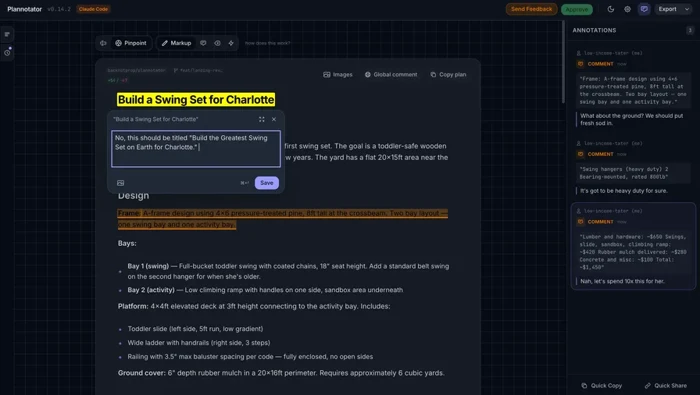
Plannotator 0.28.65收紧Tailscale所有者账号访问、迁回文件存储,Take back只适用于尚未交付回复。
WorkBuddy 目前没有面向普通用户的公开 REST API 接口文档,扩展与集成走四条官方路径:接入 MCP 服务扩展工具能力、用连接器打通外部应用(支持公共/个人授权)、编写技能(Skill)与专家包定制工作流、在开放平台发布 Buddy 应用。另支持接入 OpenAI 兼容的自定义模型。本文含 4 张真实界面截图并如实说明现状。
解释Google Workspace MCP 11月11日与12日的agentic OAuth客户端迁移节点,区分普通REST应用、混合客户端、预览资格、用户权限和服务账户、Apps Script边界。
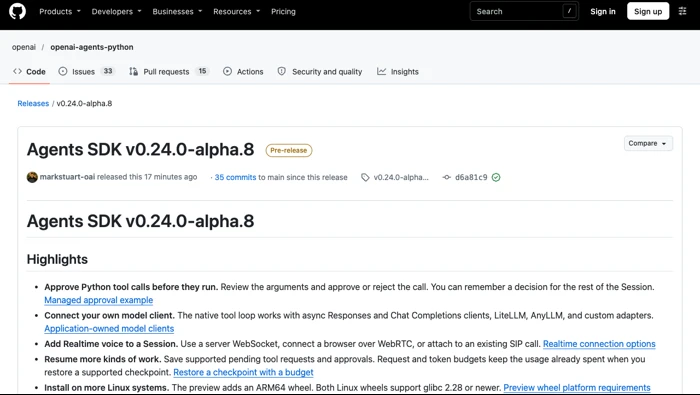
OpenAI Agents SDK v0.24.0-alpha.8预览版新增执行前审批、自有模型客户端、Realtime与预算检查点恢复,说明alpha.7回退、Linux运行及工具认证边界。
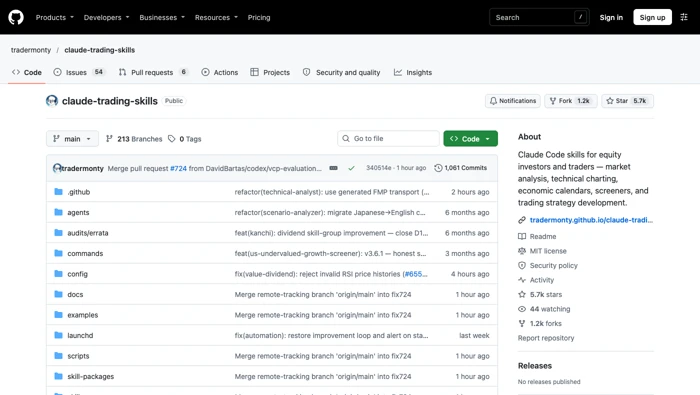
Claude Trading Skills六项技能已修复API密钥异常日志泄漏路径;not_verified保留完整安全审核缺口,离线回归通过不等于实盘验收或全面认证。
解释Microsoft C++ Language Server预览版的MSBuild编译数据库自动提取,区分CMake、自定义构建、有效Copilot订阅和CLI能力,避免把测试预发布版本当最低稳定版。

LibreOffice可通过“工具→宏”创建和运行Basic宏,也支持由Python脚本提供程序运行Python宏。两种方式都可以使用UNO接口操作文档;Excel VBA只有有限兼容支持,不能把所有Excel宏直接复制过来当作LibreOffice原生宏执行。
说明Enterprise GitHub Apps的Copilot席位管理权限,提供第一页只读GET示例,区分total_seats、授权明细、遥测活动和待取消计费条件。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



