

Hibernate N+1问题怎么解决?
本文旨在解决Hibernate中常见的N+1查询问题,该问题会导致性能瓶颈。我们将探讨FetchType.EAGER带来的影响,并深入研究如何通过FetchType.LAZY、projections(投影)以及其他优化策略来提升Hibernate应用的性能。通过本文,你将了解如何避免不必要的数据库查询,从而显著提高数据访问效率。
本文旨在解决Hibernate中常见的N+1查询问题,该问题会导致性能瓶颈。我们将探讨FetchType.EAGER带来的影响,并深入研究如何通过FetchType.LAZY、 projections (投影)以及其他优化策略来提升Hibernate应用的性能。通过本文,你将了解如何避免不必要的数据库查询,从而显著提高数据访问效率。
理解N+1查询问题
在Hibernate中,N+1查询问题是指当获取一个实体时,Hibernate会首先执行一个查询来获取该实体本身(1次查询),然后对于该实体关联的每一个子实体,Hibernate会再执行一个单独的查询来获取这些子实体(N次查询)。这会导致大量的数据库交互,严重影响性能。
例如,考虑以下实体关系:Translations 实体关联 Phrase 和 Lang 实体。
@Entity
@Table(name="ad_translations")
public class Translations implements Serializable  {

    @Id
    @GeneratedValue(strategy = GenerationType.IDENTITY)
    private Long id;

    @ManyToOne(fetch = FetchType.EAGER) // 默认EAGER加载,导致N+1问题
    @JoinColumn(name="id_ad_phrase")
    private Phrase idAdPhrase;

    @ManyToOne(fetch = FetchType.EAGER) // 默认EAGER加载,导致N+1问题
    @JoinColumn(name="id_ad_lang")
    private Lang idAdLang;

    // Getters and setters
}
默认情况下,@ManyToOne 注解的 fetch 属性是 FetchType.EAGER。这意味着,当你查询 Translations 实体时,Hibernate 会立即加载关联的 Phrase 和 Lang 实体。如果查询了1000个 Translations 实体,Hibernate 就会执行 1 个查询获取 Translations,然后执行 1000 个查询获取 Phrase,再执行 1000 个查询获取 Lang,总共 2001 次查询,这就是典型的 N+1 问题。
解决方案
以下是一些解决 Hibernate N+1 查询问题的常用方法:
1. 延迟加载 (Lazy Loading)
将 fetch 属性设置为 FetchType.LAZY 可以避免立即加载关联实体。
@Entity
@Table(name="ad_translations")
public class Translations implements Serializable  {

    @Id
    @GeneratedValue(strategy = GenerationType.IDENTITY)
    private Long id;

    @ManyToOne(fetch = FetchType.LAZY) // 修改为LAZY加载
    @JoinColumn(name="id_ad_phrase")
    private Phrase idAdPhrase;

    @ManyToOne(fetch = FetchType.LAZY) // 修改为LAZY加载
    @JoinColumn(name="id_ad_lang")
    private Lang idAdLang;

    // Getters and setters
}
现在,只有在调用 getPhrase() 或 getLang() 方法时,Hibernate 才会加载关联的实体。
注意事项:
- 如果在 REST 应用中使用延迟加载,并且在序列化 Translations 对象时访问了未加载的关联实体,则会触发延迟加载。这可能会导致在序列化过程中出现 N+1 问题。
- 可以使用 Hibernate 的 EntityGraph 或 Spring Data JPA 的 @EntityGraph 注解来控制在查询时加载哪些关联实体,从而避免在序列化过程中触发不必要的延迟加载。
2. 使用 JOIN FETCH
使用 JPQL 的 JOIN FETCH 语句可以在一个查询中加载关联实体。
@Query("SELECT t FROM Translations t JOIN FETCH t.idAdPhrase JOIN FETCH t.idAdLang WHERE t.id = :id")
Translations findByIdWithPhraseAndLang(@Param("id") Long id);
这个查询会一次性加载 Translations 实体以及关联的 Phrase 和 Lang 实体,避免了 N+1 问题。
3. 使用 Projections (投影)
如果只需要 Translations 实体的一部分属性,可以使用 projections 来只检索需要的属性。这可以减少数据库查询的数据量,从而提高性能。
例如,假设只需要 Translations 的 id 和关联的 Phrase 的 phraseText 属性。
首先定义一个接口:
public interface TranslationPhrase {
    Long getId();
    String getPhraseText();
}
然后,在 Repository 中使用该接口:
@Query("SELECT t.id as id, p.phraseText as phraseText FROM Translations t JOIN t.idAdPhrase p WHERE t.id = :id")
TranslationPhrase findTranslationPhraseById(@Param("id") Long id);
虽然 projections 本身不能直接解决 N+1 问题,但它可以减少每次查询的数据量,从而提高整体性能。结合其他优化策略,例如 JOIN FETCH 或 EntityGraph,可以更好地解决 N+1 问题。
4. 使用 @BatchSize
@BatchSize 注解可以控制 Hibernate 一次性加载多少个关联实体。
@Entity
@Table(name="ad_translations")
public class Translations implements Serializable  {

    @Id
    @GeneratedValue(strategy = GenerationType.IDENTITY)
    private Long id;

    @ManyToOne(fetch = FetchType.LAZY)
    @JoinColumn(name="id_ad_phrase")
    @BatchSize(size = 25) // 一次加载25个Phrase
    private Phrase idAdPhrase;

    @ManyToOne(fetch = FetchType.LAZY)
    @JoinColumn(name="id_ad_lang")
    @BatchSize(size = 25) // 一次加载25个Lang
    private Lang idAdLang;

    // Getters and setters
}
当 Hibernate 需要加载多个 Phrase 实体时,它会一次性加载 25 个,而不是每个都执行单独的查询。这可以减少数据库查询的次数,从而提高性能。
注意事项:
- @BatchSize 是一种折衷方案。它不能完全避免 N+1 问题,但可以显著减少查询次数。
- 需要根据实际情况调整 size 的大小,以达到最佳性能。
5. 使用 EntityGraph
EntityGraph 允许你指定在查询时加载哪些关联实体,从而避免不必要的延迟加载。
@EntityGraph(attributePaths = {"idAdPhrase", "idAdLang"})
@Query("SELECT t FROM Translations t WHERE t.id = :id")
Translations findByIdWithPhraseAndLangUsingEntityGraph(@Param("id") Long id);
这个查询会加载 Translations 实体以及关联的 Phrase 和 Lang 实体,类似于 JOIN FETCH,但更加灵活。
总结
解决 Hibernate N+1 查询问题需要综合考虑应用场景和数据访问模式。以下是一些建议:
- 延迟加载 (Lazy Loading): 适用于不需要立即加载所有关联实体的情况。
- JOIN FETCH: 适用于需要立即加载所有关联实体的情况。
- Projections (投影): 适用于只需要实体的一部分属性的情况。
- @BatchSize: 适用于需要在延迟加载和减少查询次数之间进行权衡的情况。
- EntityGraph: 适用于需要灵活控制加载哪些关联实体的情况。
选择合适的解决方案可以显著提高 Hibernate 应用的性能,避免不必要的数据库查询。

GitHub合并故障中的“已缓解并监控”和“已解决”不能互换。前者表示影响已经采取措施缓解,仍在观察稳定性;后者是供应商正式结束这场事故的状态。11月13日的Pull Requests合并超时事件先进入监控,随后于北京时间11月14日02:29标记为已解决。
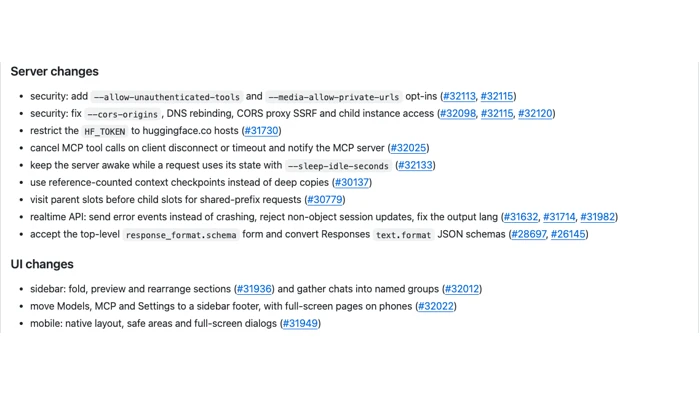
llama.cpp v1.0.0改善聊天组织、长消息编辑和附件预览;界面变化与底层API迁移、缓存及访问边界需要分别理解。
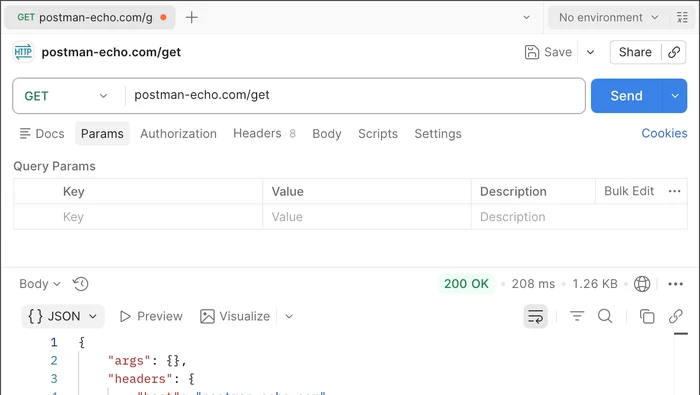
Postman 12.36.4 更新后仍有异常时,可按应用、API请求和平台服务区分问题范围,避免把补丁版本当作故障原因。
按正式、预发布和1.x维护渠道对应补丁,再结合Redis、Agent端点和Pinecone索引判断适用范围。
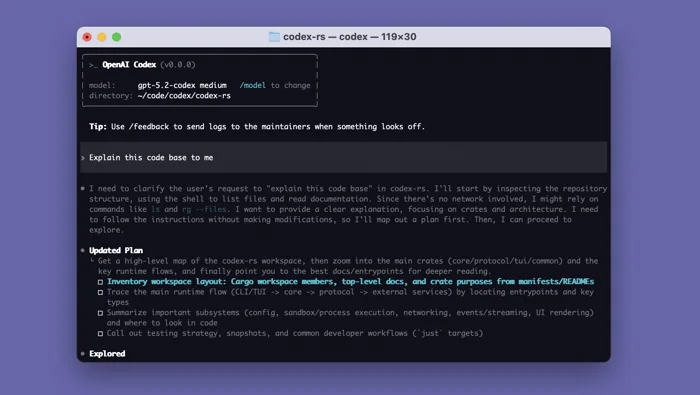
Codex CLI 0.169.0提供有明确说明的终端工作区能力;0.171.0-alpha.2为预发布,当前没有功能清单,选用时应分开评估。
llama.cpp b12345的预发布构建为Hexagon HTP后端增加Q5_0和Q5_1支持。选择模型时需要核对完整量化名称及实际运行后端,不能只看到“Q5”就视为同一种格式。
llama.cpp b12344的预发布构建调整了MCP工具调用的取消行为:客户端断连或调用超时时,服务器会向MCP服务发送带请求ID的取消通知。使用服务端工具的Web界面也属于这项变更范围。
GitHub对11月5日Actions与Checks事件的新增复盘指出:数据库服务在高并发大读请求下耗尽资源,导致部分运行无法排队或执行失败。检查类似问题时,先比对平台事件时间与失败状态,再决定是否重试自己的工作流。
GitHub对11月9日Actions事件的新增复盘说明:数据库迁移后,新区域容量与速率限制不足导致请求被拒,部分运行在服务恢复后仍占用并发。排查自己的工作流时,应把平台状态、运行状态与应用代码错误分开核对。
llama.cpp b12342新增面向少列矩阵计算的CUDA量化内核,覆盖2至24个src1列等场景,例如推测解码的验证阶段。新增内核针对Ampere及更新的NVIDIA GPU,并限定于发行说明列出的量化类型;它不是所有硬件与模型都会得到相同收益的通用开关。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



