

全球瞩目的「科目三」:梅西、钢铁侠、二次元小姐姐轻松应对

Air Explorer Pro是一款跨平台多网盘管理工具,可实现一站式完成不同网盘间文件的互传、搜索和同步等操作。任务管理和过程控制会更完整,持续下载、批量同步或需要稳定传输流程的场景会更适合它。
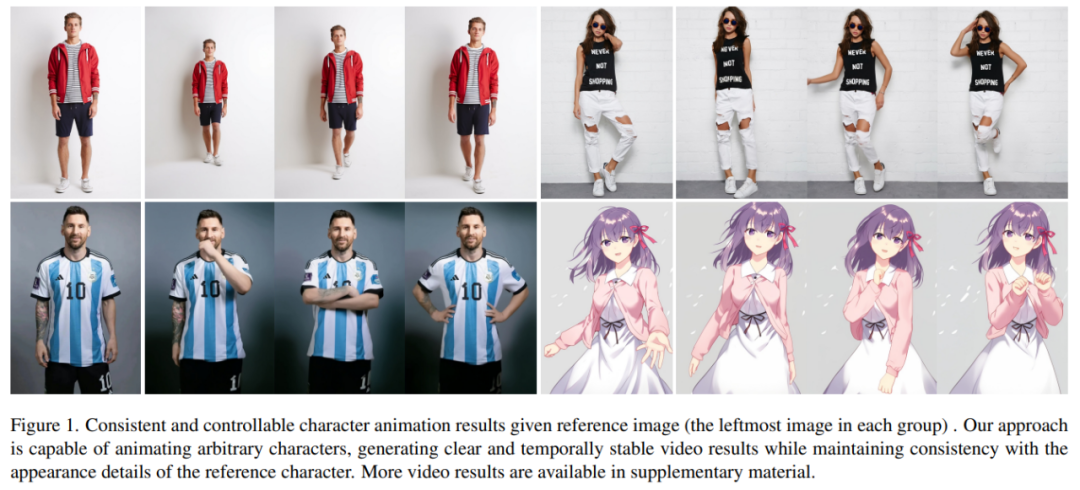
最近一段时间,你可能或多或少的听到过「科目三」,摇花手、半崴不崴的脚,配合着节奏鲜明的音乐,这一舞蹈动作遭全网模仿。如果相似的舞蹈,让AI生成会怎样?就像下图所展示的,不管是现代人、还是纸片人,都做着整齐划一的动作。你可能猜不到的是,这是根据一张图片生成的舞蹈视频。人物动作难度加大,生成的视频也非常丝滑(最右边):让梅西、钢铁侠动起来,也不在话下:还有各种动漫小姐姐。这些效果是如何实现的呢?我们继续往下看角色动画是将原始角色图像按照所需的姿态序列转化为逼真的视频的过程。这项任务有许多潜在的应用领域,比如在
最近一段时间,你可能或多或少的听到过「科目三」,摇花手、半崴不崴的脚,配合着节奏鲜明的音乐,这一舞蹈动作遭全网模仿。
如果相似的舞蹈,让 AI 生成会怎样?就像下图所展示的,不管是现代人、还是纸片人,都做着整齐划一的动作。你可能猜不到的是,这是根据一张图片生成的舞蹈视频。
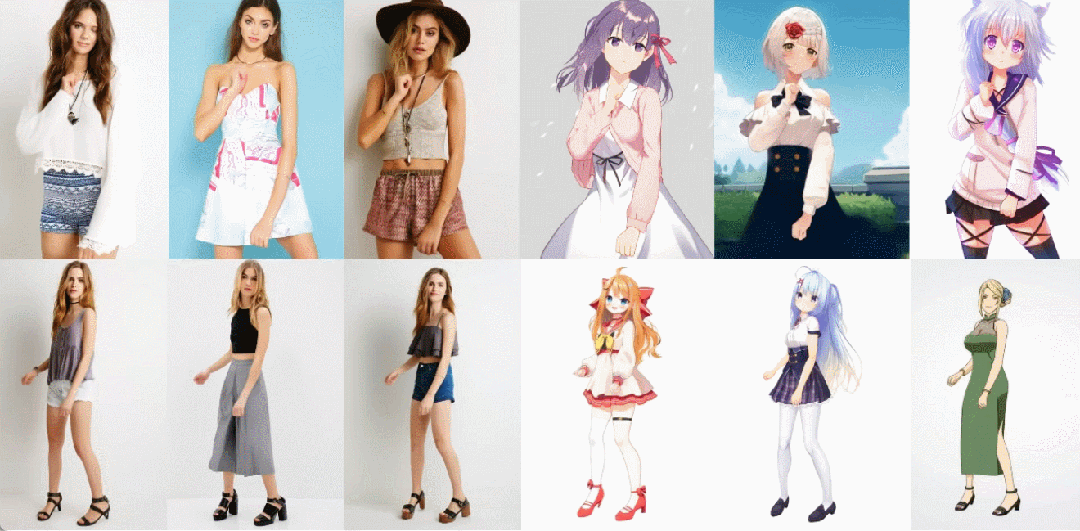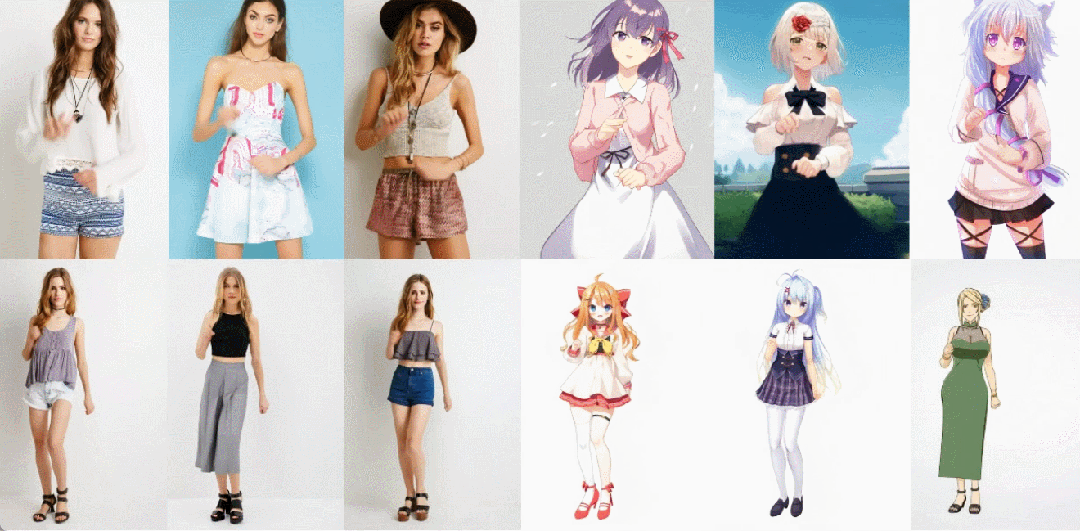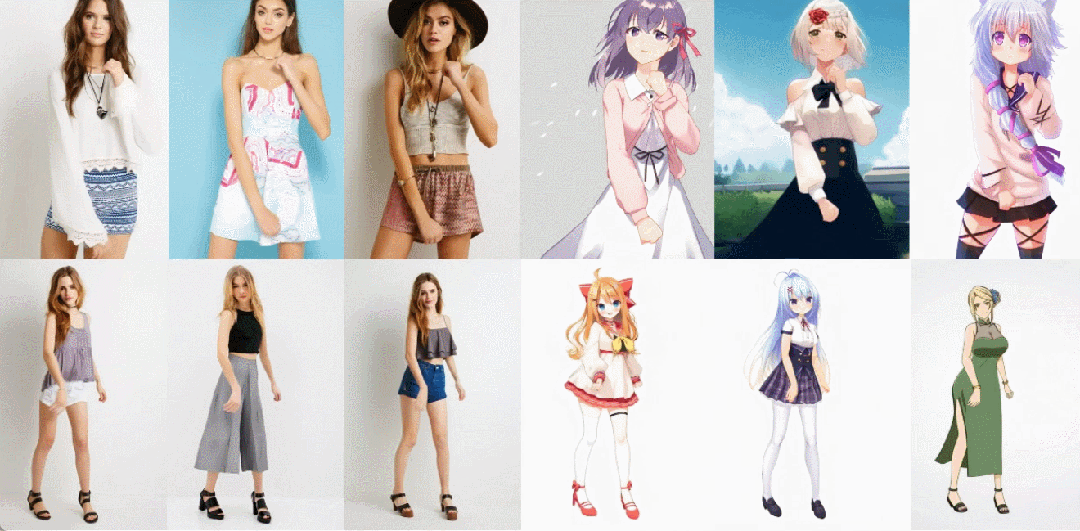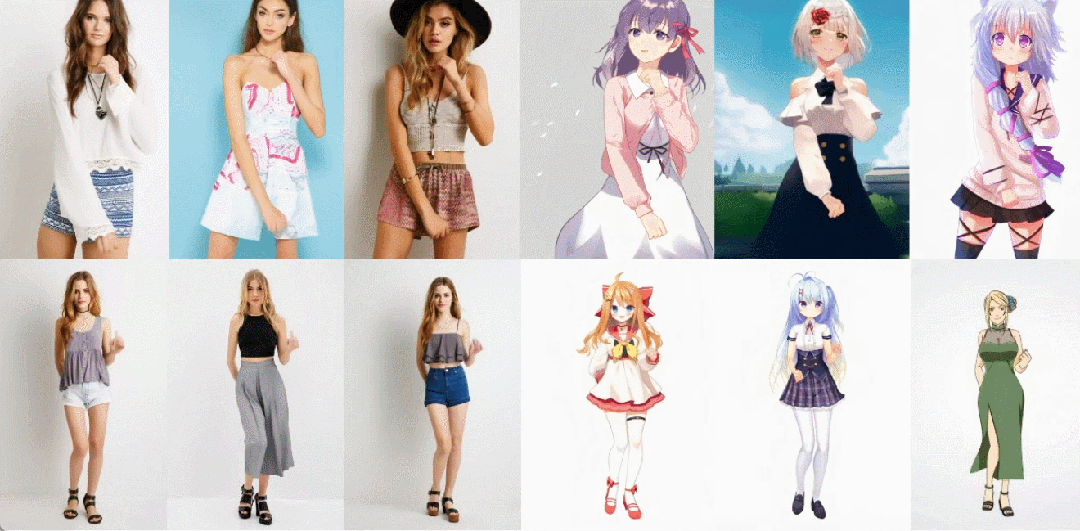
人物动作难度加大,生成的视频也非常丝滑(最右边):
让梅西、钢铁侠动起来,也不在话下:
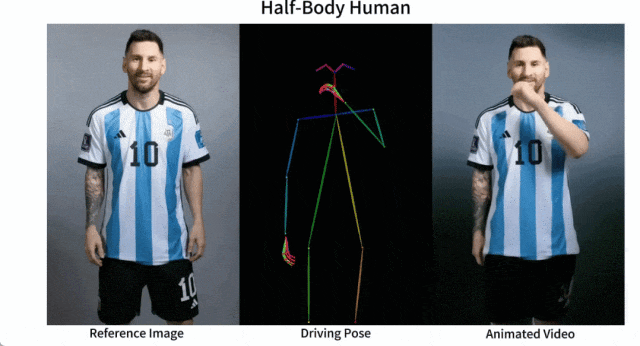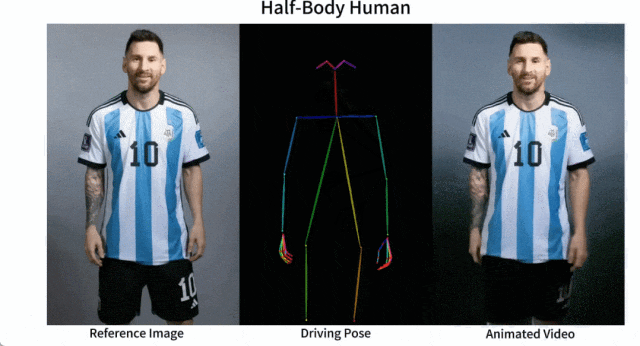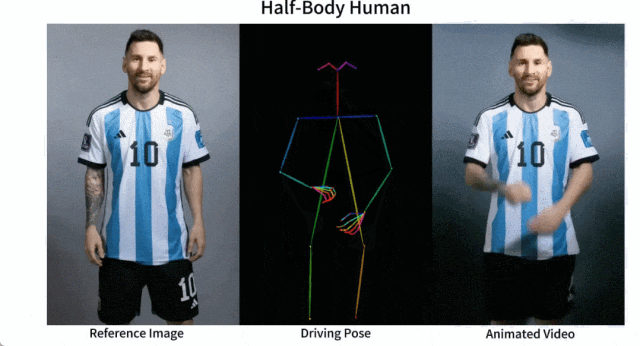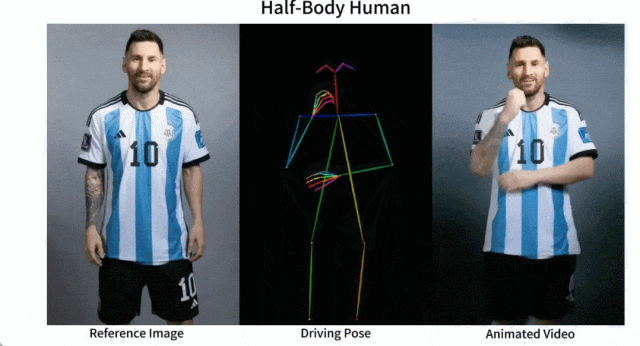
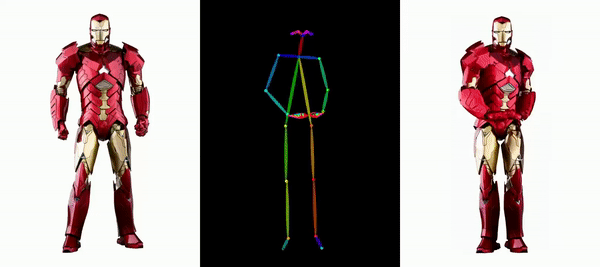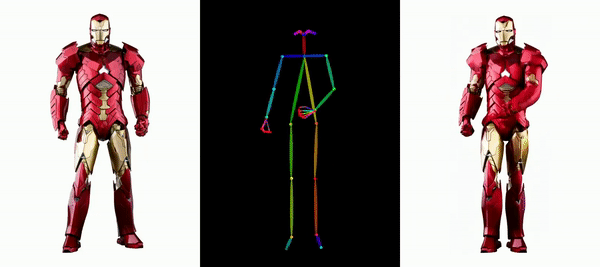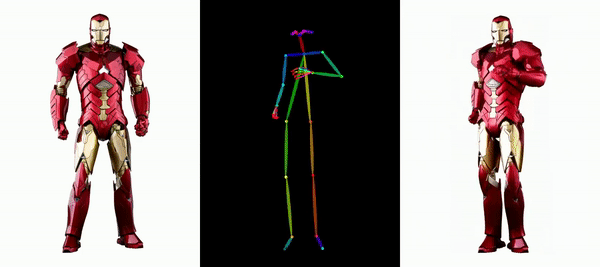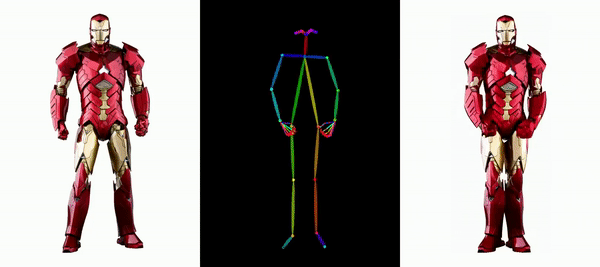
还有各种动漫小姐姐。
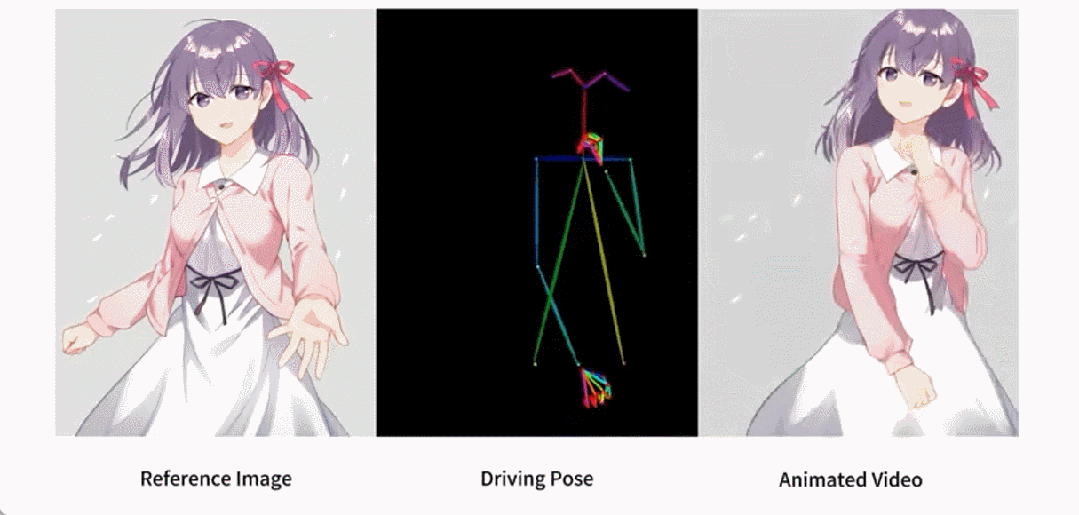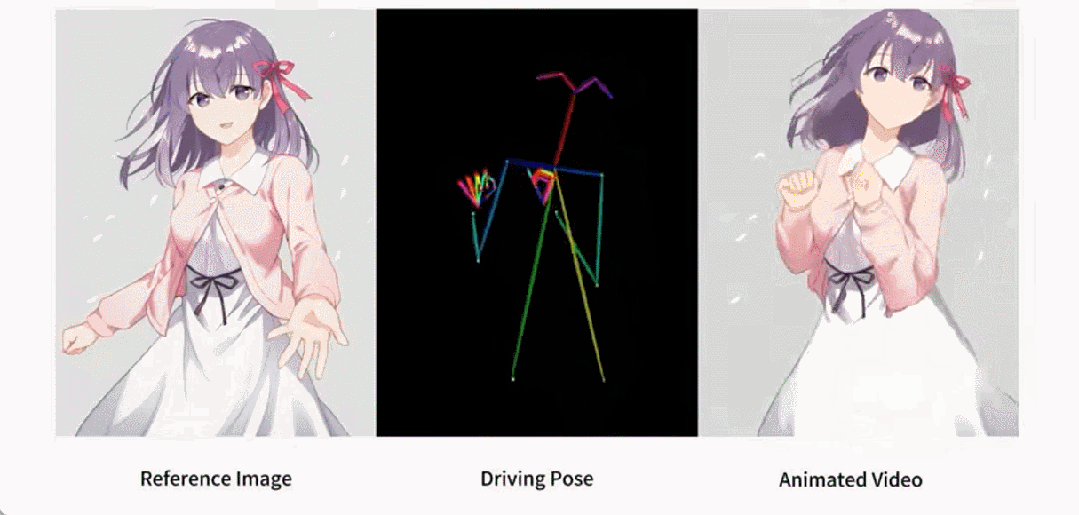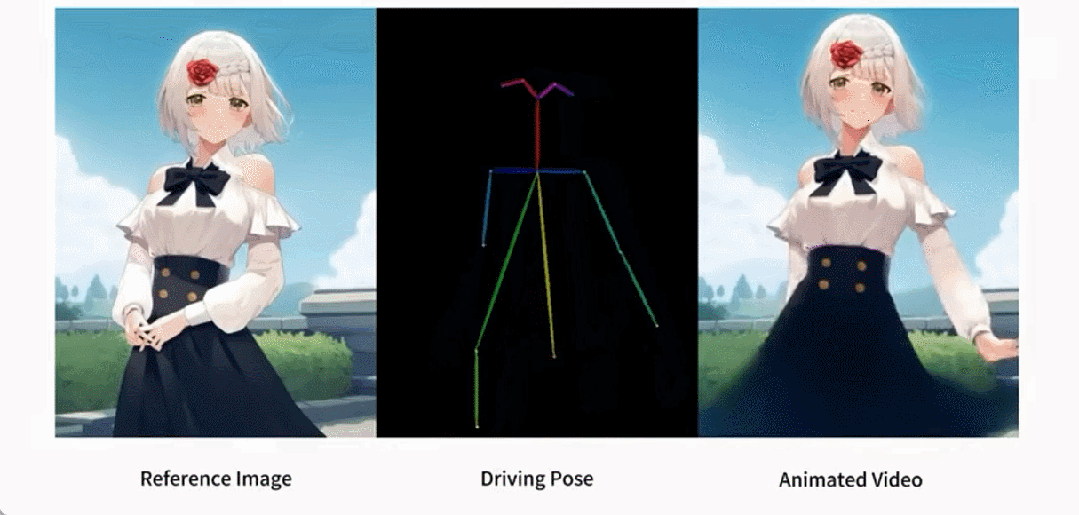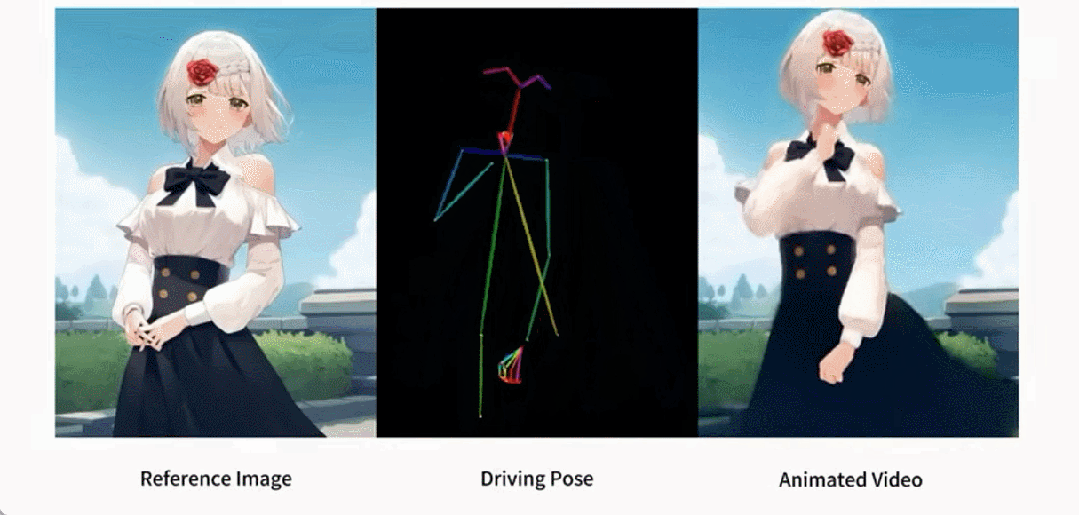
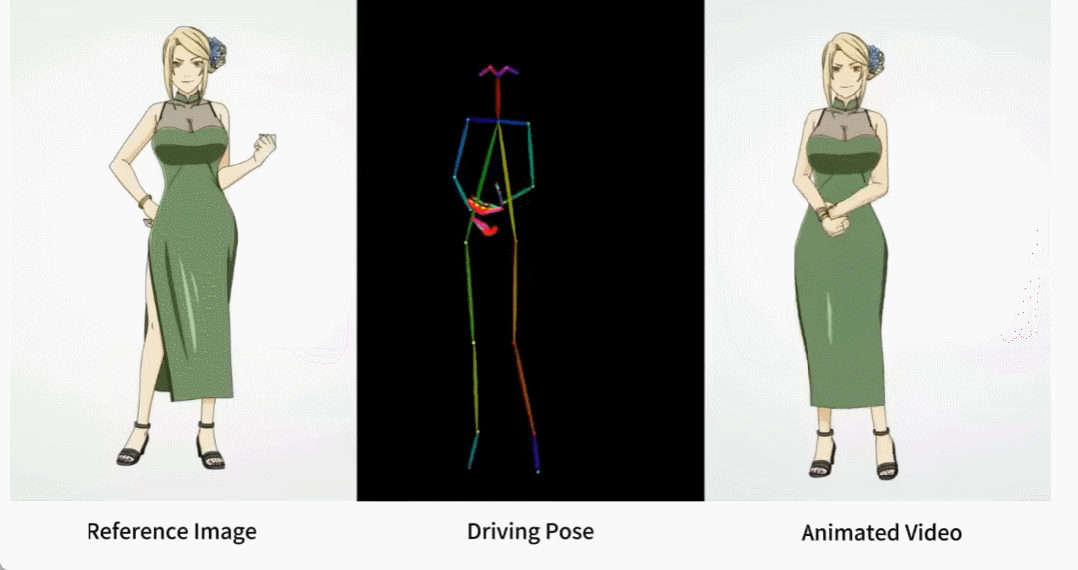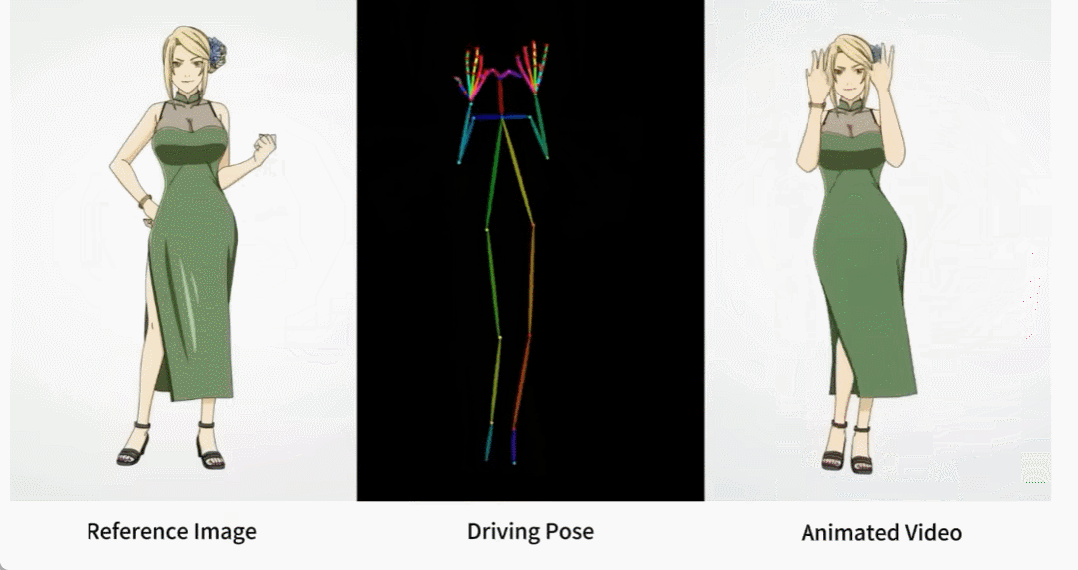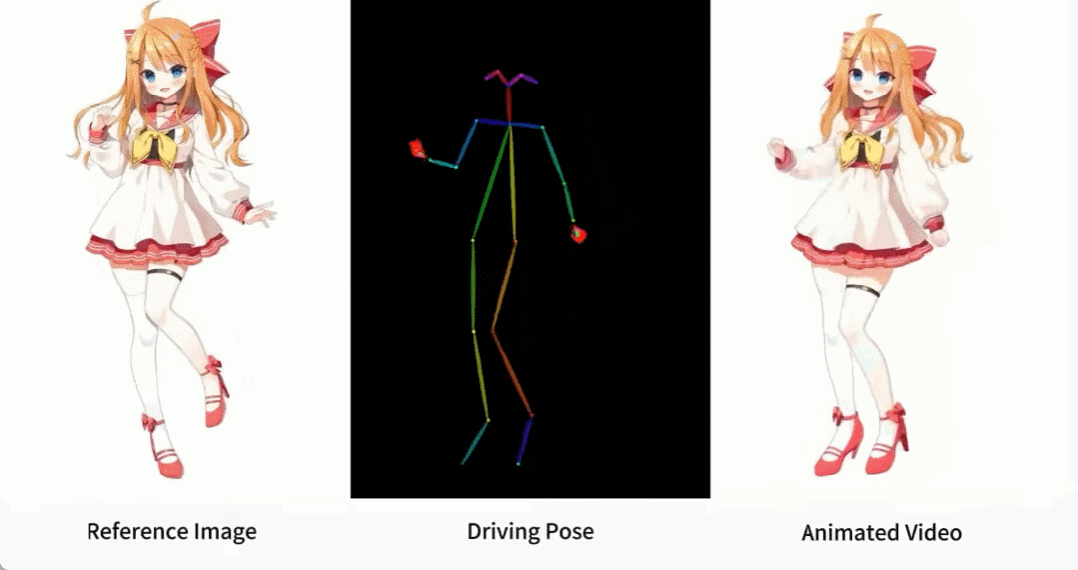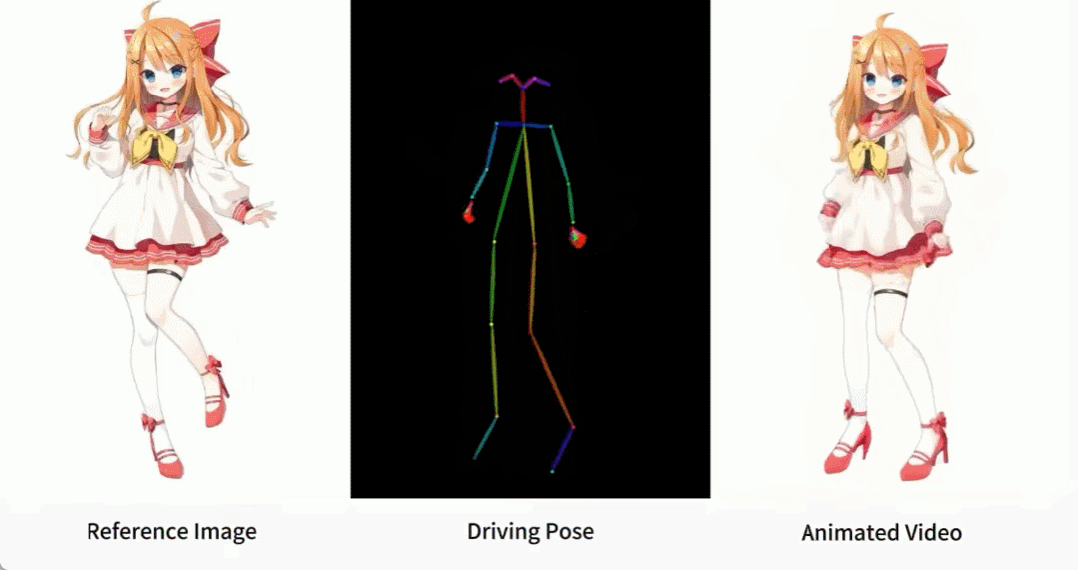
这些效果是如何实现的呢?我们继续往下看
角色动画是将原始角色图像按照所需的姿态序列转化为逼真的视频的过程。这项任务有许多潜在的应用领域,比如在线零售、娱乐视频、艺术创作和虚拟角色等等
自 GAN 技术问世以来,研究人员一直在不断深入探索将图像转换为动画以及完成姿态迁移的方法。然而,生成的图像或视频仍然存在一些问题,比如局部失真、细节模糊、语义不一致以及时间不稳定等,这些问题阻碍了这些方法的应用
阿里的研究者提出了一种名为Animate Anybody的方法,可以将角色图像转换为动画视频,并遵循所需的姿态序列。该研究采用了Stable Diffusion网络设计和预训练权重,并对去噪UNet进行了修改以适应多帧输入
- 论文地址:https://arxiv.org/pdf/2311.17117.pdf
- 项目地址:https://humanaigc.github.io/animate-anyone/
为了让外观保持一致性,该研究引入了ReferenceNet。该网络采用对称的UNet结构,旨在捕捉参考图像的空间细节。在每个相应的UNet块层中,该研究使用空间-注意力机制将ReferenceNet的特征集成到去噪UNet中。这种架构使得模型能够在一致的特征空间中全面地学习与参考图像的关系
为了确保姿态可控性,该研究设计了一种轻量级姿态引导器,以有效地将姿态控制信号集成到去噪过程中。为了实现时间稳定性,本文引入了时间层( temporal layer)来对多个帧之间的关系进行建模,从而在模拟连续且平滑的时间运动过程的同时保留视觉质量的高分辨率细节。
Animate Anybody 经过在 5K 角色视频剪辑的内部数据集上的训练而得到,如图 1 所示,展示了各种角色的动画结果。与以往的方法相比,本文的方法具有几个明显的优势:
- 首先,它有效地保持了视频中人物外观的空间和时间一致性。
- 其次,它生成的高清视频不会出现时间抖动或闪烁等问题。
- 第三,它能够将任何角色图像动画化为视频,不受特定领域的限制。
本文在两个特定的人类视频合成基准(UBC 时尚视频数据集和 TikTok 数据集)上进行了评估。结果显示,Animate Anybody 取得了 SOTA 结果。此外,该研究还将 Animate Anybody 方法与在大规模数据上训练的一般图像到视频方法进行了比较,结果显示 Animate Anybody 在角色动画方面展示了卓越的能力。
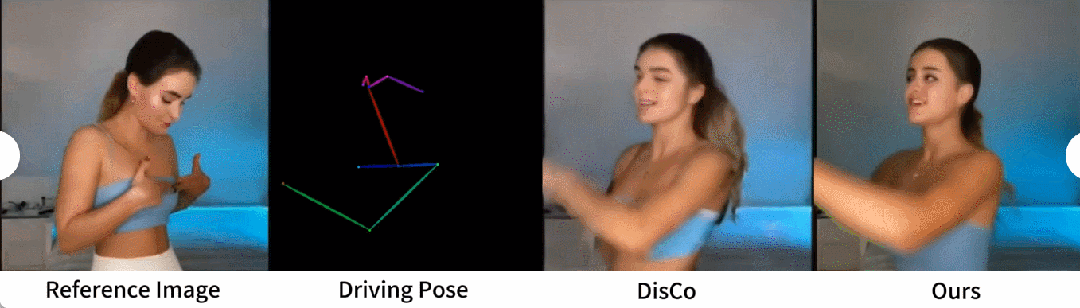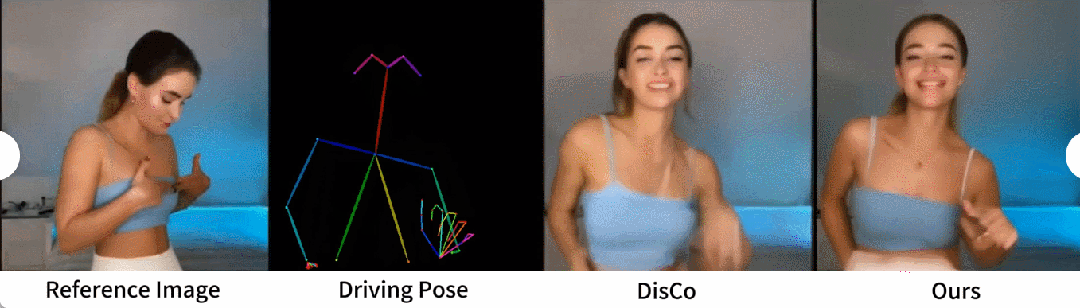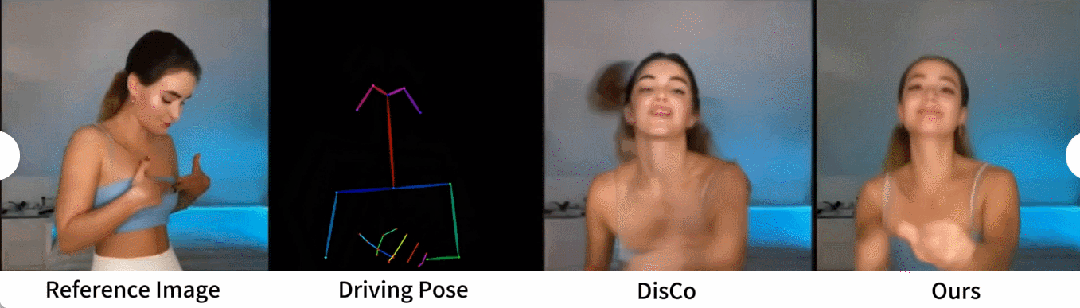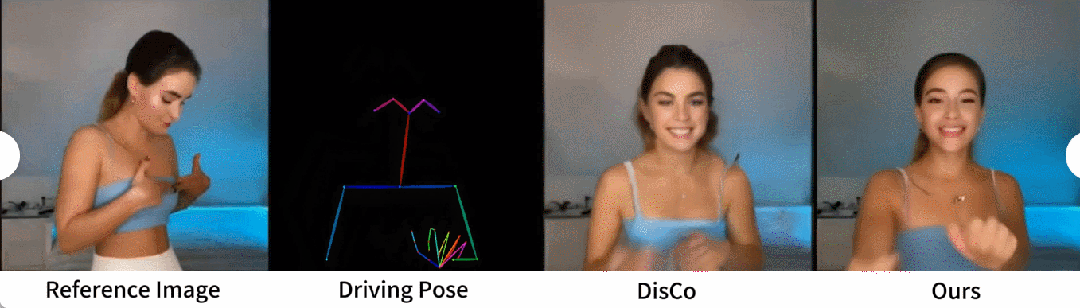
Animate Anybody 与其他方法的比较:
方法介绍
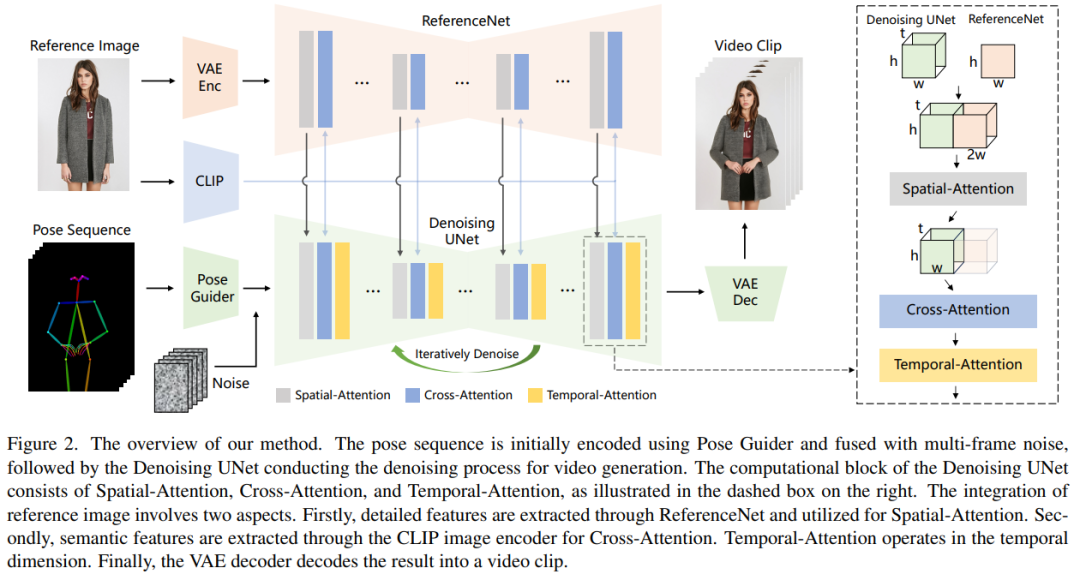
本文的处理方式如图 2 所示,网络的原始输入由多帧噪声构成。为了实现去噪效果,研究者采用了基于 SD 设计的配置方式,并使用了相同的框架和块单元,并继承了来自 SD 的训练权重。具体来说,这个方法包括三个关键部分,分别是:
- ReferenceNet,编码参考图像角色的外观特征;
- Pose Guider(姿态引导器),编码动作控制信号以实现可控角色运动;
- Temporal layer(时间层),编码时间关系以确保角色动作的连续性。
ReferenceNet
ReferenceNet 是一个参考图像特征提取网络,它的框架与去噪 UNet 大致相同,仅有时间层不同。因此,ReferenceNet 继承了与去噪 UNet 类似的原始 SD 权重,并且每个权重更新都是独立进行的。研究者解释了将 ReferenceNet 的特征集成到去噪 UNet 的方法。
ReferenceNet 的设计有两个优势。第一,ReferenceNet 可以利用原始 SD 的预训练图像特征建模能力,产生初始化良好的特征。第二,由于 ReferenceNet 与去噪 UNet 本质上具有相同的网络结构和共享初始化权重,因而去噪 UNet 可以选择性地从 ReferenceNet 中学习在同一特征空间关联的特征。
姿态引导器
重写后的内容为:该轻量级姿态引导器采用了四个卷积层(4×4内核,2×2步幅),通道数量分别为16、32、64、128,类似于[56]中的条件编码器,用于对齐分辨率与潜在噪声相同的姿态图像。处理后的姿态图像被添加到潜在噪声中,然后输入到去噪UNet进行处理。姿态引导器使用高斯权重进行初始化,并在最终的映射层中使用了零卷积
时间层
时间层的设计灵感来自 AnimateDiff。对于一个特征图 x∈R^b×t×h×w×c,研究者首先将它变形为 x∈R^(b×h×w)×t×c,然后执行时间注意力,即沿着维度 t 的自注意力。时间层的特征通过残差连接合并到了原始特征中,这种设计与下文的双阶段训练方法相一致。时间层专门在去噪 UNet 的 Res-Trans 块内使用。
训练策略
训练过程分为两个阶段。
重写后的内容: 在第一阶段的训练中,使用单个视频帧进行训练。在去噪 UNet 模型中,研究者暂时排除了时间层,将单帧噪声作为输入。同时,还对参考网络和姿态引导器进行了训练。参考图像是从整个视频片段中随机选择的。他们使用了预训练权重来初始化去噪 UNet 和 ReferenceNet 模型。姿态引导器的初始化使用了高斯权重,但最后的投影层除外,该层使用了零卷积。VAE 的编码器和解码器以及 CLIP 图像编码器的权重保持不变。这一阶段的优化目标是在给定参考图像和目标姿态的条件下生成高质量的动画图像
在第二阶段,研究者将时间层引入先前训练好的模型,并使用 AnimateDiff 中预先训练好的权重对其进行初始化。模型的输入包括一个 24 帧的视频片段。在这一阶段,只训练时间层,同时固定网络其他部分的权重。
实验与结果
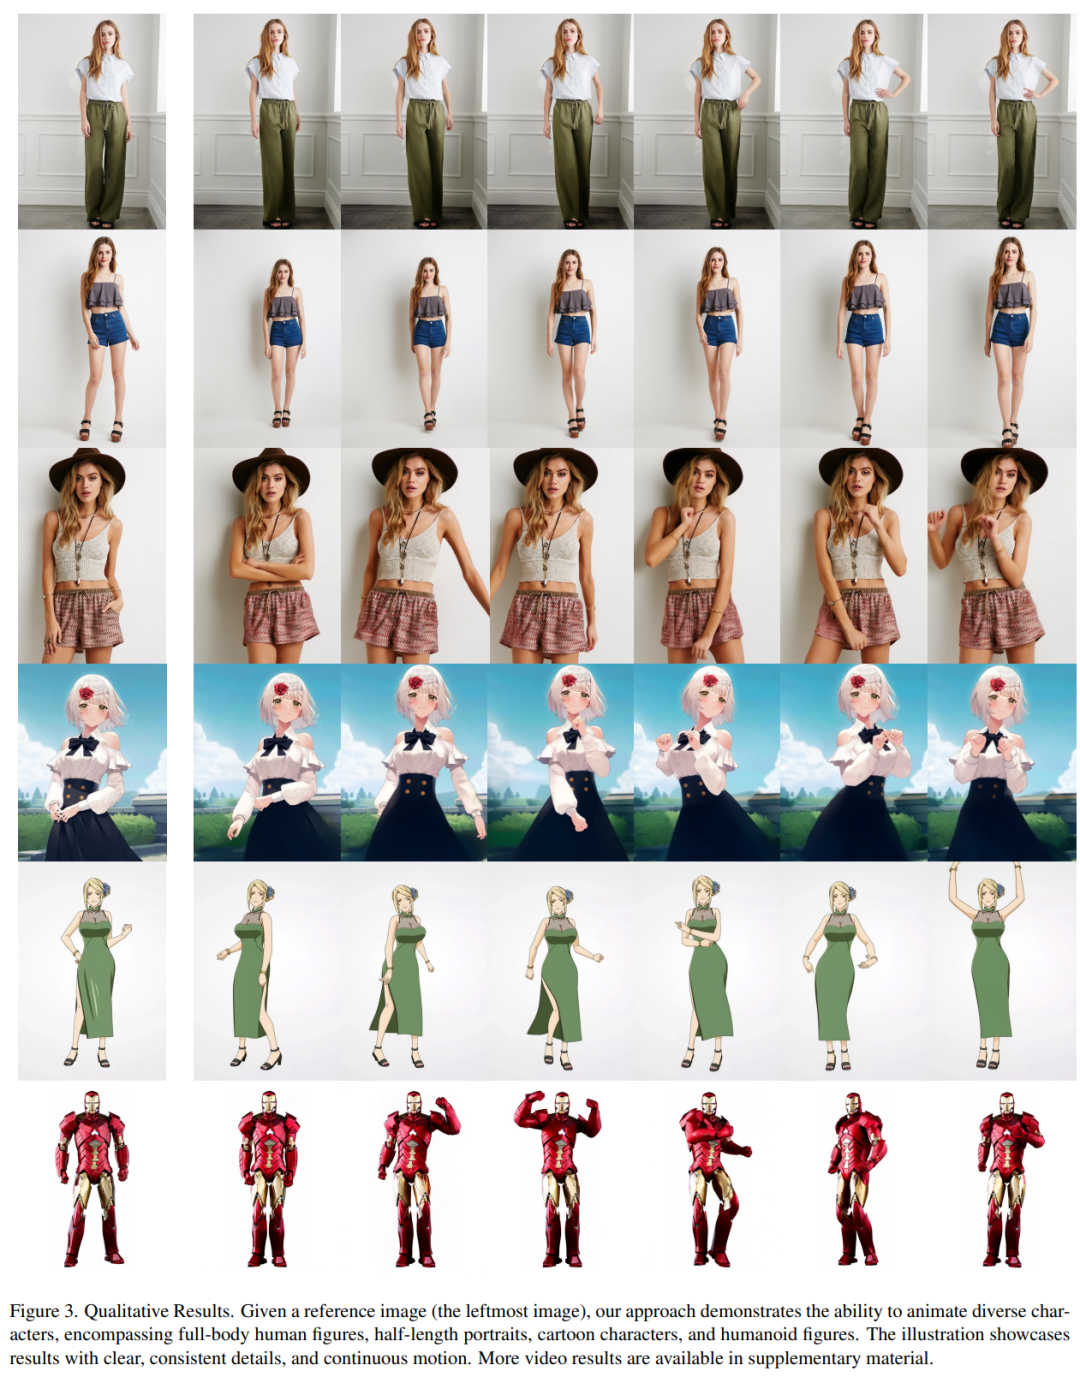
定性结果:如图 3 显示,本文方法可以制作任意角色的动画,包括全身人像、半身人像、卡通人物和仿人角色。该方法能够生成高清晰度和逼真的人物细节。即使在大幅度运动的情况下,它也能与参考图像保持时间上的一致性,并在帧与帧之间表现出时间上的连续性。
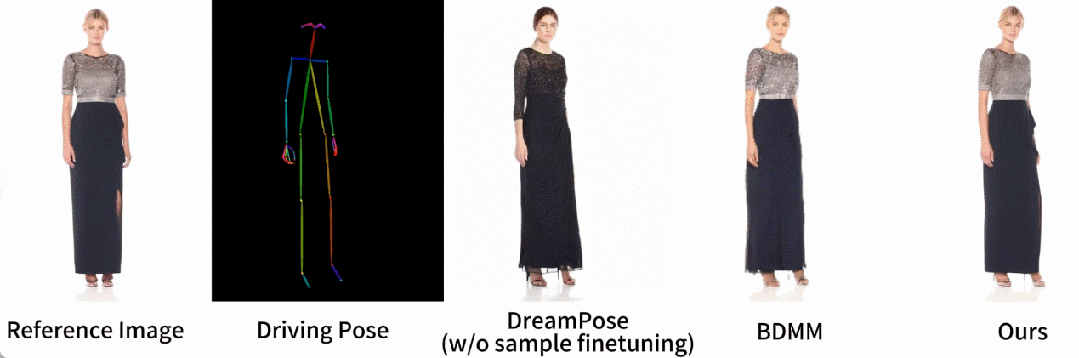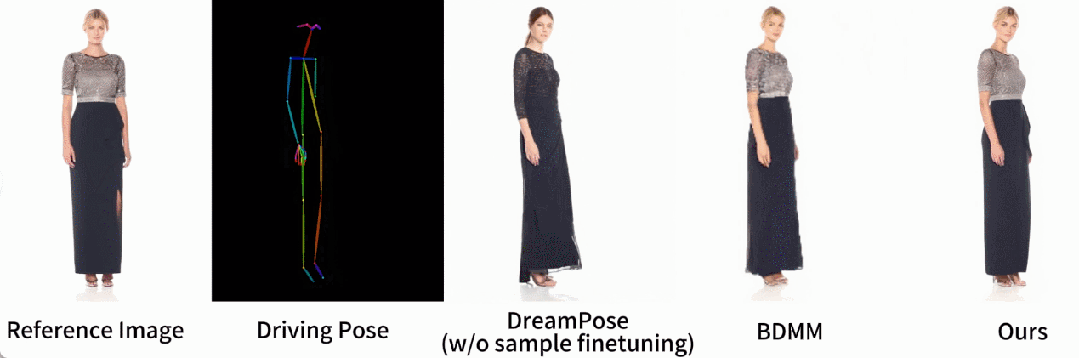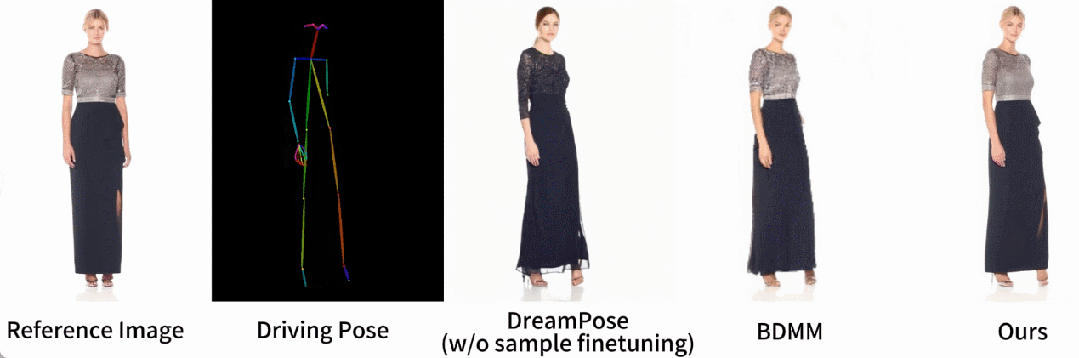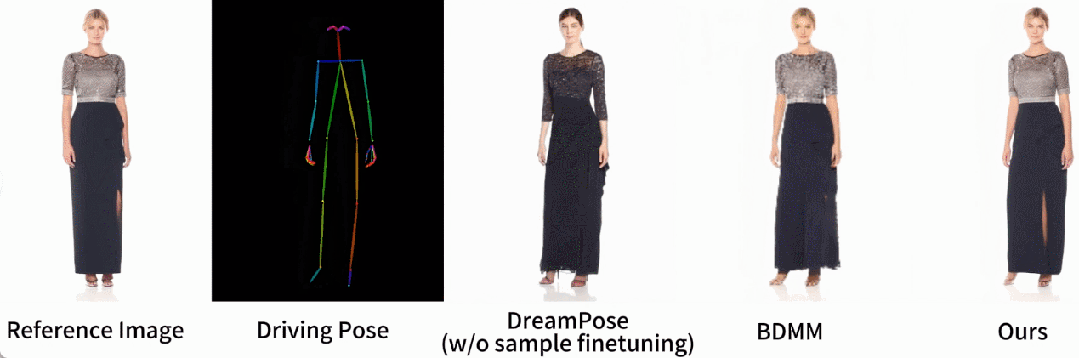
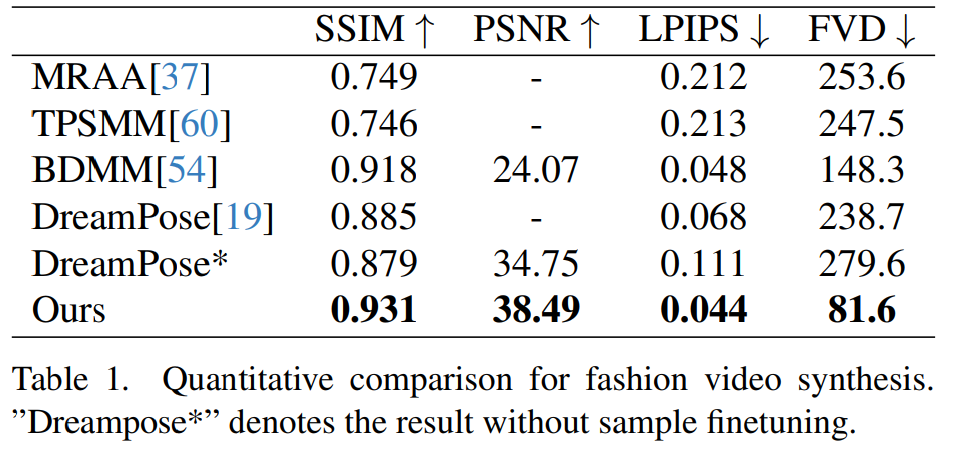
时尚视频合成。时尚视频合成的目的是利用驱动姿态序列将时尚照片转化为逼真的动画视频。实验在 UBC 时尚视频数据集上进行,该数据集由 500 个训练视频和 100 个测试视频组成,每个视频包含约 350 个帧。定量比较见表 1。在结果中可以发现,本文方法优于其他方法,尤其是在视频度量指标方面表现出明显的领先优势。
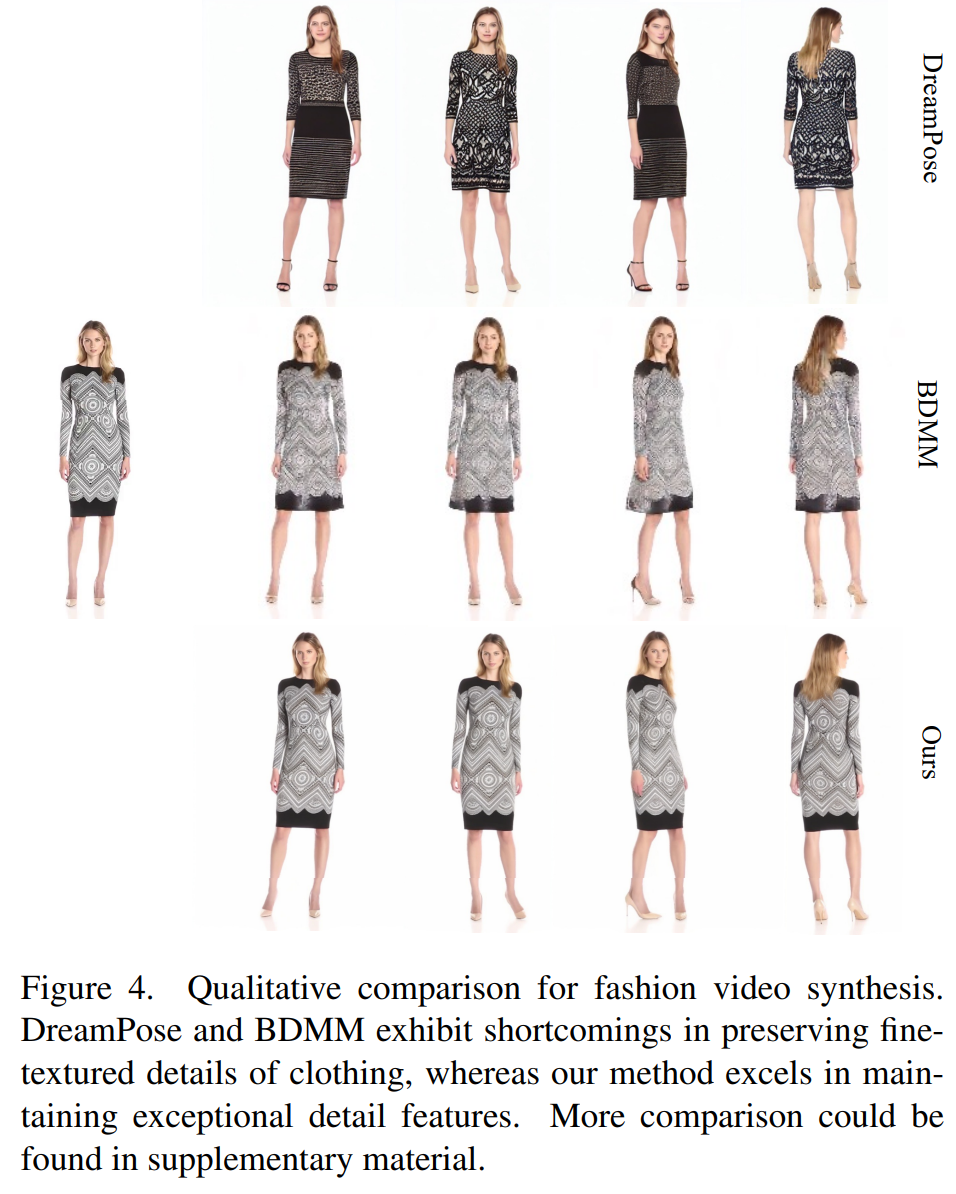
定性比较如图 4 所示。为了进行公平比较,研究者使用 DreamPose 的开源代码获得了未进行样本微调的结果。在时尚视频领域,对服装细节的要求非常严格。然而,DreamPose 和 BDMM 生成的视频无法保持服装细节的一致性,并在颜色和精细结构元素方面表现出明显的误差。相比之下,本文方法生成的结果能更有效保持服装细节的一致性。
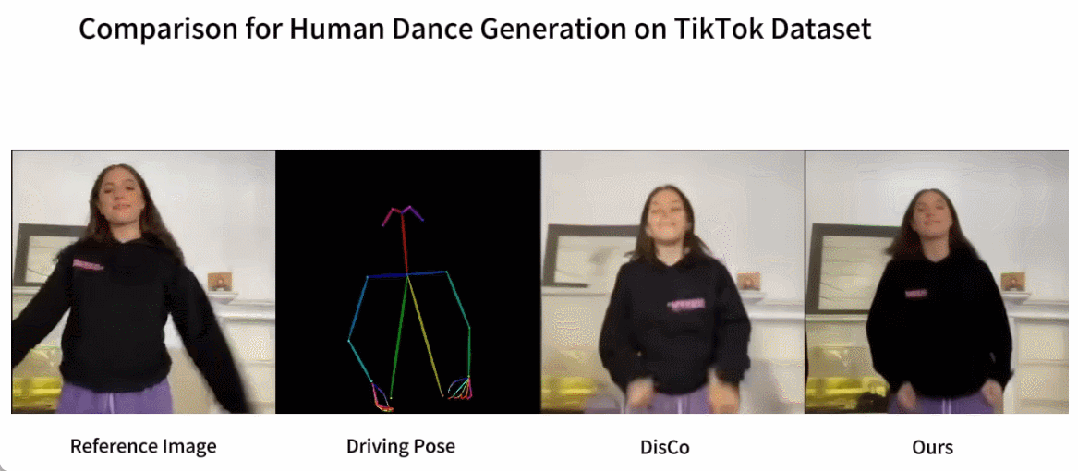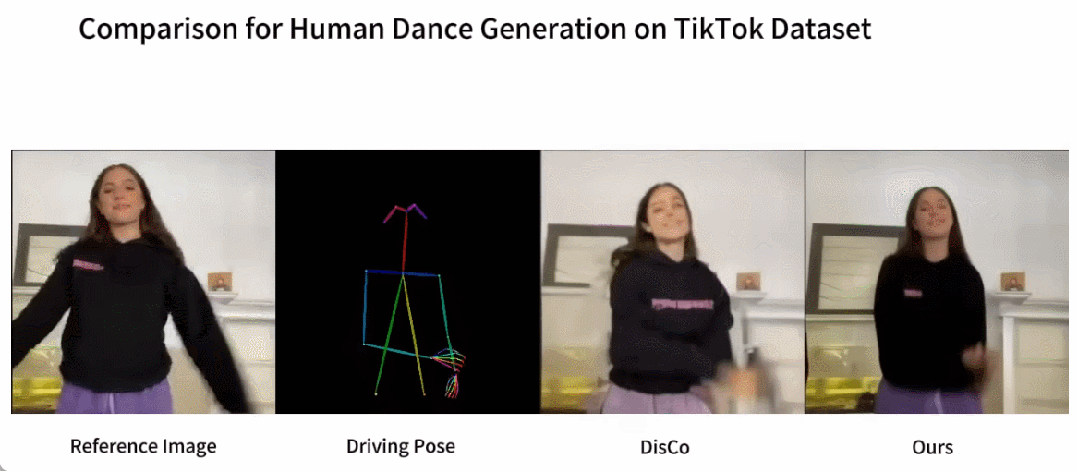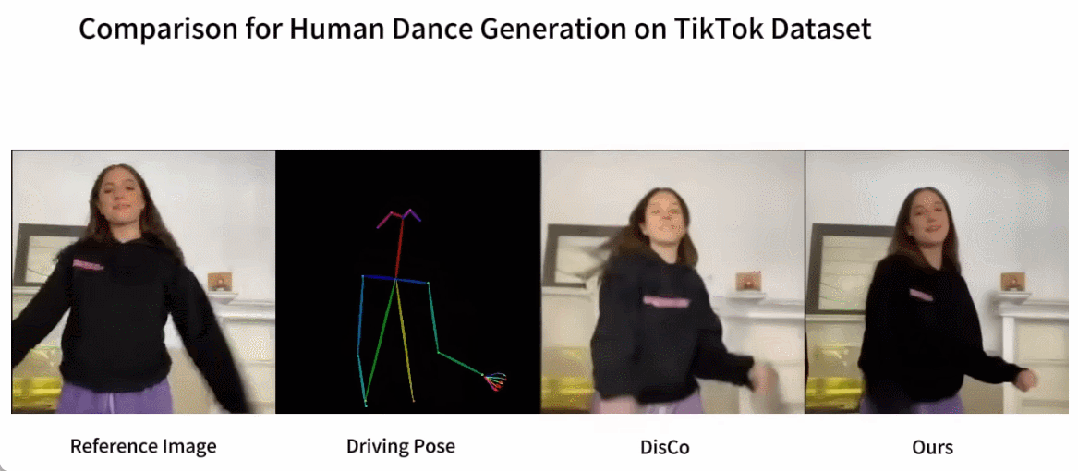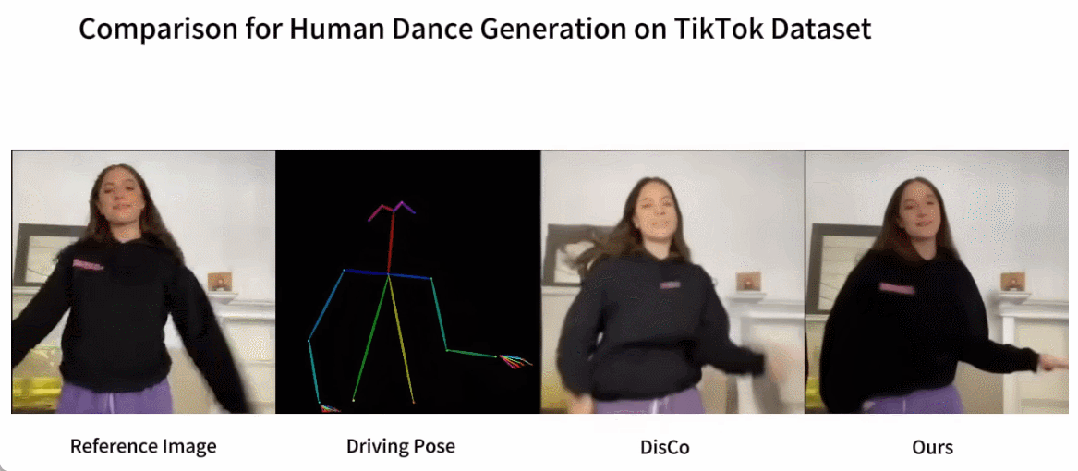
人类舞蹈生成是一项研究,其目标是通过对现实舞蹈场景图像进行动画处理来生成人类舞蹈。研究者们使用了TikTok数据集,其中包括340个训练视频和100个测试视频。他们按照DisCo的数据集划分方法,使用相同的测试集进行了定量比较,其中包含10个TikTok风格的视频。通过表2可以看出,本文的方法取得了最佳结果。为了增强模型的泛化能力,DisCo结合了人类属性预训练,并利用大量图像对进行了模型预训练。相比之下,其他研究者只在TikTok数据集上进行训练,但结果仍然优于DisCo
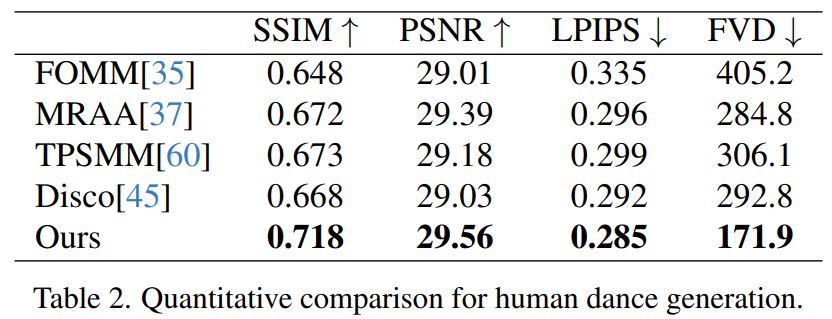
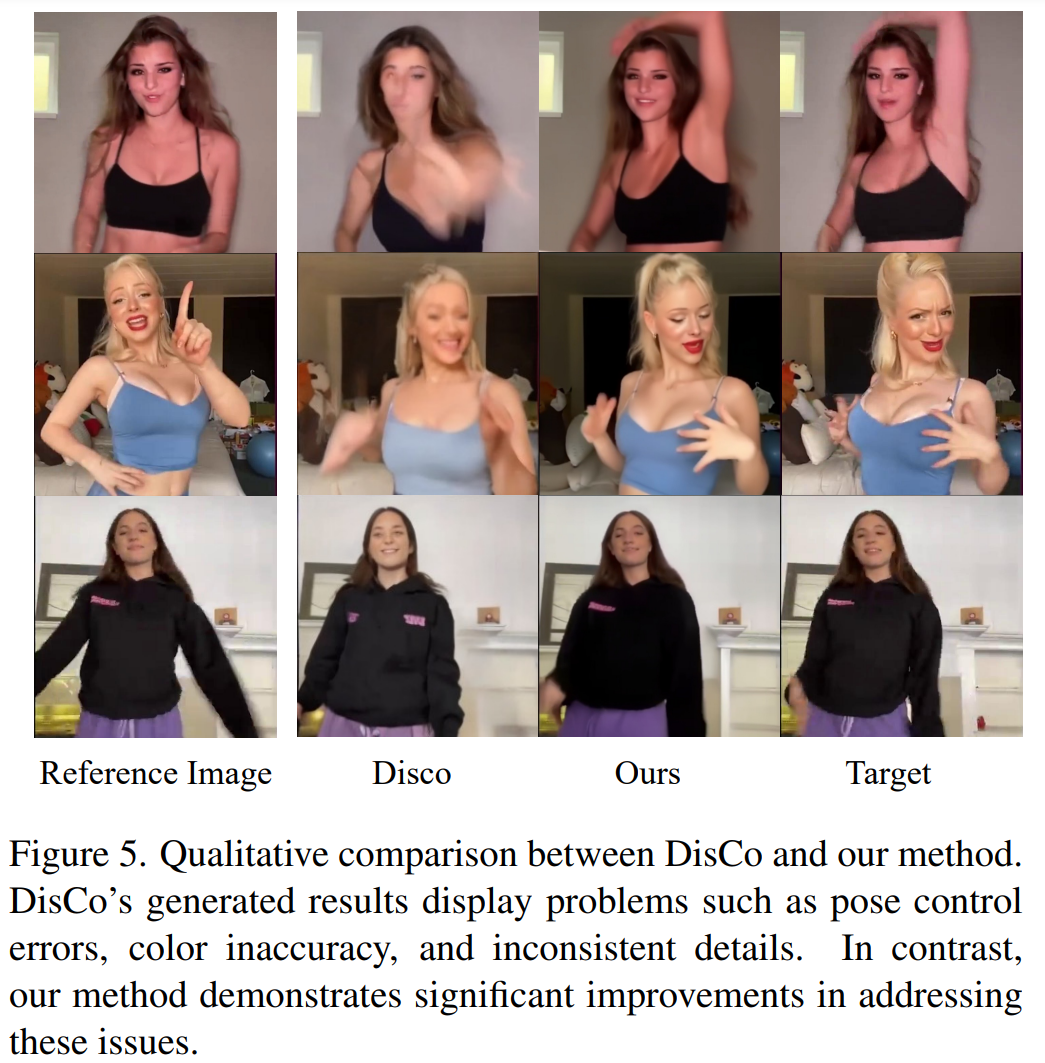
图 5 中展示了与 DisCo 的定性比较。考虑到场景的复杂性,DisCo 的方法需要额外使用 SAM 来生成人类前景掩码。相反,本文方法表明,即使没有明确的人体掩码学习,模型也能从被摄体的运动中掌握前景与背景的关系,而无需事先进行人体分割。此外,在复杂的舞蹈序列中,该模型在保持整个动作的视觉连续性方面表现突出,并在处理不同的角色外观方面表现出更强的稳健性。
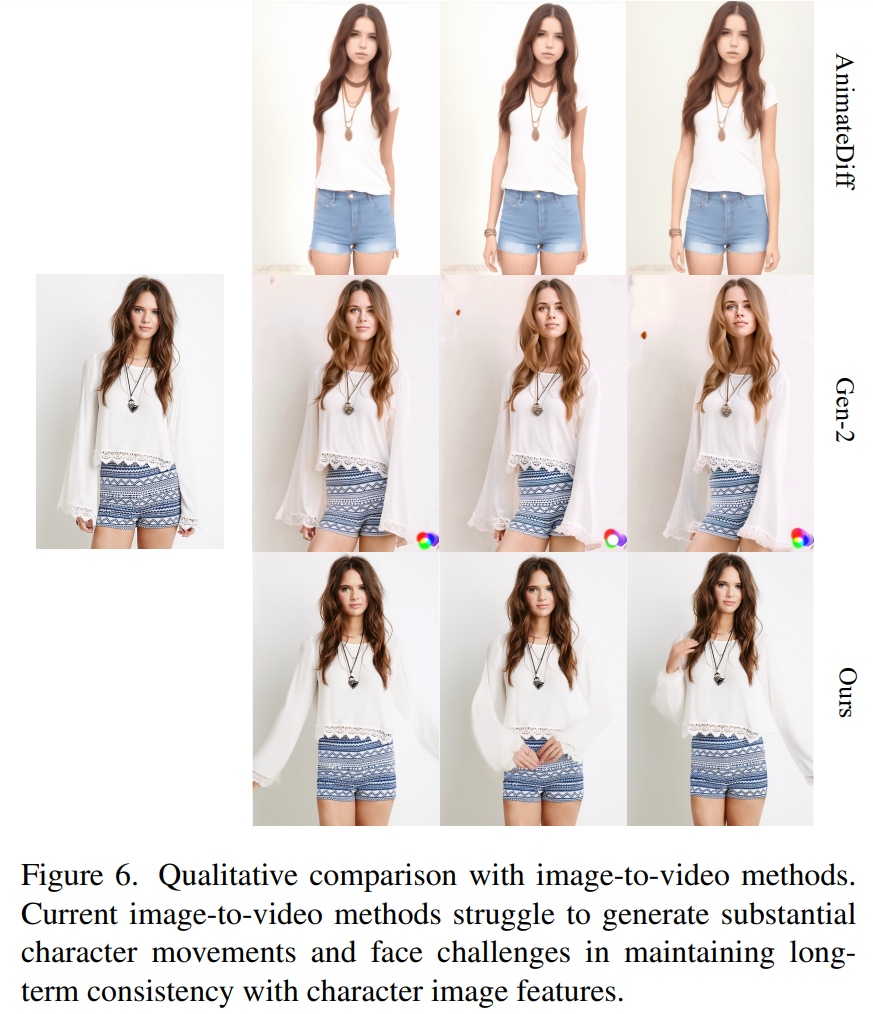
图像 - 视频的通用方法。目前,许多研究都提出了基于大规模训练数据、具有强大生成能力的视频扩散模型。研究者选择了两种最著名、最有效的图像 - 视频方法进行比较:AnimateDiff 和 Gen2。由于这两种方法不进行姿态控制,因此研究者只比较了它们保持参考图像外观保真度的能力。如图 6 所示,当前的图像 - 视频方法在生成大量角色动作方面面临挑战,并且难以在视频中保持长期的外观一致性,从而阻碍了对一致角色动画的有效支持。
请查阅原始论文以获取更多信息

本文解析超聚变在2026数博会发布的“智企”范式,重点阐述如何通过Token生产平台(Token Factory)与企业业务本体建模,实现从简单AI工具调用到企业应用架构系统性重构的演进。文章详细拆解了智能体编排、数字孪生及生态协同等关键技术路径,为AI时代企业数字化转型提供可落地的参考方案。


从Office转向WPS的核心操作肌肉记忆切换通常需3至7天,不影响正常办公。适应期长短取决于界面视觉差异与专属格式配置。通过切换“经典界面”、嵌入字体及开启云同步,可实现平滑过渡。本文详解格式兼容、数据迁移及AI功能适用场景,适用于需多端协同、成本控制及国产化兼容的办公人群。
加拿大一母亲起诉OpenAI,称ChatGPT设计缺陷导致其女儿自杀,指控其优先用户参与度而非安全性,持续提供情感支持致过度依赖。专家指出AI应“陪伴但不过界”,需设定边界并引导求助。国家已出台拟人化互动服务管理办法。
2026届高考生学车时多采用AI教练,逐步适应人机共驾。作为与生成式AI共同成长的一代,他们更易接受智能驾驶,未来可能成为首批“原生AI司机”。至2030年前后,其人生首辆车或具备L3级自动驾驶能力,驾驶角色将从操控者转向监督者。
全球股市因AI热潮呈现K型分化,半导体板块估值逼近百倍市盈率。历史警示:2000年互联网泡沫中的“四骑士”最终市值暴跌或长期盘整。投资者应警惕“错失恐惧症”,重视安全边际、护城河与能力圈,避免被高估值裹挟,关注稳健性与股息率。
Cloudflare报告显示,完成应用现代化的企业从AI投资中获得可衡量回报的概率是未现代化企业的三倍。93%的决策者视系统更新为AI先决条件,91%的领先企业已嵌入AI功能。安全与现代化协同推进可使AI成熟度提升四倍,精简技术架构成为竞争力分水岭。
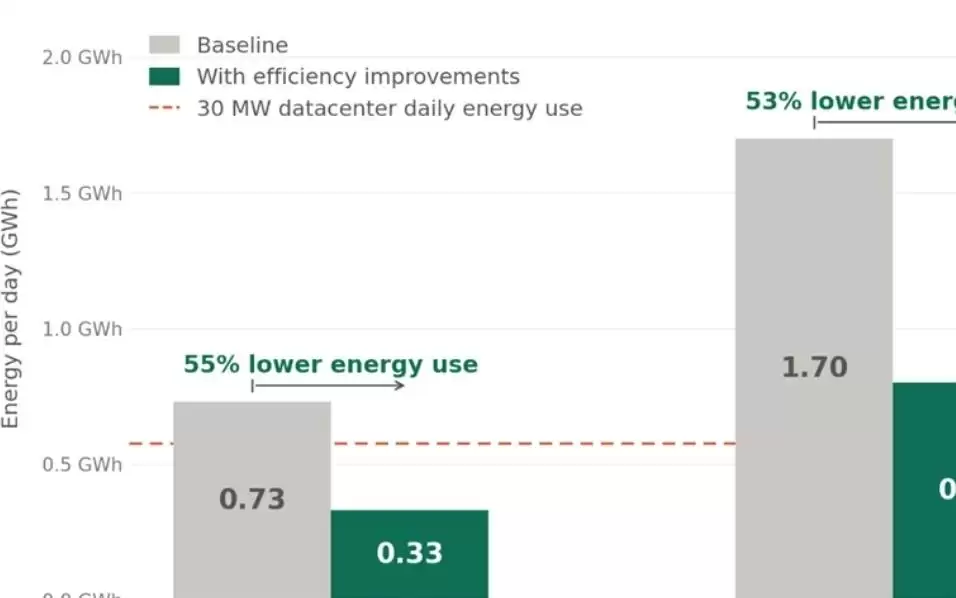
据微软引用《Joule》期刊的一项研究指出,每一次典型人工智能查询耗电量零点一六至零点六零瓦时,其冷却用水量中位数不足一滴水。大规模部署下,单位查询的效率会更高,总能耗可以降低一半以上。
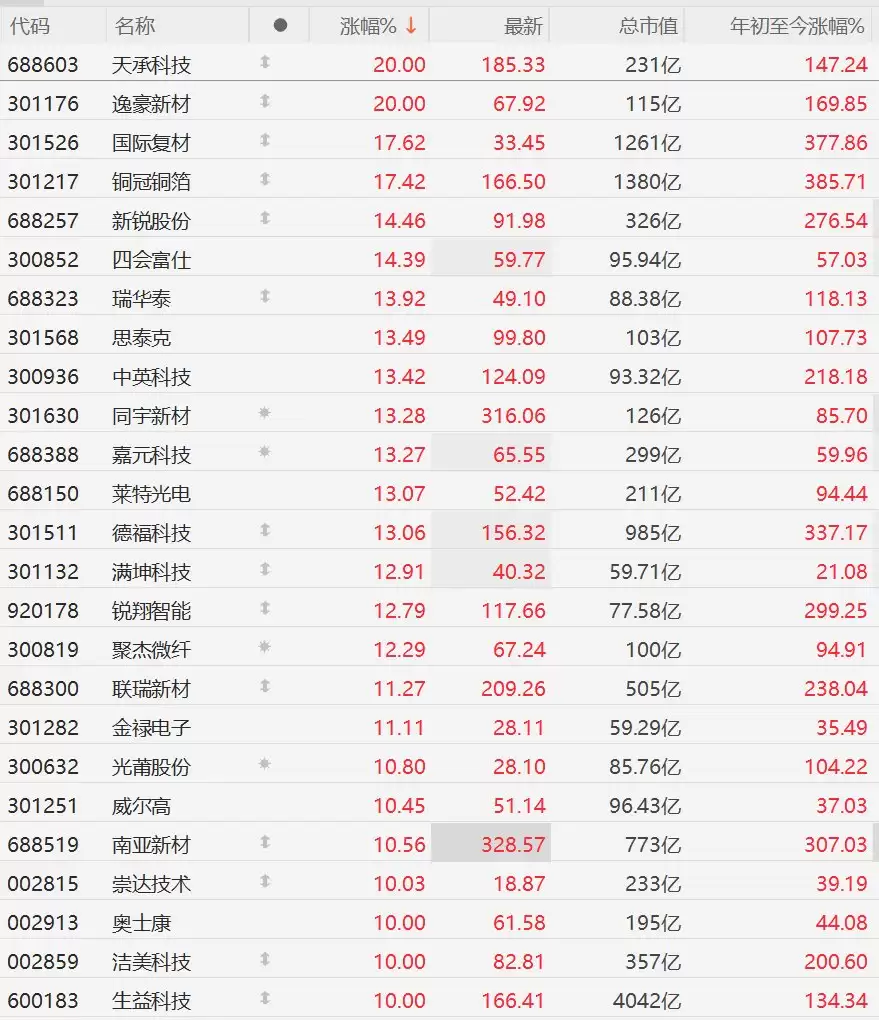
A股PCB概念板块掀起涨停潮,因摩根士丹利报告预测AI光模块PCB市场三年增长超5倍,2025至2028年规模从6.2亿美元增至37.7亿美元,年复合增速高达83%,远超光模块整体增速。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



