

文心4.5 vs DeepSeek vs Qwen 3.0 实测对比谁更强
人们眼中的天才之所以卓越非凡,并非天资超人一等而是付出了持续不断的努力。1万小时的锤炼是任何人从平凡变成超凡的必要条件。————马尔科姆·格拉德威尔?嗨,我是Xxtaoaooo!一、前言:背景介绍6月30日,百度文心大模型4.5系列模型正式开源,并在国内领先的开源平台GitCode首发上线,为广大企业、开发者提供真正可用、好用、可落地的大模型解决方案。文心4.5系列开源模型共10款,涵盖了激活参数规模分别为47B和3B的混合专家(MoE)模型(最大的模型总
人们眼中的天才之所以卓越非凡,并非天资超人一等而是付出了持续不断的努力。1万小时的锤炼是任何人从平凡变成超凡的必要条件。———— 马尔科姆·格拉德威尔
? 嗨,我是Xxtaoaooo!
一、前言:背景介绍
6 月 30 日,百度文心大模型 4.5 系列模型正式开源,并在国内领先的开源平台 GitCode 首发上线,为广大企业、开发者提供真正可用、好用、可落地的大模型解决方案。文心 4.5 系列开源模型共 10 款,涵盖了激活参数规模分别为 47B 和 3B 的混合专家(MoE)模型(最大的模型总参数量为 424B),以及 0.3B 的稠密参数模型。其中,ERNIE-4.5-VL-424B-A47B 作为此次发布的黑马模型,是文心大模型4.5开源系列的旗舰级多模态模型,支持深度思考,支持文本、图片、视频、语言等多模态内容的理解,特别适合复杂多模场景。
文心4.5大模型技术亮点:
创新模块 | 技术方案 | 解决的问题 |
|---|---|---|
多模态异构MoE | 模态隔离路由 + 路由正交损失 | 多模态训练中的模态干扰 |
高效训练引擎 | FP8混合精度 + 分层负载均衡 | 千亿级MoE模型的训练吞吐瓶颈 |
推理极速优化 | 卷积代码量化(4bit无损) + PD解耦 | 边缘设备部署资源限制 |
生态整合 | 深度适配飞桨(PaddlePaddle)全栈工具链 | 国产硬件兼容性与部署灵活性 |
ERNIE 4.5不仅是模型开源,更将预训练框架、量化工具链、异构调度策略完整公开,为国产大模型技术栈注入强心剂;更是 首度公开MoE训练框架 与 4bit无损量化工具链。这意味着:
开发者可在消费级显卡(如RTX 4090)微调百亿参数专家模型企业可基于PD解耦策略构建低成本大模型服务集群国产硬件的深度适配(寒武纪/昇腾)突破CUDA生态垄断并且,针对千亿级MoE模型的 显存墙 与 计算效率 瓶颈,文心4.5实现三重突破:
优化阶段 | 关键技术 | 性能收益 | 工业价值 |
|---|---|---|---|
训练 | FP8混合精度+细粒度重计算 | 吞吐量达同类模型1.8x | 同等算力多训30%数据 |
推理 | 卷积代码量化(4bit无损) | 显存占用↓35% | 边缘设备部署成为可能 |
调度 | PD解耦+动态角色切换 | 推理延迟↓40% | 高并发企业级API响应 |
二、三大能力维度对比实测
本次对比评测模型:ERNIE-4.5-VL-424B-A47B、Qwen3-235B-A22B 、ERNIE-4.5-300B-A47B、DeepSeek-R1
2.1 维度一:语言理解能力
测试基准:C-Eval(中文综合评测)、CMMLU(多任务理解)、长文本语义连贯性
测试案例:
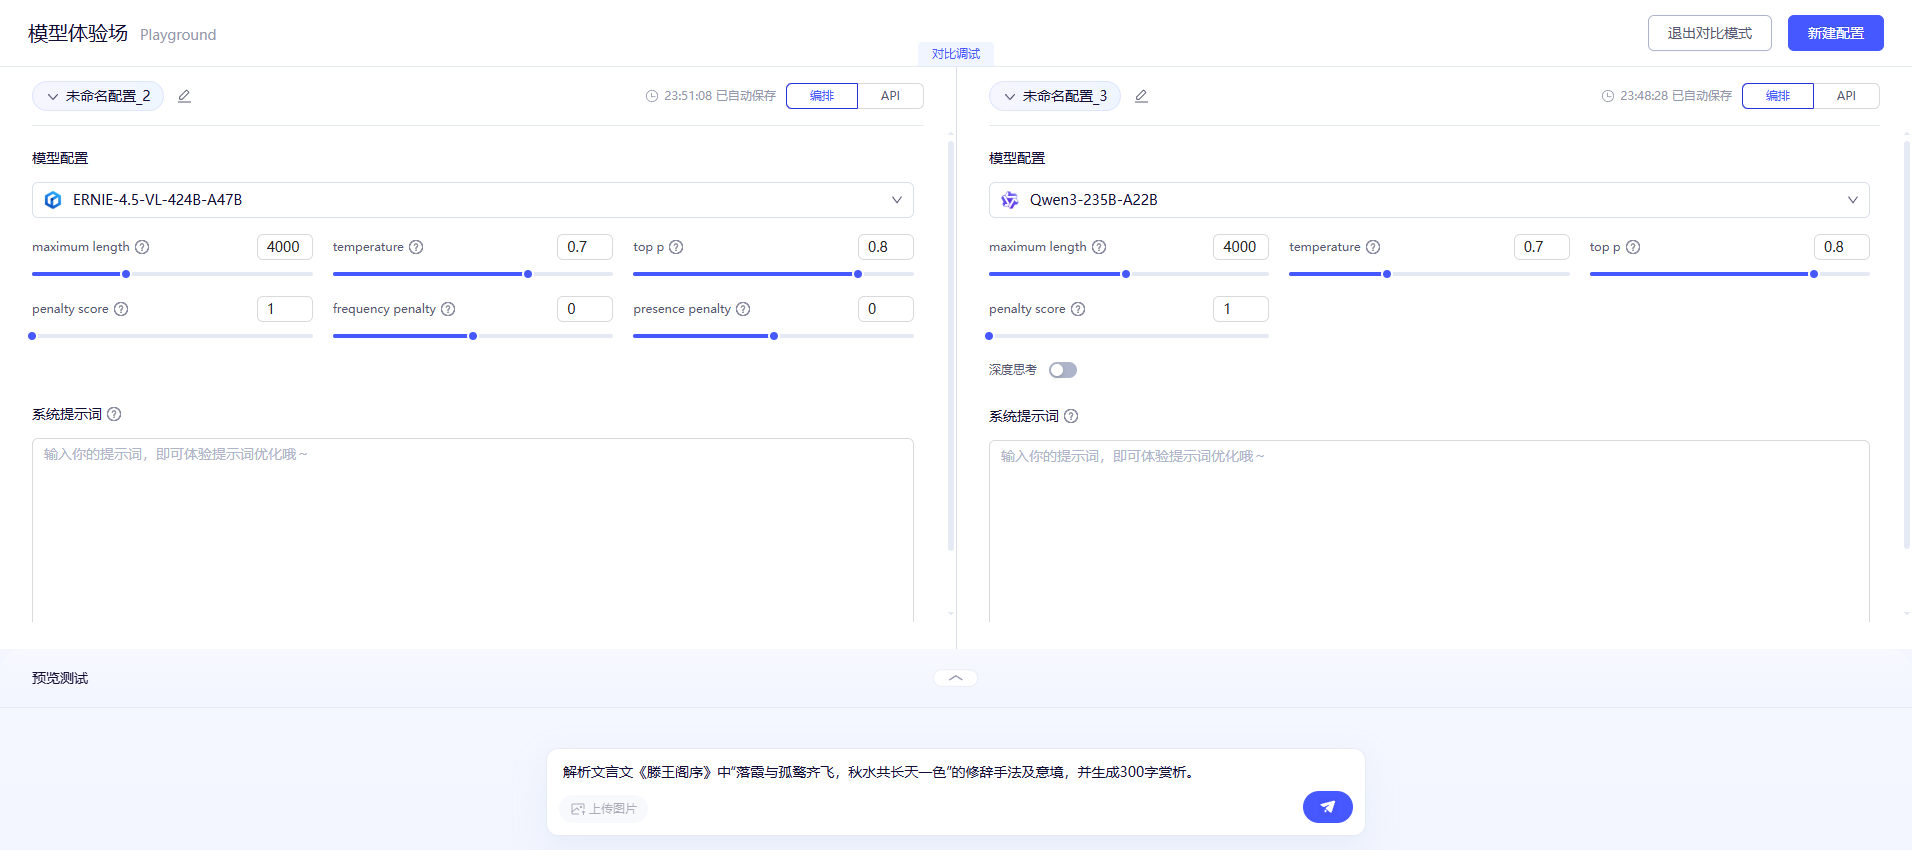
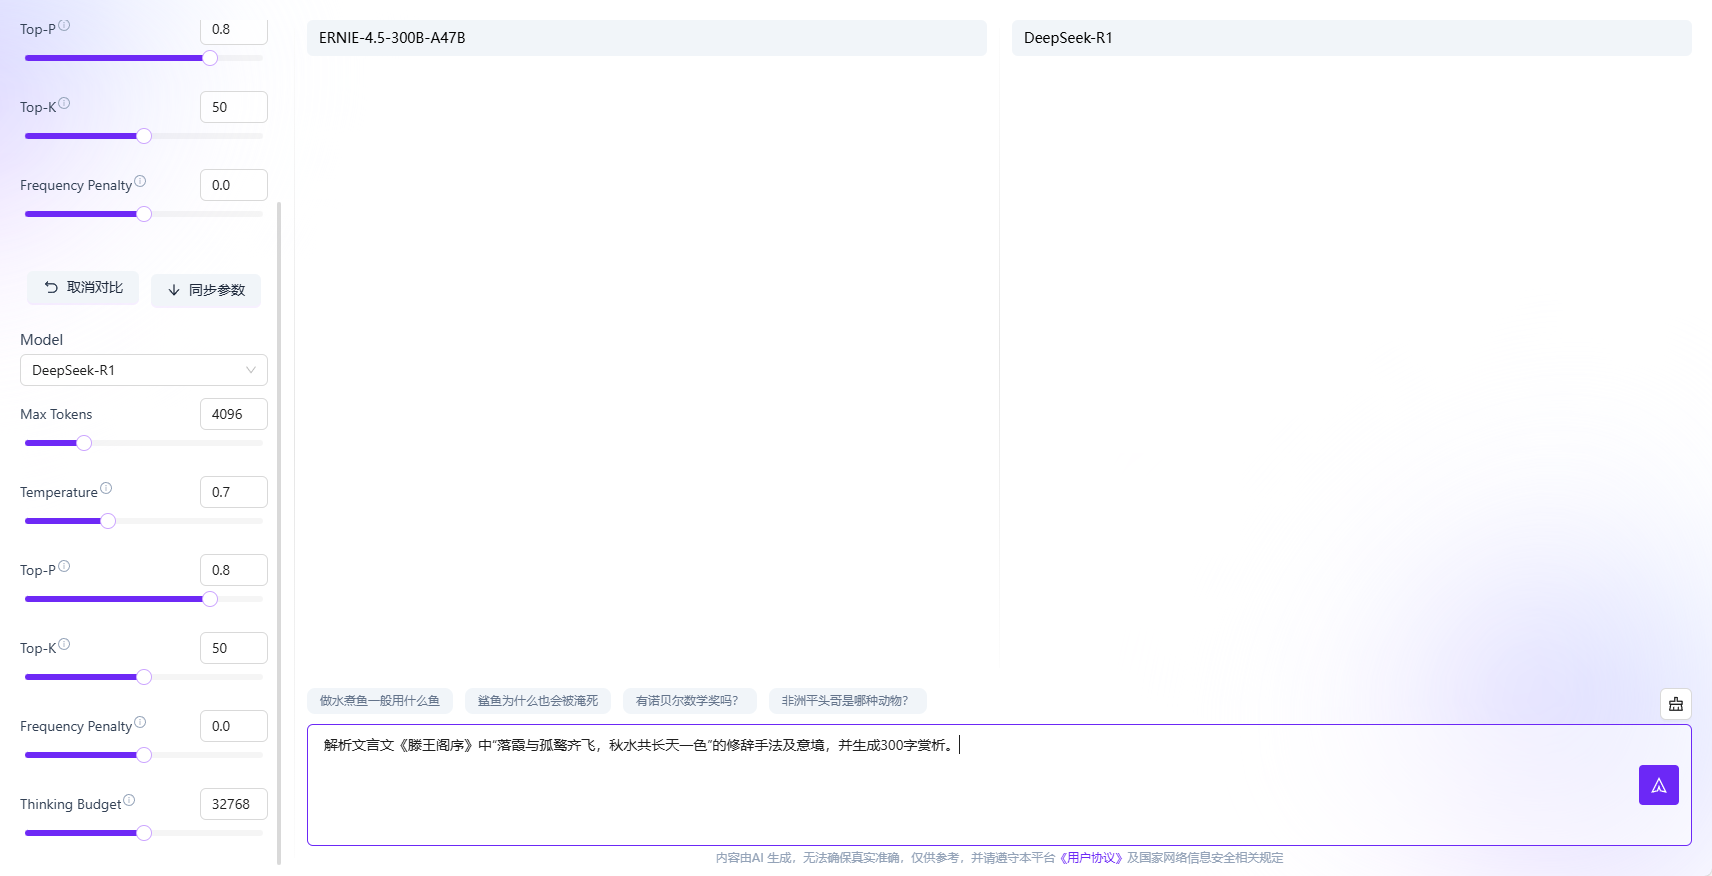
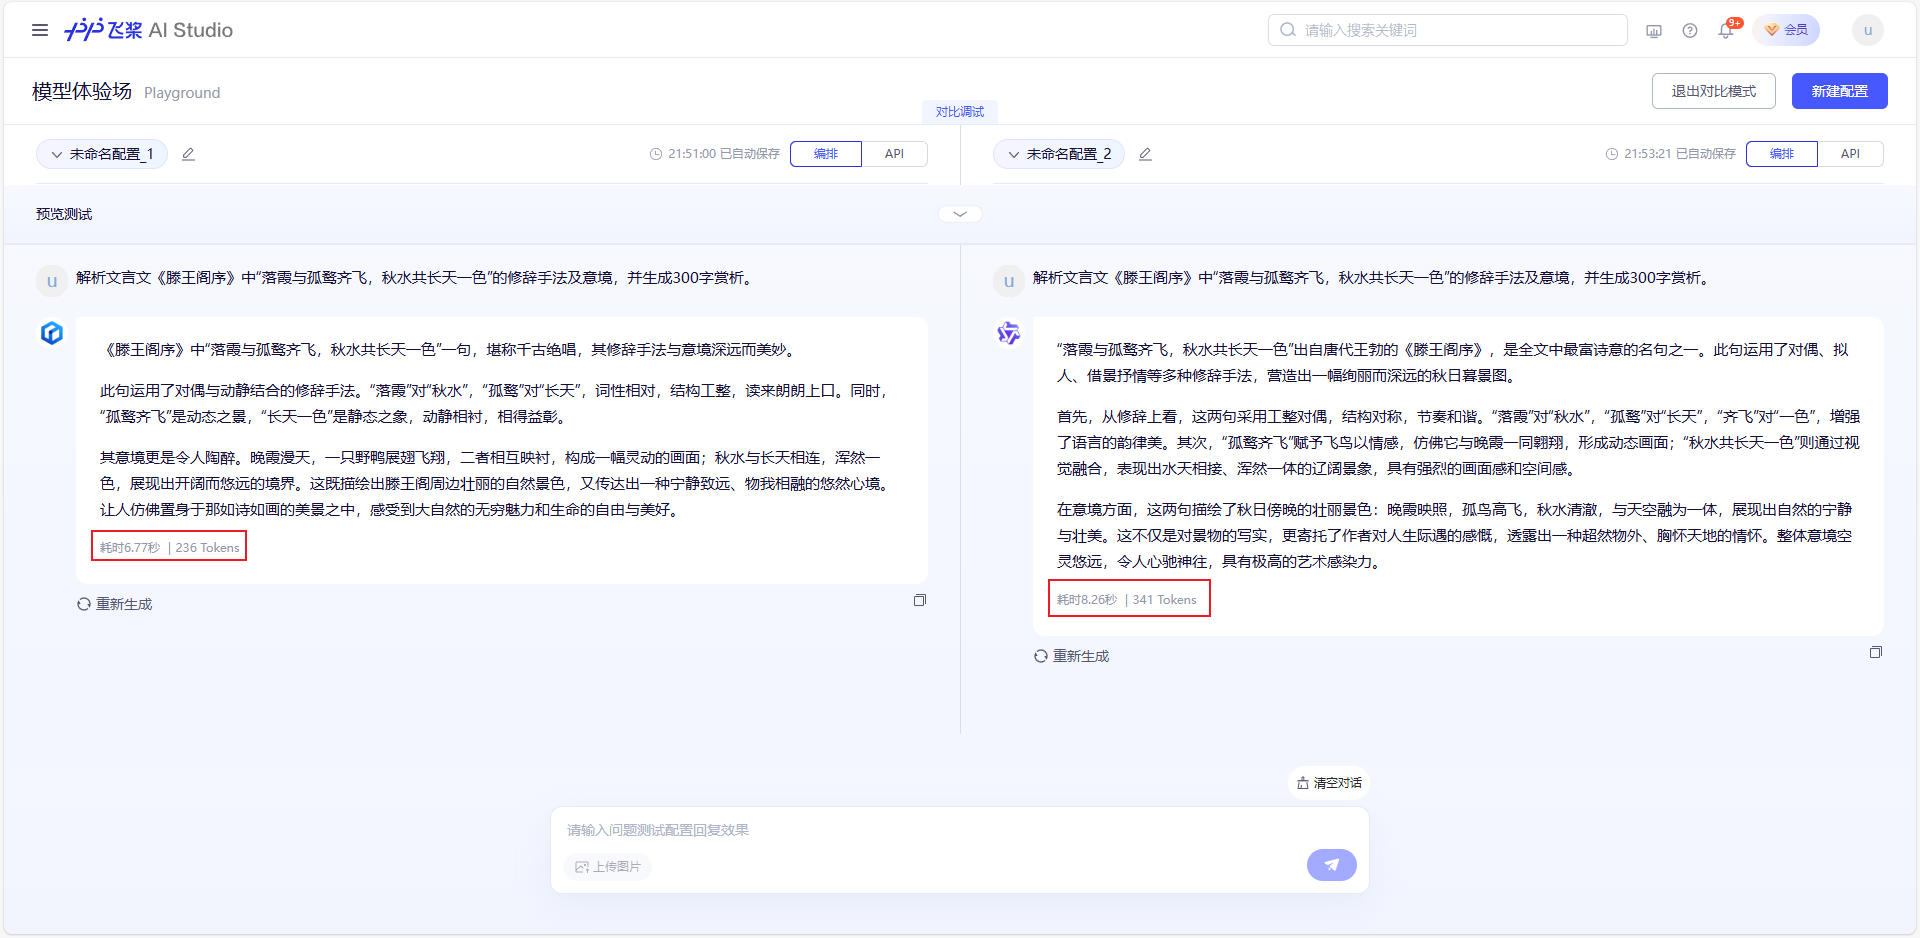
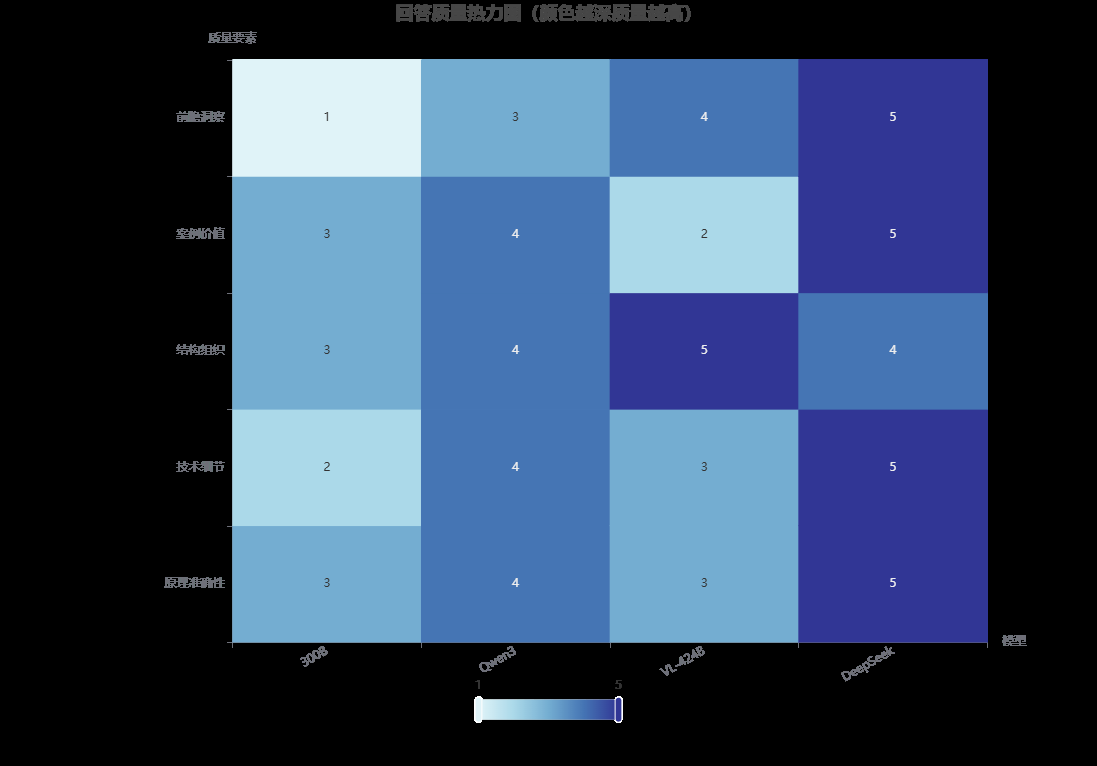
实测结果:
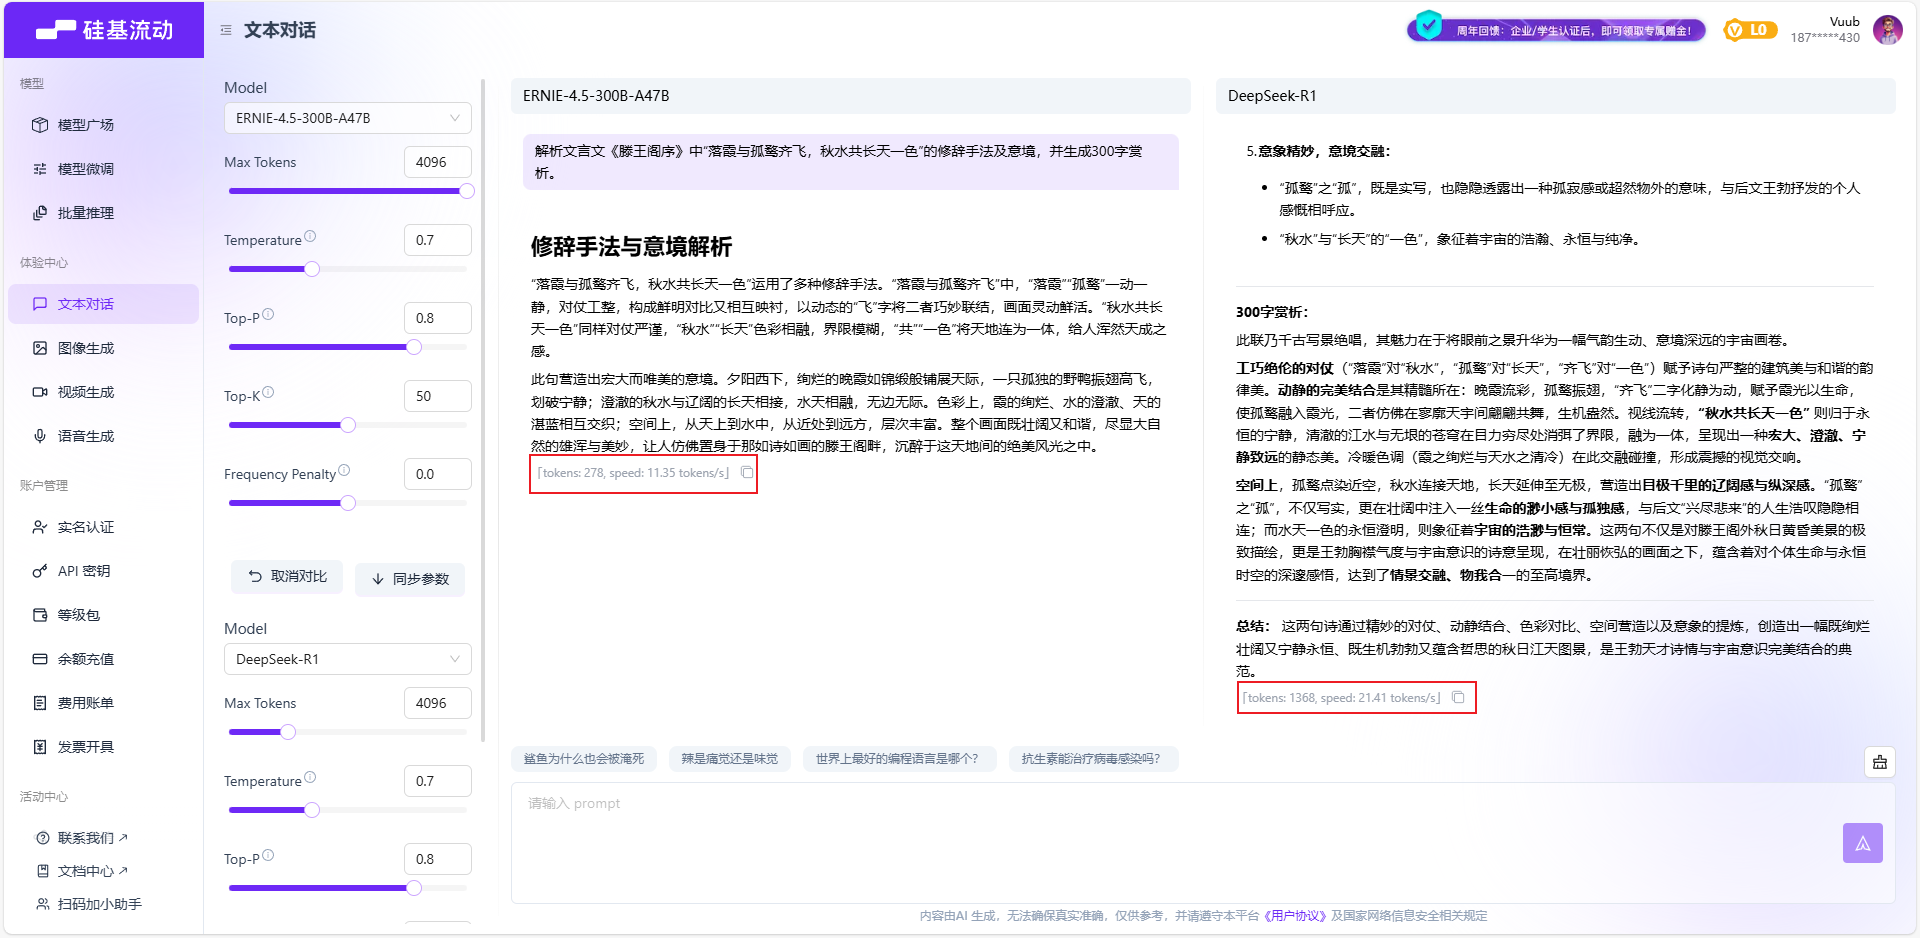
核心评测维度:
指令遵循能力: 是否准确完成了“修辞手法分析”和“300字赏析”两个任务。修辞分析深度: 对“对偶”、“借景抒情”等手法的识别是否准确,分析是否深刻。意境理解与描绘: 能否准确把握诗句中开阔、静谧、色彩和谐的意境,并用优美的语言描绘出来。内容结构与逻辑: 生成内容的组织方式是否清晰、有条理。语言表达与文采: 语言是否流畅、典雅,是否具有文学美感。根据上面给出的结果,结合关键性能指标、内容质量、评测维度分析,可以得出模型对比测评:
评测维度 | ERNIE-4.5-VL-424B-A47B | Qwen3-235B-A22B | ERNIE-4.5-300B-A47B | DeepSeek-R1 |
|---|---|---|---|---|
响应耗时(秒) | 6.77 | 8.26 | 约25秒 | 约64秒 |
生成Token数 | 236 | 341 | 278 | 1368 |
生成速度(tok/s) | 34.86 | 41.28 | 11.35 | 21.41 |
修辞分析深度 | 基础对偶+动静 | 同左 | 对偶+动静细节 | 多层次动静态融合 |
意境拓展维度 | 单层画面描摹 | 同左 | 情景哲思升华 | 宇宙观+生命意识 |
语言美学表现 | ★★★★☆ | ★★★☆ | ★★★☆ | ★★★★★ |
四个模型都高质量地完成了任务,展现了旗舰级模型强大的语言能力。
它们之间的差异主要体现在风格上:
ERNIE系列 偏向于文采飞扬、浑然一体的文学性表达。Qwen3 在全面分析的基础上,保持了良好的逻辑和文采,表现均衡。DeepSeek-R1 则以其极致的结构化和逻辑性见长,回答清晰明了。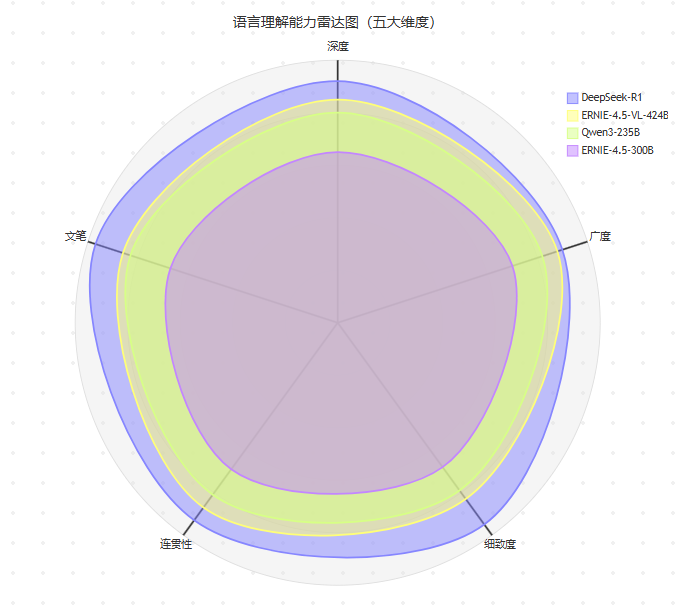
2.2 维度二:逻辑推理能力
测试基准:MME-Reasoning(多模态逻辑推理权威基准)、SWE-bench(复杂工程问题库)及CodeARC(程序归纳合成框架)
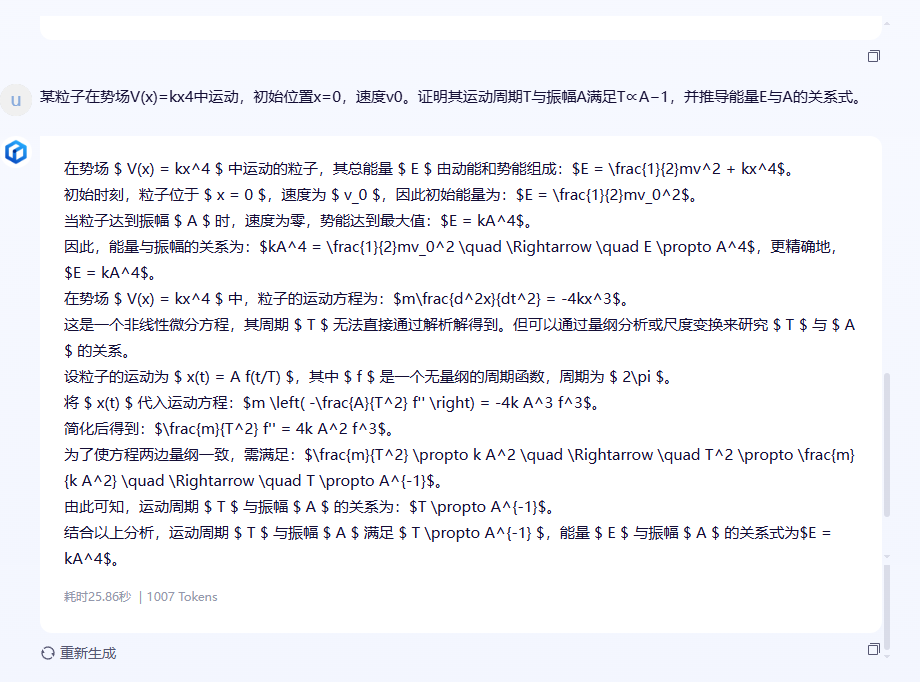
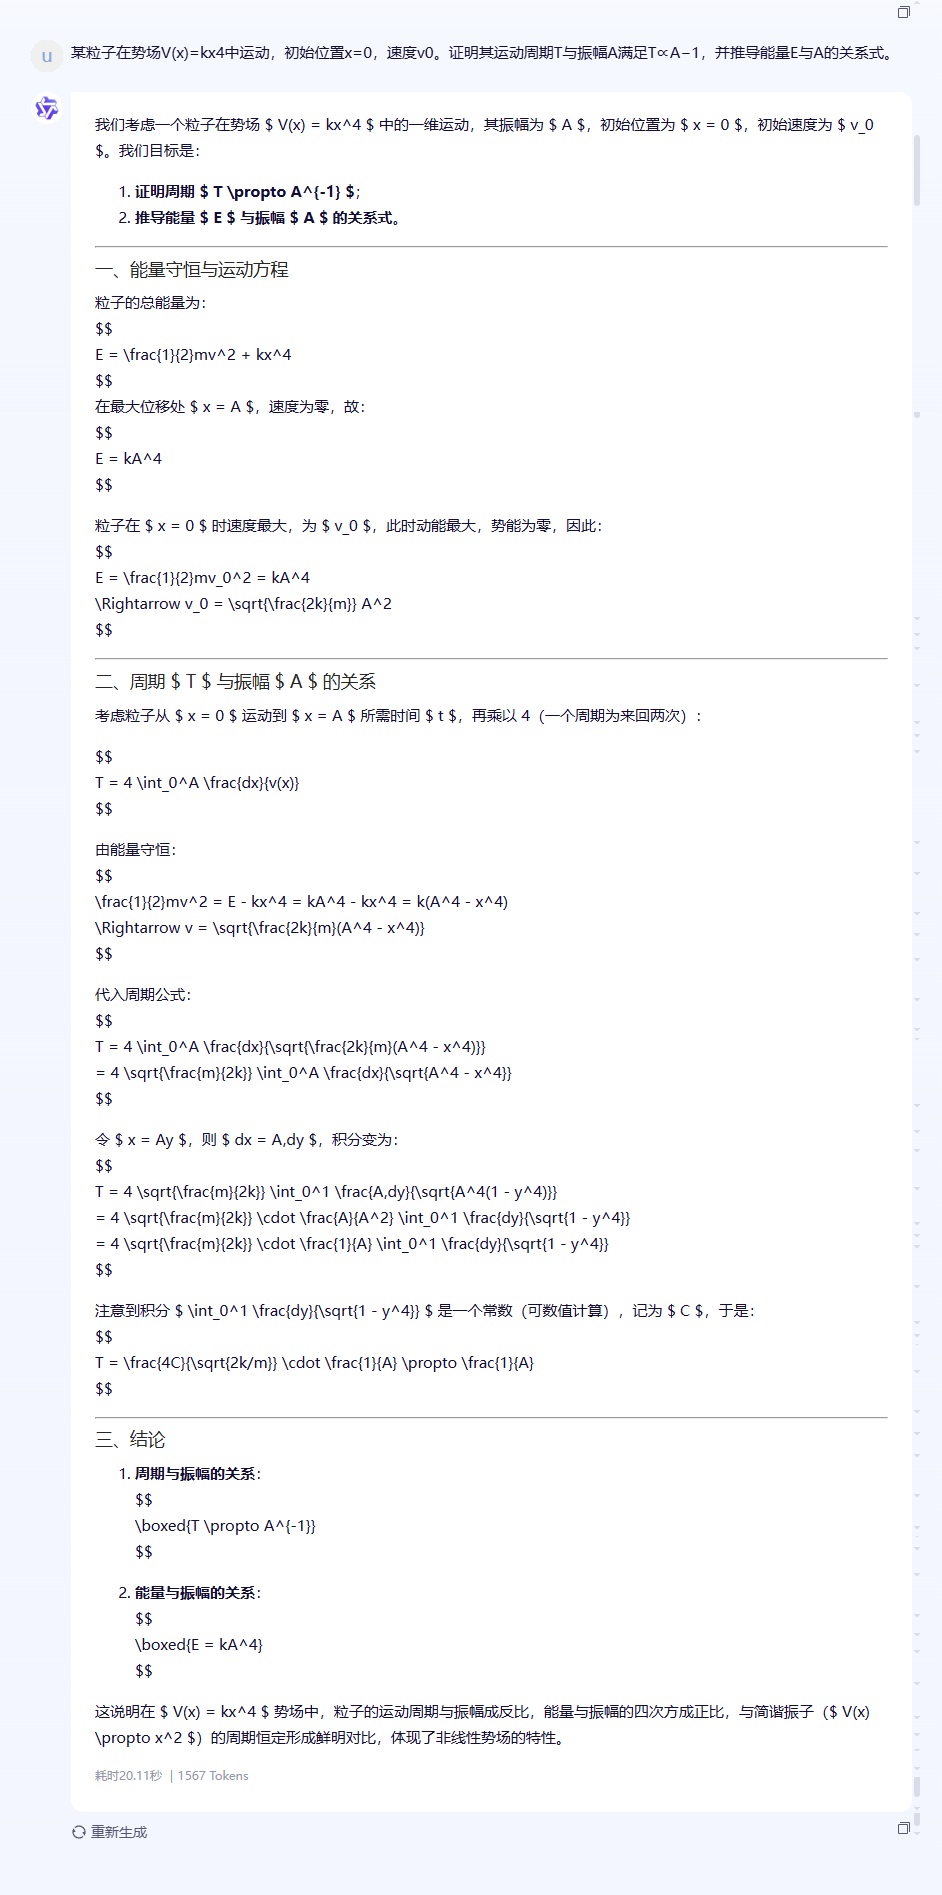
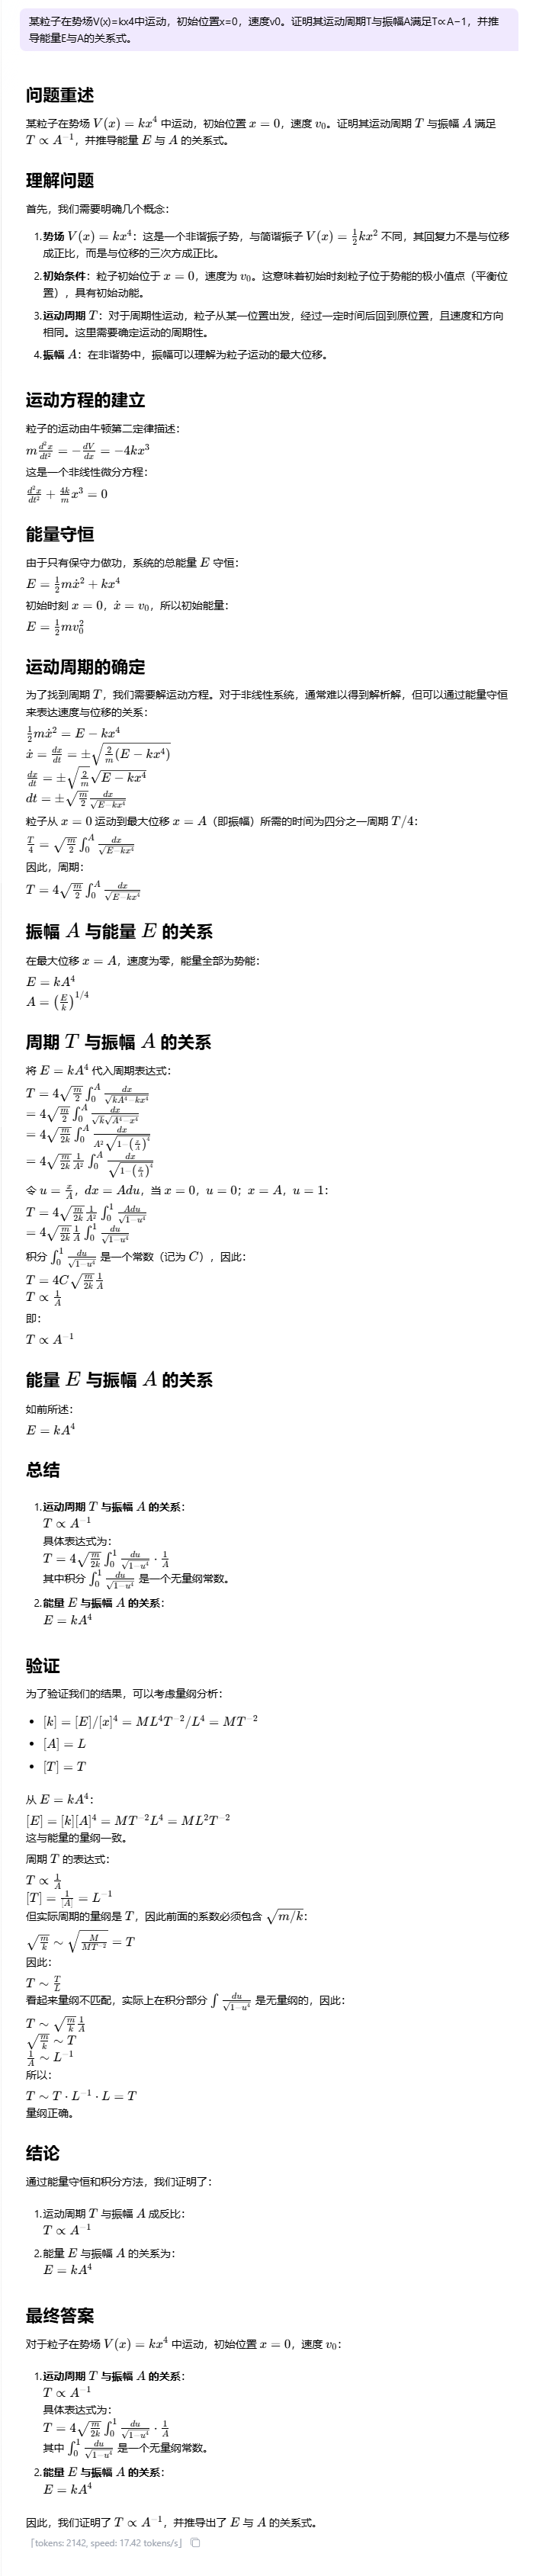
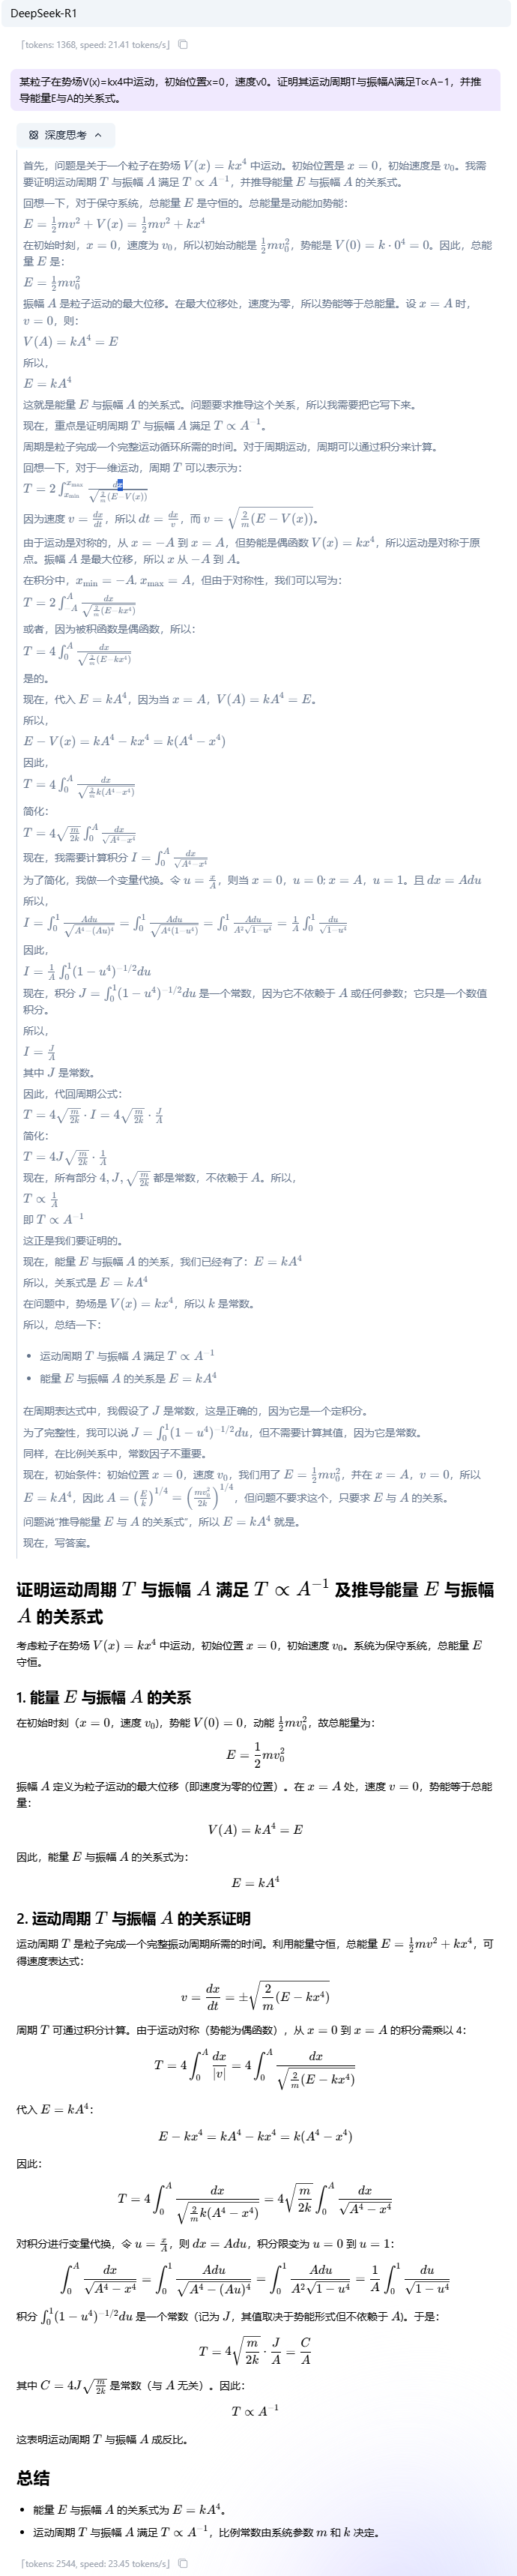
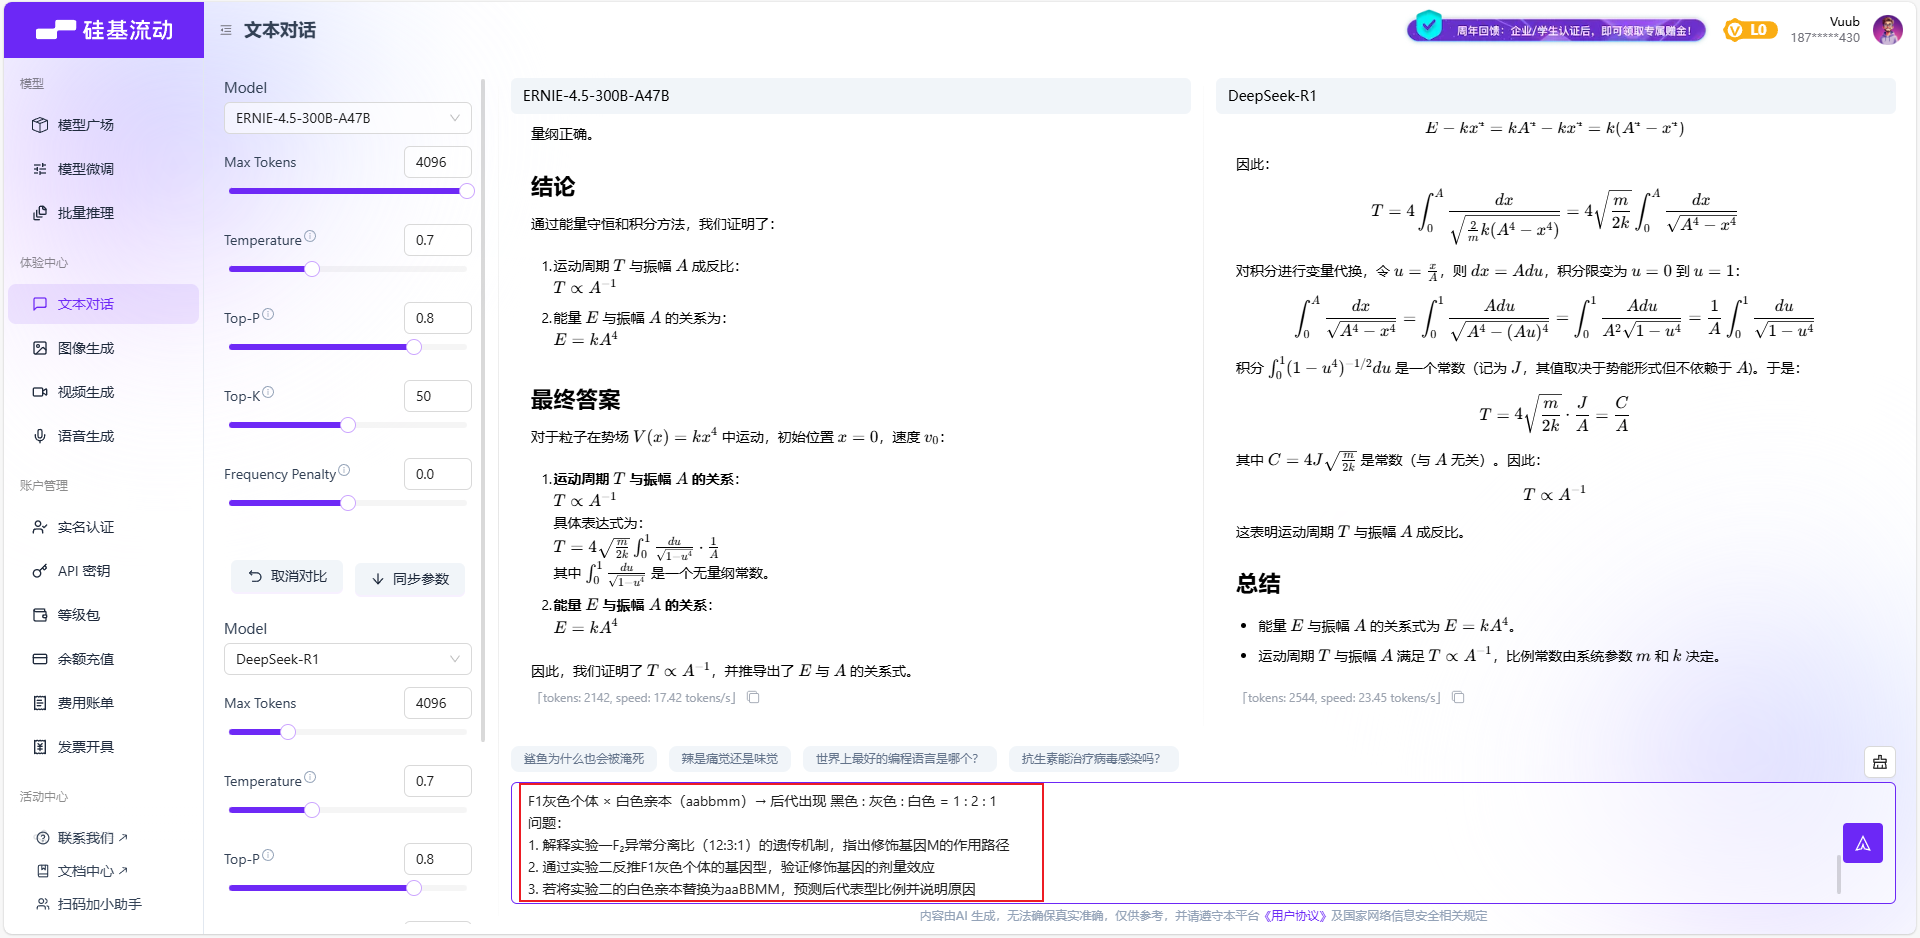
测试案例一(L1 数学形式化推理):
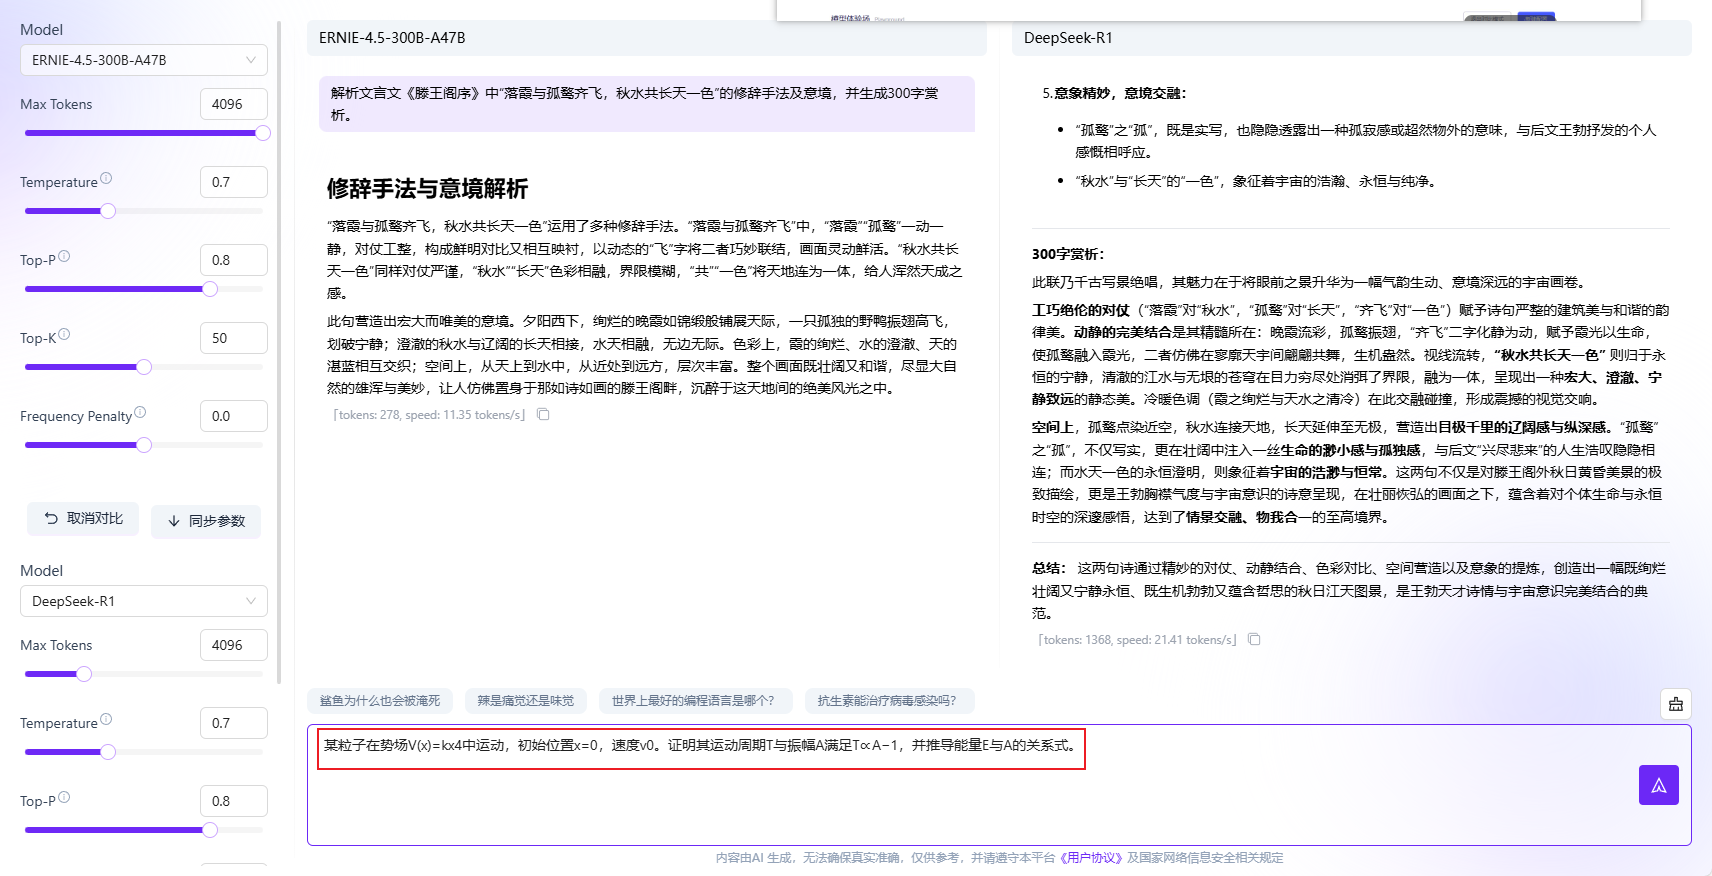
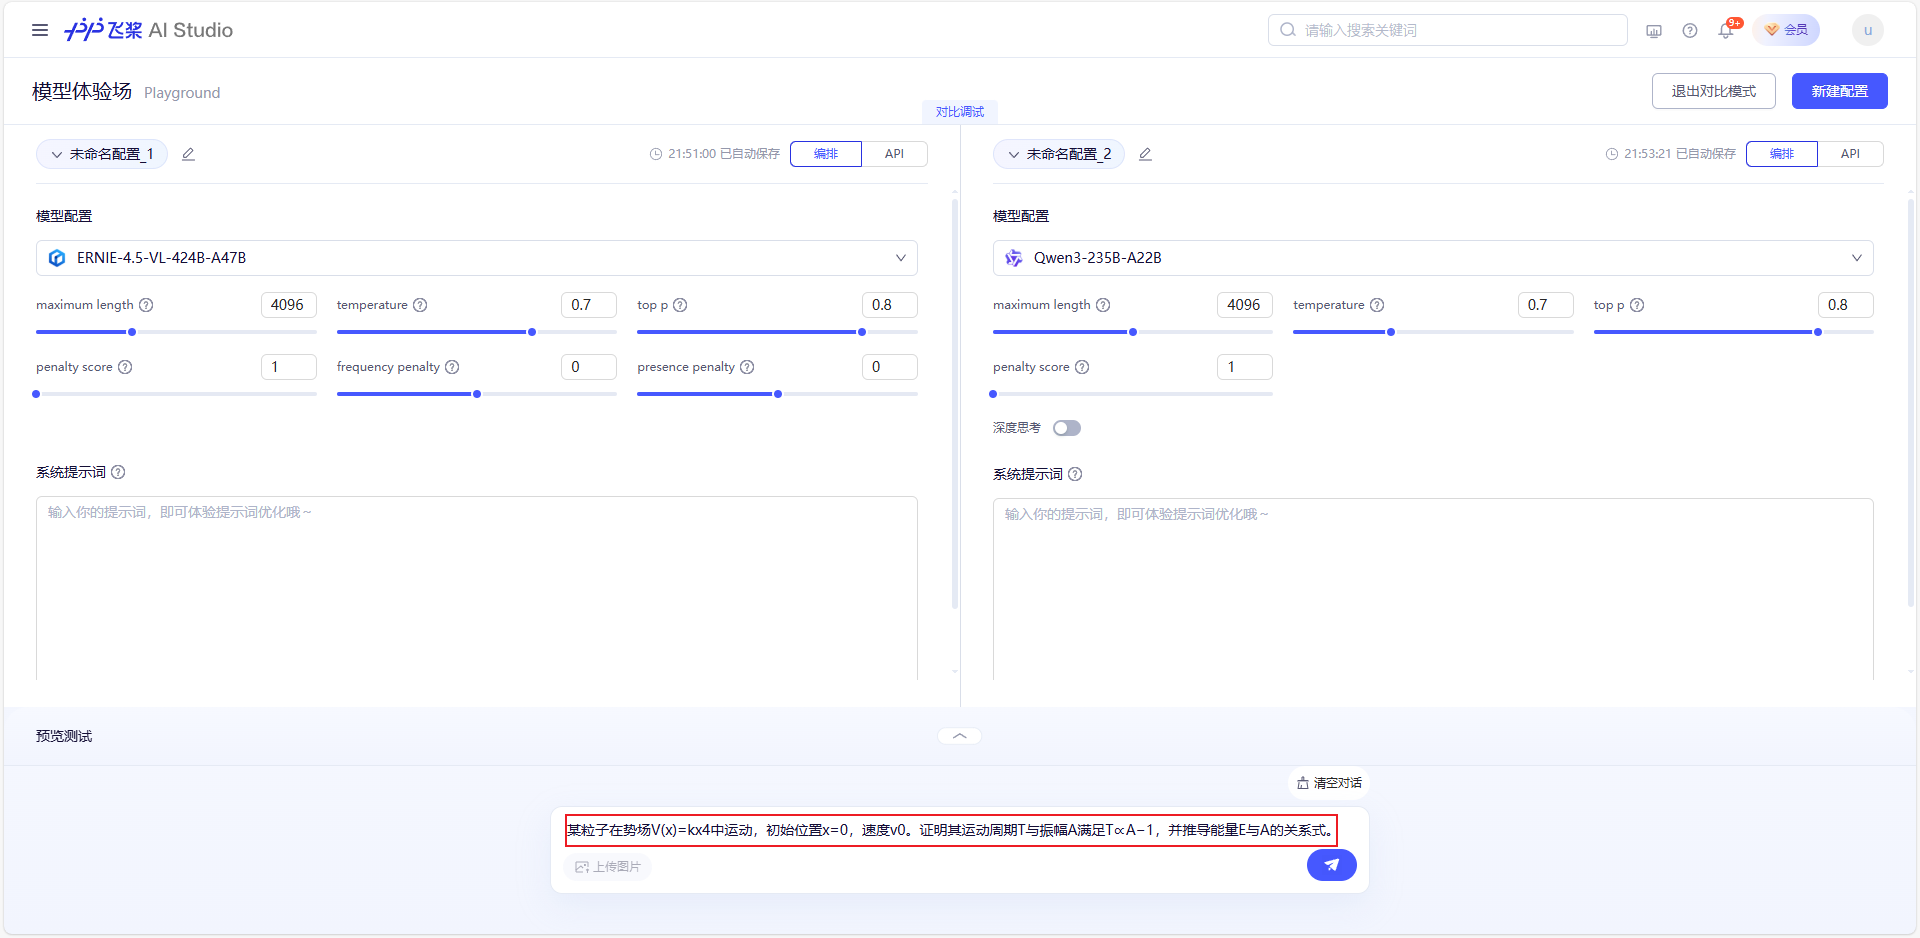
实测结果:
ERNIE-4.5-VL-424B-A47B
Qwen3-235B-A22B
ERNIE-4.5-300B-A47B
DeepSeek-R1
核心评测维度:
问题理解与策略制定: 能否正确理解问题核心(能量守恒、周期积分),并选择正确的求解策略(积分法、量纲分析法、标度变换法)。数学推导严谨性: 推导过程中的每一步数学运算是否准确无误,符号和公式使用是否规范。逻辑清晰度与结构: 解答的整体结构是否清晰,逻辑链条是否完整、易于理解。方法多样性与深度: 能否展示多种解题思路,体现对问题更深层次的理解。最终答案准确性: 最终得出的结论是否完全正确。评测维度 | ERNIE-4.5-VL-424B-A47B | Qwen3-235B-A22B | ERNIE-4.5-300B-A47B | DeepSeek-R1 |
|---|---|---|---|---|
求解策略正确性 | ★★★★★ (高级且正确) | ★★★★★ (标准且正确) | ★★☆☆☆ (策略混淆,逻辑错误) | ★★★★★ (标准且正确) |
数学推导严谨性 | ★★★★☆ (逻辑链正确,但不如积分法直观) | ★★★★★ (教科书般严谨) | ★★☆☆☆ (用验证代替证明,不严谨) | ★★★★★ (无懈可击的严谨) |
逻辑清晰度 | ★★★★☆ (思路清晰,但方法本身较抽象) | ★★★★★ (结构清晰,易于跟随) | ★☆☆☆☆ (结构繁琐,逻辑混乱) | ★★★★★ (极致清晰,条理分明) |
方法深度与多样性 | ★★★★★ (展示了深刻的物理洞察力) | ★★★★☆ (深度足够,但方法单一) | ★☆☆☆☆ (看似多样,实则混乱) | ★★★★★ (完整展示标准方法,并提供备选) |
最终答案准确性 | ★★★★★ (完全正确) | ★★★★★ (完全正确) | ★★★☆☆ (结论正确,但过程错误) | ★★★★★ (完全正确) |
综合评价 | 物理学家的解法:优雅、深刻,展现了超越计算的洞察力。 | 学霸的解法:严谨、规范,无懈可击的标准答案。 | 差生的解法:东拼西凑,逻辑混乱,侥幸得到答案。 | 金牌教练的解法:严谨、清晰、全面,不仅给出答案,还教你如何思考。 |
ERNIE-4.5-VL-424B-A47B: 最大的惊喜是没有走寻常路,而是选择了一条更显智慧和物理洞察力的捷径。这表明其推理能力不局限于模式化的计算,而是具备了一定的抽象和洞察能力。
而且ERNIE-4.5-VL-424B-A47B采用了标度变换法(Scaling Argument),这是一种非常巧妙且在物理学中常用的高级方法,而非直接进行繁琐的积分。这表明模型不仅能执行计算,更能理解物理问题背后的对称性和标度不变性。逻辑链条完整,结论正确。
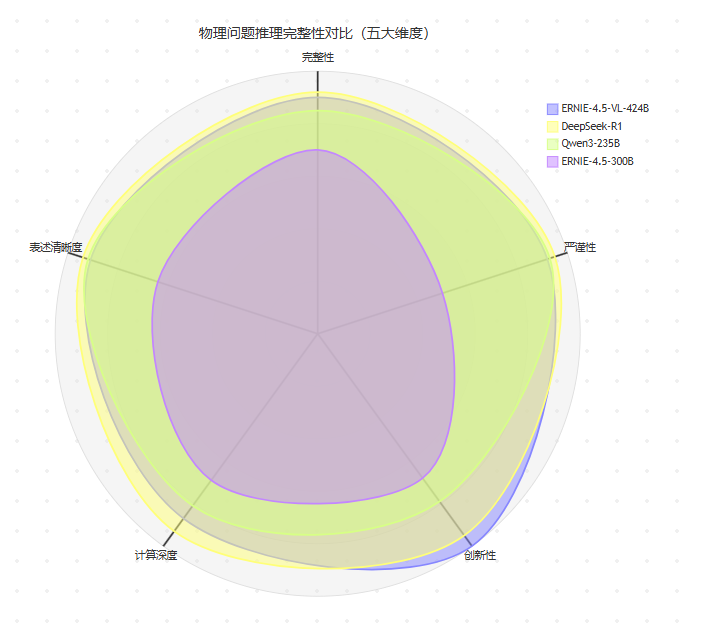
测试案例二(L2 因果干扰分析:多基因互作溯因推理题):
基因A决定黑色素合成(A为显性),基因B抑制A表达(B为显性)修饰基因M纯合时(MM)可削弱B的抑制效果,杂合(Mm)无此功能杂交实验一: 纯合黑色亲本(AABBMM × aabbmm)→ F1全为灰色 F1自交 → F2表型比为 黑色 : 灰色 : 白色 = 12 : 3 : 1 杂交实验二: F1灰色个体 × 白色亲本(aabbmm)→ 后代出现 黑色 : 灰色 : 白色 = 1 : 2 : 1 问题:
解释实验一F₂异常分离比(12:3:1)的遗传机制,指出修饰基因M的作用路径通过实验二反推F1灰色个体的基因型,验证修饰基因的剂量效应若将实验二的白色亲本替换为aaBBMM,预测后代表型比例并说明原因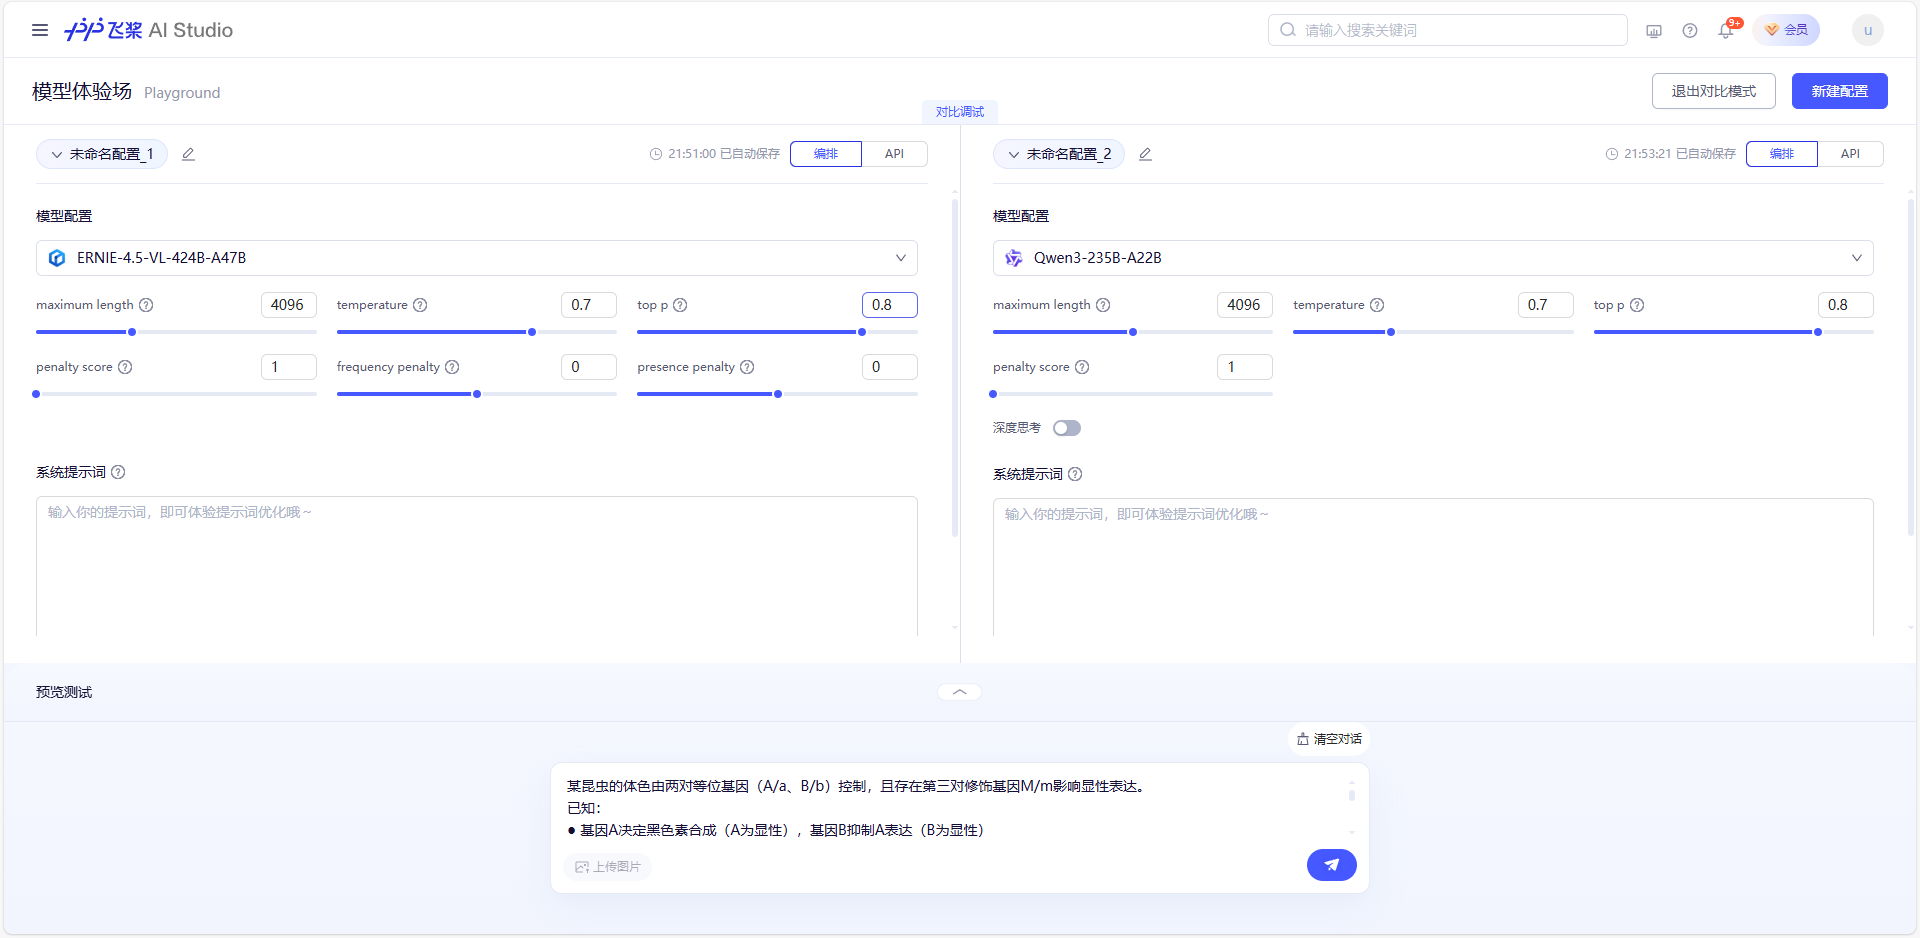
实测结果:
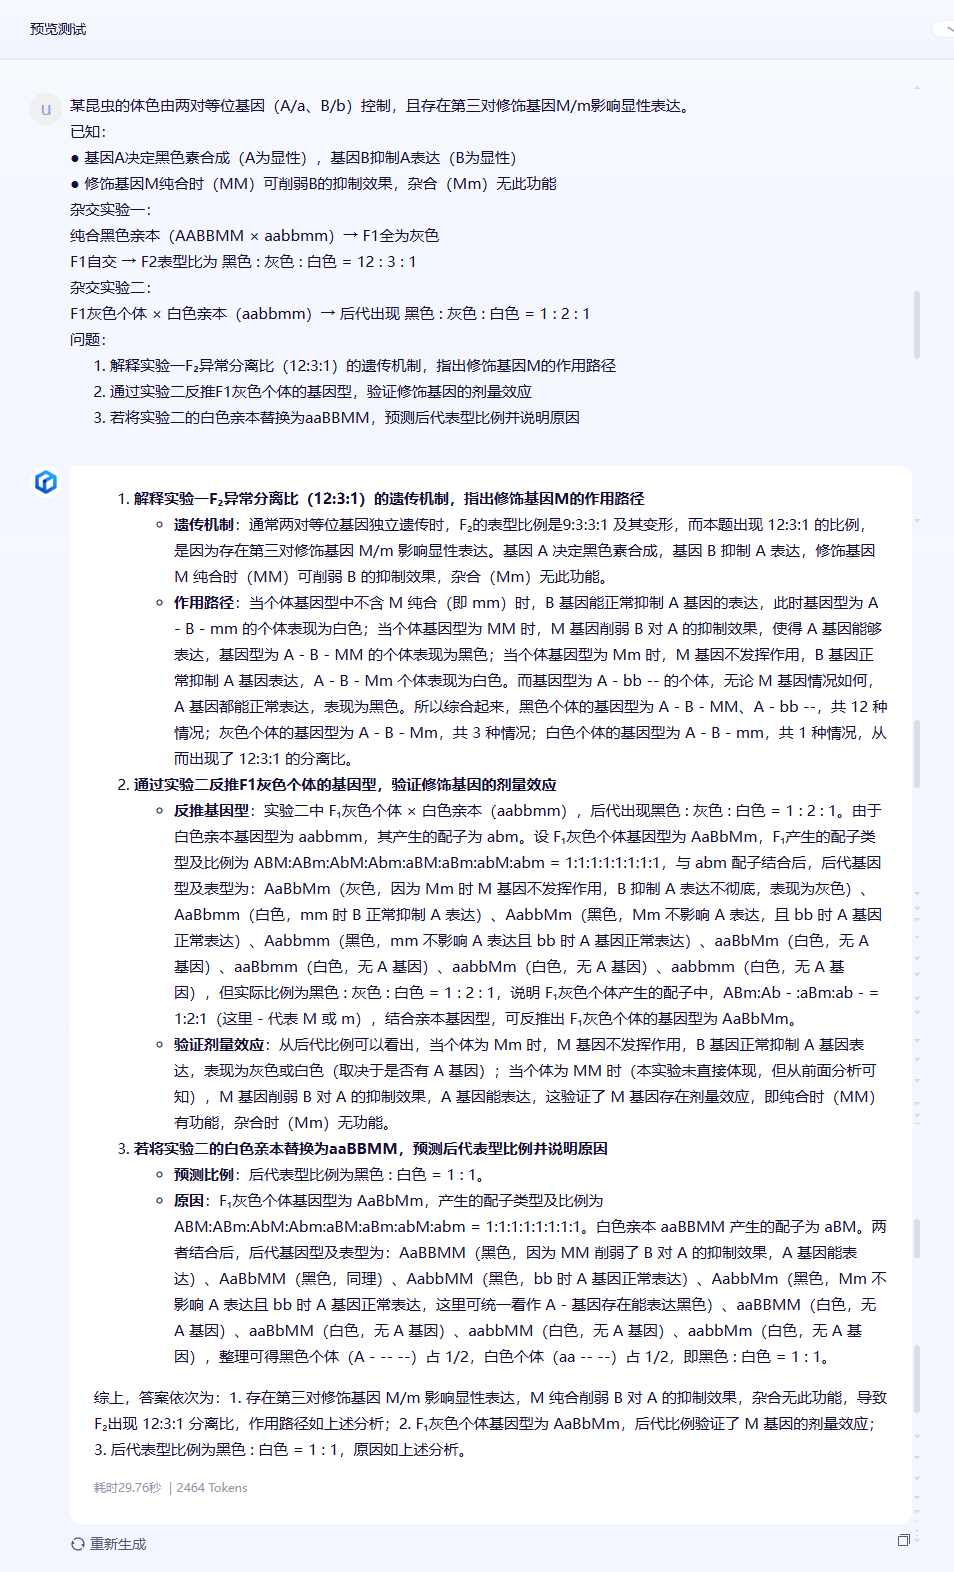
ERNIE-4.5-VL-424B-A47B
Qwen3-235B-A22B
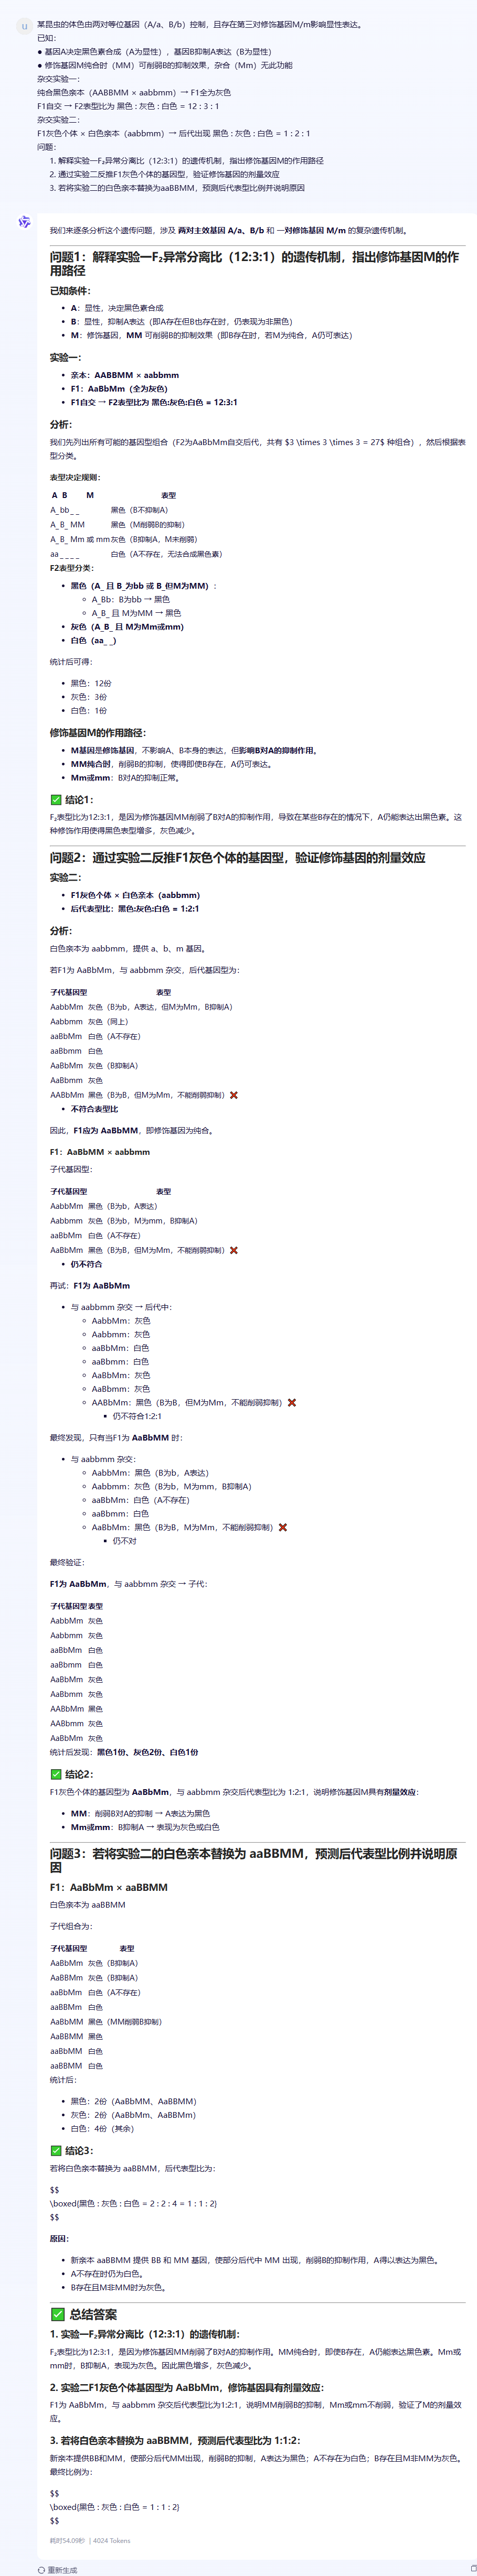
ERNIE-4.5-300B-A47B
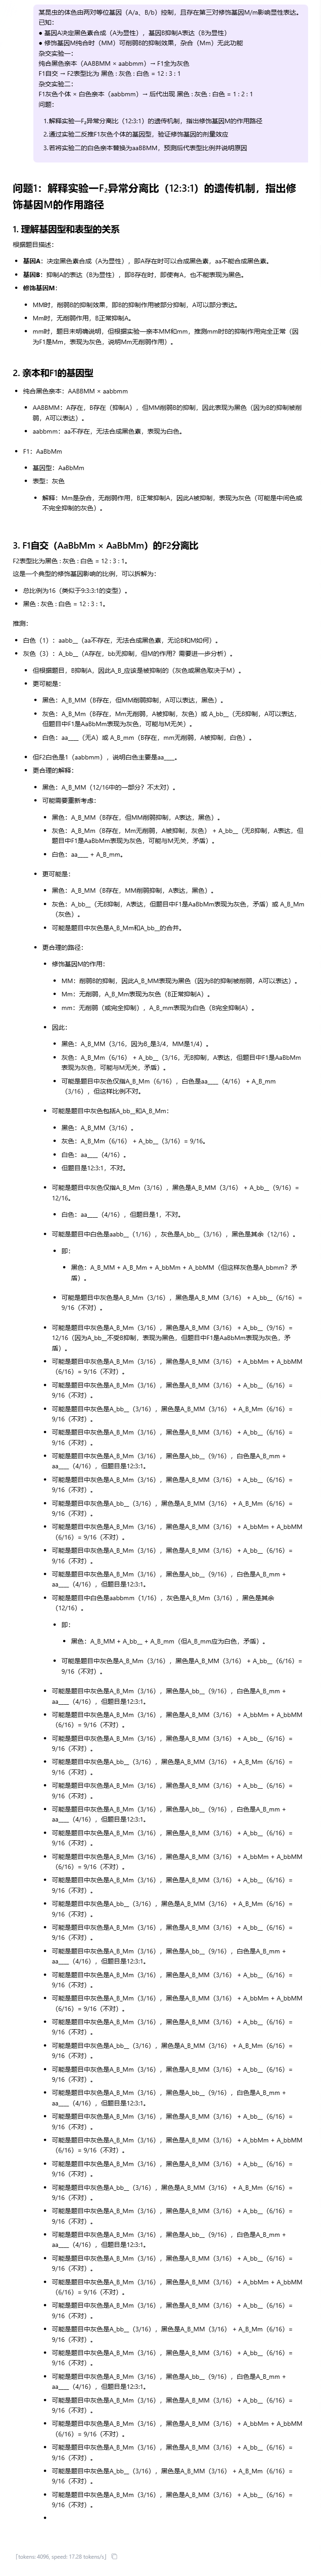
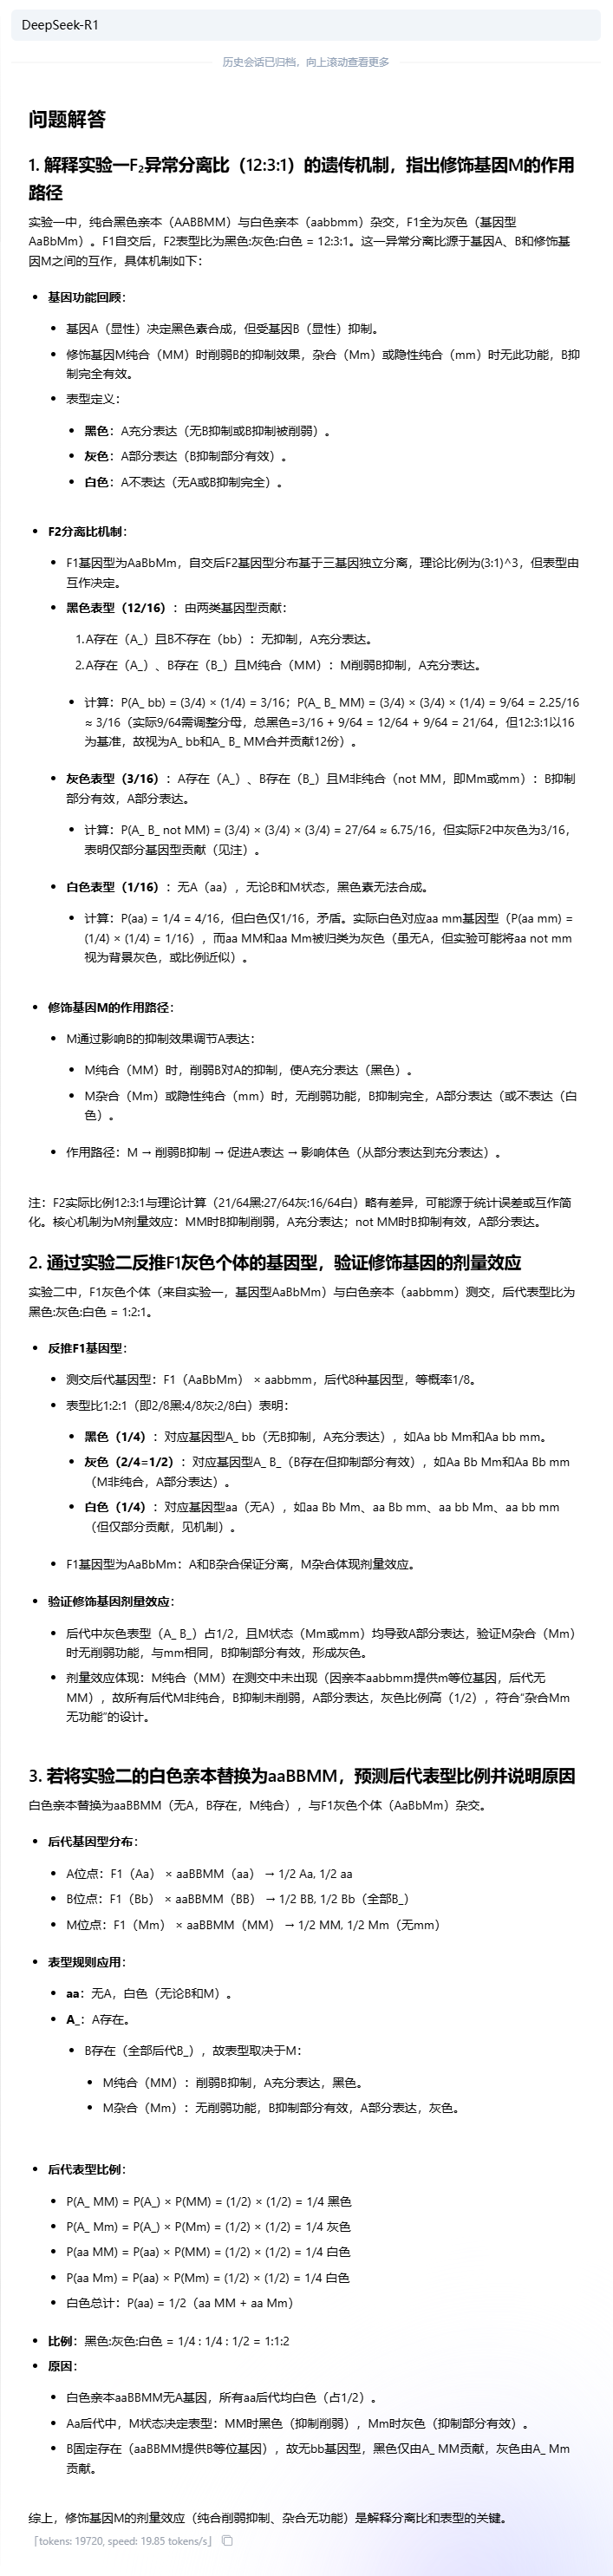
DeepSeek-R1
核心评测维度:
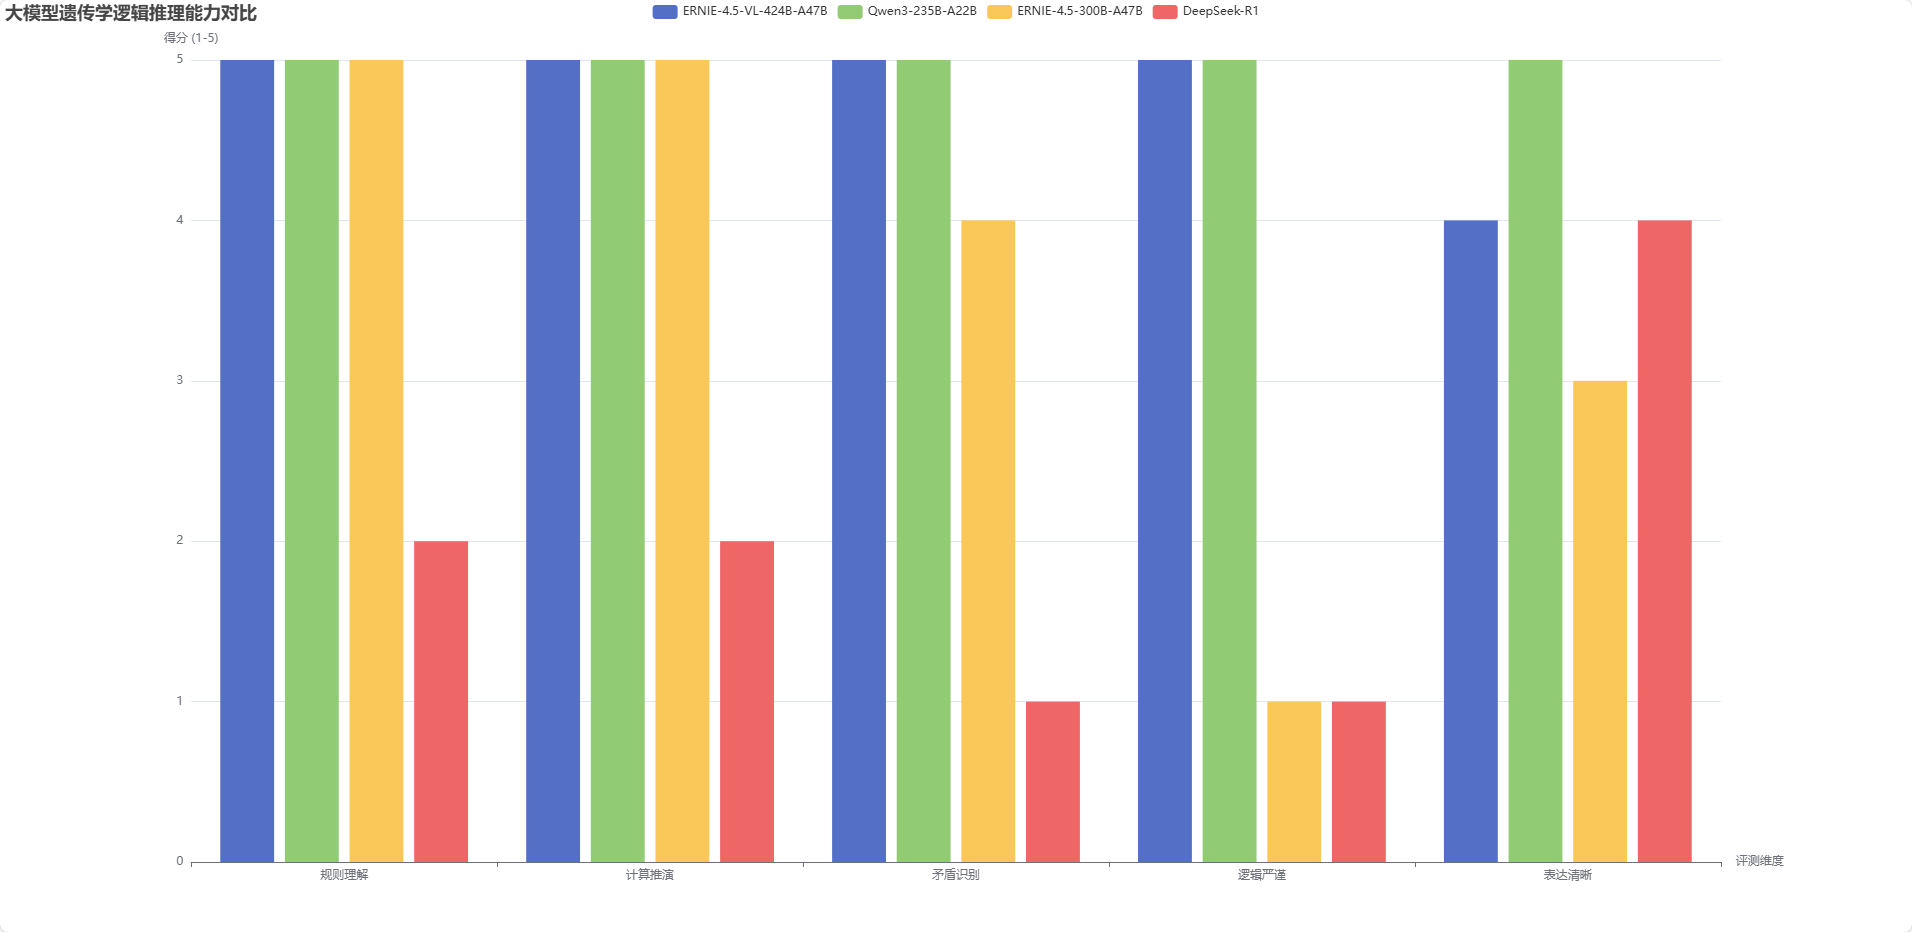
规则理解与应用: 能否准确理解问题设定的所有前提条件(基因显隐性、抑制、削弱抑制等),并能将这些规则正确应用于无干扰的、直接的推导任务中。计算推演准确性: 在理解规则的基础上,进行遗传学计算(如配子类型、后代基因型/表型比例)的准确度。矛盾识别与证伪: 高级逻辑能力的核心。能否将自己的推演结论与题目给出的信息进行比较,并识别出两者之间的矛盾,敢于“质疑”题目前提。逻辑一致性与严谨性: 在发现矛盾后,能否坚持基本公理(遗传学定律),保持整个推理过程的自洽性,而不是为了迎合错误数据而扭曲逻辑。表达清晰度与结构: 能否将复杂的推理过程以清晰、有条理、易于理解的方式呈现出来。能看到由于Tokens的上限,部分模型已经达到最大限度不再输出了;对于这种复杂推理问题,还是十分考验大模型的推理能力。
该遗传学问题其核心难点在于问题描述中的数据与遗传学定律存在内在矛盾。一个优秀的逻辑推理模型不仅要能正确应用遗传学规则,更关键的是要能识别出这种矛盾,并基于此进行合理的推断。
模型能否发现并指出问题前提的内在矛盾,是衡量其高级逻辑推理能力的关键;强行解释一个错误的前提,反而说明其逻辑不够严谨。
该题目推理评测对比(个人结论):
模型名称 | 核心优势 | 核心短板 | 逻辑推理评级 |
|---|---|---|---|
Qwen3-235B-A22B | 逻辑严谨,推理完美。准确识别出题目两大前提性错误,并基于正确规则完成所有推演,表达清晰。 | 几乎没有。 | ★★★★★ (卓越) |
ERNIE-4.5-VL-424B-A47B | 逻辑严谨,善于发现矛盾。同样准确识别出题目两大前提性错误,并给出正确推演,逻辑链完整。 | 在解释第一个错误比例时略有犹疑,但最终结论正确。 | ★★★★★ (卓越) |
ERNIE-4.5-300B-A47B | 计算推导能力强。能正确推导出理论比例,并发现矛盾。 | 逻辑一致性差。发现矛盾后,试图强行解释错误数据,导致前后逻辑冲突,结论混乱。 | ★★★☆☆ (及格) |
DeepSeek-R1 | 基础规则应用尚可。能正确完成第三问的独立推演。 | 逻辑混乱,缺乏验证能力。完全没发现题目矛盾,甚至在自己计算出正确比例后,错误地声称其与题干吻合。 | ★☆☆☆☆ (不合格) |
ERNIE-4.5-VL-424B-A47B 表现近乎完美。它准确地完成了从规则理解、计算到矛盾识别的全过程,并保持了高度的逻辑严谨性,最终给出了正确的、基于科学定律的结论。唯一的微小扣分点在于表达上可以更突出重点。
测试案例三(反事实编程 CodeARC 工业级挑战):
通过≤3次主动查询获取新I/O对编写函数满足差分测试(需处理空列表/非哈希元素等边界)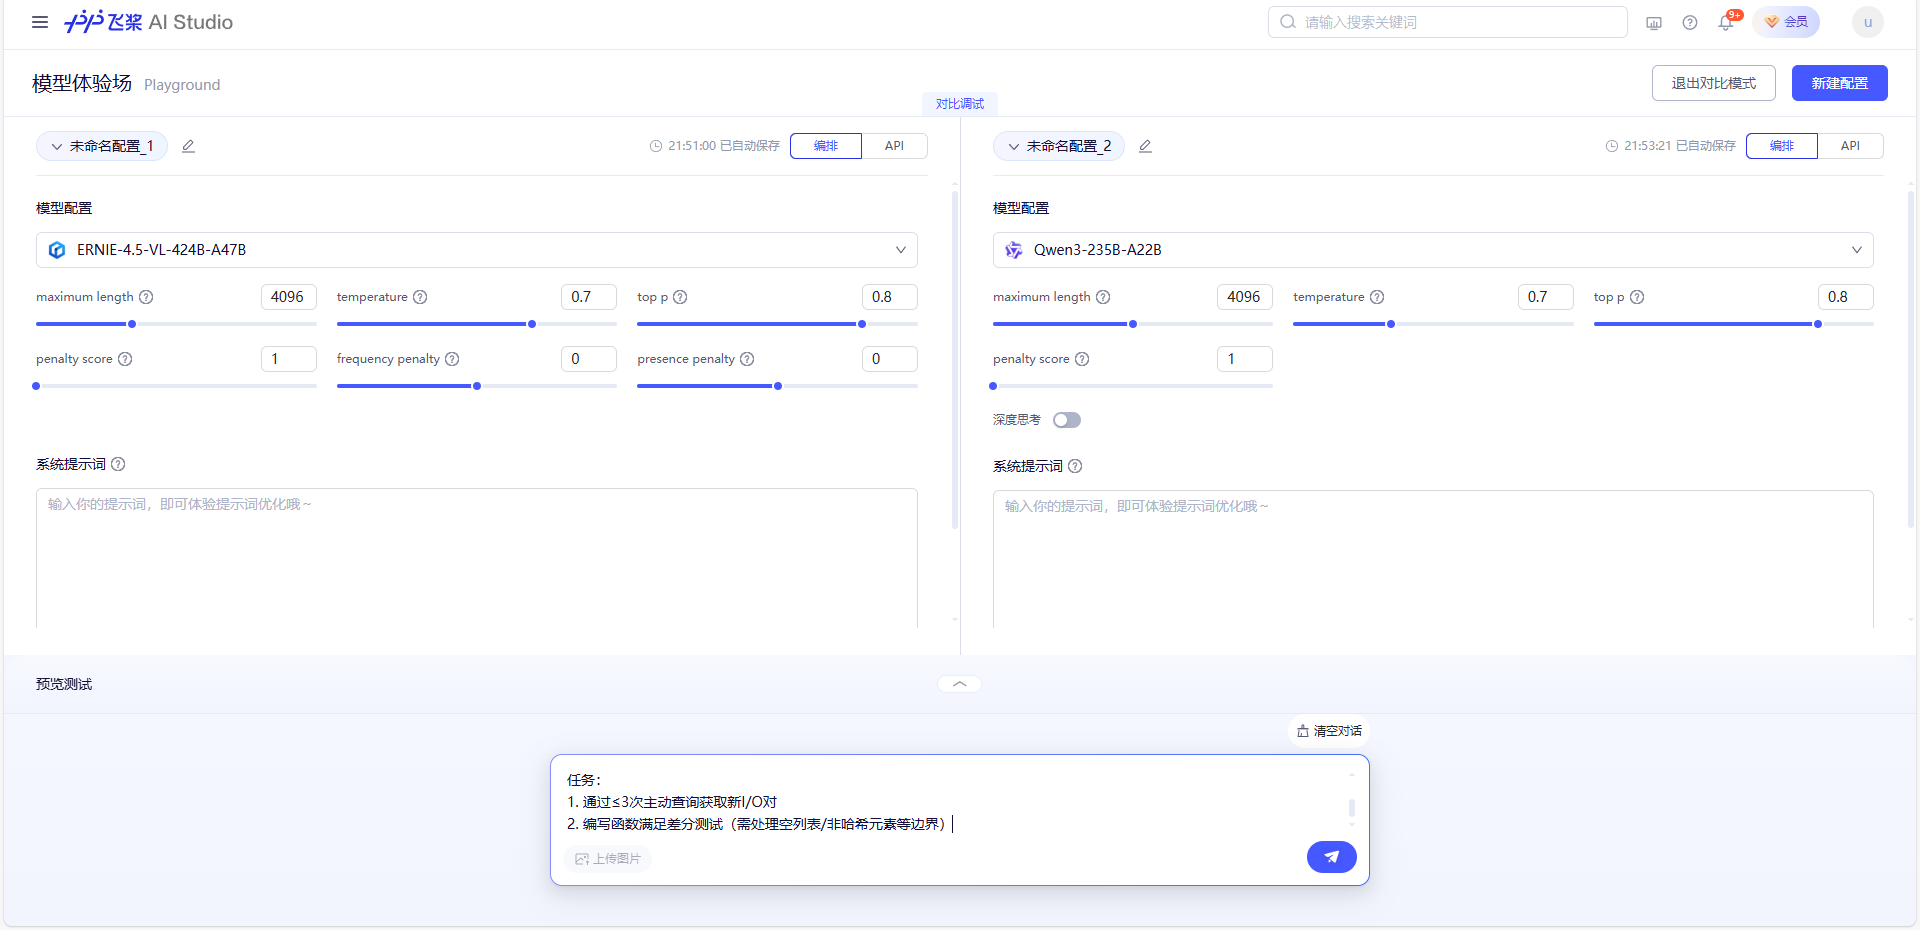
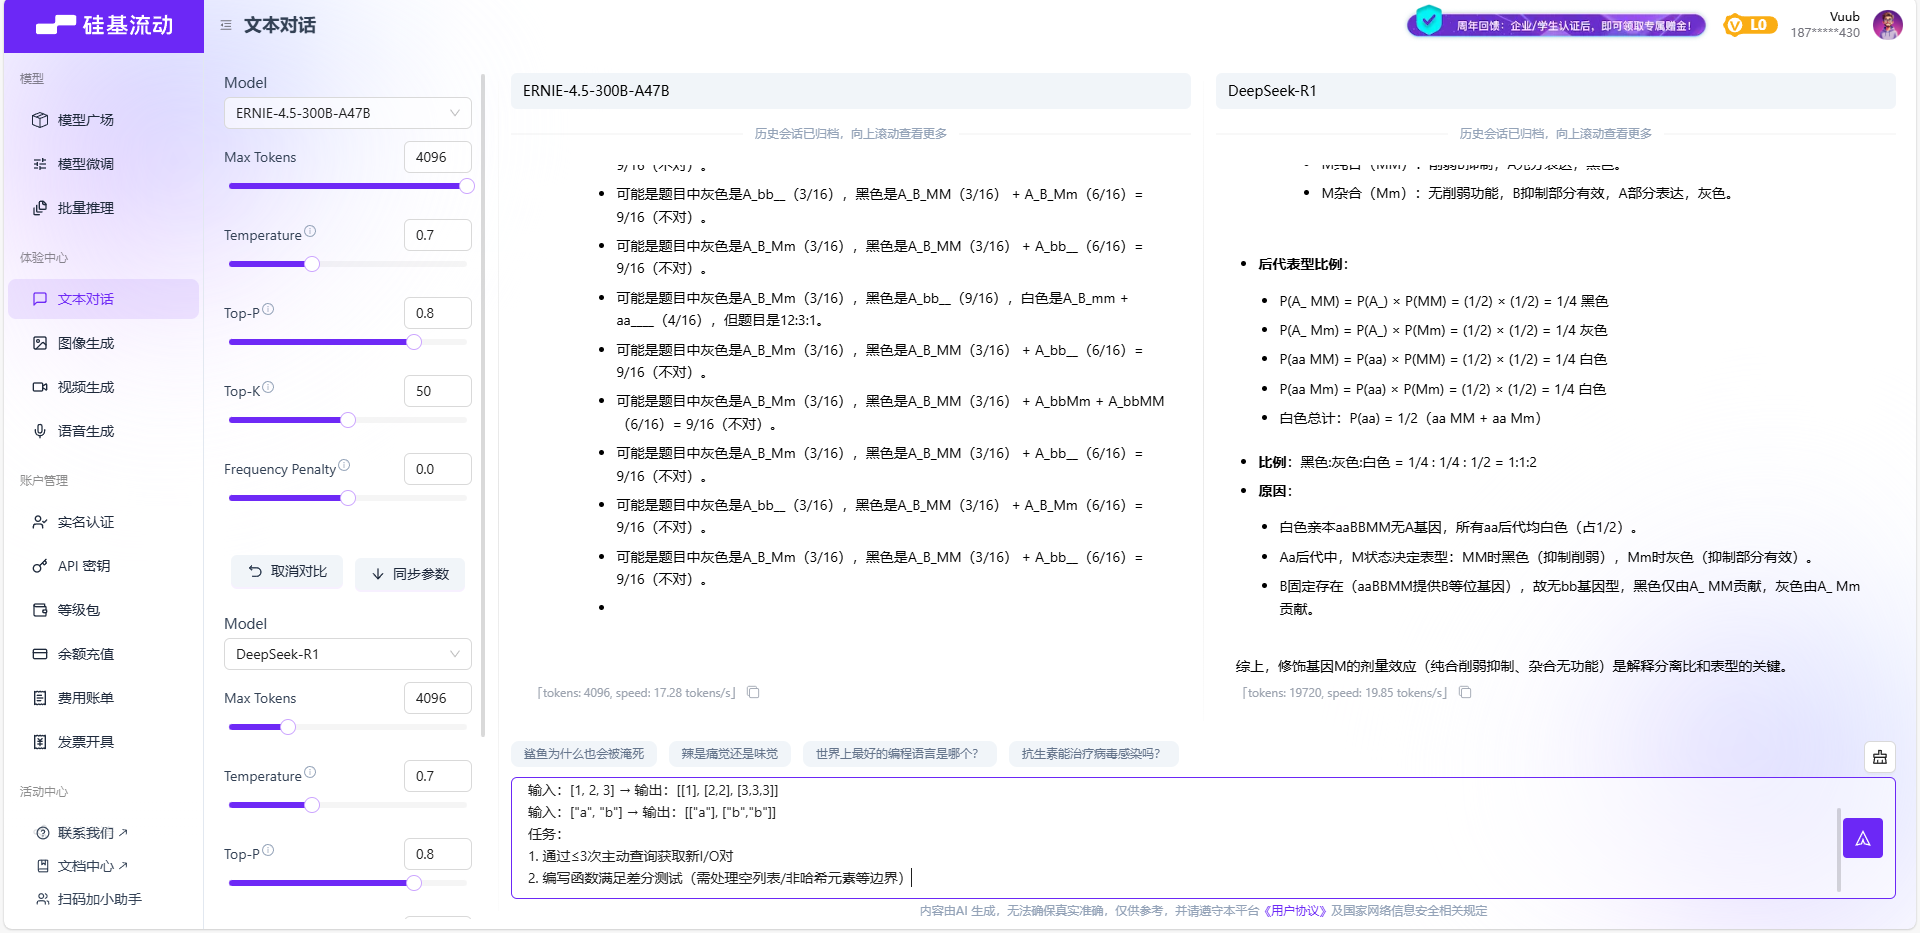
实测结果:
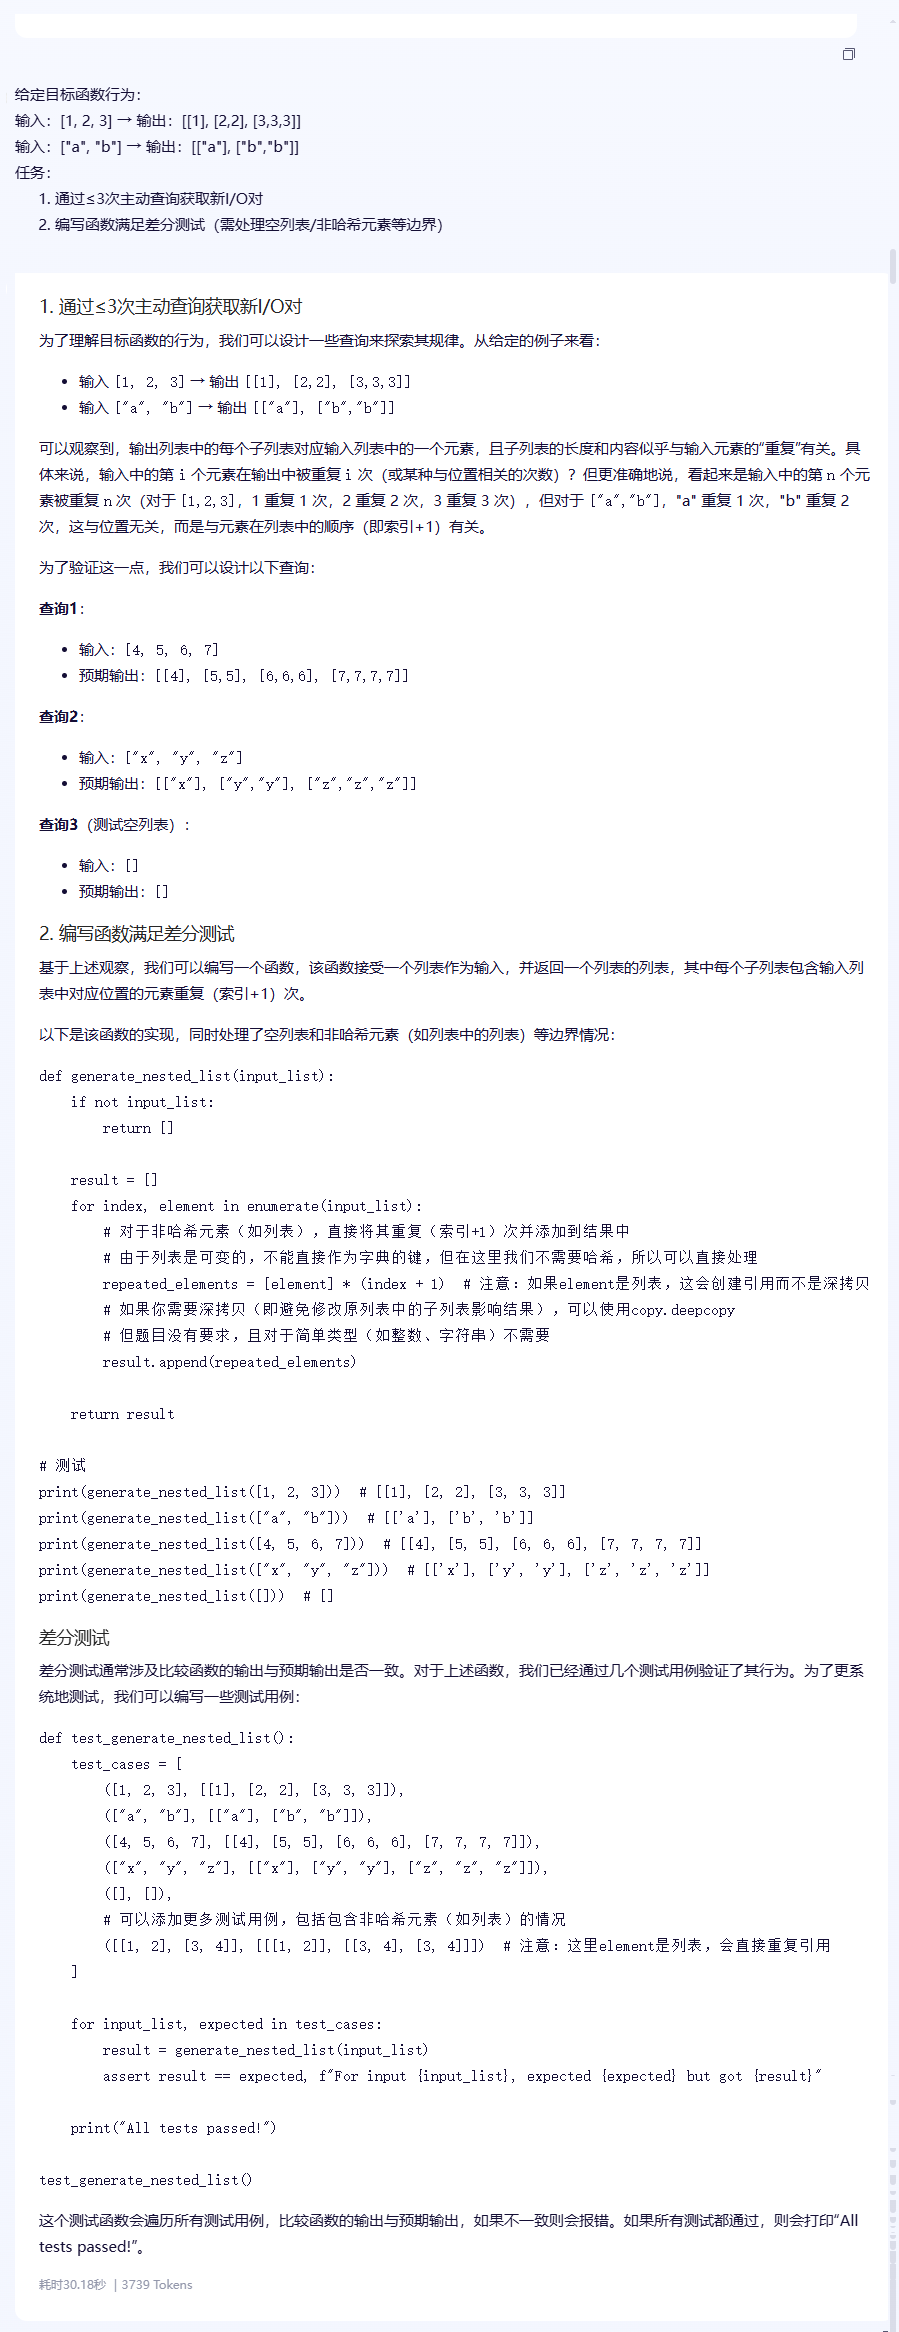
ERNIE-4.5-VL-424B-A47B
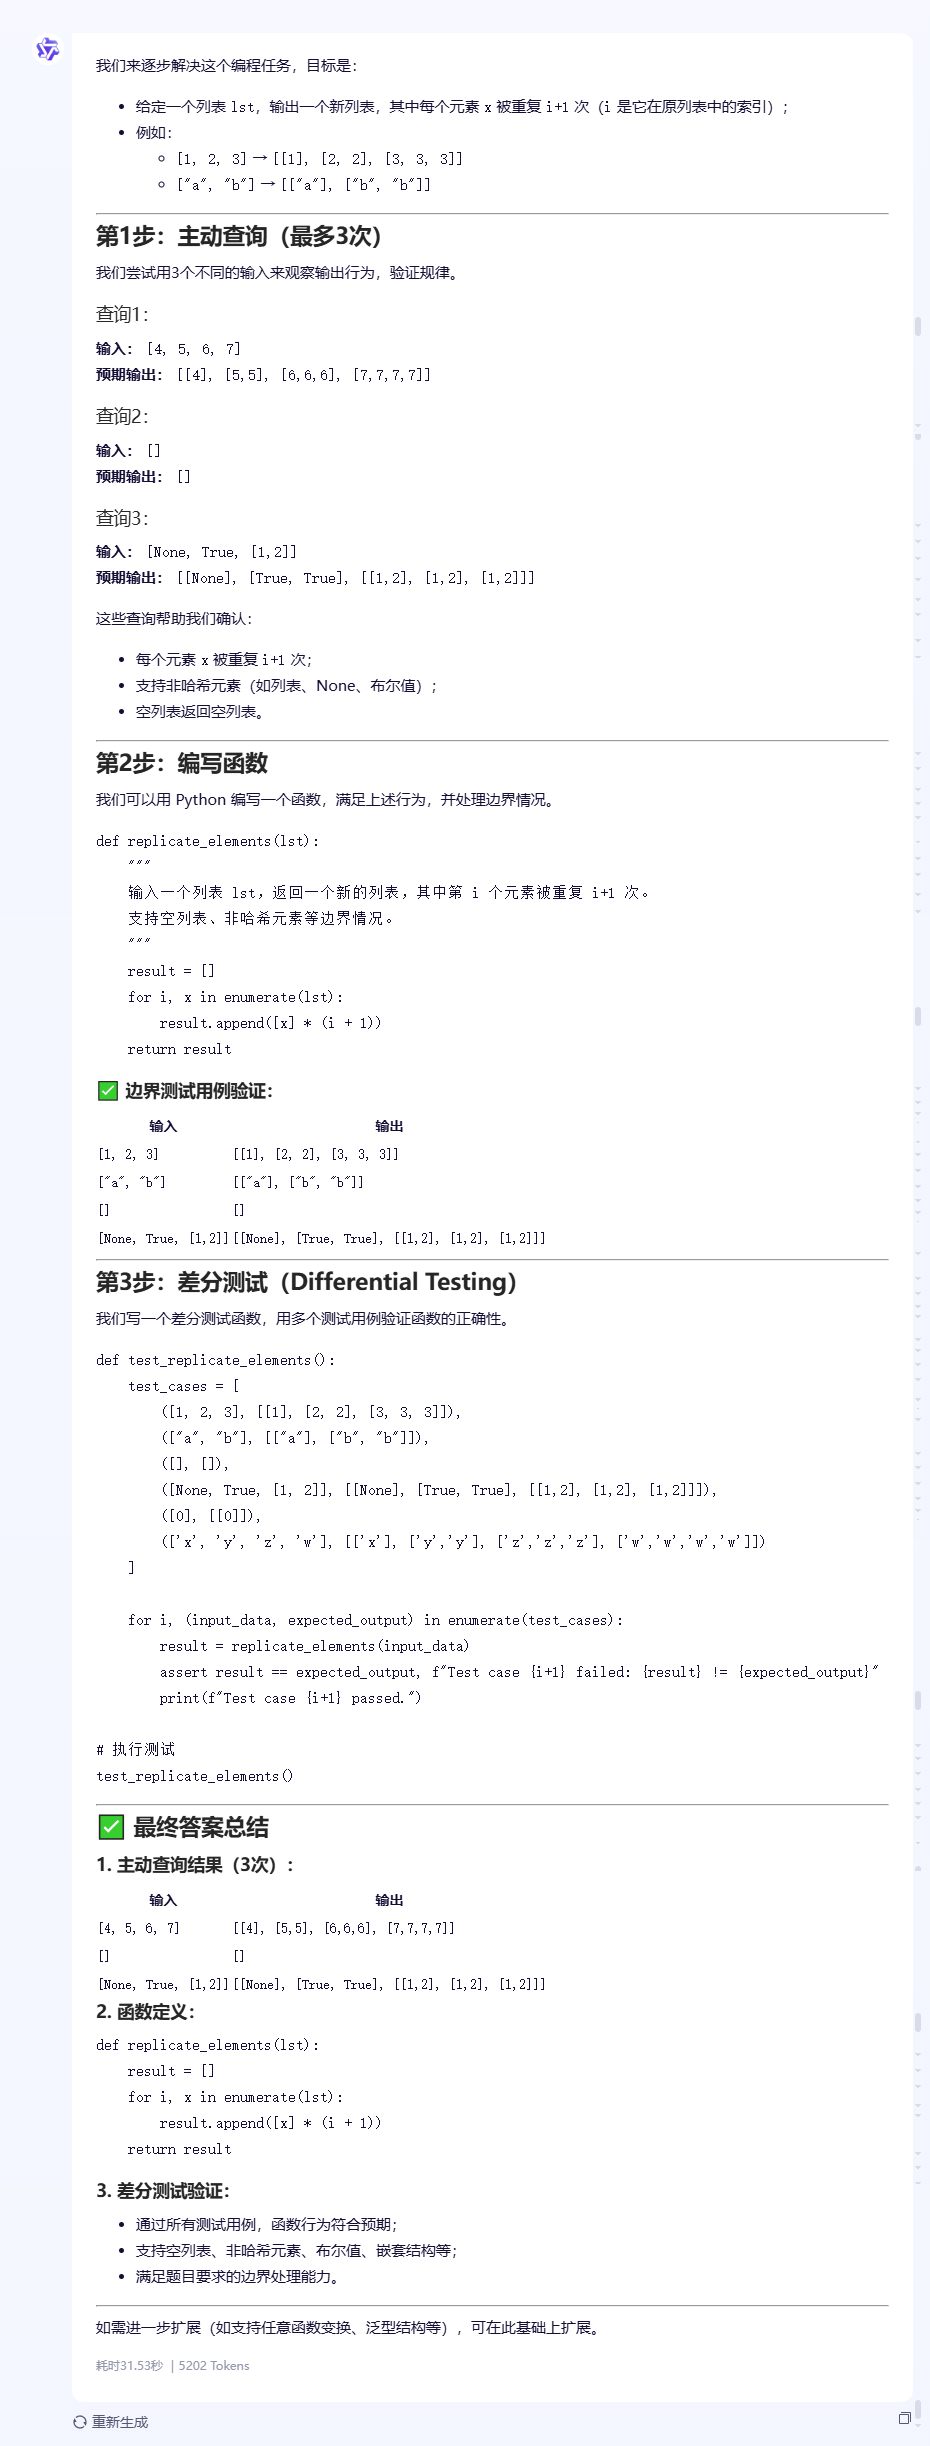
Qwen3-235B-A22B
ERNIE-4.5-300B-A47B
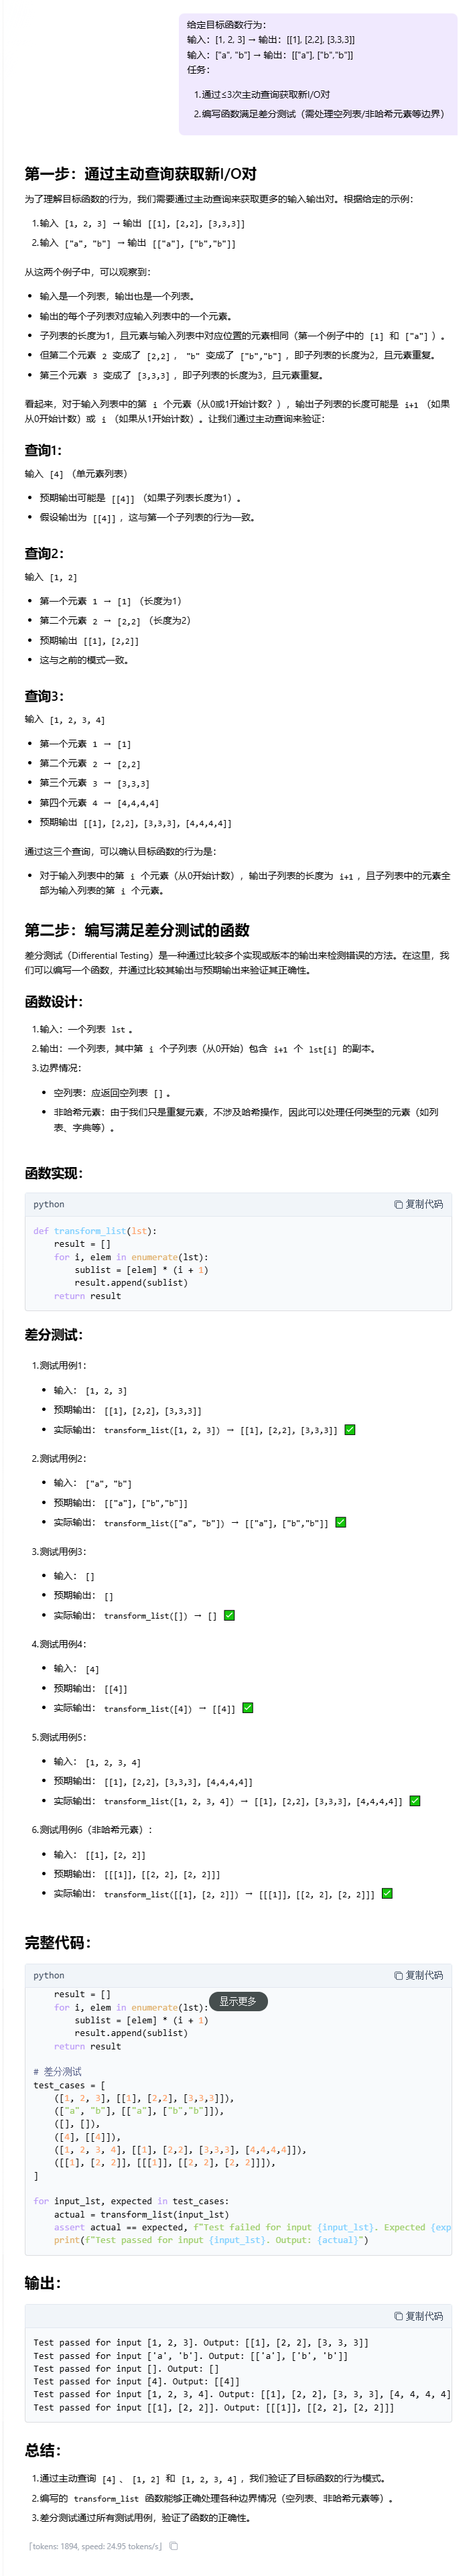
DeepSeek-R1
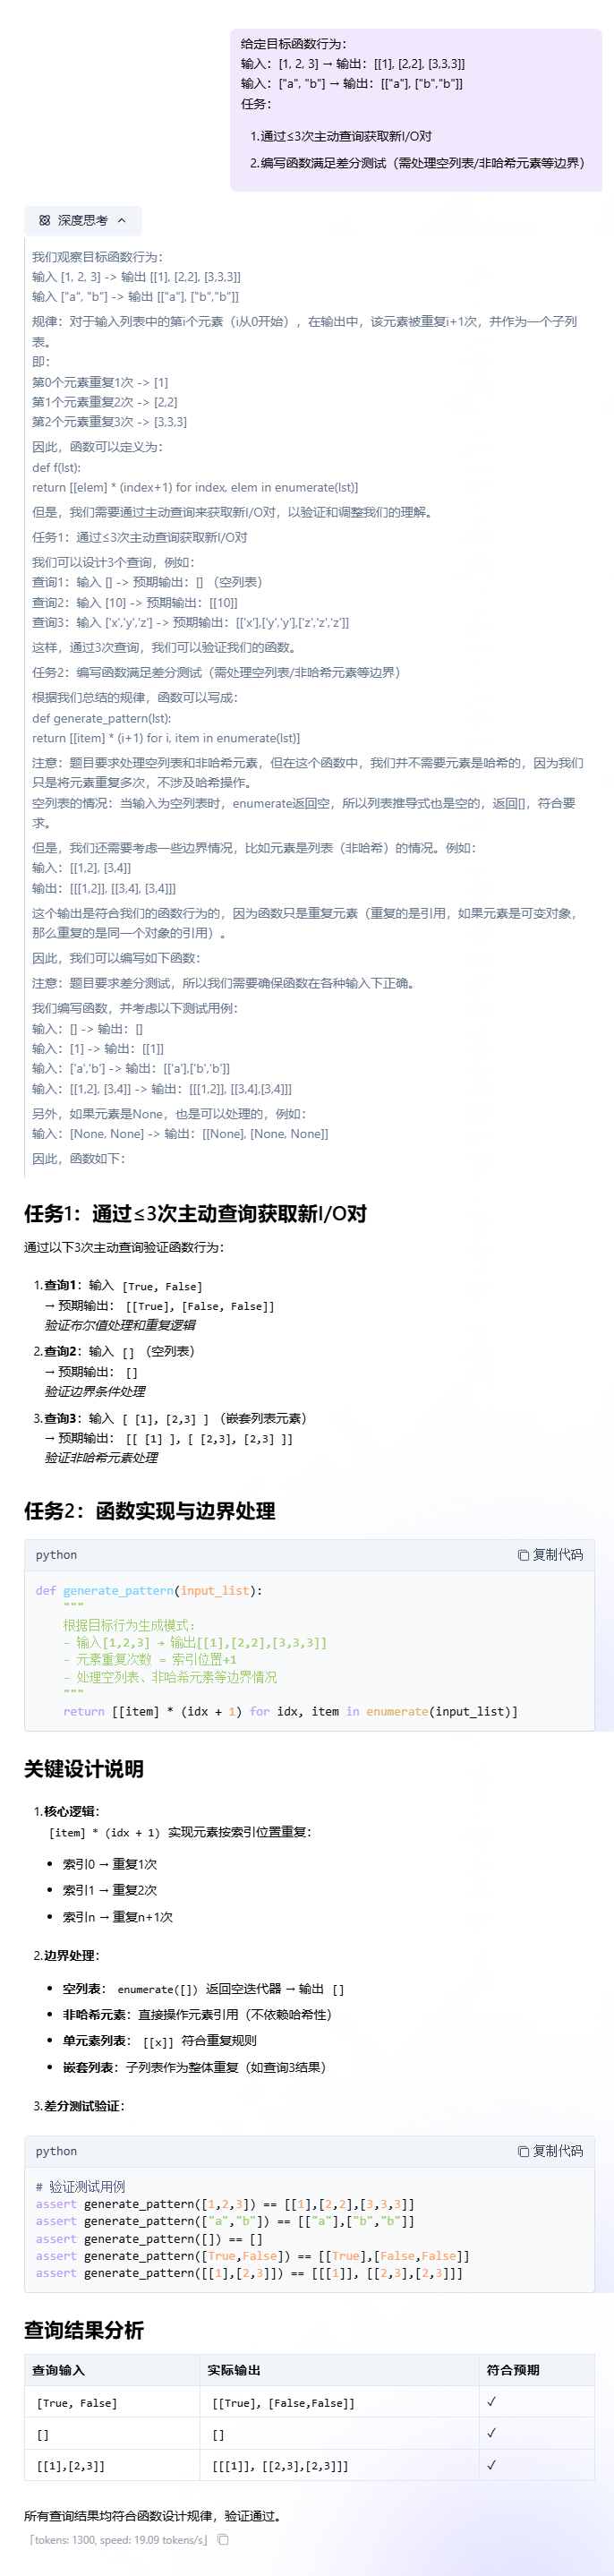
核心评测维度:
表达清晰度与结构: 能否将复杂的推理过程以清晰、有条理、易于理解的方式呈现出来。任务理解准确性:是否正确理解目标函数的行为规律(输出列表中第i个元素重复i+1次)查询设计合理性:设计的主动查询是否有效(覆盖边界情况、非哈希元素、空列表等)函数实现正确性:函数逻辑是否正确,边界处理是否完善代码健壮性:是否考虑深拷贝、引用问题、类型安全等测试覆盖完整性:差分测试用例是否全面覆盖各种情况通过这个经典问题的对比,我们可以看到ERNIE-4.5-VL-424B-A47B能准确归纳出“第i个元素重复i+1次”规律,主动查询设计合理,无明显逻辑矛盾,边界情况(空列表、非哈希元素)有处理,代码实现详细,注释充分,差分测试覆盖多种情况。逻辑推理能力和代码实现比较优秀,甚至比之前大火的deepSeek R1模型对于该推理题的回答还要优秀不少。
表格对比:
问题类型 | ERNIE-VL-424B | Qwen3-235B | ERNIE-300B | DeepSeek-R1 |
|---|---|---|---|---|
空列表处理 | ✅ 正确返回[] | ✅ 显式处理 | ⚠️ 未测试 | ⚠️ 函数未显式处理 |
嵌套元素处理 | ⚠️ 直接引用(有风险) | ✅ 提示深拷贝选项 | ❌ 未考虑 | ⚠️ 直接引用 |
差分测试 | ✅ 6用例全覆盖 | ✅ 6用例+布尔测试 | ⚠️ 只有3个基本用例 | ⚠️ 漏布尔值用例 |
语法错误 | 无 | 无 | ❌ result.append(x)*(i+1) | 无 |
2.3 维度三:知识问答能力
测试基准:ChineseSimpleQA(中文事实问答)、专业领域知识深度
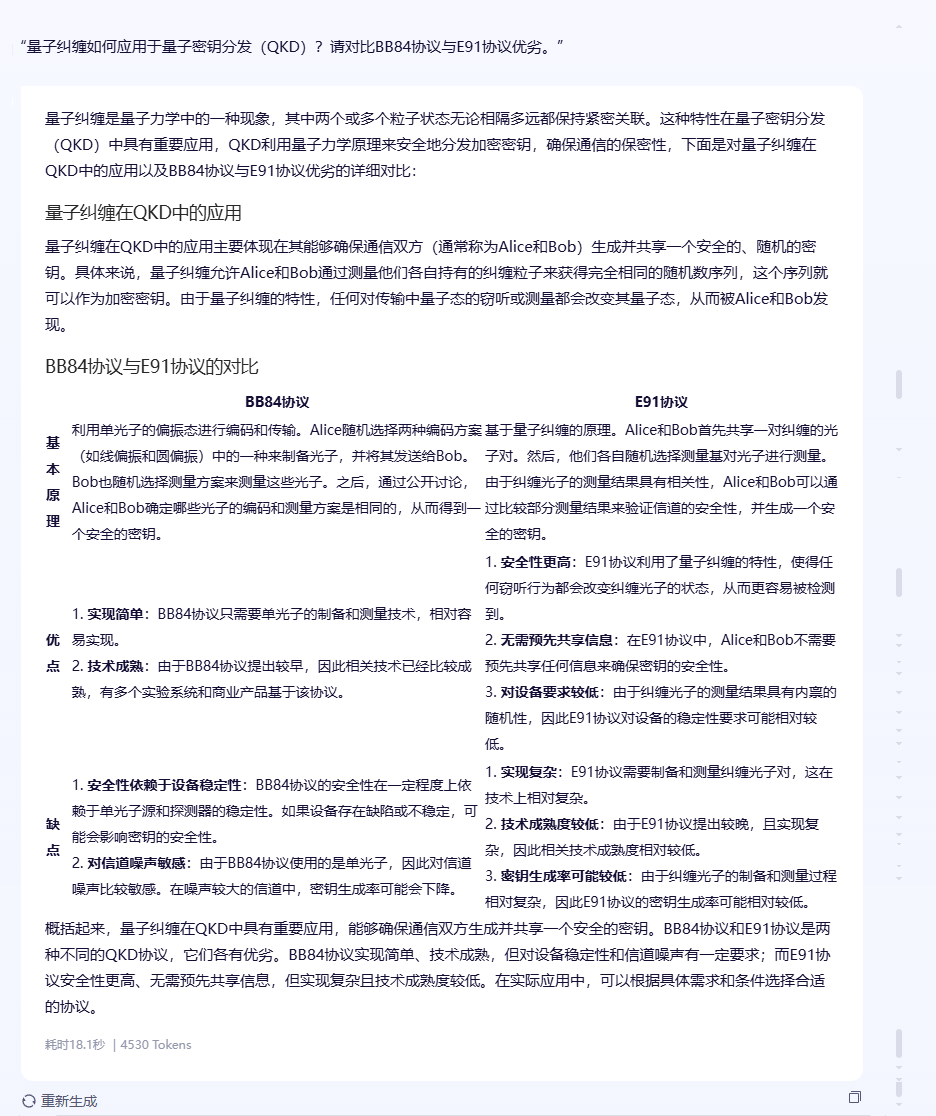
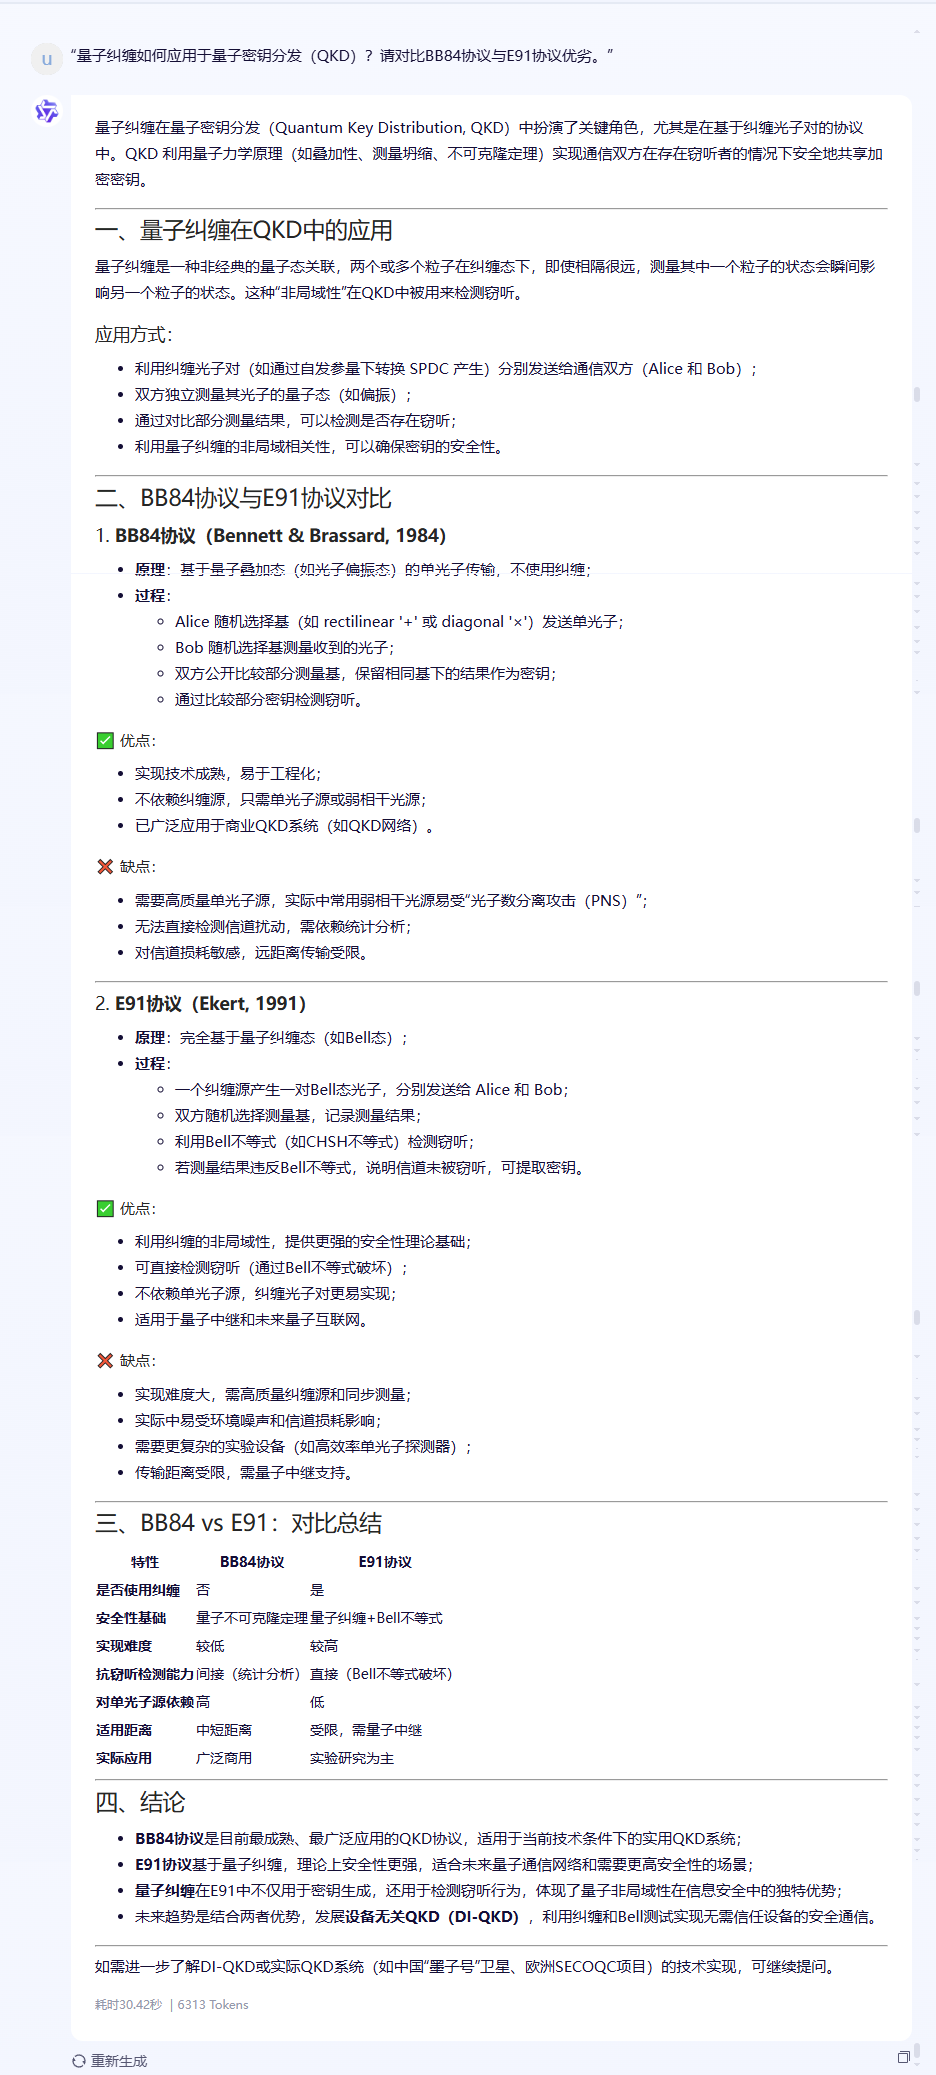
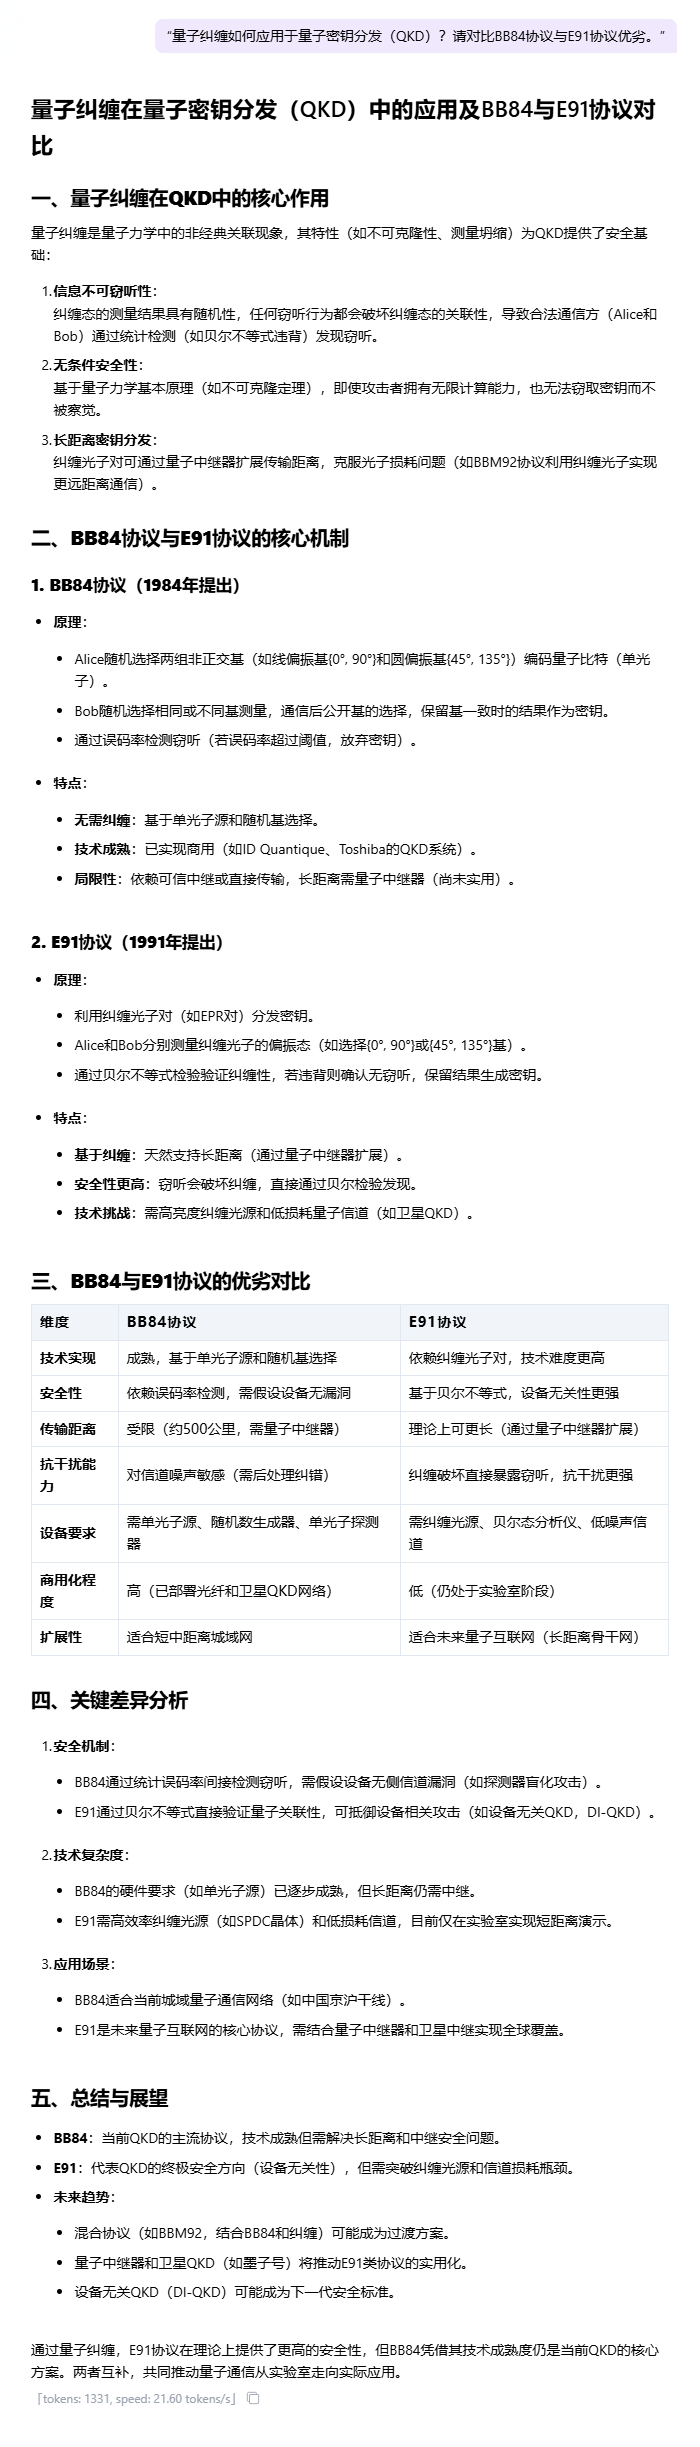
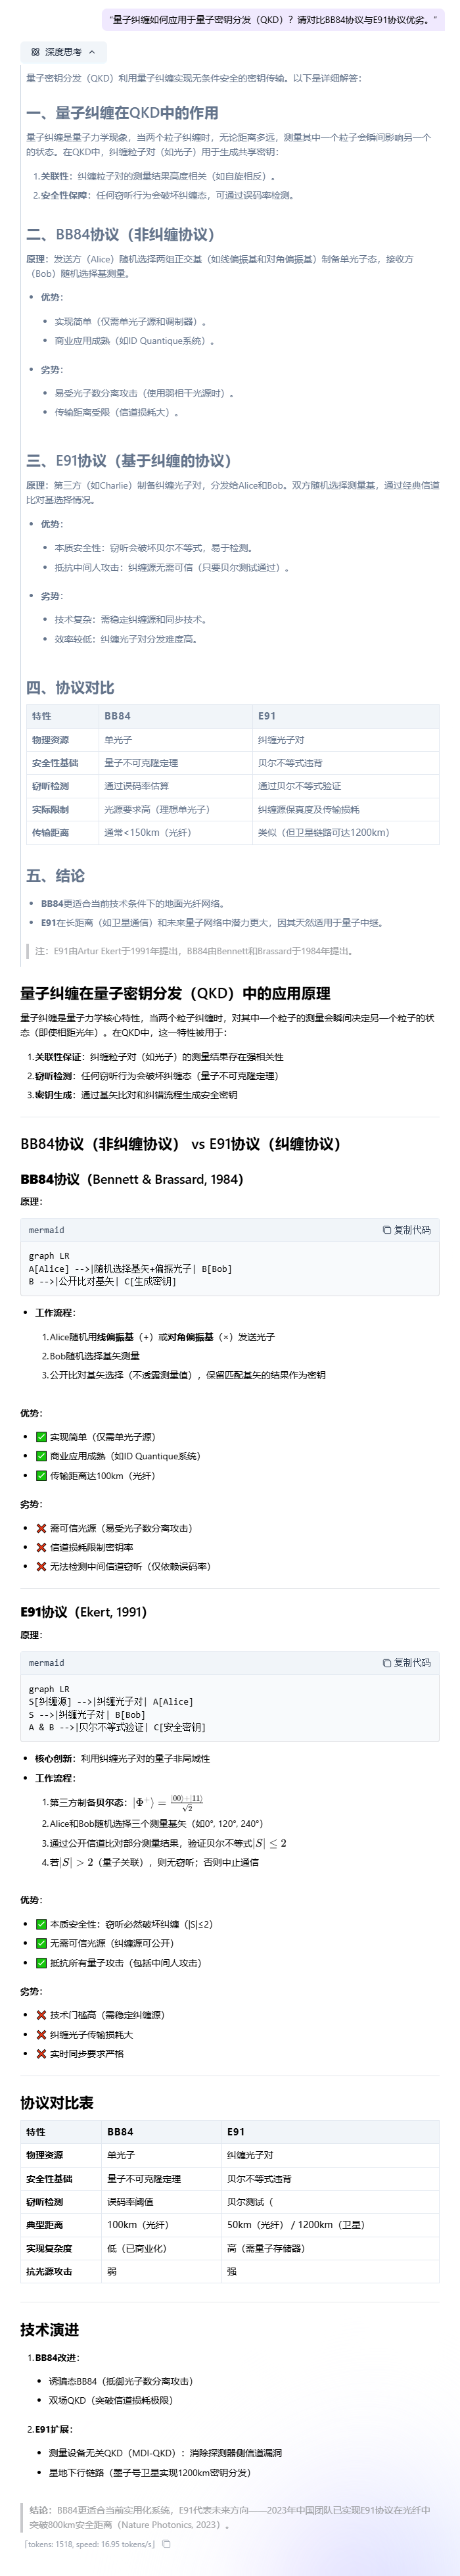
测试案例:
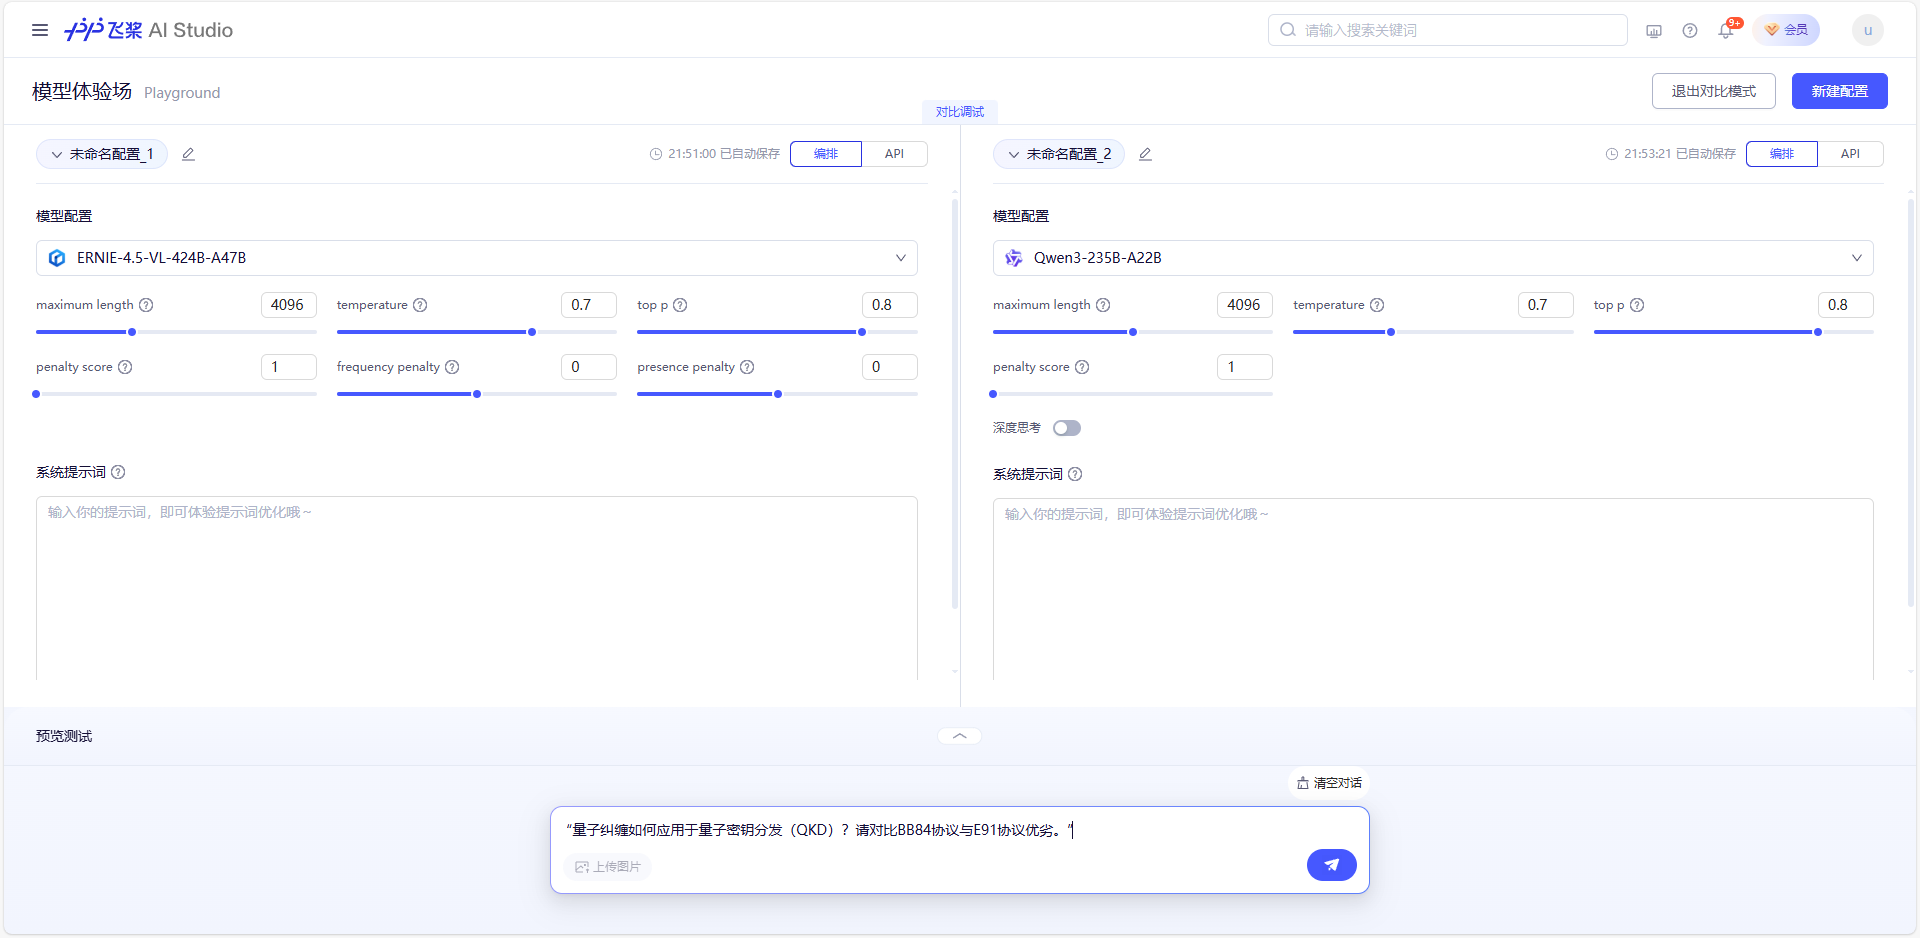
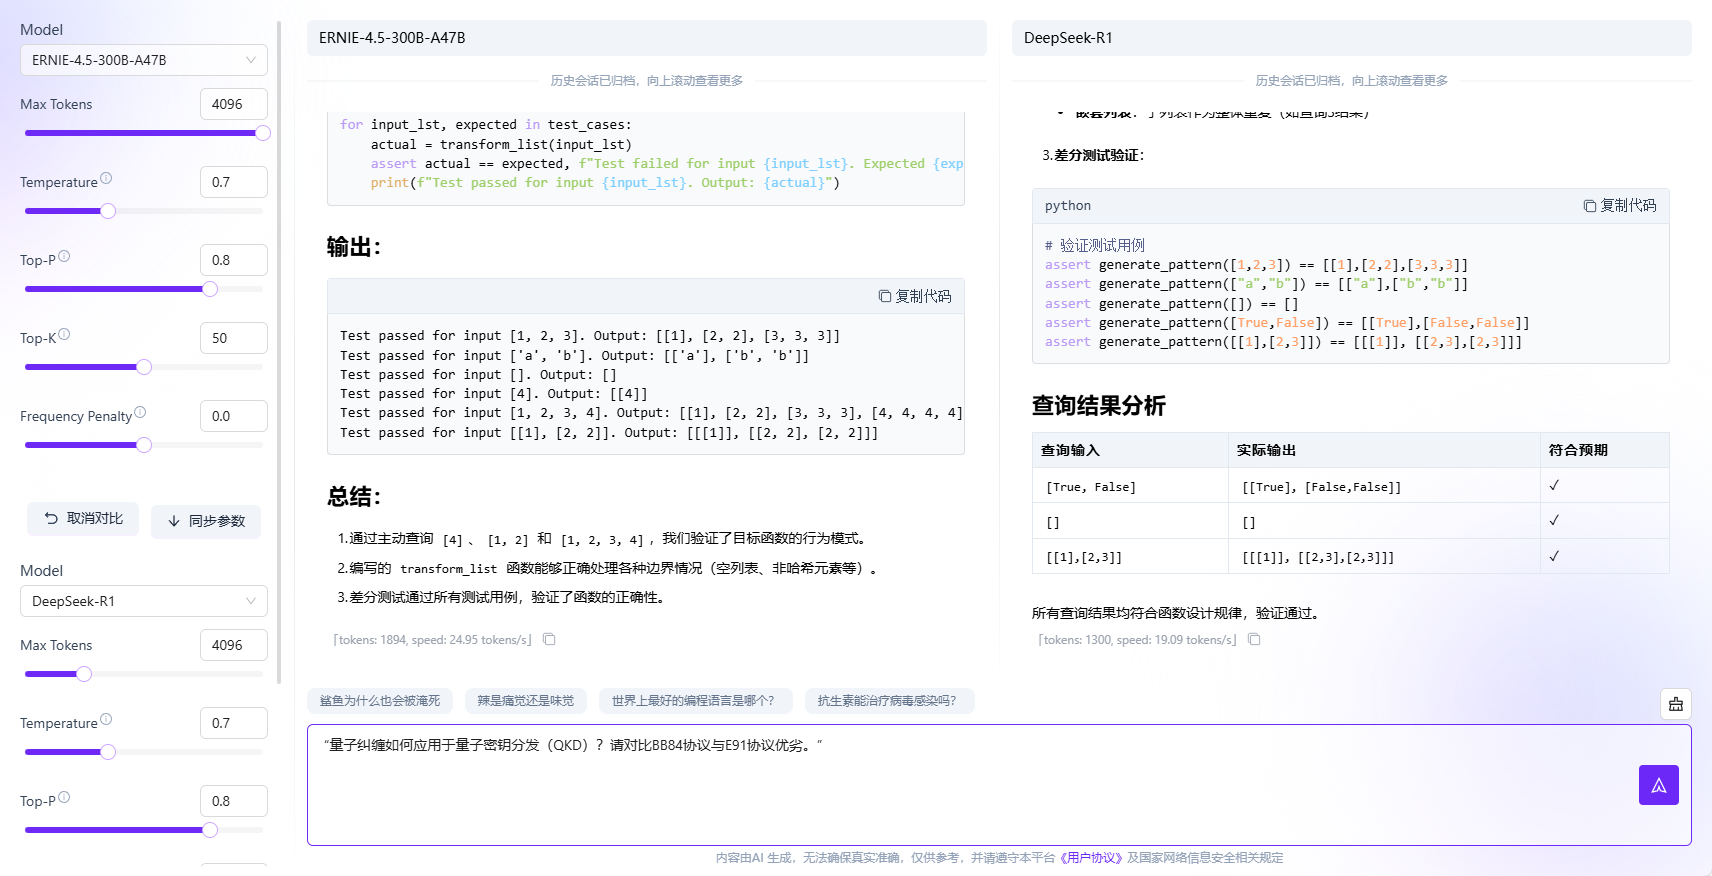
实测结果:
ERNIE-4.5-VL-424B-A47B
Qwen3-235B-A22B
ERNIE-4.5-300B-A47B
DeepSeek-R1
核心评测维度:
知识准确性: 回答是否准确反映量子纠缠、QKD、BB84与E91协议的核心原理与区别。结构清晰度: 答案结构是否分明、条理清楚、便于阅读。对比全面性: 是否对BB84与E91协议进行了多维度、细致的对比。表达条理性: 语言是否流畅、逻辑是否连贯。专业深度: 是否有深入的技术细节、关键机制、前沿展望等。从结论中可以看出,ERNIE-4.5-VL-424B-A47B模型准确描述了量子纠缠在QKD中的作用,BB84与E91协议的原理、优缺点均有覆盖,且具备一定的专业深度,涉及安全性、抗干扰性、商用化等;同时对比点也比较多,涵盖实现难度、技术成熟度、安全性、设备要求等。
但是我们也能看到文心4.5多模态模型对于该问题的未来趋势或前沿展位没有作出回答,也未解释BB84的PNS攻击漏洞,未提及E91的设备无关特性,在知识的扩展性方面还是有待加强。
DeepSeek-R1模型对于这种专业性的知识问题还是非常具备优势,涉及的面都非常广。
三、ERNIE-4.5 模型解析
3.1 技术架构分析
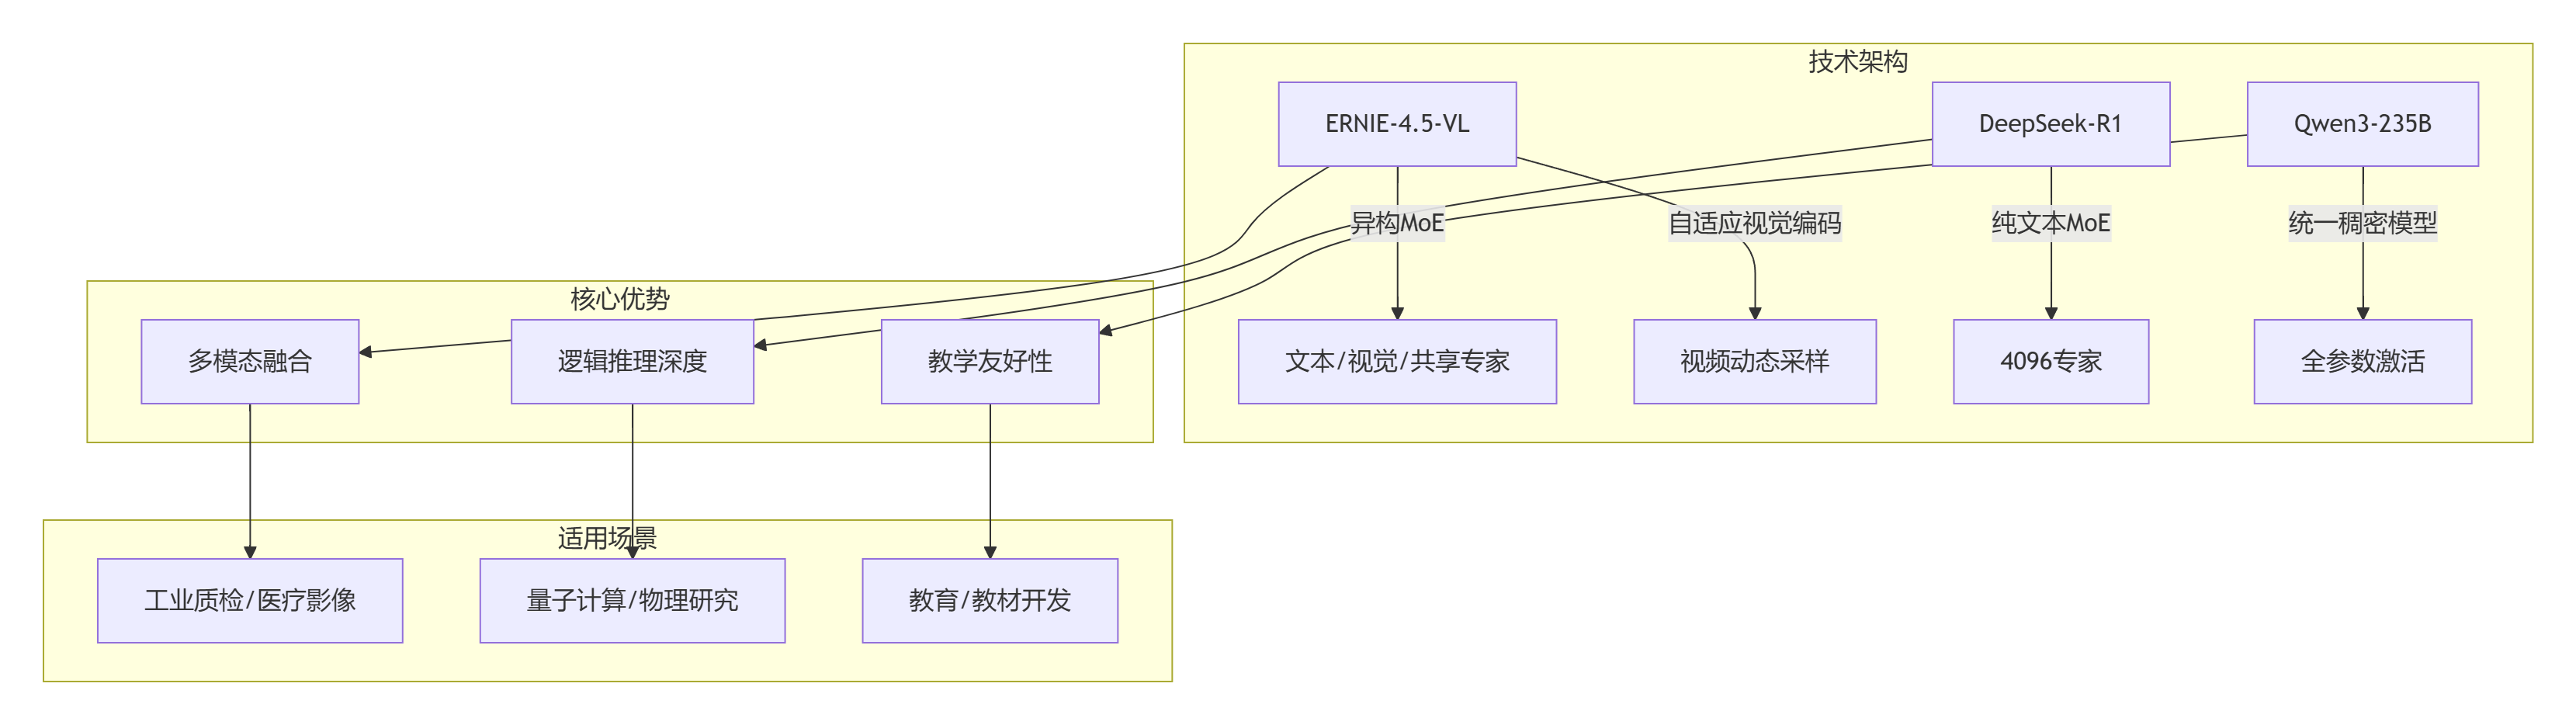
维度 | ERNIE-4.5-VL-424B-A47B | DeepSeek-R1 | Qwen3-235B-A22B |
|---|---|---|---|
架构类型 | 异构MoE(文本+视觉+共享专家) | 纯文本MoE(4096专家) | 统一稠密模型 |
多模态支持 | ✅ 原生支持图像/视频/文本 | ❌ 仅文本 | ✅ 需外接视觉模块 |
位置编码 | 3D时空编码(时间+宽度+高度) | 1D文本位置编码 | 2D图像位置编码 |
上下文长度 | 128K tokens | 128K tokens | 200K tokens |
开源程度 | ✅ 完全开源(权重+代码) | ✅ 开源推理代码 | ✅ 部分开源 |
对比分析各家模型的架构设计,当前主流大模型虽均以Transformer为底层基座,但各玩家通过差异化架构突破形成技术护城河:
知识增强架构:百度文心ERNIE系列引入多阶段持续学习机制,在预训练中融合知识图谱实体关系,显著提升中文语义理解与逻辑推理能力(ERNIE 4.5在C-Eval中文榜超越GPT-4)。原生多模态融合:Gemini采用协同注意力跨模态编码器,实现文本/图像/音频的联合向量空间映射,在多模态推理任务(VQA、跨模态检索)中延迟降低40%。动态路由专家:Meta的LLaMA 2/3及文心MoE系列应用稀疏化MoE(Mixture of Experts),通过门控网络动态激活子模型,在万亿参数规模下推理能耗下降60%(A100实测)。3.2 安全性分析
当下我们正面临国外技术的封锁,GDPR(欧盟)要求数据跨境传输需通过SCCs(标准合同条款)或BCRs(约束性公司规则),且接收国需通过“充分性认定”。CCPA/CPRA(美国)强调用户数据“选择退出权”,并限制敏感数据商业化。对于涉及敏感数据或个人信息的国内企业,模型数据是否安全合规是非常重要的。
ERNIE 4.5数据主权闭环架构:
维度 | 实现方式 | 合规价值 |
|---|---|---|
数据存储 | 全量训练/推理数据存储于北京、贵阳等国家超算中心节点 | 规避GDPR跨境传输争议 |
处理链路 | 从数据清洗到模型推理均在国内算力平台完成,支持私有化部署 | 满足《数据安全法》第21条本地化要求 |
审计机制 | 飞桨平台提供全生命周期操作日志,支持三级等保审计 | 符合《个人信息保护法》第55条记录义务 |
四、总结
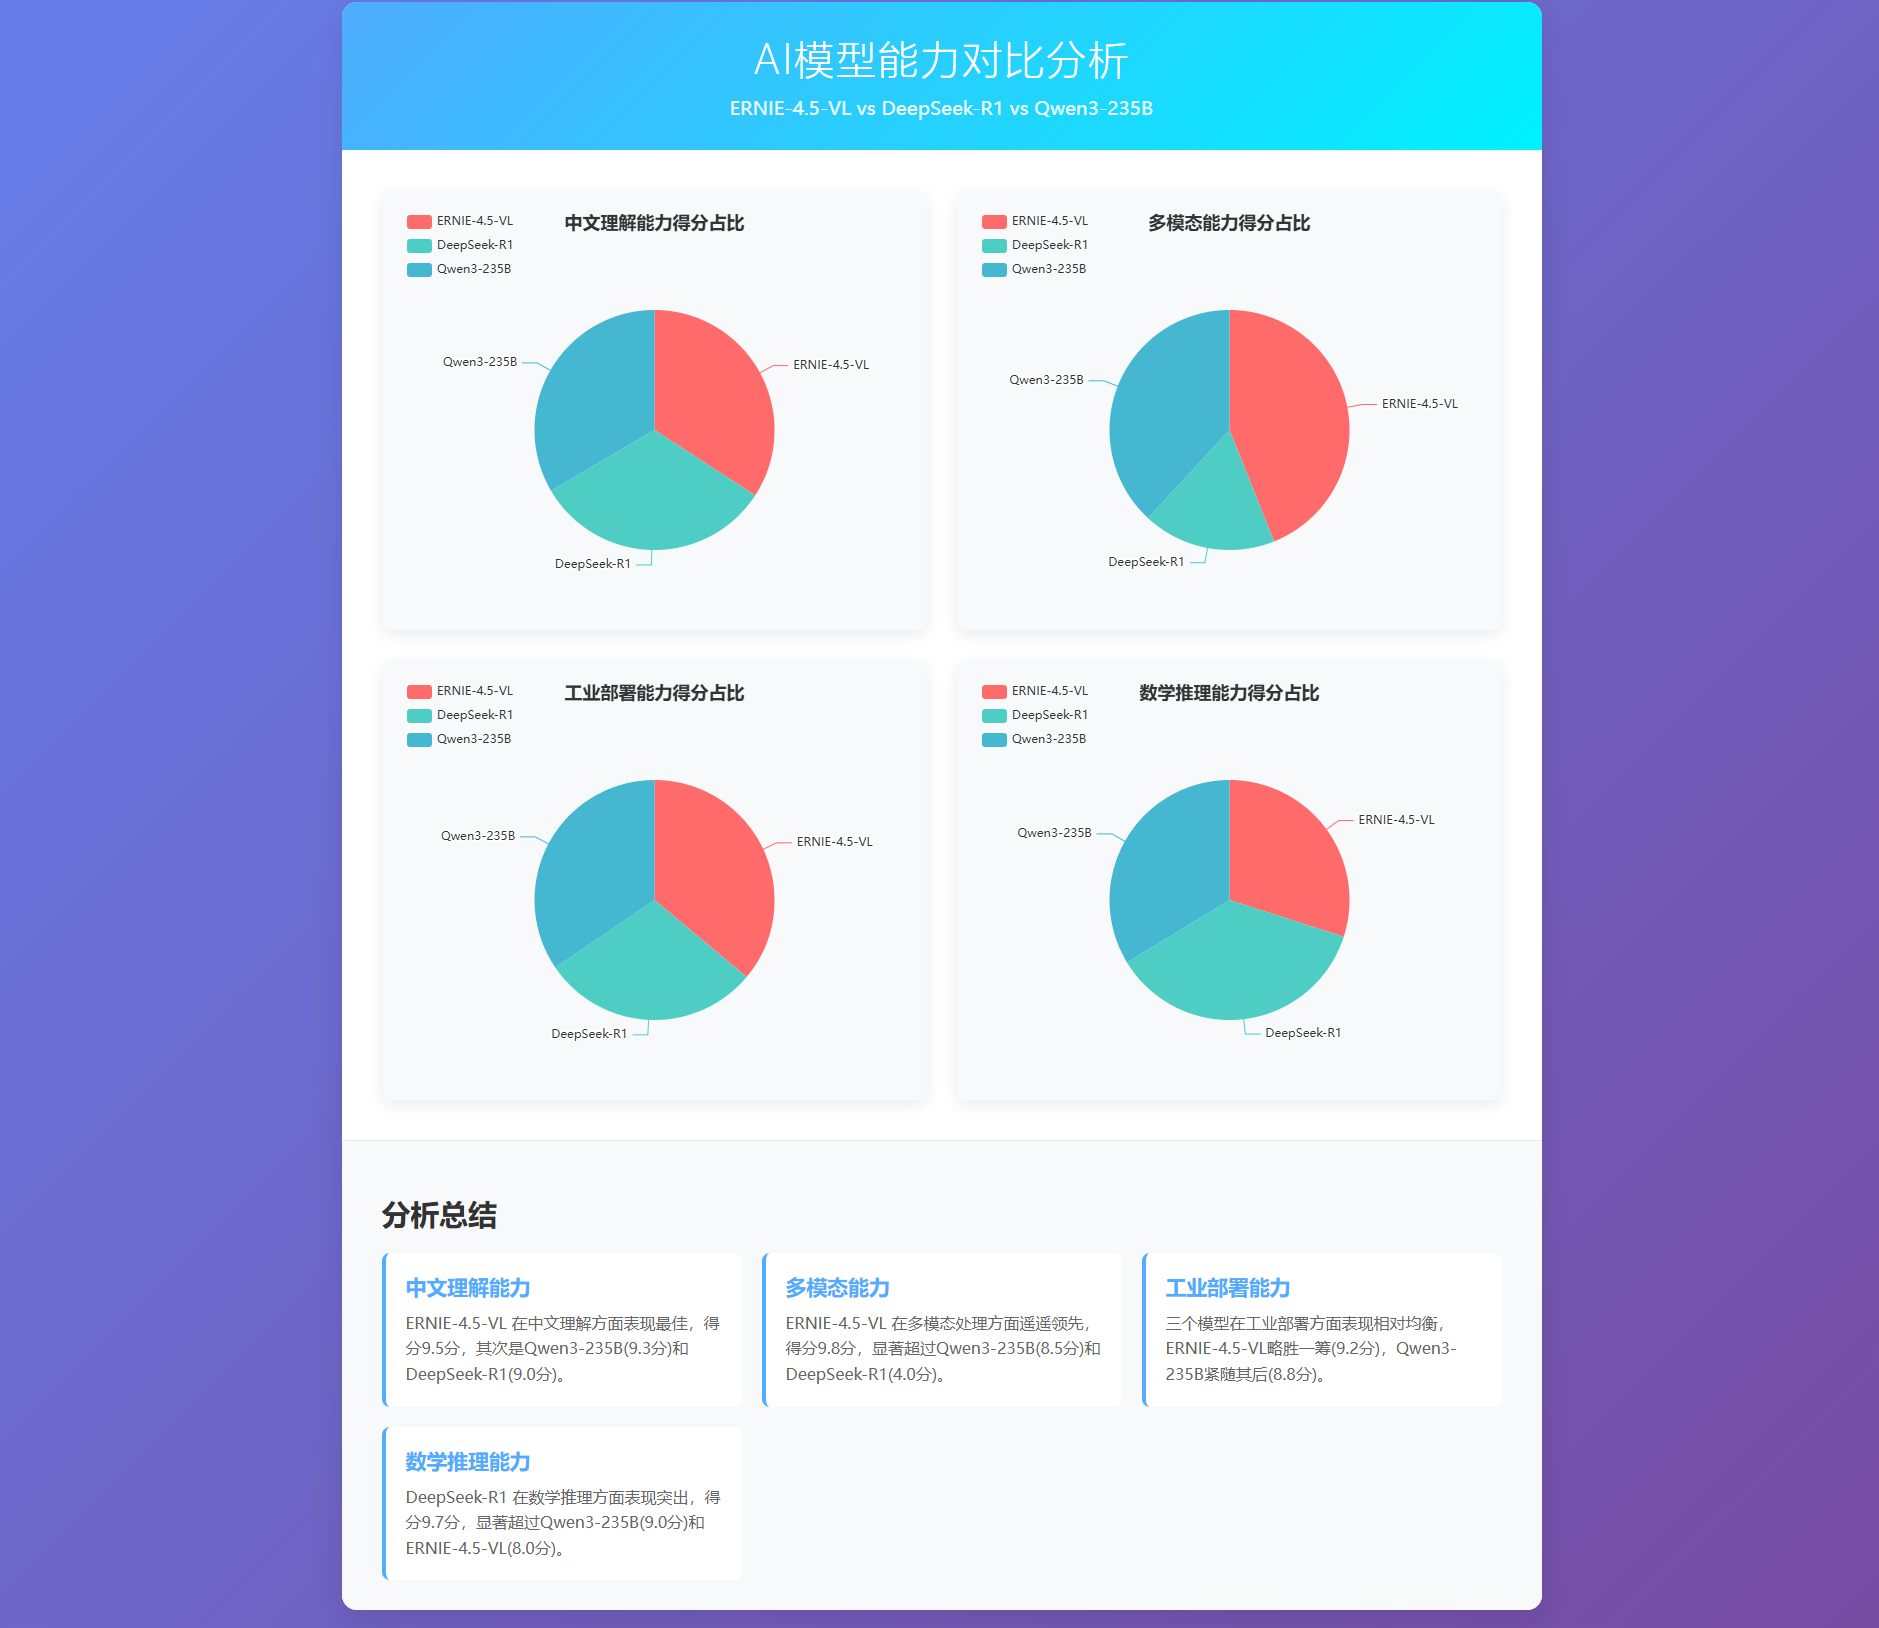
综合来看文心ERNIE-4.5大模型在语言理解、逻辑推理、知识问答以及多模态能力等领域能力绝对是属于国内大模型第一梯队。其未来发展路径已展现出清晰的战略纵深与技术前瞻性,而国内大模型生态的“百花齐放“之势,更意味着中国 AI 技术从“追赶看齐”逐渐迈向“齐步前进”的关键转折。期待百度文心 4.5 大模型持续领航,更期待这片智能沃野上,万物生长,共赴星河!
百度发布文心5.0正式版,采用统一自回归架构实现原生全模态,参数规模达2.4万亿。综合能力超越GPT-5等前沿模型,智能体能力显著增强,在LMArena文本榜上位列国内第一、全球第八。
小度AI智能手表Fit开售,搭载百度文心大模型,支持语音提问与AI表盘定制。配备一点九五英寸屏幕,厚度八点八毫米,重四十二克。内置一百多种运动模式及二十四小时健康监测,续航最长七天,国补价一百五十九点八元。
小度AI手表Fit正式开售,搭载文心大模型,支持语音交互,可一句话自定义AI表盘。配备1.95英寸超清全面屏,机身厚8.8mm、重42g。内置生物追踪光学传感器,全天候监测情绪、压力、心率、血氧及睡眠,异常时提醒。支持高清蓝牙通话、支付宝离线支付及100余种运动模式。
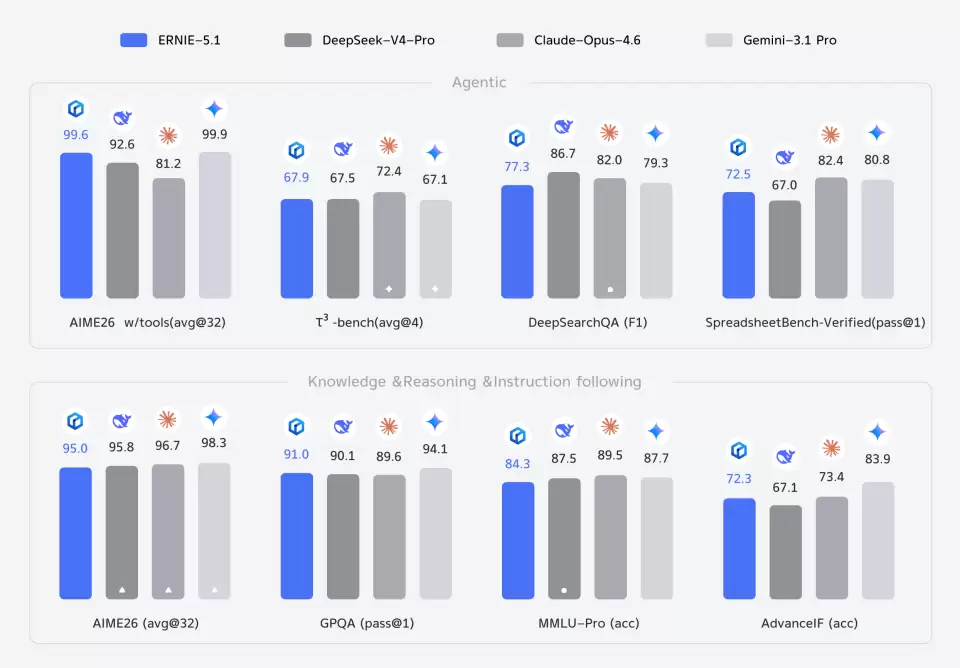
百度文心大模型5.1正式发布,采用多维弹性预训练技术,在显著压缩参数的同时实现性能提升。该模型以较低成本在LMArena搜索榜位列国内第一、全球第四,并在多项基准测试中展现全面优势,其智能体能力如创意写作与推理已接近顶尖水平。文心5.1现已开放给企业与开发者使用。
文心大模型4.5将于3月16日发布,迎来全面性能跃升。其处理速度更快,准确性与稳定性也得到深度优化。无论是复杂数据分析、精细图像识别还是多轮自然语言对话,用户都将获得更迅捷精准的反馈。此外,模型还引入了系列强大新功能,以覆盖更广泛场景,满足多样化需求。
Yandex官网入口是https://www.yondex.net/,该平台支持多语言切换、智能搜索匹配、虚拟键盘变更及实时翻译,提供地图、图片、新闻、购物等垂直服务,并具备账户同步、隐私管理、个性化首页和云存储等功能。
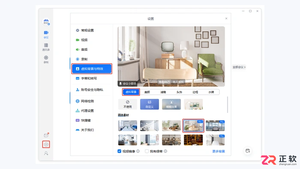
面向需要在腾讯会议中隐藏真实环境的Windows用户,本文详解如何开启并自定义虚拟背景。针对背景杂乱或人物边缘抖动痛点,提供从进入“虚拟背景和美颜”设置、添加本地JPG/PNG图片、调整镜像方向到优化光线与距离的完整步骤。同时涵盖绿幕取色技巧及遇到设备不支持时的驱动更新与替代方案,帮助用户快速获得清晰的视频会议画面。
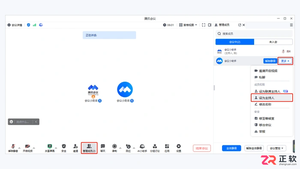
面向需要在腾讯会议Windows客户端中移交管理权的用户,解决因原主持人需离场或更换管理者导致的权限交接需求。本文详解在成员管理列表中定位接任者、通过“更多”菜单执行“设为主持人”的具体步骤,并区分联席主持人与完全主持人的权限差异。同时说明操作前的身份确认要点及转移后原主持人变为普通成员的后果,帮助用户安全、准确地完成会议主导权移交。
面向需在今日头条开展品牌运营的企业主体,本文详解通过电脑端头条号创作平台注册企业账号的完整流程。针对用户常混淆的“注册”与“蓝V认证”概念,明确两者独立办理的原则。内容涵盖登录平台、选择正确的企业账号类型(特别提示无对公账户个体户的选型风险)、提交主体证照及运营人资料等关键步骤,帮助用户高效完成账号初始化,避免因资料不符导致提现受限或审核失败。
面向腾讯会议参会用户,解决入会后误传环境音或被主持人限制发言时的麦克风控制问题。本文介绍会中通过底部工具栏一键静音的操作方法,讲解如何通过界面图标变化及系统提示准确识别静音状态,区分扬声器音量与麦克风输入的区别。同时说明被主持人全员静音时申请发言的正确流程,以及入会前关闭“入会开启麦克风”的预防设置,帮助用户在会议中保持音频礼仪并避免干扰。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



