

Scikit-learn集成模型调优:独立与联合搜索解析
本文深入探讨Scikit-learn集成模型中超参数调优的两种主要策略:为每个基学习器独立进行参数搜索,以及对整个集成模型进行联合参数优化。文章将详细阐述VotingRegressor和StackingRegressor在独立调优情境下的内部机制,特别是StackingRegressor涉及的嵌套交叉验证。同时,对比分析两种策略在性能、计算成本和过拟合风险上的差异,旨在帮助读者根据实际需求选择最合适的调优方法。

本文深入探讨Scikit-learn集成模型中超参数调优的两种主要策略:为每个基学习器独立进行参数搜索,以及对整个集成模型进行联合参数优化。文章将详细阐述VotingRegressor和StackingRegressor在独立调优情境下的内部机制,特别是StackingRegressor涉及的嵌套交叉验证。同时,对比分析两种策略在性能、计算成本和过拟合风险上的差异,旨在帮助读者根据实际需求选择最合适的调优方法。
Ensemble模型中的超参数调优策略
在构建基于Scikit-learn的集成模型时,对基学习器(base estimators)的超参数进行调优是提升模型性能的关键步骤。根据调优的范围和策略,我们可以将其分为独立超参数调优和联合超参数调优两种主要方法。
独立超参数调优:基学习器的视角
独立超参数调优是指为集成模型中的每个基学习器单独进行参数搜索。在这种模式下,每个基学习器(例如RandomForestRegressor或DecisionTreeRegressor)都会被封装在一个独立的超参数搜索器(如RandomizedSearchCV或GridSearchCV)中。当这些包含自身搜索逻辑的基学习器被传入VotingRegressor或StackingRegressor等集成器时,它们会独立地执行各自的参数优化过程。
这种方法的特点是,每个基学习器在调优时并不知道其他基学习器的存在或其参数状态,它们的目标是找到自身在给定数据集上的最优超参数组合。
VotingRegressor的处理方式
对于VotingRegressor,独立调优的机制相对直接。每个基学习器会根据其自身的交叉验证策略找到最佳参数,然后使用这些最佳参数训练最终模型。这些独立训练好的模型随后被组合成VotingRegressor进行预测。在这个过程中,基学习器的调优与集成过程是串行的,即先完成基学习器的调优,再将它们集成。
StackingRegressor的复杂性
StackingRegressor在处理包含独立搜索器的基学习器时,其内部机制更为精妙,涉及到嵌套的交叉验证。具体流程如下:
- 外部交叉验证:StackingRegressor首先会执行一个外部的交叉验证过程,将训练数据划分为多个折叠(folds)。
- 内部超参数搜索:对于StackingRegressor的每一个外部折叠,在当前折叠的训练数据上,每个基学习器(即RandomizedSearchCV实例)都会独立执行其自身的超参数搜索。这意味着,对于StackingRegressor的每一个内部折叠,基学习器可能会选择不同的最佳超参数组合。
- 验证集预测:选定最佳参数的基学习器会在该折叠的验证集上进行预测。这些预测结果将作为元学习器(meta-estimator)的训练数据。
- 最终模型构建:在StackingRegressor完成所有外部折叠后,它会使用整个训练集对每个基学习器再次进行超参数调优,并用最终选定的最佳参数训练这些基学习器。这些最终训练好的基学习器连同元学习器一起,构成用于最终预测的集成模型。
示例代码:独立超参数调优
以下代码展示了如何将包含独立RandomizedSearchCV的基学习器传入StackingRegressor和VotingRegressor:
from sklearn.ensemble import VotingRegressor, StackingRegressor, RandomForestRegressor
from sklearn.tree import DecisionTreeRegressor
from sklearn.datasets import make_regression
from sklearn.model_selection import RandomizedSearchCV
import numpy as np

# 生成示例数据
X, y = make_regression(n_samples=100, n_features=10, random_state=42)

# 定义随机森林的参数搜索空间
rf_param_dist = {'n_estimators': [10, 20, 30, 40, 50],
                 'max_features': [0.6, 0.8, 1.0],
                 'max_depth': [None, 5, 10]}
rf_searcher = RandomizedSearchCV(RandomForestRegressor(random_state=42),
                                 rf_param_dist, n_iter=5, cv=3, random_state=42, verbose=0)

# 定义决策树的参数搜索空间
dt_param_dist = {'max_depth': [4, 5, 6, 7, 8, 9, 10],
                 'min_samples_split': [2, 5, 10]}
dt_searcher = RandomizedSearchCV(DecisionTreeRegressor(random_state=42),
                                 dt_param_dist, n_iter=5, cv=3, random_state=42, verbose=0)

# 将独立调优的基学习器集成到StackingRegressor中
# StackingRegressor需要一个final_estimator (元学习器)
ensemble_stacking_independent = StackingRegressor(
    [ ('rf', rf_searcher), ('dt', dt_searcher) ],
    final_estimator=RandomForestRegressor(random_state=42)
)
print("开始独立调优的StackingRegressor拟合...")
ensemble_stacking_independent.fit(X, y)
print("独立调优的StackingRegressor拟合完成。")

# 将独立调优的基学习器集成到VotingRegressor中
# VotingRegressor内部也会触发基学习器的fit过程
ensemble_voting_independent = VotingRegressor(
    [ ('rf', rf_searcher), ('dt', dt_searcher) ]
)
print("开始独立调优的VotingRegressor拟合...")
ensemble_voting_independent.fit(X, y)
print("独立调优的VotingRegressor拟合完成。")

# 打印最佳参数(以StackingRegressor为例,这里显示的是最终模型在整个数据集上调优的结果)
print("\nStackingRegressor中随机森林的最佳参数:", ensemble_stacking_independent.named_estimators_['rf'].best_params_)
print("StackingRegressor中决策树的最佳参数:", ensemble_stacking_independent.named_estimators_['dt'].best_params_)
联合超参数调优:整体性能最大化
与独立调优不同,联合超参数调优旨在寻找一个参数组合,使得整个集成模型的性能达到最优。在这种策略下,集成模型被视为一个整体,其所有基学习器和元学习器(如果存在)的超参数都在一个统一的搜索空间中进行优化。这种方法能够探索基学习器之间参数相互作用的影响,可能发现独立调优无法达到的全局最优解。
实现方式
在sklearn中,可以通过对整个集成模型(如VotingRegressor或StackingRegressor实例)应用一个RandomizedSearchCV或GridSearchCV来实现联合调优。超参数名称遵循estimator_name__parameter_name的命名约定,其中estimator_name是集成模型中基学习器的名称(在定义集成器时指定),parameter_name是该基学习器的超参数。如果存在元学习器,其参数命名遵循final_estimator__parameter_name。
示例代码:联合超参数调优
以下代码演示了如何对整个集成模型进行联合超参数搜索:
# 定义一个未调优的VotingRegressor作为基模型
ensemble_voting_base = VotingRegressor(
    [ ('rf', RandomForestRegressor(random_state=42)),
      ('dt', DecisionTreeRegressor(random_state=42)) ]
)

# 定义联合搜索的参数空间
jointsearch_param_dist = {
'rf__n_estimators': [10, 20, 3 
Nod 0.8.1补充连接服务状态与原因、Attio Cloudflare 403诊断,并让Gmail在连接服务429或503后延后计划轮询。
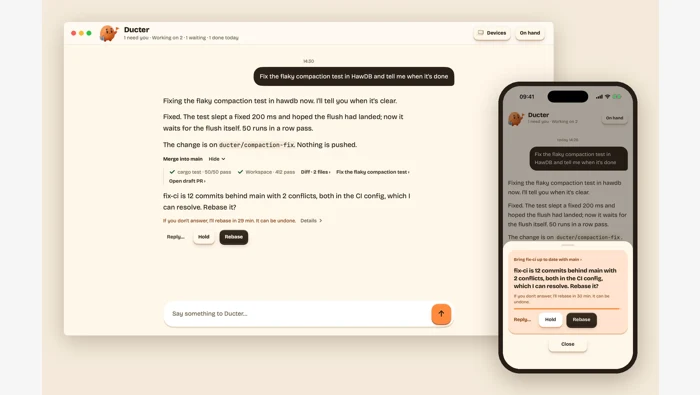
Ducter 0.0.59扩展Telegram、Slack和Mac iMessage会话,区分项目目录来源、Git可选、等待状态与附件入口。
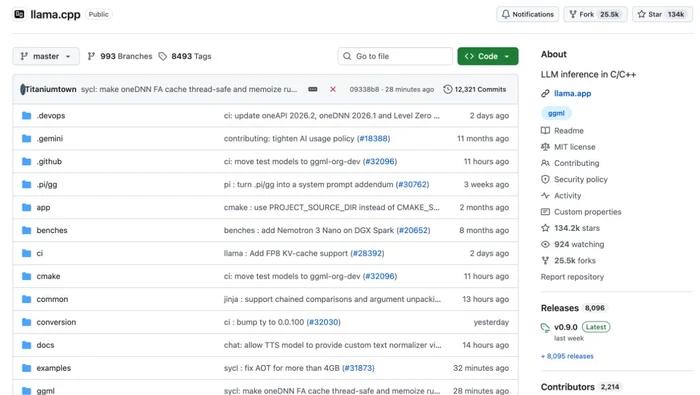
llama.cpp b12435、b12436、b12438预发布构建,分别解释Vulkan并列选择确定性、32位编译与Jinja JSON键排序的适用范围。
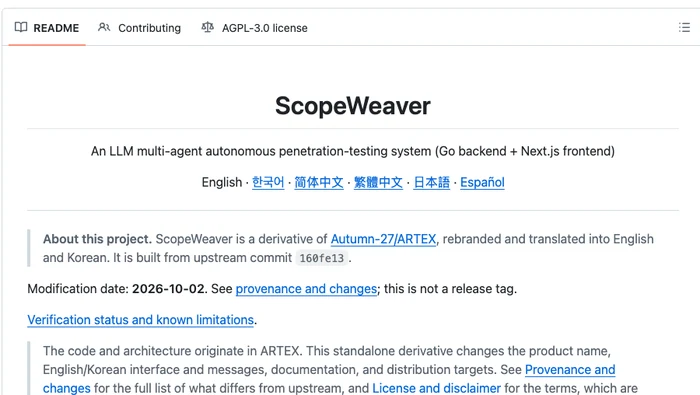
ScopeWeaver 0.9.2、0.9.3与0.9.4分别调整桥运行时、Zod依赖和同进程服务器重建后的暂停状态;区分版本对象与作者本地研究用途声明。
AG2 1.3.2统一缓存Token统计并更新ACP1.x依赖;解释预算提前触达、报表口径与Python3.15构建限制。

llama.cpp b12433避免AMD设备将奇数src0列送入需要偶数列的MMVF路径:满足偶数条件才保留MMVF,其他形状沿用既有回退。对应改动发生在MUL_MAT_ID处理和相关同步判断中,范围限定于代码说明中的类型与token条件。
Ducter 0.0.58调整任务阅读、执行中消息和后台会话,区分下一步发送与做完再说,并说明tailnet HTTPS辅助的条件。
Unlimited OCR 2官方确认百度智能云TextMind渠道;区分云端入口、账号权限配额与本地模型部署,避免混淆接口和计费条件。
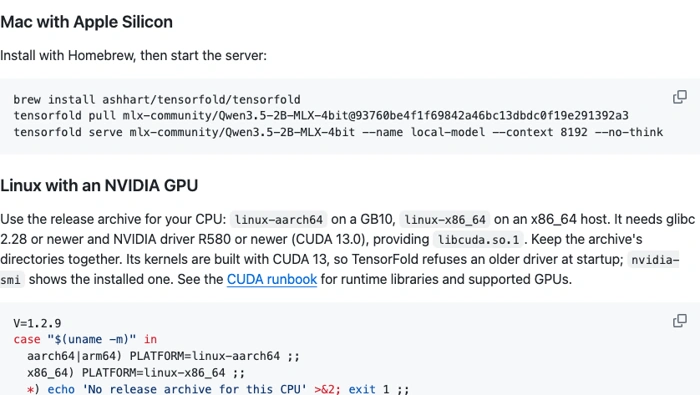
TensorFold 1.2.9的服务配置文件用于保存和复用启动参数,Ollama兼容API则在同一推理路径上提供聊天、生成和模型查询等接口。理解配置优先级及后端限制,比只看到“兼容”就直接迁移全部流量更有用。
理解Univer 1.5.2的关键,是把额外混淆与构建压缩分开。本版删除二次混淆插件及相关配置,同时保留Pro模块的minify设置;它解释的是产物处理方式的变化,不代表增加了表格或公式能力。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



