

Langchain FAISS相似度解析:距离与嵌入影响全解
本文深入探讨了Langchain中FAISS向量数据库进行相似度计算时,L2距离与余弦相似度的差异及其对结果的影响。通过案例分析,阐述了即使文本完全相同,不同嵌入模型(如BGE与OpenAI)可能导致L2距离不为零的原因,并提供了优化建议,帮助开发者更准确地理解和应用向量相似度搜索。

在构建基于向量相似度搜索的RAG(Retrieval-Augmented Generation)系统时,选择合适的向量数据库和嵌入模型至关重要。然而,开发者在使用Langchain结合FAISS和特定嵌入模型(如BGE)时,可能会遇到一个常见困惑:即使查询文本与向量库中存储的文本完全一致,similarity_search_with_score()方法返回的“相似度分数”却并非预期的完美匹配值(如余弦相似度为1.0或L2距离为0.0),而是出现一个非零值(例如0.9)。这通常源于对FAISS内部距离度量方式的误解以及嵌入模型特性带来的细微差异。
FAISS与距离度量:L2距离的奥秘
FAISS(Facebook AI Similarity Search)是一个高效的相似度搜索库,它底层主要基于L2距离(欧几里得距离)进行向量间的相似度计算。L2距离衡量的是多维空间中两点之间的直线距离。
- L2距离的特点:
- 值越小,表示两个向量越相似。
- 当两个向量完全相同时,L2距离为0,这是理论上的最佳匹配。
- L2距离没有上限,但对于单位向量(长度为1的向量),其最大L2距离为2(当两个向量方向完全相反时)。
与L2距离相对的是余弦相似度(Cosine Similarity),它衡量的是两个向量在方向上的接近程度,与向量的长度无关。
- 余弦相似度的特点:
- 值越大,表示两个向量越相似。
- 范围在-1到1之间。
- 1表示方向完全相同(完美匹配)。
- -1表示方向完全相反。
- 0表示相互正交(不相关)。
当嵌入向量被标准化(即归一化为单位向量)后,L2距离和余弦相似度之间存在直接的数学关系: L2_distance^2 = 2 * (1 - cosine_similarity) 这意味着,如果余弦相似度为1.0(完美匹配),则L2距离为0.0。反之,如果L2距离为0.0,则余弦相似度为1.0。
Langchain的FAISS.similarity_search_with_score()方法在与FAISS交互时,其返回的score通常就是FAISS计算出的原始L2距离。因此,当我们期望一个“完美匹配”时,L2距离应趋近于0。
嵌入模型与标准化:BGE与OpenAI的实践
不同的嵌入模型在生成向量时具有各自的特性,这可能会影响到完全相同文本的嵌入向量是否能做到“完美一致”。
案例一:使用BGE模型
考虑使用BAAI/bge-large-zh-v1.5模型作为嵌入器,并设置normalize_embeddings=True进行向量标准化。
from langchain.embeddings import HuggingFaceBgeEmbeddings
from langchain.vectorstores import FAISS
from langchain.docstore.document import Document

# 1. 初始化BGE嵌入模型
model_name = "BAAI/bge-large-zh-v1.5"
model_kwargs = {'device': 'cuda'} # 或 'cpu'
encode_kwargs = {'normalize_embeddings': True} # 设置为True以归一化嵌入向量

bge_model = HuggingFaceBgeEmbeddings(
    model_name=model_name,
    model_kwargs=model_kwargs,
    encode_kwargs=encode_kwargs,
    cache_folder="../model/", # 模型缓存路径
)

# 2. 创建或加载FAISS向量库
# 假设我们已经有一个包含 '无纸化发送失败?' 的FAISS数据库
# 为了演示,我们先创建一个简单的数据库
docs = [Document(page_content='无纸化发送失败?'), Document(page_content='凭证打包失败?')]
# 在实际应用中,db可能从文件加载:db = FAISS.load_local('../dataset/bge_faiss_db', embeddings=bge_model, index_name='index')
db_bge = FAISS.from_documents(docs, bge_model)

# 3. 执行相似度搜索
query = '无纸化发送失败?'
res_bge = db_bge.similarity_search_with_score(query, k=3)

print("BGE模型搜索结果 (L2距离):")
print(res_bge)
预期结果分析: 在上述BGE模型的案例中,即使查询文本与文档内容完全相同,用户观察到的L2距离为0.9069208。这个值对于一个理论上应该为0的完美匹配来说,显得异常高。这可能由以下原因导致:
- 浮点数精度问题: 计算机处理浮点数时存在精度限制。即使文本完全相同,经过复杂的神经网络模型(如BGE)生成向量,再进行浮点运算和存储,最终的向量表示可能存在极其微小的差异,导致L2距离不为0。
- 模型特性: 某些嵌入模型可能在生成完全相同文本的嵌入时,其内部状态或随机性导致了微小的非确定性差异。尽管对于主流模型来说,这通常不是一个显著问题,但不能完全排除。
- Langchain或FAISS的内部处理: 尽管可能性较低,但Langchain的封装或FAISS在处理特定数据类型时,也可能引入微小的数值偏差。
案例二:使用OpenAI模型
作为对比,我们来看使用OpenAI Embeddings时的表现。OpenAI Embeddings在处理相同文本时,通常能保证生成完全相同的向量,从而使得L2距离为0。
from langchain.document_loaders import TextLoader
from langchain.embeddings.openai import OpenAIEmbeddings
from langchain.text_splitter import CharacterTextSplitter
from langchain.vectorstores import FAISS
from langchain.docstore.document import Document

# 1. 初始化OpenAI嵌入模型
# 确保已设置OPENAI_API_KEY环境变量
embeddings_openai = OpenAIEmbeddings()

# 2. 创建一个包含测试文本的FAISS向量库
# 假设我们有一个text.txt文件,内容为 '无纸化发送失败?'
# 为了演示,我们直接创建文档对象
docs_openai = [Document(page_content='无纸化发送失败?')]
db_openai = FAISS.from_documents(docs_openai, embeddings_openai)

# 3. 执行相似度搜索
query_openai = '无纸化发送失败?'
res_openai = db_openai.similarity_search_with_score(query_openai, k=3)

print("\nOpenAI模型搜索结果 (L2距离):")
print(res_openai)

# 4. 尝试一个略微不同的查询
query_openai_slight_diff = '纸化发送失败?'
res_openai_slight_diff = db_openai.similarity_search_with_score(query_openai_slight_diff, k=3)

print("\nOpenAI模型搜索结果 (略微不同查询的L2距离):")
print(res_openai_slight_diff)
预期结果分析: 使用OpenAI Embeddings时,对于完全相同的查询,L2距离通常为0.0。而对于略有差异的查询,L2距离会是一个较小的非零值(例如0.08518691),这符合L2距离的定义和预期行为。
潜在原因与优化建议
从上述对比中可以看出,BGE模型在特定场景下为完全相同的文本返回了非零的L2距离,而OpenAI模型则返回了0.0。这表明问题可能出在BGE模型本身生成的向量的精确度或一致性上。
- FAISS的距离度量: 再次强调,FAISS默认使用L2距离,0代表完美匹配。当similarity_search_with_score返回一个非零值时,它表示的是距离,而不是一个接近1.0的“相似度分数”。
- 嵌入向量的微小差异: 即使是完全相同的文本,在经过嵌入模型处理并存储后,由于浮点数精度、模型内部计算细节(如批处理、并行计算、硬件加速器差异)或序列化/反序列化过程,生成的向量可能存在极其微小的差异。对于BGE模型,这种差异在用户观察到的0.9中体现出来,意味着实际存储的向量与查询向量存在较为明显的L2距离。
- 模型选择的影响: 不同嵌入模型在处理文本生成向量时的稳定性、精度和特性不同。某些模型(如OpenAI Embeddings)在处理完全相同文本时,其生成的向量能确保L2距离为0,表现出更高的“一致性”和鲁棒性。
- 标准化(Normalization)的作用: normalize_embeddings=True确实会将向量归一化为单位向量,这使得L2距离与余弦相似度之间存在数学关系。然而,它并不能完全消除因上述原因导致的微小差异。
优化建议:
- 评估不同嵌入模型: 如果对精确匹配(L2距离为0)有严格要求,建议尝试其他主流的嵌入模型,特别是那些在一致性方面表现良好的模型,如OpenAI Embeddings,或经过广泛验证的其他开源模型(如Sentence-Transformers库中的其他模型)。
- 设置合理的相似度阈值: 鉴于可能存在的非零距离,在实际应用中,不应严格期望L2距离为0。应根据所选模型和实际数据,通过实验确定一个合适的相似度(或距离)阈值。例如,如果L2距离在0到0.1之间都可视为高度相似,那么0.9的距离显然过大,需要进一步排查。但如果0.9是特定模型下“最相似”的距离,则需重新评估阈值。
- 检查数据处理流程: 确保文本在嵌入前后的处理(如编码、去除空白符、大小写转换等)保持一致。任何细微的文本差异都可能导致嵌入向量的不同。
- 模型版本与更新: 确保使用的嵌入模型是最新版本,有时模型更新会修复这类一致性问题。
总结
在Langchain与FAISS进行相似度搜索时,理解FAISS默认使用L2距离至关重要。对于完全相同的文本,理想的L2距离应为0。如果遇到非零距离,尤其是一个相对较大的值(如0.9),这通常不是Langchain或FAISS的错误,而是嵌入模型在处理相同文本时未能生成完全一致的向量,或存在浮点数精度问题。通过尝试不同的嵌入模型,并根据实际情况调整相似度阈值,可以更好地解决这类问题,从而构建出更健壮、更符合预期的向量相似度搜索系统。

了解 Claude Code 的基础交互流程,包括文件生成确认、使用 /compact 管理对话上下文、通过 CLAUDE.md 设定项目规则以及调用技能复用输出格式,提升开发协作效率。

详细介绍在 Visual Studio 2022 中关闭编辑器垂直滚动条代码缩略图(地图模式)的具体操作方法,包含右键快捷路径与全局选项设置,帮助恢复紧凑清晰的传统滚动条。

详细介绍在 Visual Studio 2022 中使用官方 Microsoft Visual Studio Installer Projects 扩展生成 Windows 桌面应用程序安装包(.msi / setup.exe)的完整操作步骤与配置细节。

客观全面评析大地老师的Node.js教程:从技术栈覆盖、实战讲解风格到局限短板与进阶路径,帮助初学者和前端开发者客观评估是否适合自身学习需求。

在为大模型Agent接入外部工具时,是选择MCP的结构化参数定义,还是使用CLI的通用命令入口?本文通过图片筛选与上传的实际案例,分析两种方式在上下文开销、任务组合效率及安全风险上的差异,提供选型参考。
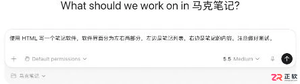
初次接触Codex不知从何下手?本文通过一个具体的HTML笔记应用案例,带你走完从建立项目、输入需求、批准执行到验收结果的完整流程,快速掌握Codex的基础使用方法。
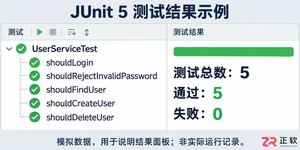
学习如何通过结构化测试、精准断言和参数化设计提升JUnit测试效率,避免常见陷阱,实现高质量、可维护的单元测试代码。
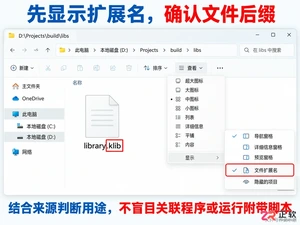
遇到.klib文件打不开?它通常是Kotlin/Native的库文件而非普通文档。本文教你如何在Windows下确认文件来源、安全查看内部结构,以及开发者如何正确使用klib工具,避免误操作。
学习如何在Vue项目中设置文件上传格式限制。本文介绍使用HTML accept属性进行基础过滤,以及结合JavaScript进行严格后缀名校验的方法,确保只允许指定类型的文件被上传。
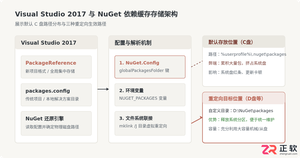
本文详细介绍在Visual Studio 2017中修改NuGet包全局缓存存放路径的实用方案,包括修改全局NuGet.Config文件、配置系统环境变量以及利用NTFS目录联接进行透明迁移,并提供验证与旧缓存清理步骤。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。


Autodesk Maya 是面向影视、电视、动画和游戏行业的专业三维制作软件,集多边形与 NURBS 建模、角色绑定、关键帧和动作捕捉动画、Bifrost 特效模拟、材质开发及 Arnold 渲染于一体,
火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。


