

如何在Go语言中处理分布式大数据任务
如何在Go语言中处理分布式大数据任务引言:随着大数据时代的到来,处理大规模数据的需求也越来越迫切。分布式计算成为了解决大规模数据处理问题的常用方案之一。本文将介绍如何在Go语言中处理分布式大数据任务,并提供具体的代码示例。一、分布式架构的设计与实现1.1任务划分与调度在分布式大数据任务中,常常需要将大任务分解成若干个小任务,并交给多个处理器节点来执行。这需
如何在Go语言中处理分布式大数据任务
引言:
随着大数据时代的到来,处理大规模数据的需求也越来越迫切。分布式计算成为了解决大规模数据处理问题的常用方案之一。本文将介绍如何在Go语言中处理分布式大数据任务,并提供具体的代码示例。
一、分布式架构的设计与实现
1.1 任务划分与调度
在分布式大数据任务中,常常需要将大任务分解成若干个小任务,并交给多个处理器节点来执行。这需要设计一个任务调度器,负责将任务划分和分发。
示例代码如下:
type Task struct {
    ID   int
    Data []byte
}

func main() {
    tasks := []Task{
        {ID: 1, Data: []byte("data1")},
        {ID: 2, Data: []byte("data2")},
        {ID: 3, Data: []byte("data3")},
        // more tasks...
    }

    results := make(chan Task, len(tasks))
    done := make(chan struct{})

    // Create worker goroutines and start processing tasks
    for i := 0; i < runtime.NumCPU(); i++ {
        go func() {
            for task := range tasks {
                result := processTask(task)
                results <- result
            }
        }()
    }

    // Wait for all tasks to be processed
    go func() {
        for i := 0; i < len(tasks); i++ {
            <-results
        }
        close(done)
    }()

    <-done
    close(results)
}

func processTask(task Task) Task {
    // Process the task here...
    // Return the result
    return task
}
1.2 数据分片与存储
对于分布式大数据任务,数据通常也需要进行划分和存储。数据划分可以基于数据的键值、哈希等方式,将数据分成多个片段,并分发给不同的处理器节点。
示例代码如下:
type DataShard struct {
    ShardID int
    Data    []byte
}

func main() {
    data := []DataShard{
        {ShardID: 1, Data: []byte("data1")},
        {ShardID: 2, Data: []byte("data2")},
        {ShardID: 3, Data: []byte("data3")},
        // more data shards...
    }

    results := make(chan DataShard, len(data))
    done := make(chan struct{})

    // Create worker goroutines and start processing data shards
    for i := 0; i < runtime.NumCPU(); i++ {
        go func() {
            for shard := range data {
                result := processDataShard(shard)
                results <- result
            }
        }()
    }

    // Wait for all data shards to be processed
    go func() {
        for i := 0; i < len(data); i++ {
            <-results
        }
        close(done)
    }()

    <-done
    close(results)
}

func processDataShard(shard DataShard) DataShard {
    // Process the data shard here...
    // Return the processed data shard
    return shard
}
二、分布式计算框架与工具
除了手动实现分布式任务的划分、调度和处理,还可以利用一些成熟的分布式计算框架和工具来简化开发。以下是一些在Go语言中常用的分布式计算库和工具。
2.1 Apache Kafka
Apache Kafka是一个分布式流媒体平台,可以用于高吞吐量、分布式、可持久化的日志消息服务。Kafka提供了可靠的消息传输机制,适用于大规模数据的传输和处理。
2.2 Apache Spark
Apache Spark是一个通用的分布式计算引擎,可以用于处理大规模数据集。Spark提供了丰富的API和编程模型,支持多种数据处理方式,如批处理、交互式查询、流式处理等。
2.3 Google Cloud Dataflow
Google Cloud Dataflow是一个基于Apache Beam编程模型的云原生大数据处理服务。Dataflow提供了灵活的分布式数据处理能力,可用于处理批量和流数据。
2.4 Go语言的分布式计算库
除了以上的成熟工具和框架,Go语言本身也提供了一些分布式计算相关的库,如GoRPC、GoFlow等。这些库可以帮助在Go语言中快速实现分布式计算任务。
结论:
在Go语言中处理分布式大数据任务可以通过设计任务划分与调度、数据分片与存储等方式进行,也可以利用成熟的分布式计算框架和工具来简化开发。无论选择何种方式,合理设计和实现分布式架构将大大提高大规模数据处理的效率。
(注:以上代码示例为简化版,实际应用中需要考虑更多细节和错误处理)
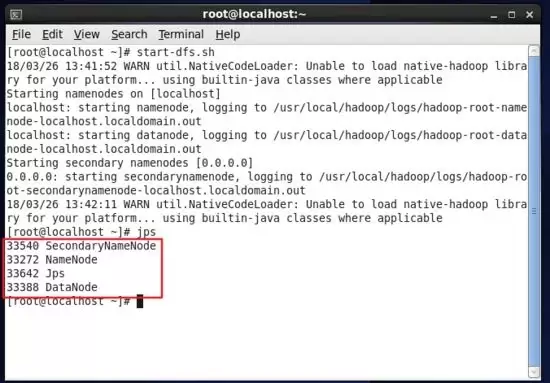
本教程指导大数据分析师在Linux环境中安装Hadoop,通过配置环境变量、验证版本及启动服务,确保Java和Hadoop命令可用。最终利用jps命令检查NameNode等核心进程状态,为后续学习HDFS和Spark打下基础。
麦富迪与达索系统联合举办技术公开日,展示数智化研发系统。通过WarmData大数据中心采集犬猫天性数据,结合达索系统仿真能力,实现配方模拟优化,缩短研发周期,推动宠物食品行业从经验驱动转向数据驱动。
总体原则匹配负载:以工作负载为锚点分配内存。轻量服务(如 Nginx、小型数据库)起步可给1–2 GB;桌面环境或中等负载建议2–4 GB;重负载(多服务/大数据/容器编排)在此基础上按峰值再加余量。始终以“应用需求 + 系统基线”为准,而非拍脑袋给大值。留有余量:宿主机需为自身与后台进程预留充足内
Debian 下 PostgreSQL 数据库迁移方案一、方案总览与选型方案适用场景停机窗口版本/平台要求关键工具主要优点主要限制逻辑导出导入(pg_dump/pg_restore、pg_dumpall)跨版本、跨平台、只迁部分库/表、云上/云下迁移一般为分钟级(取决于数据量)基本无限制,适合升级或
这篇文章我们继续聊分布式相关的内容。提到分布式系统,就一定绕不开“一致性”,这次我们说说:最终一致性。最终一致性是现在大部分高可用的分布式系统的核心思路。估计有人对最终一致性不太熟,先来个简单介绍:最终一致性指的是系统中的所有分散在不同节点的数据,经过一定时间后,最终能够达到符合业务定义的一致的状态
云计算时代,云原生分布式数据库和数据仓库开始崛起,提供弹性扩展、高可用、分布式等特性。数据库将面临怎样的变革?云原生数据库与数据仓库有哪些独特优势?在日前的DTCC 2020大会上,阿里巴巴集团副总裁、阿里云数据库产品事业部总裁、ACM杰出科学家李飞飞就《云原生分布式数据库与数据仓库系统点亮数据上云
FastCFS 是一款基于块存储的通用分布式文件系统,可以作为MySQL、PostgresSQL、Oracle等数据库和云平台的后端存储。 FastDFS已经很受欢迎了,为何还要研发FastCFS呢?FastDFS是轻量级的对象存储,只能通过专有API访问,专为互联网应用设计,适合存放图片、视频、文
随着微服务架构的流行,客户端发起的一次请求可能需要涉及到多个或 N 个服务,致使我们对服务之间的监控和排查变得更加复杂。举个例子:某条业务线的某个接口调用服务端时快时慢,这时就需要排查各个服务的日志进行分析,调动各个服务的开发人员联动排查,这种排查费时又费力。对于 ToB 的业务有时候还拿不到日志,
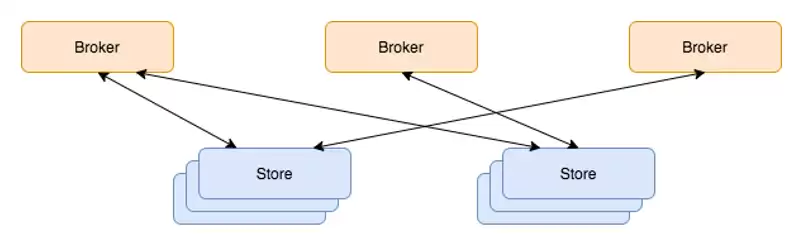
云妹导读:随着互联网的不断发展,大数据高并发不再遥远,是大部分项目都必须具备的能力。其中,消息队列几乎是必备技能。成熟的消息队列工具有很多,本篇文章就来介绍一款京东智联云自研消息队列工具——JCQ。JCQ全名JD Cloud Message Queue,是京东智联云自研,具有CloudNative特
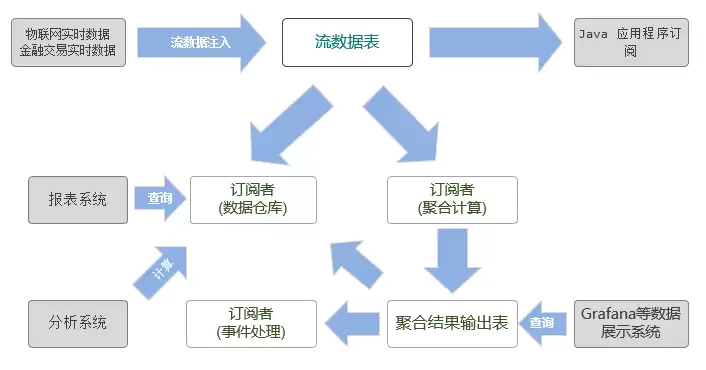
实时流处理一般是将业务系统产生的数据进行实时收集,交由流处理框架进行数据清洗,统计,入库,并可以通过可视化的方式对统计结果进行实时的展示。传统的面向静态数据表的计算引擎无法胜任流数据领域的分析和计算任务。在金融交易、物联网、互联网/移动互联网等应用场景中,复杂的业务需求对大数据处理的实时性提出了更高





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



