

Pandas DataFrame差异行识别与来源追踪教程
本教程详细介绍了如何使用Pandas识别两个DataFrame之间的差异行,并有效追踪这些差异行来源于哪个原始DataFrame。通过利用pd.merge函数的outer连接和indicator=True参数,我们可以生成一个_merge列,明确指示每行的来源(仅左侧、仅右侧或两侧共有)。教程还进一步探讨了如何在需要保留原始索引信息时,通过reset_index方法实现更全面的数据溯源。

识别DataFrame差异行及其来源
在数据分析和数据清洗过程中,我们经常需要比较两个结构相似的Pandas DataFrame,找出它们之间的差异,并了解这些差异行分别来自哪个原始DataFrame。例如,比较当前估计数据与历史估计数据,以识别发生变化的条目。Pandas提供了强大的合并(merge)功能,结合特定的参数,可以高效地完成这项任务。
核心方法:外连接与指示器
要识别两个DataFrame的差异行并追踪其来源,最有效的方法是使用pd.merge函数进行outer(外连接)操作,并设置indicator=True参数。
- how='outer': 外连接会保留左侧DataFrame中独有的行、右侧DataFrame中独有的行,以及两个DataFrame中都存在的匹配行。
- indicator=True: 当设置为True时,pd.merge会在结果DataFrame中添加一个名为_merge的特殊列。这个列会指示每行是来源于左侧DataFrame(left_only)、右侧DataFrame(right_only),还是同时来源于两个DataFrame(both)。
通过过滤_merge列,我们可以轻松地提取出差异行(即_merge不等于'both'的行),并直接获取它们的来源信息。
示例:识别并标记差异行
假设我们有两个DataFrame,df_current_est(当前估计)和df_previous_est(先前估计),它们可能包含相同的列,我们希望找出两者之间不同的行,并标记这些行来自哪个原始DataFrame。
import pandas as pd

# 示例数据
df_current_est = pd.DataFrame({
    'EstimateID': [10061, 10062, 10063],
    'Season': [2023, 2023, 2023],
    'RPIN': ['R1000', 'R2000', 'R3000'],
    'GrowMethodCode': ['FO', 'FO', 'FO'],
    'Variety_code': ['002', '068', '001'],
    'Packout_pc': [0.60, 0.76, 0.80],
    'QtyBins': [320, 1000, 500]
})

df_previous_est = pd.DataFrame({
    'EstimateID': [10061, 10062, 10064],
    'Season': [2023, 2023, 2023],
    'RPIN': ['R1000', 'R2000', 'R4000'],
    'GrowMethodCode': ['FO', 'FO', 'FO'],
    'Variety_code': ['002', '068', '003'],
    'Packout_pc': [0.60, 0.76, 0.90],
    'QtyBins': [9000, 90000, 600] # 注意 QtyBins 差异
})

# 执行外连接并添加指示器
merged_df = pd.merge(df_current_est, df_previous_est, how='outer', indicator=True)

# 筛选出差异行(_merge不为'both'的行)
changed_df = merged_df[merged_df['_merge'] != 'both'].copy()

# 对结果进行排序以便观察
changed_df = changed_df.sort_values(by=['EstimateID', '_merge'], ascending=True)

print("识别出的差异行及其来源:")
print(changed_df)
代码解释:
- pd.merge(df_current_est, df_previous_est, how='outer', indicator=True): 这一步是核心。它将两个DataFrame进行外连接,并生成_merge列。
- changed_df = merged_df[merged_df['_merge'] != 'both'].copy(): 我们通过筛选_merge列来获取所有不完全匹配的行。copy()操作是为了避免SettingWithCopyWarning,确保我们操作的是一个独立的DataFrame。
- changed_df.sort_values(...): 对结果进行排序,便于分析。
输出示例:
识别出的差异行及其来源:
   EstimateID  Season   RPIN GrowMethodCode Variety_code  Packout_pc  QtyBins      _merge
0       10061    2023  R1000             FO          002        0.60      320   left_only
3       10061    2023  R1000             FO          002        0.60     9000  right_only
1       10062    2023  R2000             FO          068        0.76     1000   left_only
4       10062    2023  R2000             FO          068        0.76    90000  right_only
2       10063    2023  R3000             FO          001        0.80      500   left_only
5       10064    2023  R4000             FO          003        0.90      600  right_only
从输出可以看出,_merge列清晰地指示了每行是来自df_current_est(left_only)还是df_previous_est(right_only)。例如,EstimateID为10061的行在两个DataFrame中都有,但QtyBins值不同,因此它们都被标记为差异行,分别指示了各自的来源。
注意事项:不要随意删除_merge列
在获取到包含_merge列的结果后,如果你需要利用该列的信息来判断行的来源,请务必不要将其删除。原始问题中的代码片段就犯了这个错误:
# 错误示例:不应删除_merge列
changed_df.drop('_merge', axis=1, inplace=True)
如果删除了_merge列,你将失去行的来源信息,这与你最初的目标相悖。
处理原始索引的需求
上述方法能够很好地追踪行的来源,但它不会保留原始DataFrame的索引。在某些场景下,你可能不仅关心行来自哪个DataFrame,还需要知道它在原始DataFrame中的具体索引。_merge列并不能保留原始索引信息。
解决方案:将索引转换为普通列
如果需要保留原始索引,你需要在进行merge操作之前,先使用reset_index()方法将每个DataFrame的索引转换为一个普通的数据列。这样,在合并之后,原始索引信息就会作为新的列存在于结果DataFrame中。
import pandas as pd

# 示例数据,包含自定义索引
df1 = pd.DataFrame({'key': ['one', 'two', 'three'], 'value1': [1, 2, 3]},
                   index=[101, 102, 103])
df2 = pd.DataFrame({'key': ['two', 'four', 'three'], 'value2': [20, 40, 30]},
                   index=[201, 202, 203])

print("df1:")
print(df1)
print("\ndf2:")
print(df2)

# 将索引重置为列,然后进行外连接
merged_df_with_index = (
    pd.merge(df1.reset_index(),
             df2.reset_index(),
             on='key',               # 基于'key'列合并
             suffixes=('_df1', '_df2'), # 为重复列添加后缀
             how='outer',
             indicator=True)
    .query('_merge != "both"') # 筛选差异行
)

print("\n带有原始索引的差异行:")
print(merged_df_with_index)
代码解释:
- df1.reset_index() 和 df2.reset_index(): 这一步将每个DataFrame的当前索引转换为一个名为index的列。
- suffixes=('_df1', '_df2'): 由于两个DataFrame都将有一个名为index的列,suffixes参数用于为这些同名列添加后缀,以区分它们来自哪个原始DataFrame(例如,index_df1和index_df2)。
- .query('_merge != "both"'): 这是一个简洁的筛选方式,等同于merged_df_with_index[merged_df_with_index['_merge'] != 'both']。
输出示例:
df1:
     key  value1
101  one       1
102  two       2
103  three     3

df2:
     key  value2
201  two      20
202  four     40
203  three    30

带有原始索引的差异行:
   index_df1   key  value1  index_df2  value2      _merge
0      101.0   one     1.0        NaN     NaN   left_only
3        NaN  four     NaN      202.0    40.0  right_only
现在,结果DataFrame中包含了index_df1和index_df2列,它们分别存储了差异行在df1和df2中的原始索引。对于left_only的行,index_df2为NaN;对于right_only的行,index_df1为NaN。
扩展应用:查找匹配行的最大索引
在某些分析场景中,你可能还需要找出那些在两个DataFrame中都匹配的行(即_merge == "both"),并获取它们在原始DataFrame中的最大索引。这在需要追踪最新版本或最高ID的匹配记录时非常有用。
# 查找匹配行(_merge == "both")的最大索引
max_id_same = (
    pd.merge(df1.reset_index(),
             df2.reset_index(),
             on='key',
             suffixes=('_df1', '_df2'),
             how='outer',
             indicator=True)
    .query('_merge == "both"') # 筛选匹配行
)[['index_df1', 'index_df2']].max() # 选择索引列并取最大值

print("\n匹配行(_merge == \"both\")的最大索引:")
print(max_id_same)
输出示例:
匹配行(_merge == "both")的最大索引:
index_df1    103.0
index_df2    203.0
dtype: float64
这表明在df1中,匹配行的最大索引是103,在df2中是203。
总结
本教程详细阐述了在Pandas中比较两个DataFrame并识别差异行的两种主要场景:
- 仅追踪行来源: 使用pd.merge(how='outer', indicator=True),然后筛选_merge列中不为'both'的行。_merge列将直接指示行是left_only还是right_only。关键是不要删除_merge列。
- 同时追踪行来源和原始索引: 在pd.merge之前,对每个DataFrame使用reset_index()将索引转换为普通列。合并时使用suffixes参数处理同名索引列,然后进行筛选。
掌握这些技术,可以帮助你在数据分析工作中更精确地理解和管理DataFrame之间的变化,从而提高数据处理的效率和准确性。

遇到PHP递归报错时,不要盲目调大max_nesting_level。本文教你区分Xdebug限制、内存耗尽和正则递归错误,提供代码级的终止条件优化与迭代替代方案,彻底解决栈溢出问题。

本文分析PHP递归中static变量导致的状态污染及引用传递引发的共享数据修改问题。提供具体的代码复现、缓存键设计建议及调试打印技巧,帮助开发者避免隐蔽的逻辑错误。

解析PHP递归函数在树形数据处理中的性能瓶颈,提供预加载数据消除I/O、使用显式栈替代深层递归的实战方案,帮助开发者在代码可读性与执行效率间做出合理取舍。
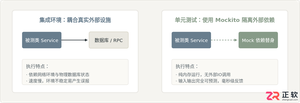
详细讲解在Java单元测试中如何使用Mockito模拟依赖对象,包括引入依赖、创建Mock、打桩返回值、行为验证以及Mock与Spy的核心差异和常见陷阱排查。
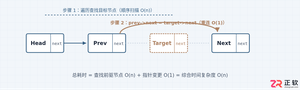
详细分析链表删除节点的时间复杂度,深入探讨单链表与双向链表在不同已知前提下的查找与删除开销,并结合完整代码与清晰图解进行对比总结。
想知道如何让AI写出的代码更贴合你的习惯?本文手把手教你在VS Code中调整Codex相关模型参数,通过修改配置文件优化温度值和令牌限制,解决代码建议不准确或响应慢的问题。
通过实测展示Claude Code在终端中如何理解自然语言指令、自动修改代码文件并处理复杂编程任务,帮助开发者评估其实际辅助能力。
本教程详细讲解如何使用Visual Studio创建WinForms项目,通过添加按钮和标签控件并编写点击事件代码,实现一个基础的计数器功能,适合C#初学者快速上手Windows窗体应用开发。
详解Cursor编辑器中自动补全功能的开启与优化设置,涵盖Tab触发机制、上下文窗口调整及模型切换,帮助开发者解决补全延迟、干扰大等问题,提升编码流畅度。
详解Pandas中数据格式转换的核心方法,包括astype强制转换、to_numeric容错处理及日期解析技巧,解决常见类型错误并提升数据处理效率。




Photoshop 2026 是 Adobe 推出的专业图像处理与视觉设计软件,支持 Windows、macOS 和 iPad 等平台,广泛应用于摄影修图、电商设计、平面海报、数字绘画及视觉合成等创作场景。

Blender 是一款免费开源、跨平台的专业 3D 创作软件,集建模、动画、渲染、视频编辑与视觉合成等功能于一体,广泛应用于影视动画、游戏设计和建筑可视化等领域。软件支持 Cycles 物理渲染器与 Eevee 实时渲染引擎,并提供多边形建模、骨骼绑定、物理模拟等专业工具。Blender 兼容 Windows、macOS 和 Linux 系统,安装包轻巧、运行流畅,依托活跃的全球开发者社区持续更新,是从初学者到专业创作者都值得选择的正版 3D 创作工具。


Photoshop 2026 是 Adobe 推出的专业图像处理与视觉设计软件,支持 Windows、macOS 和 iPad 等平台,广泛应用于摄影修图、电商设计、平面海报、数字绘画及视觉合成等创作场景。
Blender 是一款免费开源、跨平台的专业 3D 创作软件,集建模、动画、渲染、视频编辑与视觉合成等功能于一体,广泛应用于影视动画、游戏设计和建筑可视化等领域。软件支持 Cycles 物理渲染器与 Eevee 实时渲染引擎,并提供多边形建模、骨骼绑定、物理模拟等专业工具。Blender 兼容 Windows、macOS 和 Linux 系统,安装包轻巧、运行流畅,依托活跃的全球开发者社区持续更新,是从初学者到专业创作者都值得选择的正版 3D 创作工具。