

Go语言在大数据处理中的最佳实践和设计模式
大数据处理中的Go语言最佳实践和设计模式导言:随着大数据时代的到来,处理海量数据成为了各行各业的关键挑战。Go语言作为一种高效且并发性能优越的编程语言,被广泛应用于大数据处理领域。本文将探讨在大数据处理中,如何运用Go语言的最佳实践和设计模式,以实现高效可靠的数据处理。一、并行处理在大数据场景中,处理数据的并行性非常重要。Go语言天生支持并发编程,通过gor
大数据处理中的Go语言最佳实践和设计模式
导言:
随着大数据时代的到来,处理海量数据成为了各行各业的关键挑战。Go语言作为一种高效且并发性能优越的编程语言,被广泛应用于大数据处理领域。本文将探讨在大数据处理中,如何运用Go语言的最佳实践和设计模式,以实现高效可靠的数据处理。
一、并行处理
在大数据场景中,处理数据的并行性非常重要。Go语言天生支持并发编程,通过goroutines和channels的特性,我们可以轻松地实现并行处理。
- 使用goroutines进行并发处理
在Go语言中,goroutine是一种轻量级的线程,可以非常方便地并发执行函数。通过使用goroutine,我们可以将任务划分成多个子任务,并发地执行,提高处理数据的效率。
下面是一个简单的示例代码,演示了如何使用goroutines并发地处理数据:
func processData(data []int) {
    var wg sync.WaitGroup
    result := make(chan int)

    for _, d := range data {
        wg.Add(1)
        go func(d int) {
            defer wg.Done()
            r := processDataItem(d)
            result <- r
        }(d)
    }

    go func() {
        wg.Wait()
        close(result)
    }()

    for r := range result {
        fmt.Println(r)
    }
}

func processDataItem(d int) int {
    // 处理单个数据项的逻辑
    return d * 2
}

func main() {
    data := []int{1, 2, 3, 4, 5}
    processData(data)
}在上述例子中,我们将数据切分成多个子任务,并发地执行processDataItem函数,并将结果存入result通道中。通过在主函数中接收并打印通道中的结果,我们实现了对数据的并发处理。
- 利用channels进行数据同步
在并行处理中,经常需要对子任务的执行结果进行汇总或者处理。Go语言提供了channels,用于不同goroutines之间的通信和数据同步。
以下是一个示例代码,展示了如何使用channels来对并发处理的结果进行汇总:
func processData(data []int) {
    var wg sync.WaitGroup
    result := make(chan int)

    for _, d := range data {
        wg.Add(1)
        go func(d int) {
            defer wg.Done()
            r := processDataItem(d)
            result <- r
        }(d)
    }

    go func() {
        wg.Wait()
        close(result)
    }()

    processedData := []int{}
    for r := range result {
        processedData = append(processedData, r)
    }

    // 对processedData的后续处理逻辑
    fmt.Println(processedData)
}

func processDataItem(d int) int {
    // 处理单个数据项的逻辑
    return d * 2
}

func main() {
    data := []int{1, 2, 3, 4, 5}
    processData(data)
}在上述示例中,我们创建了一个通道result,并将每个子任务的处理结果发送到通道中。在主函数中,我们通过从通道中接收数据,将处理后的结果逐个追加到processedData切片中。通过这种方式,我们可以对并发处理的结果进行汇总和后续处理。
二、错误处理和容错机制
在大数据处理中,数据质量和系统的稳定性非常重要。Go语言提供了强大的错误处理机制和容错机制,可以帮助我们保证数据处理的可靠性。
- 错误处理
在Go语言中,错误被视为一种普通的类型。通过返回错误类型,我们可以将错误信息传递给调用者,并指导后续逻辑的处理。
以下是一个简单的示例代码,展示了如何处理错误和返回错误信息:
func processData(data []int) error {
    for _, d := range data {
        if err := processDataItem(d); err != nil {
            return err
        }
    }
    return nil
}

func processDataItem(d int) error {
    // 处理单个数据项的逻辑
    if d > 10 {
        return errors.New("数据项超过阈值")
    }
    return nil
}

func main() {
    data := []int{1, 2, 3, 20, 5}
    if err := processData(data); err != nil {
        fmt.Println("数据处理失败:", err)
    } else {
        fmt.Println("数据处理成功")
    }
}在上述例子中,我们在processDataItem函数中模拟了一个错误情况:当数据项大于10时,返回一个错误。在主函数中,我们使用if err := processData(data); err != nil的方式对错误进行处理,并输出相应的错误信息。
- 容错机制
在大数据处理中,往往需要考虑到系统的灵活性和稳定性。Go语言提供了一系列的机制,用于增强系统的容错能力。
例如,我们可以使用recover关键字来捕获并处理panic异常,确保系统可以继续运行。以下是一个示例代码,展示了如何使用recover进行容错处理:
func processData(data []int) {
    defer func() {
        if r := recover(); r != nil {
            fmt.Println("系统发生错误:", r)
        }
    }()

    for _, d := range data {
        processDataItem(d)
    }
}

func processDataItem(d int) {
    // 处理单个数据项的逻辑
    if d == 0 {
        panic("除零错误")
    }
}

func main() {
    data := []int{1, 2, 0, 4, 5}
    processData(data)
}在上述示例中,我们在processDataItem函数中模拟了一个除零错误的情况,通过使用panic关键字引发一个panic异常。在processData函数中,通过defer关键字配合recover函数,捕获并处理panic异常,输出相应的错误信息。
三、优化性能和资源管理
在大数据处理中,优化性能和合理管理资源是非常重要的。Go语言提供了一些最佳实践和设计模式,可以帮助我们提高系统的性能和高效管理资源。
- 重用对象
在大数据处理中,频繁地创建和销毁对象会带来很大的性能开销。为了提高性能,我们可以利用对象池和对象复用的方式来重用对象。
以下是一个示例代码,展示了如何使用对象池来重用对象:
var dataPool = sync.Pool{
    New: func() interface{} {
        return make([]byte, 1024)
    },
}

func processData(data []byte) {
    newData := dataPool.Get().([]byte)
    copy(newData, data)

    // 处理数据的逻辑

    dataPool.Put(newData)
}

func main() {
    data := make([]byte, 1024)
    processData(data)
}在上述示例中,我们使用sync.Pool来实现了一个对象池dataPool,它负责管理一个可重用的字节数组。在processData函数中,我们通过dataPool.Get()方法从对象池中获取一个可用的字节数组,并在数据处理完成后使用dataPool.Put()方法将它放回对象池中。通过这种方式,我们可以避免重复创建和销毁字节数组,提高了系统的性能。
- 使用内存映射文件
在大数据处理中,对于大量的数据文件,往往需要频繁地读取和写入。为了提高效率和减少内存开销,我们可以使用内存映射文件的方式来处理数据。
以下是一个示例代码,展示了如何使用内存映射文件来处理数据:
func processData(filename string) {
    f, err := os.OpenFile(filename, os.O_RDWR, 0666)
    if err != nil {
        fmt.Println("打开文件失败:", err)
        return
    }
    defer f.Close()

    fileInfo, err := f.Stat()
    if err != nil {
        fmt.Println("获取文件信息失败:", err)
        return
    }

    data, err := mmap.Map(f, mmap.RDWR, 0)
    if err != nil {
        fmt.Println("内存映射文件失败:", err)
        return
    }
    defer data.Unmap()

    // 处理数据的逻辑
    // 可以直接在data中读取和写入数据

    if err := data.Flush(); err != nil {
        fmt.Println("刷新数据到文件失败:", err)
        return
    }

    if err := f.Truncate(fileInfo.Size()); err != nil {
        fmt.Println("截断文件失败:", err)
        return
    }
}

func main() {
    filename := "data.txt"
    processData(filename)
}在上述示例中,我们使用os.OpenFile函数打开文件,并通过mmap.Map函数将文件映射到内存中。通过这种方式,我们可以直接在内存中读取和写入数据,而无需频繁地进行文件IO操作。最后,通过调用data.Flush()方法将数据刷新回文件。
结语:
本文介绍了在大数据处理中使用Go语言的最佳实践和设计模式。通过并行处理、错误处理和容错机制以及性能优化和资源管理,我们可以实现高效可靠的大数据处理系统。希望本文对读者在大数据处理中运用Go语言提供了一些有用的参考和指导。
新手如何从零搭建Go语言开发环境?本文分步详解Go编译器、VS Code编辑器和Git的安装配置,涵盖环境变量设置、插件安装及国内网络加速方案,助你快速入门Go开发。
CentOS系统下,通过SSL(安全套接字层)加密技术,可保障Nginx传输数据的安全性。那么,如何配置Nginx以使用SSL呢?以下是一些最佳实践:获取SSL证书:你可以从Let’s Encrypt免费获取SSL证书,或者购买一个商业证书。使用Certbot工具可以自动化证书的申请和续订过程。安装
在Linux系统上如何优化MongoDB配置一 系统层优化使用XFS 或 ext4文件系统,生产环境更推荐XFS(高并发与元数据性能更好);挂载数据盘时启用noatime/nodiratime减少元数据写入;SSD 建议设置较小的readahead(如32),机械盘可适当增大;避免使用NFS存放数据
在Linux系统下,若要通过Ja vaScript(Node.js)进行日志存储,有以下一些最佳实践可供参考,这些实践能够保障日志得到有效管理与分析:选择合适的日志库:使用流行的日志库,如winston、pino或bunyan,这些库提供了丰富的功能,包括日志级别、格式化、传输和存储。设置日志级别:
在Debian上部署Oracle存储,该如何选择架构?又要如何取舍?优先采用 Oracle ASM 管理数据库存储,按功能划分为两个磁盘组:一个用于 DATA(数据文件、控制文件、在线重做日志等,关键业务可用 HIGH REDUNDANCY 三路镜像),另一个用于 FRA(快速恢复区:归档日志、RM
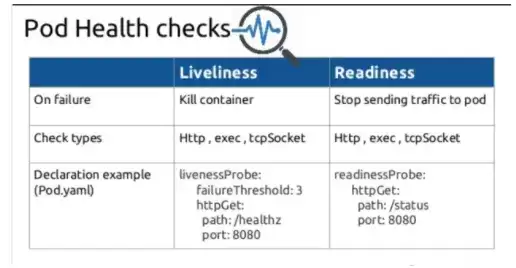
众所周知,Kubernetes很难! 以下是在生产中使用它应遵循的一些最佳实践。遵循这些步骤能够确保更高的安全性和生产效率。毫无疑问,DevOps已经走过了一段很长的路! 借助于Kubernetes编排平台使得公司比以往更快地发布软件。随着容器用于构建和发布软件的使用量不断增加,Kubernetes
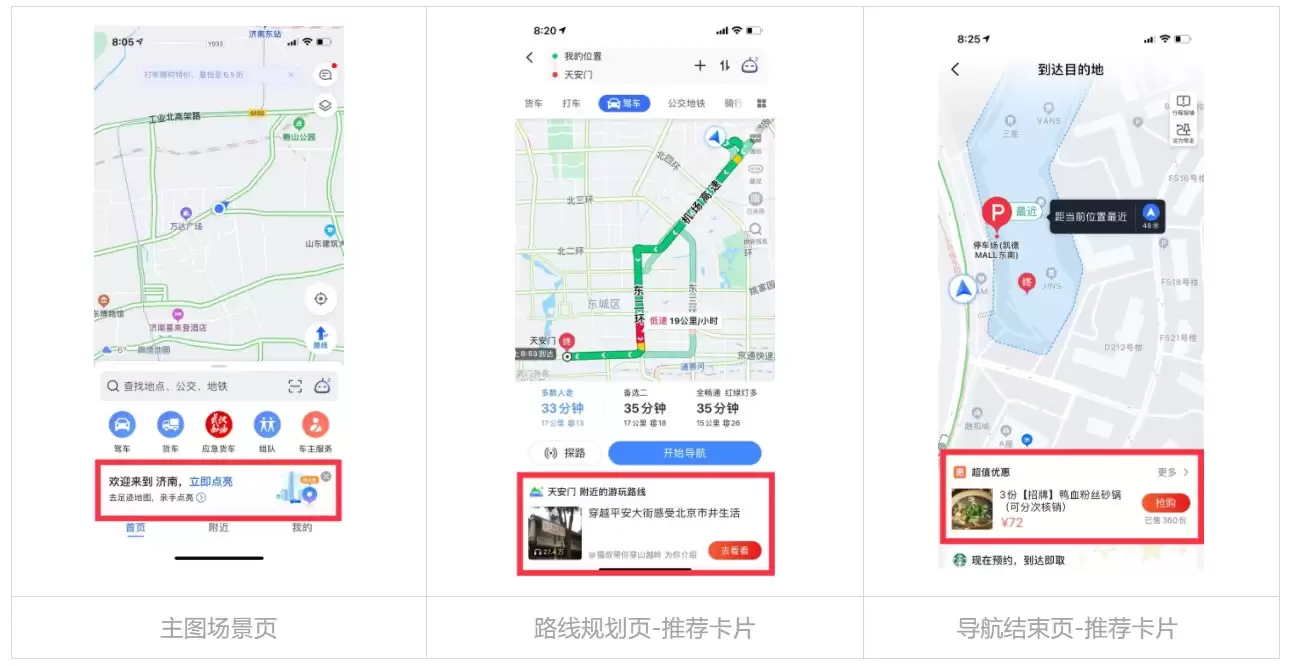
导读:曾经看上去很美、一直被观望的 Serverless,现已逐渐进入落地的阶段。今年的"十一出行节",高德在核心业务规模化落地 Serverless,由 Serverless 支撑的业务在流量高峰期的表现十分优秀。传统应用也能带来同样的体验,那么 Serverless 的差异化价值又是什么呢?本文
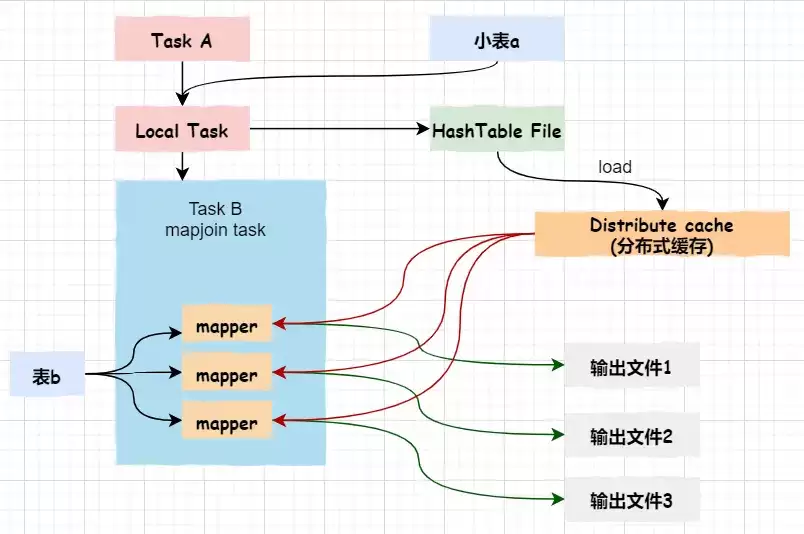
Apache Hive作为一款构建于Apache Hadoop之上的数据仓库软件项目,其作用是实现数据的查询与分析。它在Hadoop的HDFS中充当SQL接口,能够通过类似SQL的接口,对存储于与Hadoop集成的各类数据库及文件系统中的数据进行查询。可以说,对于从事数据开发工作的人员而言,无论是日
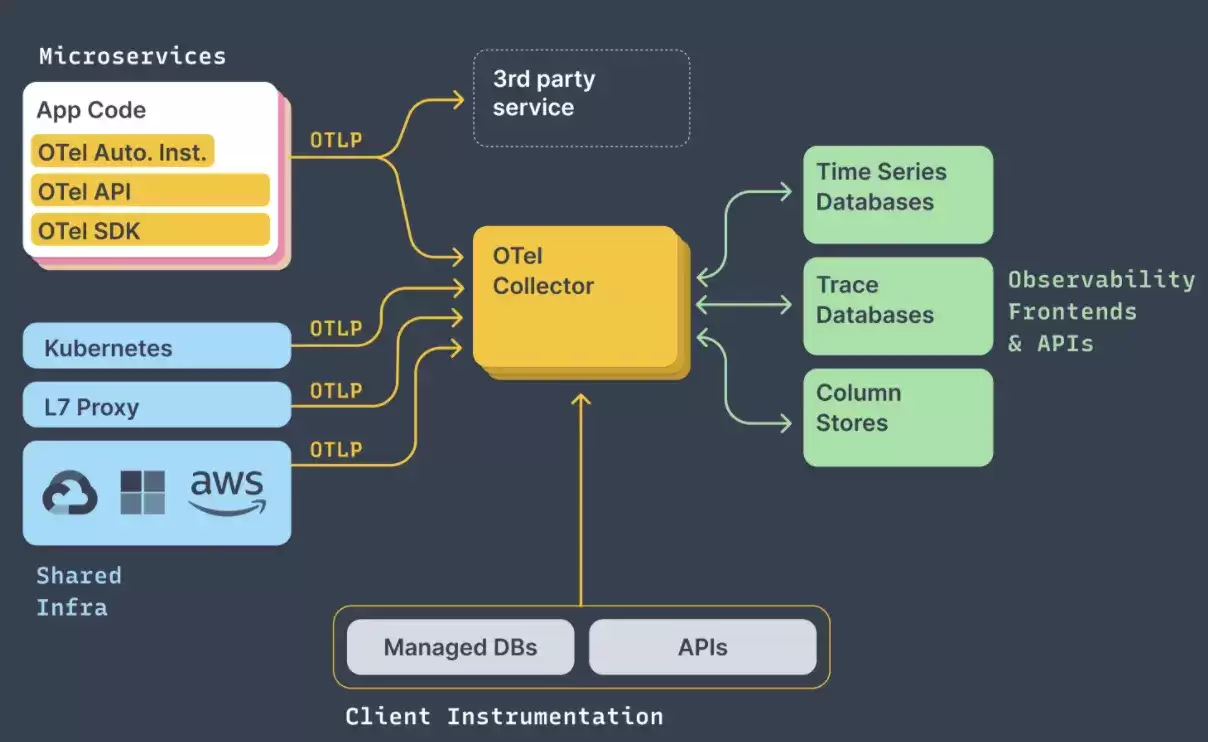
【百度云原生导读】OpenTelemetry 由著名的 OpenTracing、 OpenCensus 两个产品在 2019 年合并而来,拥有广泛的应用场景和强大的开发团队。2021年,OpenTelemetry 的使用成为新的行业规范,通过在各个数据源之间建立一致性,使得数据收集以及处理更加便捷。
OCR软件通过图像预处理、字符识别和后处理将图片文字转为可编辑文本。选择时需关注识别准确率、版面处理及输出格式。预处理可提升质量,识别时应正确设置语言与模式,并善用区域选择。后处理包括校对形近字和整理格式,建立标准化流程与注意数据安全可提高效率。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



