

面试|不可不知的十大Hive调优技巧最佳实践
Apache Hive作为一款构建于Apache Hadoop之上的数据仓库软件项目,其作用是实现数据的查询与分析。它在Hadoop的HDFS中充当SQL接口,能够通过类似SQL的接口,对存储于与Hadoop集成的各类数据库及文件系统中的数据进行查询。可以说,对于从事数据开发工作的人员而言,无论是日
Apache Hive作为一款构建于Apache Hadoop之上的数据仓库软件项目,其作用是实现数据的查询与分析。它在Hadoop的HDFS中充当SQL接口,能够通过类似SQL的接口,对存储于与Hadoop集成的各类数据库及文件系统中的数据进行查询。可以说,对于从事数据开发工作的人员而言,无论是日常工作还是面试环节,Hive都占据着极为重要的地位,特别是在Hive的性能调优方面,不仅能在工作中提高效率,还能在面试中展现出自身的优势。接下来,本文将为大家分享十个性能优化技术。
1.多次INSERT单次扫描表默认情况下,Hive会执行多次表扫描。因此,如果要在某张hive表中执行多个操作,建议使用一次扫描并使用该扫描来执行多个操作。
比如将一张表的数据多次查询出来装载到另外一张表中。如下面的示例,表my_table是一个分区表,分区字段为dt,如果需要在表中查询2个特定的分区日期数据,并将记录装载到2个不同的表中。
INSERT INTO temp_table_20201115 SELECT * FROM my_table WHERE dt ='2020-11-15';
INSERT INTO temp_table_20201116 SELECT * FROM my_table WHERE dt ='2020-11-16';
在以上查询中,Hive将扫描表2次,为了避免这种情况,我们可以使用下面的方式:
FROM my_table
INSERT INTO temp_table_20201115 SELECT * WHERE dt ='2020-11-15'
INSERT INTO temp_table_20201116 SELECT * WHERE dt ='2020-11-16'
这样可以确保只对my_table表执行一次扫描,从而可以大大减少执行的时间和资源。
2.分区表对于一张比较大的表,将其设计成分区表可以提升查询的性能,对于一个特定分区的查询,只会加载对应分区路径的文件数据,因此,当用户使用特定分区列值执行选择查询时,将仅针对该特定分区执行查询,由于将针对较少的数据量进行扫描,所以可以提供更好的性能。值得注意的是,分区字段的选择是影响查询性能的重要因素,尽量避免层级较深的分区,这样会造成太多的子文件夹。
现在问题来了,该使用哪些列进行分区呢?一条基本的法则是:选择低基数属性作为“分区键”,比如“地区”或“日期”等。
一些常见的分区字段可以是:
- 日期或者时间
比如year、month、day或者hour,当表中存在时间或者日期字段时,可以使用些字段。
- 地理位置
比如国家、省份、城市等
- 业务逻辑
比如部门、销售区域、客户等等
CREATE TABLE table_name (
    col1 data_type,
    col2 data_type)
PARTITIONED BY (partition1 data_type, partition2 data_type,….);通常,当很难在列上创建分区时,我们会使用分桶,比如某个经常被筛选的字段,如果将其作为分区字段,会造成大量的分区。在Hive中,会对分桶字段进行哈希,从而提供了中额外的数据结构,进行提升查询效率。
与分区表类似,分桶表的组织方式是将HDFS上的文件分割成多个文件。分桶可以加快数据采样,也可以提升join的性能(join的字段是分桶字段),因为分桶可以确保某个key对应的数据在一个特定的桶内(文件),所以巧妙地选择分桶字段可以大幅度提升join的性能。通常情况下,分桶字段可以选择经常用在过滤操作或者join操作的字段。
我们可以使用set.hive.enforce.bucketing = true启用分桶设置。
当使用分桶表时,最好将bucketmapjoin标志设置为true,具体配置参数为:
SET hive.optimize.bucketmapjoin = true
CREATE TABLE table_name
PARTITIONED BY (partition1 data_type, partition2 data_type,….) CLUSTERED BY (column_name1, column_name2, …)
SORTED BY (column_name [ASC|DESC], …)]
INTO num_buckets BUCKETS;复杂的Hive查询通常会转换为一系列多阶段的MapReduce作业,并且这些作业将由Hive引擎链接起来以完成整个查询。因此,此处的“中间输出”是指上一个MapReduce作业的输出,它将用作下一个MapReduce作业的输入数据。
压缩可以显著减少中间数据量,从而在内部减少了Map和Reduce之间的数据传输量。
我们可以使用以下属性在中间输出上启用压缩。
set hive.exec.compress.intermediate=true;
set hive.intermediate.compression.codec=org.apache.hadoop.io.compress.SnappyCodec;
set hive.intermediate.compression.type=BLOCK;
为了将最终输出到HDFS的数据进行压缩,可以使用以下属性:
set hive.exec.compress.output=true;下面是一些可以使用的压缩编解码器
org.apache.hadoop.io.compress.DefaultCodec
org.apache.hadoop.io.compress.GzipCodec
org.apache.hadoop.io.compress.BZip2Codec
com.hadoop.compression.lzo.LzopCodec
org.apache.hadoop.io.compress.Lz4Codec
org.apache.hadoop.io.compress.SnappyCodecmap端join适用于当一张表很小(可以存在内存中)的情况,即可以将小表加载至内存。Hive从0.7开始支持自动转为map端join,具体配置如下:
SET hive.auto.convert.join=true; --  hivev0.11.0之后默认true
SET hive.mapjoin.smalltable.filesize=600000000; -- 默认 25m
SET hive.auto.convert.join.noconditionaltask=true; -- 默认true,所以不需要指定map join hint
SET hive.auto.convert.join.noconditionaltask.size=10000000; -- 控制加载到内存的表的大小一旦开启map端join配置,Hive会自动检查小表是否大于hive.mapjoin.smalltable.filesize配置的大小,如果大于则转为普通的join,如果小于则转为map端join。
关于map端join的原理,如下图所示:
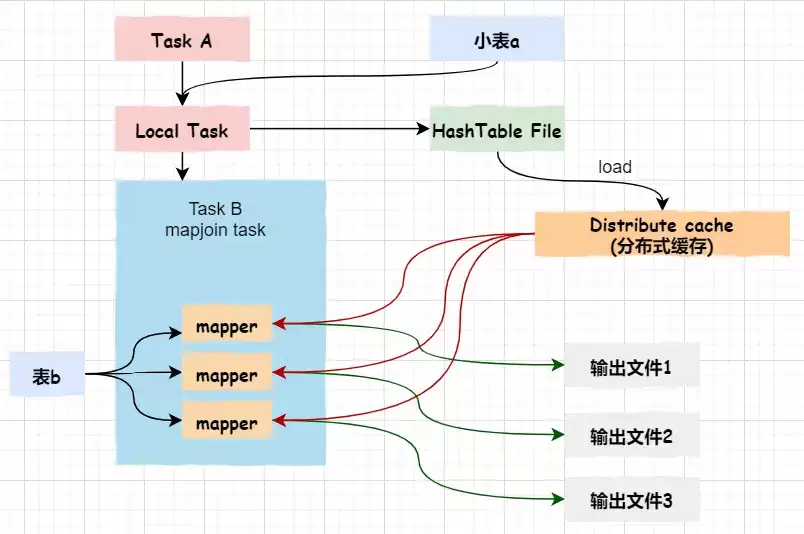
首先,Task A(客户端本地执行的task)负责读取小表a,并将其转成一个HashTable的数据结构,写入到本地文件,之后将其加载至分布式缓存。
然后,Task B任务会启动map任务读取大表b,在Map阶段,根据每条记录与分布式缓存中的a表对应的hashtable关联,并输出结果
注意:map端join没有reduce任务,所以map直接输出结果,即有多少个map任务就会产生多少个结果文件。
6.向量化Hive中的向量化查询执行大大减少了典型查询操作(如扫描,过滤器,聚合和连接)的CPU使用率。
标准查询执行系统一次处理一行,在处理下一行之前,单行数据会被查询中的所有运算符进行处理,导致CPU使用效率非常低。在向量化查询执行中,数据行被批处理在一起(默认=> 1024行),表示为一组列向量。
要使用向量化查询执行,必须以ORC格式(CDH 5)存储数据,并设置以下变量。
SET hive.vectorized.execution.enabled=true在CDH 6中默认启用Hive查询向量化,启用查询向量化后,还可以设置其他属性来调整查询向量化的方式,具体可以参考cloudera官网。
7.谓词下推默认生成的执行计划会在可见的位置执行过滤器,但在某些情况下,某些过滤器表达式可以被推到更接近首次看到此特定数据的运算符的位置。
比如下面的查询:
select
    a.*,
    b.*
from
    a join b on (a.col1 = b.col1)
where a.col1 > 15 and b.col2 > 16
如果没有谓词下推,则在完成JOIN处理之后将执行过滤条件**(a.col1> 15和b.col2> 16)**。因此,在这种情况下,JOIN将首先发生,并且可能产生更多的行,然后在进行过滤操作。
使用谓词下推,这两个谓词**(a.col1> 15和b.col2> 16)**将在JOIN之前被处理,因此它可能会从a和b中过滤掉连接中较早处理的大部分数据行,因此,建议启用谓词下推。
通过将hive.optimize.ppd设置为true可以启用谓词下推。
SET hive.optimize.ppd=trueHive支持TEXTFILE, SEQUENCEFILE, A VRO, RCFILE, ORC,以及PARQUET文件格式,可以通过两种方式指定表的文件格式:
- CREATE TABLE … STORE AS :即在建表时指定文件格式,默认是TEXTFILE
- ALTER TABLE … [PARTITION partition_spec] SET FILEFORMAT :修改具体表的文件格式
如果未指定文件存储格式,则默认使用的是参数hive.default.fileformat设定的格式。
要是数据存于小于块大小的小文件里,SEQUENCE文件格式就能派上用场。而倘若想以优化的方式存储数据,达到减少存储空间并提升性能的目的,那ORC文件格式是个不错的选择。至于Parquet格式,当列中嵌套的数据过多时,它的作用就凸显出来了。所以啊,得依据自身所拥有的数据来确定输入文件格式。
9.启动严格模式如果要查询分区的Hive表,但不提供分区谓词(分区列条件),则在这种情况下,将针对该表的所有分区发出查询,这可能会非常耗时且占用资源。因此,我们将下面的属性定义为strict,以指示在分区表上未提供分区谓词的情况下编译器将引发错误。
SET hive.partition.pruning=strictHive在提交最终执行之前会优化每个查询的逻辑和物理执行计划。基于成本的优化会根据查询成本进行进一步的优化,从而可能产生不同的决策:比如如何决定JOIN的顺序,执行哪种类型的JOIN以及并行度等。
可以通过设置以下参数来启用基于成本的优化。
set hive.cbo.enable=true;
set hive.compute.query.using.stats=true;
set hive.stats.fetch.column.stats=true;
set hive.stats.fetch.partition.stats=true;
可以使用统计信息来优化查询以提高性能。基于成本的优化器(CBO)还使用统计信息来比较查询计划并选择最佳计划。通过查看统计信息而不是运行查询,效率会很高。
收集表的列统计信息:
ANALYZE TABLE mytable COMPUTE STATISTICS FOR COLUMNS;查看my_db数据库中my_table中my_id列的列统计信息:
DESCRIBE FORMATTED my_db.my_table my_id本文主要分享了10个Hive优化的基本技巧,希望能够为你优化Hive查询提供一个基本的思路。再次感谢你的阅读,希望本文对你有所帮助。
END
本文分享自微信公众号 - 大数据技术与数仓(gh_95306769522d)。
如有侵权,请联系 support@oschina.cn 删除。
本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。
CentOS系统下,通过SSL(安全套接字层)加密技术,可保障Nginx传输数据的安全性。那么,如何配置Nginx以使用SSL呢?以下是一些最佳实践:获取SSL证书:你可以从Let’s Encrypt免费获取SSL证书,或者购买一个商业证书。使用Certbot工具可以自动化证书的申请和续订过程。安装
在Linux系统上如何优化MongoDB配置一 系统层优化使用XFS 或 ext4文件系统,生产环境更推荐XFS(高并发与元数据性能更好);挂载数据盘时启用noatime/nodiratime减少元数据写入;SSD 建议设置较小的readahead(如32),机械盘可适当增大;避免使用NFS存放数据
在Linux系统下,若要通过Ja vaScript(Node.js)进行日志存储,有以下一些最佳实践可供参考,这些实践能够保障日志得到有效管理与分析:选择合适的日志库:使用流行的日志库,如winston、pino或bunyan,这些库提供了丰富的功能,包括日志级别、格式化、传输和存储。设置日志级别:
在Debian上部署Oracle存储,该如何选择架构?又要如何取舍?优先采用 Oracle ASM 管理数据库存储,按功能划分为两个磁盘组:一个用于 DATA(数据文件、控制文件、在线重做日志等,关键业务可用 HIGH REDUNDANCY 三路镜像),另一个用于 FRA(快速恢复区:归档日志、RM
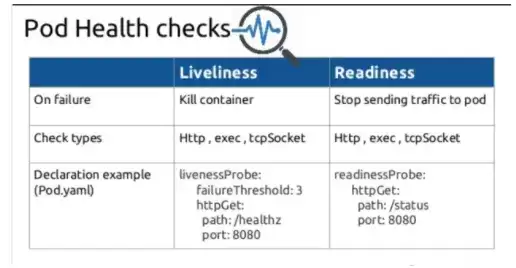
众所周知,Kubernetes很难! 以下是在生产中使用它应遵循的一些最佳实践。遵循这些步骤能够确保更高的安全性和生产效率。毫无疑问,DevOps已经走过了一段很长的路! 借助于Kubernetes编排平台使得公司比以往更快地发布软件。随着容器用于构建和发布软件的使用量不断增加,Kubernetes
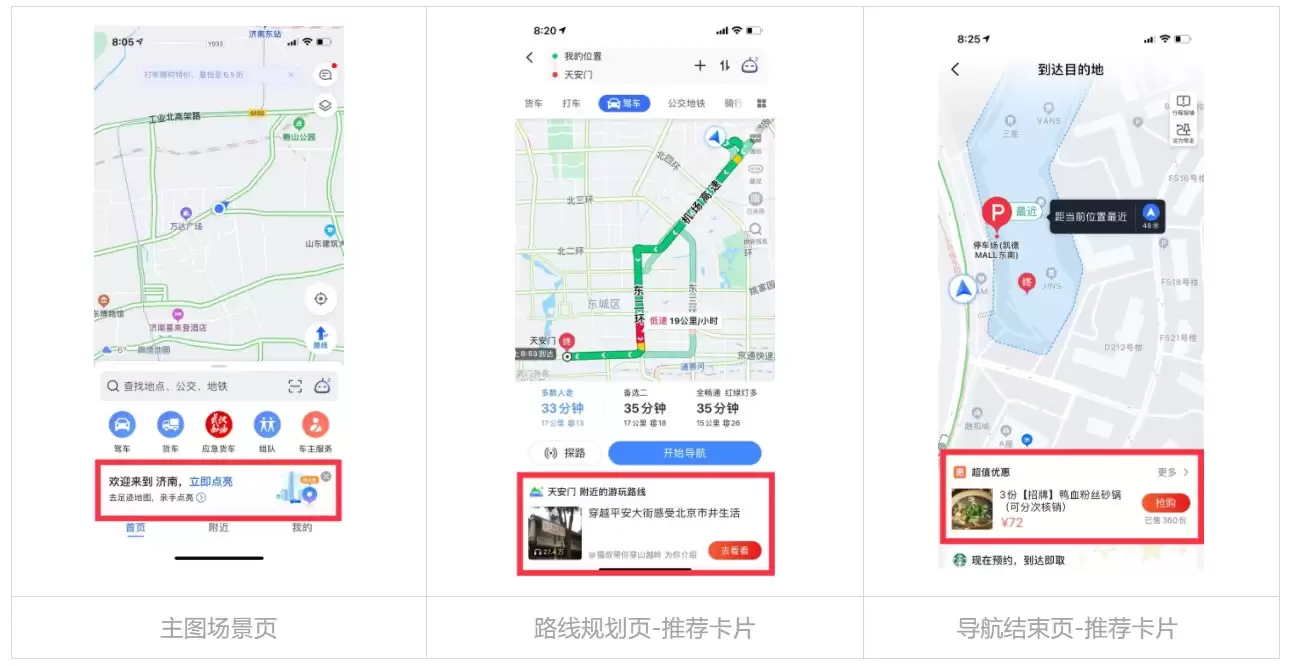
导读:曾经看上去很美、一直被观望的 Serverless,现已逐渐进入落地的阶段。今年的"十一出行节",高德在核心业务规模化落地 Serverless,由 Serverless 支撑的业务在流量高峰期的表现十分优秀。传统应用也能带来同样的体验,那么 Serverless 的差异化价值又是什么呢?本文
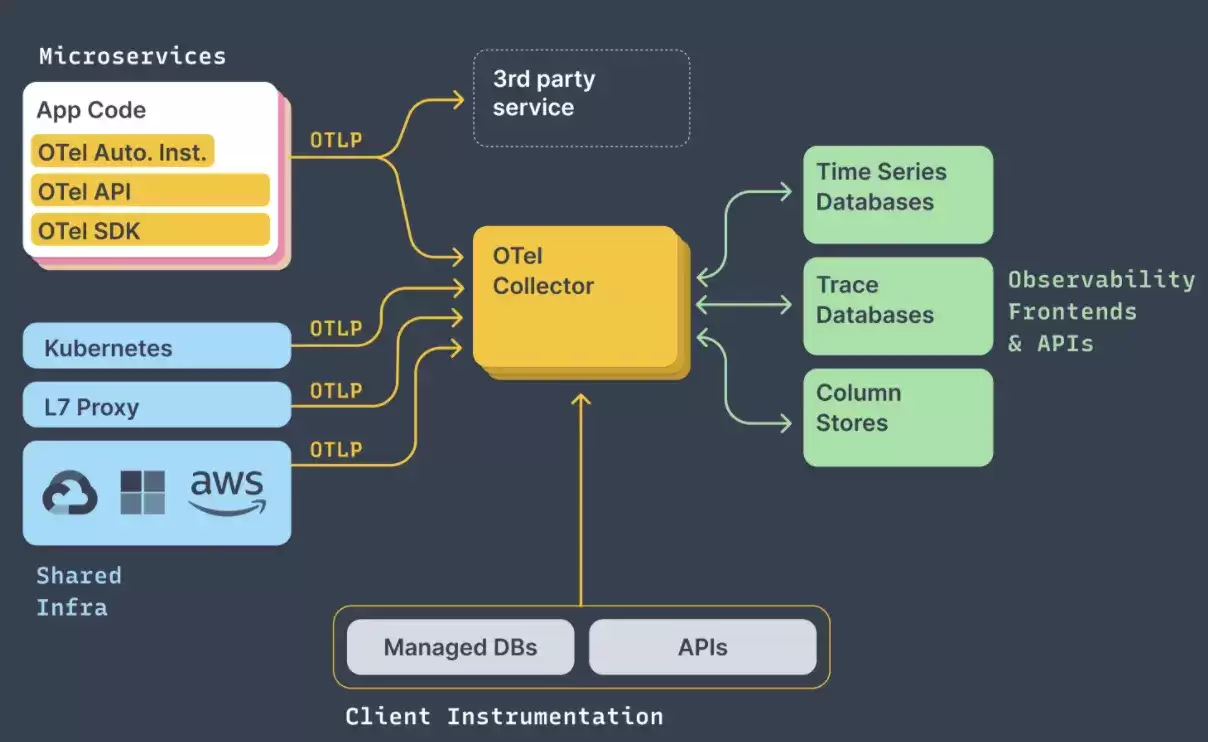
【百度云原生导读】OpenTelemetry 由著名的 OpenTracing、 OpenCensus 两个产品在 2019 年合并而来,拥有广泛的应用场景和强大的开发团队。2021年,OpenTelemetry 的使用成为新的行业规范,通过在各个数据源之间建立一致性,使得数据收集以及处理更加便捷。
OCR软件通过图像预处理、字符识别和后处理将图片文字转为可编辑文本。选择时需关注识别准确率、版面处理及输出格式。预处理可提升质量,识别时应正确设置语言与模式,并善用区域选择。后处理包括校对形近字和整理格式,建立标准化流程与注意数据安全可提高效率。
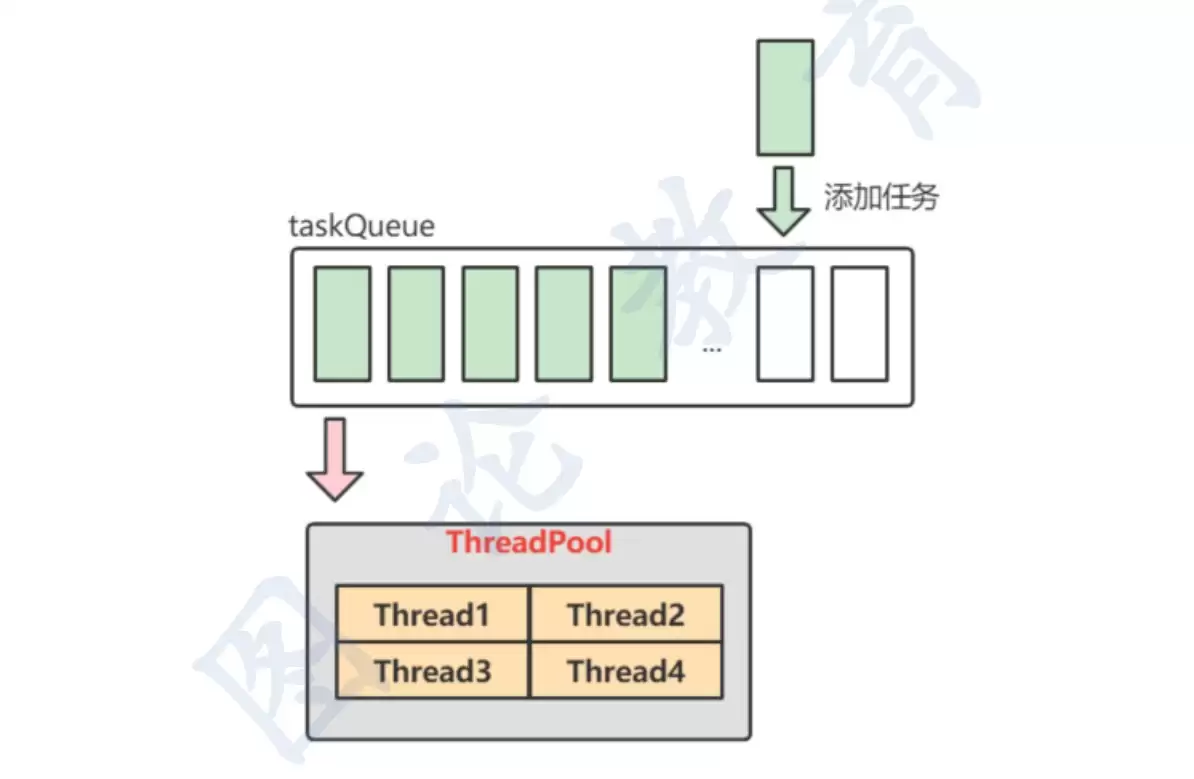
一、线程池概述 1.1 线程池概念 线程池技术其实很简单,就是系统里预先准备好一些线程,等任务来了,直接从池子里分配一个去处理。任务处理完了,线程不销毁,而是还回去,继续服务下一个任务。这样一来,创建和销毁线程的开销就被大大降低了。 线程池的特点: 线程复用:相当于把线程当成一次性餐具变成了可重复使
说白了,如果TP5.1的Controller层直接跟Db::table()玩上了,验证逻辑到处乱塞,业务判断随手一写,那这控制器早就不是控制器了,而是个“缝合怪调度中心”。这样的代码,维护成本会随着迭代翻着跟头往上涨——不是“难维护”,是“根本不敢动”。 一旦在Controller里看到Db::ta





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



