

BigQuery Java客户端查询会话管理技巧
本教程详细介绍了如何在BigQueryJava客户端中创建和重用查询会话,特别适用于需要跨多个查询操作临时表的场景。文章将指导读者如何通过首次查询创建会话并提取其会话ID,进而将该ID应用于后续查询,以确保所有操作在同一会话上下文中执行,从而实现临时表的正确访问和数据一致性。

本教程详细介绍了如何在BigQuery Java客户端中创建和重用查询会话,特别适用于需要跨多个查询操作临时表的场景。文章将指导读者如何通过首次查询创建会话并提取其会话ID,进而将该ID应用于后续查询,以确保所有操作在同一会话上下文中执行,从而实现临时表的正确访问和数据一致性。
BigQuery查询会话概述
BigQuery查询会话提供了一个有状态的、事务性的执行环境,这对于需要跨多个查询保持上下文的场景至关重要。最常见的应用是创建和使用临时表(_SESSION.temp_table_name),这些临时表仅在当前会话的生命周期内有效。在Java客户端中,正确管理和重用会话是实现复杂数据处理流程的关键。
创建会话与定义临时表
要在BigQuery Java客户端中创建新的查询会话并定义一个临时表,您需要在首次执行的查询配置中设置 setCreateSession(true)。此操作将启动一个新的会话,并在该会话中创建您指定的临时表。
以下代码片段展示了如何创建一个会话并定义一个名为 _SESSION.tmp_01 的临时表:
import com.google.cloud.bigquery.*;

public class BigQuerySessionExample {

    public static void main(String[] args) throws InterruptedException {
        BigQuery bigQuery = BigQueryOptions.getDefaultInstance().getService();

        // 步骤1:创建会话并定义临时表
        QueryJobConfiguration createTempTableConfig = QueryJobConfiguration.newBuilder(
                "CREATE TEMP TABLE _SESSION.tmp_01 AS SELECT 1 AS id, 'apple' AS fruit UNION ALL SELECT 2, 'banana'"
        ).setCreateSession(true).build();

        Job createJob = null;
        try {
            createJob = bigQuery.create(JobInfo.of(createTempTableConfig));
            createJob = createJob.waitFor(); // 等待作业完成

            if (createJob.isDone() && createJob.getStatus().getError() == null) {
                System.out.println("临时表 _SESSION.tmp_01 已在新的会话中创建。");
            } else {
                System.err.println("创建临时表或会话时出错: " + (createJob != null ? createJob.getStatus().getError() : "未知错误"));
                return;
            }

            // ... 后续步骤将在此处添加 ...

        } finally {
            // 建议在应用程序生命周期结束时关闭BigQuery客户端,或根据实际情况管理
            // bigQuery.close(); // BigQueryOptions.getDefaultInstance().getService() 返回的实例通常不需要手动关闭
        }
    }
}
提取会话ID以供重用
创建会话后,关键在于如何获取该会话的唯一标识符(sessionId),以便在后续查询中重用它。sessionId 包含在完成的作业统计信息中。您可以通过 JobStatistics.QueryStatistics.getSessionInfo().getSessionId() 方法来提取它。
承接上文代码,我们可以在创建临时表作业成功完成后,立即提取会话ID:
// ... (承接上文代码) ...

        if (createJob.isDone() && createJob.getStatus().getError() == null) {
            System.out.println("临时表 _SESSION.tmp_01 已在新的会话中创建。");

            // 提取会话ID
            JobStatistics.QueryStatistics queryStatistics = createJob.getStatistics();
            String sessionId = queryStatistics.getSessionInfo().getSessionId();
            System.out.println("已成功创建会话,会话ID为: " + sessionId);

            // ... (后续重用会话的查询将在此处添加) ...

        } else {
            System.err.println("创建临时表或会话时出错: " + (createJob != null ? createJob.getStatus().getError() : "未知错误"));
            return;
        }

// ... (承接上文代码) ...
重用会话执行后续查询
一旦获取到 sessionId,您就可以在任何后续需要访问该会话中临时表的查询中,通过 QueryJobConfiguration.setSessionId(sessionId) 方法来指定使用该会话。这样,所有带有相同 sessionId 的查询都将在同一个逻辑会话上下文中执行,从而能够正确访问会话中定义的临时表。
以下代码片段展示了如何使用之前提取的 sessionId 来查询 _SESSION.tmp_01 临时表:
// ... (承接上文代码) ...

            // 提取会话ID
            JobStatistics.QueryStatistics queryStatistics = createJob.getStatistics();
            String sessionId = queryStatistics.getSessionInfo().getSessionId();
            System.out.println("已成功创建会话,会话ID为: " + sessionId);

            // 步骤2:重用会话ID执行后续查询
            QueryJobConfiguration reuseSessionConfig = QueryJobConfiguration.newBuilder(
                    "SELECT * FROM _SESSION.tmp_01 WHERE id = 1"
            ).setSessionId(sessionId).build(); // 使用提取的会话ID

            Job reuseJob = bigQuery.create(JobInfo.of(reuseSessionConfig));
            reuseJob = reuseJob.waitFor(); // 等待作业完成

            if (reuseJob.isDone() && reuseJob.getStatus().getError() == null) {
                System.out.println("\n成功在同一会话中查询临时表。查询结果:");
                // 获取查询结果
                TableResult result = bigQuery.query(reuseSessionConfig);
                result.iterateAll().forEach(row -> {
                    System.out.println("ID: " + row.get("id").getLongValue() + ", Fruit: " + row.get("fruit").getStringValue());
                });
            } else {
                System.err.println("重用会话查询时出错: " + (reuseJob != null ? reuseJob.getStatus().getError() : "未知错误"));
            }

// ... (承接上文代码) ...
完整示例代码
将上述所有步骤整合,以下是一个完整的BigQuery Java客户端会话管理示例:
import com.google.cloud.bigquery.*;

public class BigQuerySessionManager {

    public static void main(String[] args) throws InterruptedException {
        // 初始化BigQuery客户端
        // BigQueryOptions.getDefaultInstance().getService() 会使用默认凭据(如应用程序默认凭据)
        BigQuery bigQuery = BigQueryOptions.getDefaultInstance().getService();

        String sessionId = null; // 用于存储会话ID

        try {
            // 步骤1:创建会话并定义临时表
            System.out.println("--- 步骤1:创建会话和临时表 ---");
            QueryJobConfiguration createTempTableConfig = QueryJobConfiguration.newBuilder(
                    "CREATE TEMP TABLE _SESSION.tmp_01 AS SELECT 1 AS id, 'apple' AS fruit UNION ALL SELECT 2, 'banana' UNION ALL SELECT 3, 'orange'"
            ).setCreateSession(true).build();

            Job createJob = bigQuery.create(JobInfo.of(createTempTableConfig));
            createJob = createJob.waitFor(); // 等待作业完成

            if (createJob.isDone() && createJob.getStatus().getError() == null) {
                System.out.println("临时表 _SESSION.tmp_01 已在新的会话中成功创建。");

                // 提取会话ID
                JobStatistics.QueryStatistics queryStatistics = createJob.getStatistics();
                sessionId = queryStatistics.getSessionInfo().getSessionId();
                System.out.println("已成功创建会话,会话ID为: " + sessionId);

            } else {
                System.err.println("创建临时表或会话时出错: " + (createJob != null ? createJob.getStatus().getError() : "未知错误"));
                return; // 如果第一步失败,则退出
            }

            // 步骤2:重用会话ID执行后续查询
            if (sessionId != null) {
                System.out.println("\n--- 步骤2:重用会话查询临时表 ---");
                QueryJobConfiguration reuseSessionConfig = QueryJobConfiguration.newBuilder(
                        "SELECT * FROM _SESSION.tmp_01 WHERE id = 2"
                ).setSessionId(sessionId).build(); // 使用提取的会话ID

                Job reuseJob = bigQuery.create(JobInfo.of(reuseSessionConfig));
                reuseJob = reuseJob.waitFor(); // 等待作业完成

                if (reuseJob.isDone() && reuseJob.getStatus().getError() == null) {
                    System.out.println("成功在同一会话中查询临时表。查询结果:");
                    TableResult result = bigQuery.query(reuseSessionConfig);
                    result.iterateAll().forEach(row -> {
                        System.out.println("ID: " + row.get("id").getLongValue() + ", Fruit: " + row.get("fruit").getStringValue());
                    });
                } else {
                    System.err.println("重用会话查询时出错: " + (reuseJob != null ? reuseJob.getStatus().getError() : "未知错误"));
                }
            }

        } catch (BigQueryException e) {
            System.err.println("BigQuery操作异常: " + e.getMessage());
        } catch (InterruptedException e) {
            System.err.println("作业等待中断: " + e.getMessage());
            Thread.currentThread().interrupt();
        } finally {
            System.out.println("\n--- 示例执行完毕 ---");
            // 在实际应用中,您可能需要更精细的资源管理策略
            // 对于通过 BigQueryOptions.getDefaultInstance().getService() 获取的客户端,通常不需要手动关闭。
        }
    }
}
注意事项
- 会话生命周期: BigQuery 会话默认持续 30 分钟。超过此时间,会话将自动终止,所有会话临时表也会被删除。请确保您的所有会话相关操作都在此生命周期内完成。
- 错误处理: 在实际应用中,务必对 Job 对象进行详细的状态检查和错误处理,以应对可能出现的网络问题、权限不足或查询语法错误等情况。
- 资源管理: 尽管 BigQueryOptions.getDefaultInstance().getService() 返回的客户端实例通常不需要手动关闭,但在某些特定场景下(例如,您直接创建了 BigQuery 客户端实例),可能需要考虑在应用程序结束时关闭客户端以释放资源。
- 临时表与永久表: 会话临时表适用于短期的、即时的数据处理需求。对于需要长期存储或跨会话访问的数据,应使用标准的BigQuery表。
- 并发性: 每个会话是独立的。不同会话之间无法共享临时表,这意味着每个需要访问临时表的客户端实例或线程都需要管理自己的会话ID。
总结
通过在BigQuery Java客户端中正确创建和重用查询会话,您可以有效地管理有状态的查询上下文,尤其是在处理需要跨多个查询操作临时表的场景时。核心步骤包括:在首次查询中设置 setCreateSession(true) 来创建会话并定义临时表,然后从该查询的作业统计信息中提取 sessionId,最后在所有后续查询中通过 setSessionId(sessionId) 来重用该会话。遵循这些指导原则,将有助于您构建更健壮和高效的BigQuery数据处理应用程序。
chat-demo v0.1.1可以作为静态聊天客户端在本地运行,但模型、搜索、文件和语音能力仍由DeepSeek API提供。源码运行环境为Node.js 22.12及以上、Git与pnpm。Demo版本号不等于应用API版本;这套应用API未单独标版本,默认聊天模型ID是deepseek-flash。
理解GitHub Copilot CLI v1.0.111的高级请求百分比、用户提示活动图与实际路由模型窗口,区分显示口径和任务状态。
按维护分支、利用权限与节点类型对应四项修复,区分正式补丁、Beta和临时缓解的适用边界。

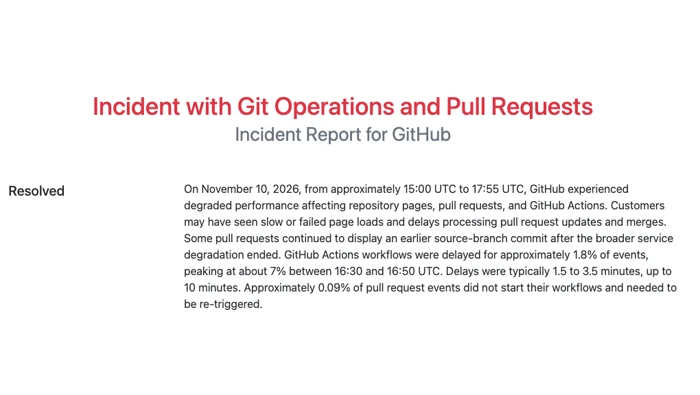
GitHub合并故障中的“已缓解并监控”和“已解决”不能互换。前者表示影响已经采取措施缓解,仍在观察稳定性;后者是供应商正式结束这场事故的状态。11月13日的Pull Requests合并超时事件先进入监控,随后于北京时间11月14日02:29标记为已解决。
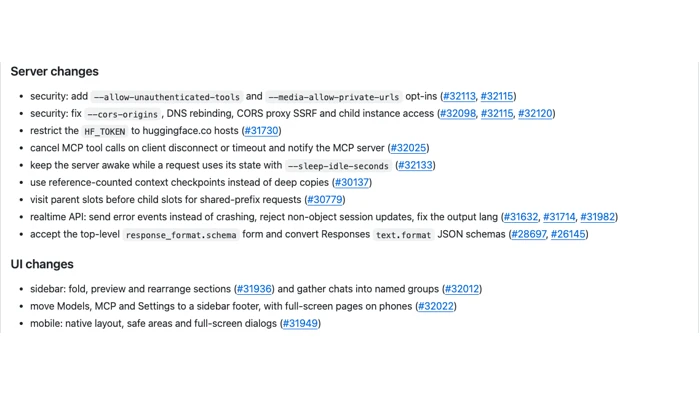
llama.cpp v1.0.0改善聊天组织、长消息编辑和附件预览;界面变化与底层API迁移、缓存及访问边界需要分别理解。
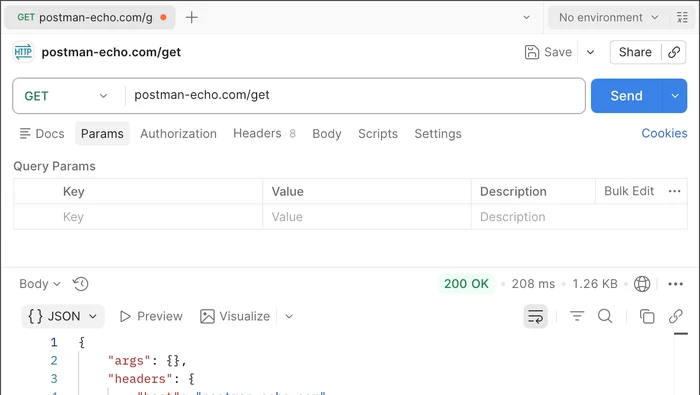
Postman 12.36.4 更新后仍有异常时,可按应用、API请求和平台服务区分问题范围,避免把补丁版本当作故障原因。
按正式、预发布和1.x维护渠道对应补丁,再结合Redis、Agent端点和Pinecone索引判断适用范围。
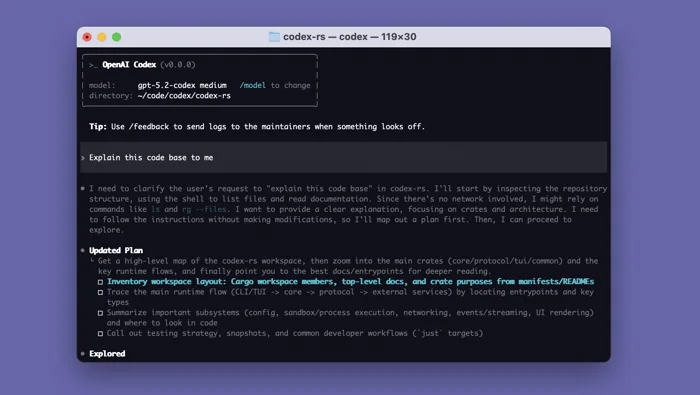
Codex CLI 0.169.0提供有明确说明的终端工作区能力;0.171.0-alpha.2为预发布,当前没有功能清单,选用时应分开评估。
llama.cpp b12345的预发布构建为Hexagon HTP后端增加Q5_0和Q5_1支持。选择模型时需要核对完整量化名称及实际运行后端,不能只看到“Q5”就视为同一种格式。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



