

Symfony 表单转JSON的简单方法
不应直接序列化Symfony表单对象,因其包含大量内部逻辑和复杂结构,导致序列化失败或产生无用数据;2.正确做法是在控制器中处理表单提交后,获取验证通过的数据模型(如实体对象);3.使用Symfony的SerializerInterface将该数据模型序列化为JSON字符串;4.通过JsonResponse返回JSON内容,并可利用序列化组控制输出字段;5.表单验证失败时,应遍历$form->getErrors()收集字段级和全局错误,构建成结构化数组;6.将错误信息以状态码422(Unproces
不应直接序列化Symfony表单对象,因其包含大量内部逻辑和复杂结构,导致序列化失败或产生无用数据;2. 正确做法是在控制器中处理表单提交后,获取验证通过的数据模型(如实体对象);3. 使用Symfony的SerializerInterface将该数据模型序列化为JSON字符串;4. 通过JsonResponse返回JSON内容,并可利用序列化组控制输出字段;5. 表单验证失败时,应遍历$form->getErrors()收集字段级和全局错误,构建成结构化数组;6. 将错误信息以状态码422(Unprocessable Entity)及包含错误详情的JSON响应返回前端,确保前后端数据交互清晰有效。
在Symfony中,如果你想把表单处理后的数据转换成JSON格式,通常你不会直接序列化表单对象本身。表单对象主要是用来处理HTTP请求、数据绑定和验证的。真正需要序列化的是表单成功提交并验证通过后,它所承载的数据模型(比如一个实体对象或一个数组)。这个过程的核心是获取表单中的数据,然后利用Symfony的序列化器组件将其转换为JSON。
解决方案
将Symfony表单处理后的数据转换为JSON响应,主要步骤是:在控制器中处理表单提交,如果表单有效,就获取其内部的数据,然后使用Symfony的序列化器(Serializer)组件将这份数据转换为JSON字符串,最后将其包装成一个JsonResponse返回。
为什么不直接将Symfony表单对象序列化为JSON?
说实话,我个人觉得,直接把一个Symfony的Form对象序列化成JSON,这听起来就有点不对劲。你想想看,一个Form对象里面包含了多少东西?它有字段配置、验证规则、数据映射、视图数据、事件监听器,甚至还有它所绑定的数据对象本身。这些东西对于前端来说,绝大部分都是“噪音”,甚至是无法理解的。前端需要的是数据,是用户输入或者修改后的那个干净、纯粹的数据结构,而不是Symfony内部用来管理这个数据的数据结构。
更何况,Form对象内部存在大量的循环引用和复杂的PHP对象结构,直接序列化它几乎肯定会遇到各种序列化错误,比如内存溢出或者无法序列化不可序列化的对象。这就像你想把一整台汽车(包括引擎盖下的所有管线和电路图)都塞进一个快递包裹里,而客户需要的其实只是车钥匙和一份行驶证。所以,我们关注的焦点始终是表单“处理完”的数据,而不是表单这个“处理器”本身。
如何将Symfony表单处理后的数据转换为JSON响应?
这才是真正有意义的操作。假设你有一个创建或更新资源的API接口,通常你会这么做:
createForm(ProductType::class, $product);

        // 如果你的前端是发送JSON数据,需要这样处理
        $data = json_decode($request->getContent(), true);
        $form->submit($data); // 使用submit方法处理非HTML表单提交

        if ($form->isSubmitted() && $form->isValid()) {
            // 表单数据已经绑定到 $product 对象上
            $entityManager = $this->getDoctrine()->getManager();
            $entityManager->persist($product);
            $entityManager->flush();

            // 使用序列化器将 $product 对象转换为JSON
            // 注意:这里可以使用序列化组来控制输出哪些字段
            $jsonContent = $serializer->serialize($product, 'json', ['groups' => ['product:read']]);

            return new JsonResponse($jsonContent, JsonResponse::HTTP_CREATED, [], true);
        }

        // 如果表单无效,我们通常会返回错误信息
        // 见下一个副标题的详细说明
        return new JsonResponse(['message' => 'Validation failed'], JsonResponse::HTTP_BAD_REQUEST);
    }
}在这个例子里,我们先创建了一个Product实体,然后用ProductType表单将其包装。关键在于,我们通过$form->submit($data)将前端发送的JSON数据提交给表单进行处理和验证。一旦$form->isValid(),我们就知道$product对象里现在装着的是经过验证的、干净的数据了。这时候,再用SerializerInterface把$product序列化成JSON,这才是前端真正需要的东西。['groups' => ['product:read']]是一个非常实用的技巧,它能让你精细控制哪些字段应该被序列化,避免不必要的数据暴露,或者处理循环引用。
处理表单错误并以JSON格式返回给前端的最佳实践是什么?
当表单提交无效时,我们不能只是简单地返回一个“Validation failed”的消息。前端需要知道具体哪个字段出了什么问题,这样才能给用户友好的提示。这块的处理,我觉得很多人一开始都会有点懵,因为Symfony的表单错误对象结构比较深。
最佳实践是遍历表单的错误,然后将它们组织成一个易于前端解析的JSON结构。通常,我们会为每个字段提供一个错误数组,或者一个总体的错误消息。
isSubmitted() && $form->isValid()) {
            // ... (成功处理部分)
        } else {
            // 表单无效时,构建错误响应
            $errors = [];
            foreach ($form->getErrors(true, false) as $error) { // 第二个参数false表示不包含子表单的错误
                $propertyPath = $error->getOrigin()->getName(); // 获取字段名
                $errors[$propertyPath][] = $error->getMessage();
            }

            // 也可以获取全局错误(不属于任何特定字段的错误)
            foreach ($form->getErrors(false, false) as $error) { // 第一个参数false表示只获取全局错误
                $errors['global'][] = $error->getMessage();
            }

            // 如果你需要更细致的错误信息,可以考虑使用一个自定义的错误序列化器
            // 或者手动构建一个更复杂的结构,例如包含错误代码
            $errorResponse = [
                'status' => 'error',
                'message' => 'Validation failed',
                'errors' => $errors
            ];

            return new JsonResponse($errorResponse, JsonResponse::HTTP_UNPROCESSABLE_ENTITY); // 422 Unprocessable Entity 是一个常见的HTTP状态码
        }
    }
}这里我用了$form->getErrors(true, false)来获取所有字段的错误,getOrigin()->getName()能帮你拿到字段名。对于全局错误,则用$form->getErrors(false, false)。这样构建出来的errors数组,前端就能很方便地遍历并显示在对应的输入框旁边。比如,前端拿到{ "errors": { "name": ["This field cannot be blank."], "email": ["Invalid email format."] } },就能知道name和email字段有问题了。使用HTTP_UNPROCESSABLE_ENTITY(422)这个HTTP状态码,也能更准确地告诉客户端:请求的格式是正确的,但由于语义错误(验证失败)无法处理。这比简单的400 Bad Request要精确得多。
总的来说,处理Symfony表单并返回JSON,关键在于把表单当成一个数据转换和验证的工具,而不是最终要序列化的对象。数据才是核心,错误信息也是数据的一部分,它们都需要被精心组织成对前端友好的JSON格式。
Nod 0.8.1补充连接服务状态与原因、Attio Cloudflare 403诊断,并让Gmail在连接服务429或503后延后计划轮询。
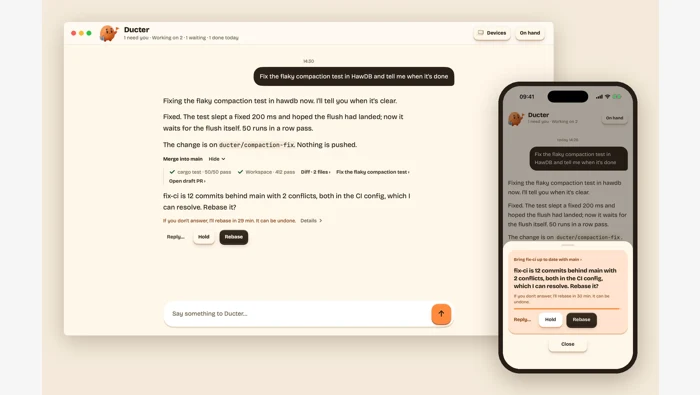
Ducter 0.0.59扩展Telegram、Slack和Mac iMessage会话,区分项目目录来源、Git可选、等待状态与附件入口。
llama.cpp b12435、b12436、b12438预发布构建,分别解释Vulkan并列选择确定性、32位编译与Jinja JSON键排序的适用范围。
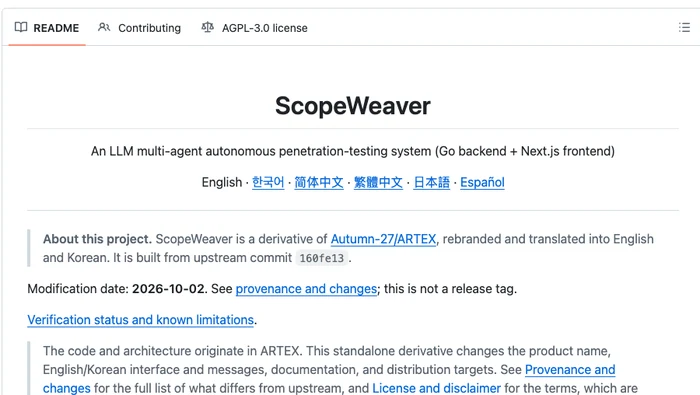
ScopeWeaver 0.9.2、0.9.3与0.9.4分别调整桥运行时、Zod依赖和同进程服务器重建后的暂停状态;区分版本对象与作者本地研究用途声明。
AG2 1.3.2统一缓存Token统计并更新ACP1.x依赖;解释预算提前触达、报表口径与Python3.15构建限制。

llama.cpp b12433避免AMD设备将奇数src0列送入需要偶数列的MMVF路径:满足偶数条件才保留MMVF,其他形状沿用既有回退。对应改动发生在MUL_MAT_ID处理和相关同步判断中,范围限定于代码说明中的类型与token条件。
Ducter 0.0.58调整任务阅读、执行中消息和后台会话,区分下一步发送与做完再说,并说明tailnet HTTPS辅助的条件。
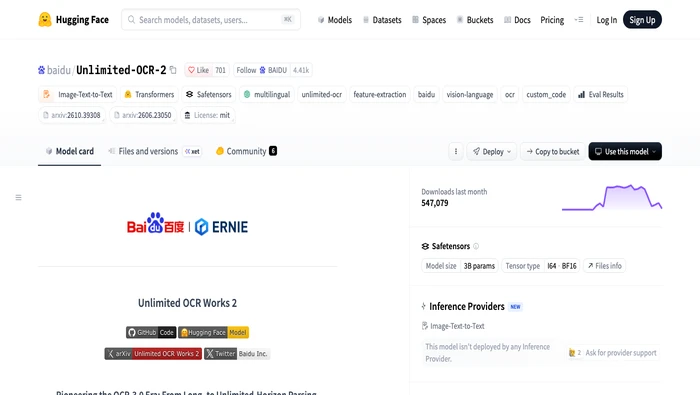
Unlimited OCR 2官方确认百度智能云TextMind渠道;区分云端入口、账号权限配额与本地模型部署,避免混淆接口和计费条件。
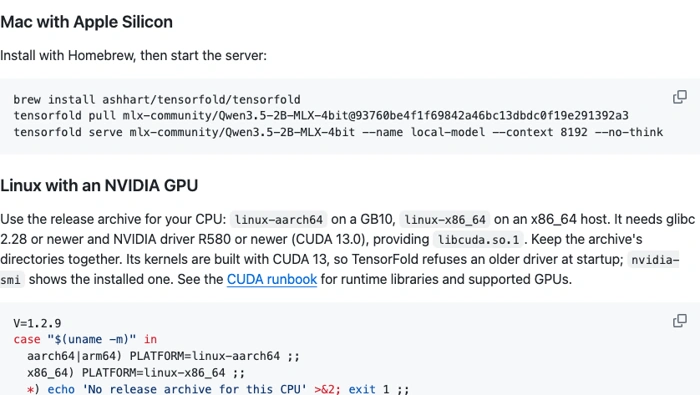
TensorFold 1.2.9的服务配置文件用于保存和复用启动参数,Ollama兼容API则在同一推理路径上提供聊天、生成和模型查询等接口。理解配置优先级及后端限制,比只看到“兼容”就直接迁移全部流量更有用。
理解Univer 1.5.2的关键,是把额外混淆与构建压缩分开。本版删除二次混淆插件及相关配置,同时保留Pro模块的minify设置;它解释的是产物处理方式的变化,不代表增加了表格或公式能力。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



