

Java线性与二分搜索算法详解
本教程详细介绍了如何在Java中实现线性搜索和二分搜索算法。文章涵盖了两种搜索方法的原理、代码实现细节、关键优化点,以及如何构建一个清晰的测试框架来验证这些算法的正确性,强调了代码规范和测试最佳实践。

本教程详细介绍了如何在Java中实现线性搜索和二分搜索算法。文章涵盖了两种搜索方法的原理、代码实现细节、关键优化点,以及如何构建一个清晰的测试框架来验证这些算法的正确性,强调了代码规范和测试最佳实践。
1. 引言:理解搜索算法
在计算机科学中,搜索算法是用于在数据结构中查找特定元素的算法。本教程将重点介绍两种基础且常用的搜索算法:线性搜索(Linear Search)和二分搜索(Binary Search)。理解它们的原理、实现方式以及适用场景,对于编写高效的代码至关重要。
1.1 线性搜索 (Linear Search)
线性搜索,顾名思义,是一种逐个遍历数据集合的搜索方法。它从数组的第一个元素开始,依次与目标值进行比较,直到找到匹配的元素或遍历完整个数组。
- 优点:实现简单,适用于任何类型的数组(无论是否排序)。
- 缺点:效率较低,时间复杂度为O(n),对于大型数据集性能不佳。
1.2 二分搜索 (Binary Search)
二分搜索是一种更高效的搜索算法,但它有一个严格的前提条件:数据集合必须是已排序的。其基本思想是每次将搜索区间减半。它首先检查数组的中间元素,如果中间元素是目标值,则搜索结束;如果目标值小于中间元素,则在左半部分继续搜索;如果目标值大于中间元素,则在右半部分继续搜索。
- 优点:效率高,时间复杂度为O(log n),对于大型数据集性能优越。
- 缺点:要求数据集合必须是已排序的。
2. 核心实现:Search 类
我们将创建一个名为 Search 的类,其中包含 linearSearch 和 binarySearch 两个方法,用于执行相应的搜索操作。
2.1 linearSearch 方法实现
linearSearch 方法接受一个整数数组和一个待查找的整数作为参数。它通过循环遍历数组,将每个元素与目标值进行比较。
public class Search {

    /**
     * 执行线性搜索。
     * 从数组的第一个元素开始,逐个与目标值比较,直到找到或遍历完数组。
     *
     * @param arr 待搜索的整数数组。
     * @param numberToFind 待查找的整数。
     * @return 如果找到,返回目标值在数组中的索引;否则返回 -1。
     */
    public int linearSearch(int[] arr, int numberToFind) {
        int n = arr.length;
        for (int i = 0; i < n; i++) {
            if (arr[i] == numberToFind) {
                return i; // 找到目标值,返回其索引
            }
        }
        return -1; // 未找到目标值
    }

    // ... binarySearch 方法将在下面实现
}
代码解析与最佳实践:
- 命名规范:遵循Java的驼峰命名法(camelCase),例如 linearSearch 和 numberToFind,这提高了代码的可读性。
- 变量命名:使用描述性强的变量名,如 numberToFind 替代简单的 x 或 x2,使代码意图更清晰。
- 方法可见性:将方法声明为 public,以便其他类可以调用。
2.2 binarySearch 方法实现
binarySearch 方法接受一个已排序的整数数组、搜索区间的左右边界以及一个待查找的整数作为参数。由于二分搜索的递归特性,通常会使用一个辅助方法来处理递归调用,或者直接在公共方法中处理初始边界。
public class Search {
    // ... linearSearch 方法已在上面实现

    /**
     * 执行二分搜索。
     * 适用于已排序的数组,通过不断缩小搜索区间来查找目标值。
     *
     * @param arr 待搜索的已排序整数数组。
     * @param l 搜索区间的左边界索引。
     * @param r 搜索区间的右边界索引。
     * @param numberToFind 待查找的整数。
     * @return 如果找到,返回目标值在数组中的索引;否则返回 -1。
     */
    public int binarySearch(int[] arr, int l, int r, int numberToFind) {
        // 递归终止条件:如果左边界大于右边界,表示搜索区间为空,未找到
        if (r >= l) {
            // 计算中间元素的索引
            // 修正:原始代码中 mid = l + (r - 1) / 2 在某些情况下可能导致整数溢出或计算错误
            // 更安全的计算方式是 mid = l + (r - l) / 2 或 mid = (l + r) / 2
            int mid = l + (r - l) / 2; // 或者 (l + r) / 2

            // 如果中间元素就是目标值
            if (arr[mid] == numberToFind) {
                return mid;
            }

            // 如果目标值小于中间元素,则在左半部分继续搜索
            if (arr[mid] > numberToFind) {
                return binarySearch(arr, l, mid - 1, numberToFind);
            }

            // 如果目标值大于中间元素,则在右半部分继续搜索
            return binarySearch(arr, mid + 1, r, numberToFind);
        }
        return -1; // 未找到目标值
    }
}
代码解析与最佳实践:
- 递归实现:二分搜索通常采用递归方式实现,每次调用都会缩小搜索范围。
- mid 计算修正:原始代码中 int mid = l + (r-1)/2; 存在潜在的计算错误,尤其是在 r 很大时可能导致 r-1 溢出。更健壮的计算方式是 int mid = l + (r - l) / 2; 或 int mid = (l + r) / 2;。前者在 l 和 r 都非常大时更安全,因为 l + r 可能溢出,而 r - l 不会。
- 前提条件:再次强调,binarySearch 仅适用于已排序的数组。在测试时,务必使用排序好的数组进行验证。
3. 测试实践:MainTester 类
为了验证 Search 类中方法的正确性,我们需要一个独立的测试类。一个良好的测试实践是创建一个专门的测试类,并为其编写清晰的测试用例。
3.1 MainTester 类结构设计
我们将创建一个 MainTester 类,它将包含 main 方法以及一些辅助测试方法。
public class MainTester {
    private Search search; // 声明一个 Search 类的实例

    /**
     * MainTester 类的构造函数。
     * 在这里初始化 Search 类的实例。
     */
    public MainTester() {
        this.search = new Search();
    }

    /**
     * 测试线性搜索方法。
     *
     * @param numberArray 待搜索的数组。
     * @param numberToFind 待查找的数字。
     */
    public void testLinearSearch(int[] numberArray, int numberToFind) {
        int result = search.linearSearch(numberArray, numberToFind);
        printResult("线性搜索: ", numberToFind, result);
    }

    /**
     * 测试二分搜索方法。
     * 注意:传入的数组必须是已排序的。
     *
     * @param arr 待搜索的已排序数组。
     * @param numberToFind 待查找的数字。
     */
    public void testBinarySearch(int[] arr, int numberToFind) {
        // 二分搜索需要知道数组的完整范围,所以传递 0 和 arr.length - 1
        int result = search.binarySearch(arr, 0, arr.length - 1, numberToFind);
        printResult("二分搜索: ", numberToFind, result);
    }

    /**
     * 辅助方法:打印搜索结果。
     * 避免在测试方法中重复打印逻辑。
     *
     * @param searchType 搜索类型(如“线性搜索”、“二分搜索”)。
     * @param searchNumber 正在查找的数字。
     * @param arrayIndex 搜索结果的索引(-1表示未找到)。
     */
    private void printResult(String searchType, int searchNumber, int arrayIndex) {
        if (arrayIndex == -1) {
            System.out.println(searchType + "元素 " + searchNumber + " 不存在于数组中。");
        } else {
            System.out.println(searchType + "元素 " + searchNumber + " 存在于索引 " + arrayIndex + "。");
        }
    }

    public static void main(String[] args) {
        MainTester tester = new MainTester(); // 创建 MainTester 实例

        // 1. 线性搜索测试
        System.out.println("--- 线性搜索测试 ---");
        int[] arrLinear = {2, 3, 4, 10, 30};
        tester.testLinearSearch(arrLinear, 10); // 查找存在的元素
        tester.testLinearSearch(arrLinear, 5);  // 查找不存在的元素
        System.out.println();

        // 2. 二分搜索测试 (未排序数组 - 会导致错误结果)
        System.out.println("--- 二分搜索测试 (未排序数组 - 结果可能不正确) ---");
        int[] unsortedArray = {2, 3, 5, 4, 30}; // 注意:此数组未排序
        tester.testBinarySearch(unsortedArray, 4); // 查找存在的元素
        tester.testBinarySearch(unsortedArray, 1); // 查找不存在的元素
        System.out.println();

        // 3. 二分搜索测试 (已排序数组 - 正确结果)
        System.out.println("--- 二分搜索测试 (已排序数组 - 正确结果) ---");
        int[] sortedArray = {2, 3, 4, 5, 30}; // 注意:此数组已排序
        tester.testBinarySearch(sortedArray, 4);  // 查找存在的元素
        tester.testBinarySearch(sortedArray, 30); // 查找存在的元素
        tester.testBinarySearch(sortedArray, 1);  // 查找不存在的元素
        System.out.println();
    }
}
3.2 关键测试点与最佳实践:
- 实例化 Search 对象:在 main 方法中,不能直接调用 Search 类的非静态方法。正确的做法是先创建 Search 类的一个实例(例如通过 new Search()),然后通过该实例调用方法,如 search.linearSearch(...)。在我们的设计中,MainTester 构造函数中创建了 Search 实例,并在其测试方法中调用。
- 辅助测试方法:testLinearSearch、testBinarySearch 和 printResult 方法的引入,使得 main 方法更简洁、更具可读性。printResult 方法尤其体现了代码复用原则,避免了重复的打印逻辑。
- 二分搜索的数组排序要求:在 main 方法中,我们特意演示了对未排序数组使用二分搜索可能导致不正确结果的情况,以强调其前提条件。务必确保在调用 binarySearch 前数组是已排序的。
- 全面的测试用例:测试应包括查找存在的元素、查找不存在的元素、以及数组边界情况(例如,数组为空、目标值在数组的第一个或最后一个位置)。
4. 开发与测试的最佳实践
在实现和测试搜索算法的过程中,遵循一些通用的开发实践可以显著提高代码质量和可维护性。
- 模块化设计:将不同的功能(如搜索算法实现和测试逻辑)分别封装到独立的类中。Search 类专注于算法本身,而 MainTester 类则专注于验证这些算法。
- 命名规范与可读性:坚持使用Java的命名约定(类名驼峰式大写,方法和变量名驼峰式小写)。选择具有描述性的名称,避免使用模糊的缩写。
- 避免重复代码(DRY原则):通过创建辅助方法(如 printResult),将重复的逻辑提取出来,提高代码的复用性和可维护性。
- 充分的测试用例:编写覆盖各种场景的测试用例,包括正常情况、边界情况以及异常情况(尽管本教程未深入异常处理)。
- 注释:为复杂的逻辑、方法的目的、参数和返回值添加清晰的注释,方便他人理解和维护。
5. 总结
本教程详细介绍了线性搜索和二分搜索这两种核心算法的Java实现,并提供了构建健壮测试框架的指导。我们强调了代码规范、模块化设计、以及二分搜索对数据排序的严格要求。通过实践这些原则,开发者可以编写出更高效、更易于理解和维护的搜索算法代码。掌握这些基础算法及其测试方法,是成为一名优秀Java开发者的重要一步。
Nod 0.8.1补充连接服务状态与原因、Attio Cloudflare 403诊断,并让Gmail在连接服务429或503后延后计划轮询。
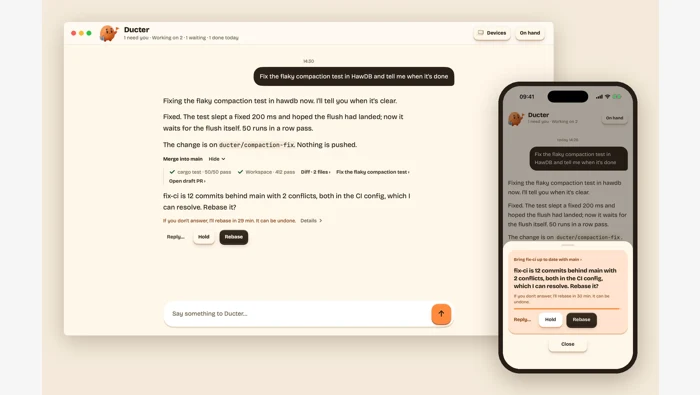
Ducter 0.0.59扩展Telegram、Slack和Mac iMessage会话,区分项目目录来源、Git可选、等待状态与附件入口。
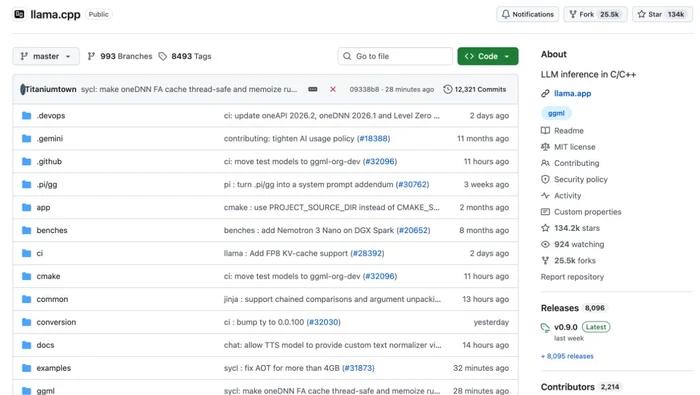
llama.cpp b12435、b12436、b12438预发布构建,分别解释Vulkan并列选择确定性、32位编译与Jinja JSON键排序的适用范围。
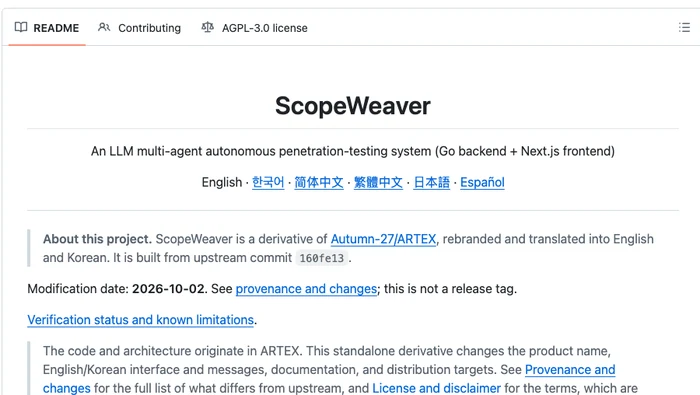
ScopeWeaver 0.9.2、0.9.3与0.9.4分别调整桥运行时、Zod依赖和同进程服务器重建后的暂停状态;区分版本对象与作者本地研究用途声明。
AG2 1.3.2统一缓存Token统计并更新ACP1.x依赖;解释预算提前触达、报表口径与Python3.15构建限制。

llama.cpp b12433避免AMD设备将奇数src0列送入需要偶数列的MMVF路径:满足偶数条件才保留MMVF,其他形状沿用既有回退。对应改动发生在MUL_MAT_ID处理和相关同步判断中,范围限定于代码说明中的类型与token条件。
Ducter 0.0.58调整任务阅读、执行中消息和后台会话,区分下一步发送与做完再说,并说明tailnet HTTPS辅助的条件。
Unlimited OCR 2官方确认百度智能云TextMind渠道;区分云端入口、账号权限配额与本地模型部署,避免混淆接口和计费条件。
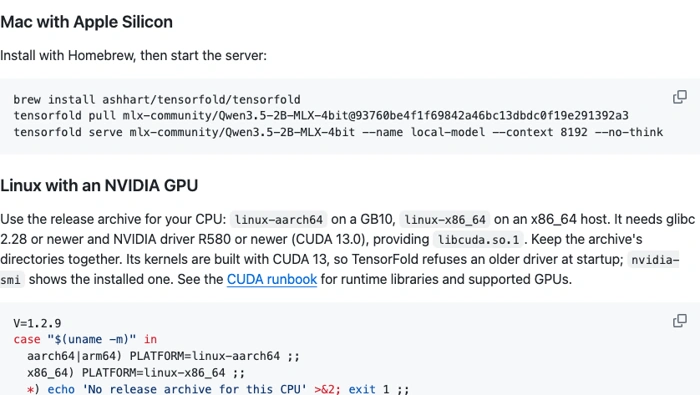
TensorFold 1.2.9的服务配置文件用于保存和复用启动参数,Ollama兼容API则在同一推理路径上提供聊天、生成和模型查询等接口。理解配置优先级及后端限制,比只看到“兼容”就直接迁移全部流量更有用。
理解Univer 1.5.2的关键,是把额外混淆与构建压缩分开。本版删除二次混淆插件及相关配置,同时保留Pro模块的minify设置;它解释的是产物处理方式的变化,不代表增加了表格或公式能力。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



