

Pandas DataFrame列扩展与行位移技巧
本教程详细介绍了如何使用Pandas在DataFrame中实现列值的向下位移并扩展DataFrame的行数。通过结合reindex和shift方法,我们可以有效地将指定列的数值向下移动N个位置,同时在顶部填充缺失值,并在底部为位移后的数据创建新的行,从而保持原始第一列的相对位置不变。

本教程详细介绍了如何使用Pandas在DataFrame中实现列值的向下位移并扩展DataFrame的行数。通过结合`reindex`和`shift`方法,我们可以有效地将指定列的数值向下移动N个位置,同时在顶部填充缺失值,并在底部为位移后的数据创建新的行,从而保持原始第一列的相对位置不变。
在数据处理中,我们经常会遇到需要对DataFrame中的特定列进行位移操作的场景。例如,可能需要将某一列的数据向下移动若干行,同时保持其他列的原始位置,并在位移产生的空缺处填充缺失值,同时扩展DataFrame以容纳位移后的所有数据。Pandas库提供了强大的工具集来高效地完成这类任务。
问题描述与目标
假设我们有一个包含多列数据的Pandas DataFrame,目标是将其中某一列(例如,列'B')的数值向下移动指定的步数n。这意味着原列'B'的前n个位置将填充为缺失值(NaN),而原有的数据将从第n行开始显示。为了容纳这些向下位移的数据,DataFrame的总行数需要增加n行,并且在新增的行中,除了被位移的列,其他列(例如,列'A')在新行中将显示为NaN。
以下是一个具体的示例,展示了从原始DataFrame到期望结果的转换:
原始DataFrame:
     A    B
0    1    a
1    2    b
2    3    c
3    4    d
4    5    e
期望结果 (位移2步):
     A    B
0    1  NaN
1    2  NaN
2    3    a
3    4    b
4    5    c
5  NaN    d
6  NaN    e
解决方案:使用 reindex 和 shift
Pandas提供了reindex和shift这两个核心方法,可以完美地解决上述问题。
- reindex() 方法: 用于根据新的索引重新排列DataFrame。如果新索引包含原始索引中不存在的标签,则会在相应位置填充缺失值。我们可以利用它来扩展DataFrame的行数。
- shift() 方法: 用于将Series或DataFrame的元素沿指定轴移动。当应用于列时,它会将列中的值向下(或向上)移动指定的步数,并在移动产生的空缺处填充缺失值。
实现步骤
我们将通过以下两个主要步骤来完成数据转换:
步骤一:扩展DataFrame的索引
首先,我们需要确保DataFrame有足够的行来容纳位移后的数据。这可以通过reindex方法结合pd.RangeIndex来实现。我们将创建一个新的索引,其长度为原始DataFrame的行数加上位移步数n。
import pandas as pd

# 示例DataFrame
df = pd.DataFrame({'A': [1, 2, 3, 4, 5], 'B': list('abcde')})

n = 2 # 位移步数

# 创建新的索引,长度为原长度 + n
new_index = pd.RangeIndex(len(df) + n)

# 使用reindex扩展DataFrame的行数
# 对于非'B'列,新增加的行将填充NaN
extended_df = df.reindex(new_index)
此时,extended_df将看起来像这样:
     A    B
0  1.0    a
1  2.0    b
2  3.0    c
3  4.0    d
4  5.0    e
5  NaN  NaN
6  NaN  NaN
注意,列'A'的数据类型可能从整数变为浮点数,因为NaN(Not a Number)是浮点类型。
步骤二:位移目标列的值
接下来,我们使用shift(n)方法将目标列(例如,'B')的值向下移动n个位置。然后,我们将这个位移后的Series赋值回DataFrame的相应列。
# 位移列'B'的值
shifted_B = df['B'].shift(n)

# 将位移后的列'B'赋值给扩展后的DataFrame
extended_df['B'] = shifted_B
整合代码
为了更简洁地实现,我们可以将上述操作整合到一行代码中,利用assign()方法来创建或修改列:
import pandas as pd

# 示例DataFrame
df = pd.DataFrame({'A': [1, 2, 3, 4, 5], 'B': list('abcde')})

n = 2 # 位移步数

# 整合reindex和shift操作
out = df.reindex(pd.RangeIndex(len(df) + n)).assign(B=lambda x: x['B'].shift(n))

print(out)
输出结果:
     A      B
0  1.0   None
1  2.0   None
2  3.0      a
3  4.0      b
4  5.0      c
5  NaN      d
6  NaN      e
这里,None在Pandas中通常等同于NaN,尤其是在对象类型(如字符串)的Series中。
注意事项
- 索引类型: 上述解决方案假设原始DataFrame具有默认的RangeIndex(即从0开始的整数索引)。如果DataFrame具有自定义索引,reindex(pd.RangeIndex(len(df) + n))会保留原始索引对应的值,并在新索引位置填充NaN。如果希望原始索引被完全替换为新的RangeIndex,可以先reset_index(drop=True)。
- 数据类型: 当列中引入NaN或None时,Pandas可能会自动向上转换数据类型。例如,整数列会变为浮点数列,以容纳NaN。字符串或对象列则会保持对象类型。
- 位移方向: shift(n)默认是向下位移。如果需要向上位移,可以使用负数作为参数,例如shift(-n)。
- 灵活性: 变量n可以根据需要调整,以实现不同步数的位移。
总结
通过巧妙地结合Pandas的reindex和assign(或直接赋值)以及shift方法,我们可以高效且灵活地实现DataFrame列的位移和行数的扩展。这种方法不仅保持了原始列的相对位置,还在新增的行和位移产生的空缺处填充了缺失值,从而满足了多种复杂的数据转换需求。理解并掌握这些Pandas核心功能,对于进行数据清洗和预处理至关重要。
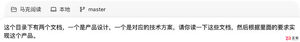
了解AI编程如何高效交付产品。本文以电子书阅读器为例,解析从环境搭建、产品设计、技术选型到代码实现及最终验收的标准工作流,帮助开发者规范AI协作过程。

了解 Claude Code 的基础交互流程,包括文件生成确认、使用 /compact 管理对话上下文、通过 CLAUDE.md 设定项目规则以及调用技能复用输出格式,提升开发协作效率。

详细介绍在 Visual Studio 2022 中关闭编辑器垂直滚动条代码缩略图(地图模式)的具体操作方法,包含右键快捷路径与全局选项设置,帮助恢复紧凑清晰的传统滚动条。

详细介绍在 Visual Studio 2022 中使用官方 Microsoft Visual Studio Installer Projects 扩展生成 Windows 桌面应用程序安装包(.msi / setup.exe)的完整操作步骤与配置细节。

客观全面评析大地老师的Node.js教程:从技术栈覆盖、实战讲解风格到局限短板与进阶路径,帮助初学者和前端开发者客观评估是否适合自身学习需求。

在为大模型Agent接入外部工具时,是选择MCP的结构化参数定义,还是使用CLI的通用命令入口?本文通过图片筛选与上传的实际案例,分析两种方式在上下文开销、任务组合效率及安全风险上的差异,提供选型参考。
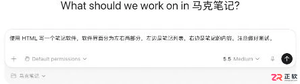
初次接触Codex不知从何下手?本文通过一个具体的HTML笔记应用案例,带你走完从建立项目、输入需求、批准执行到验收结果的完整流程,快速掌握Codex的基础使用方法。
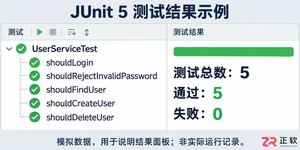
学习如何通过结构化测试、精准断言和参数化设计提升JUnit测试效率,避免常见陷阱,实现高质量、可维护的单元测试代码。
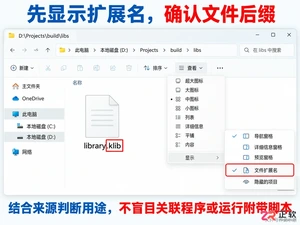
遇到.klib文件打不开?它通常是Kotlin/Native的库文件而非普通文档。本文教你如何在Windows下确认文件来源、安全查看内部结构,以及开发者如何正确使用klib工具,避免误操作。
学习如何在Vue项目中设置文件上传格式限制。本文介绍使用HTML accept属性进行基础过滤,以及结合JavaScript进行严格后缀名校验的方法,确保只允许指定类型的文件被上传。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。


Autodesk Maya 是面向影视、电视、动画和游戏行业的专业三维制作软件,集多边形与 NURBS 建模、角色绑定、关键帧和动作捕捉动画、Bifrost 特效模拟、材质开发及 Arnold 渲染于一体,
火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。


