

Pandas 日期区间数据填充技巧
本文详细介绍了如何利用Pandas库,根据另一个DataFrame中定义的日期范围条件,对目标DataFrame进行数据填充。通过将日期列转换为标准格式,结合melt、merge_asof和pivot等操作,实现高效且精确的条件性数据合并与筛选,最终生成符合特定日期区间要求的数据视图。

本文详细介绍了如何利用 Pandas 库,根据另一个 DataFrame 中定义的日期范围条件,对目标 DataFrame 进行数据填充。通过将日期列转换为标准格式,结合 `melt`、`merge_asof` 和 `pivot` 等操作,实现高效且精确的条件性数据合并与筛选,最终生成符合特定日期区间要求的数据视图。
在数据分析和处理中,我们经常需要根据复杂的条件从一个数据集填充或筛选另一个数据集。其中一种常见场景是基于日期范围进行条件性数据填充。例如,我们有一个包含公司及其有效日期范围的 DataFrame (df1),以及另一个包含每日公司数据值的 DataFrame (df2)。我们的目标是创建一个新的 DataFrame (df3),其中 df2 中的值仅在对应公司的日期落在 df1 定义的有效范围内时才保留,否则置为 NaN。
数据准备
首先,我们定义两个示例 DataFrame df1 和 df2。df1 包含每个公司的有效起始和结束日期,而 df2 包含每日的各项公司数据。
import pandas as pd

# 定义 df1:包含公司及其有效日期范围
data1 = {'company': {0: 'a', 1: 'b', 2: 'c', 3: 'd'},
         'start date': {0: '2023-01-02', 1: '2023-01-05', 2: '2023-01-04', 3: '2023-01-03'},
         'end date': {0: '2023-01-06', 1: '2023-01-12', 2: '2023-01-13', 3: '2023-01-10'}}
df1 = pd.DataFrame(data1)

# 定义 df2:包含每日的公司数据
data2 = {'DATE': {0: '2023-01-02', 1: '2023-01-03', 2: '2023-01-04', 3: '2023-01-05',
                  4: '2023-01-06', 5: '2023-01-09', 6: '2023-01-10', 7: '2023-01-11',
                  8: '2023-01-12', 9: '2023-01-13'},
         'a': {0: 1, 1: 2, 2: 3, 3: 4, 4: 5, 5: 6, 6: 7, 7: 8, 8: 9, 9: 10},
         'b': {0: 10, 1: 11, 2: 12, 3: 13, 4: 14, 5: 15, 6: 16, 7: 17, 8: 18, 9: 19},
         'c': {0: 30, 1: 31, 2: 32, 3: 33, 4: 34, 5: 35, 6: 36, 7: 37, 8: 38, 9: 39},
         'd': {0: 40, 1: 41, 2: 42, 3: 43, 4: 44, 5: 45, 6: 46, 7: 47, 8: 48, 9: 49}}
df2 = pd.DataFrame(data2)

print("df1 原始数据:")
print(df1)
print("\ndf2 原始数据:")
print(df2)
日期类型转换
在进行任何日期相关的操作之前,将日期列转换为 Pandas 的 datetime 类型至关重要。这确保了日期比较和合并的准确性。
df1['start date'] = pd.to_datetime(df1['start date'])
df1['end date'] = pd.to_datetime(df1['end date'])
df2['DATE'] = pd.to_datetime(df2['DATE'])

print("\ndf1 转换日期类型后:")
print(df1)
print("\ndf2 转换日期类型后:")
print(df2)
核心逻辑实现
为了实现基于日期范围的条件填充,我们将采用以下步骤:
- 数据重塑 (melt): 将 df2 从宽格式(每列代表一个公司)转换为长格式。这使得每个数据点(日期、公司、值)都成为一行,便于与 df1 进行合并。
- 近似合并 (merge_asof): 使用 merge_asof 将 df2(长格式)与 df1 合并。merge_asof 是一种特殊的合并,它根据最近的键进行合并,而不是精确匹配。在这里,我们将 df2 的 DATE 与 df1 的 start date 进行近似合并,同时按 company 分组。
- 条件筛选 (where): 合并后,我们将得到一个包含 DATE、company、value、start date 和 end date 的临时 DataFrame。然后,我们检查每个数据点的 DATE 是否落在对应的 start date 和 end date 之间。如果不在,则将 value 设置为 NaN。
- 数据重塑 (pivot): 最后,将临时 DataFrame 重新 pivot 回原始的宽格式,以 DATE 为索引,company 为列,value 为值。
# 步骤1:将 df2 转换为长格式并按日期排序,以准备 merge_asof
tmp = df2.melt('DATE', var_name='company').sort_values('DATE')

# 步骤2:使用 merge_asof 进行近似合并
# by='company' 表示在每个公司内部进行合并
# left_on='DATE' 和 right_on='start date' 表示以 df2 的 DATE 和 df1 的 start date 进行近似匹配
# 注意:merge_asof 要求左右 DataFrame 的合并键(这里是 DATE 和 start date)必须已排序
df1_sorted = df1.sort_values('start date')
tmp = pd.merge_asof(tmp, df1_sorted, by='company', left_on='DATE', right_on='start date')

# 步骤3:根据日期范围条件筛选值
# .where() 方法会根据条件保留值,不满足条件的置为 NaN
df3_filtered = tmp.assign(value=tmp['value'].where(
    (tmp['DATE'] >= tmp['start date']) & (tmp['DATE'] <= tmp['end date'])
))

# 步骤4:将数据透视回宽格式
# index='DATE' 设置日期为行索引
# columns='company' 设置公司为列名
# values='value' 设置填充的值
df3 = df3_filtered.pivot(index='DATE', columns='company', values='value') \
                  .rename_axis('', axis=1) \
                  .reset_index()

print("\ndf3 期望输出:")
print(df3)
完整示例代码
以下是整合了所有步骤的完整代码,可以直接运行:
import pandas as pd

# 原始数据定义
data1 = {'company': {0: 'a', 1: 'b', 2: 'c', 3: 'd'},
         'start date': {0: '2023-01-02', 1: '2023-01-05', 2: '2023-01-04', 3: '2023-01-03'},
         'end date': {0: '2023-01-06', 1: '2023-01-12', 2: '2023-01-13', 3: '2023-01-10'}}
df1 = pd.DataFrame(data1)

data2 = {'DATE': {0: '2023-01-02', 1: '2023-01-03', 2: '2023-01-04', 3: '2023-01-05',
                  4: '2023-01-06', 5: '2023-01-09', 6: '2023-01-10', 7: '2023-01-11',
                  8: '2023-01-12', 9: '2023-01-13'},
         'a': {0: 1, 1: 2, 2: 3, 3: 4, 4: 5, 5: 6, 6: 7, 7: 8, 8: 9, 9: 10},
         'b': {0: 10, 1: 11, 2: 12, 3: 13, 4: 14, 5: 15, 6: 16, 7: 17, 8: 18, 9: 19},
         'c': {0: 30, 1: 31, 2: 32, 3: 33, 4: 34, 5: 35, 6: 36, 7: 37, 8: 38, 9: 39},
         'd': {0: 40, 1: 41, 2: 42, 3: 43, 4: 44, 5: 45, 6: 46, 7: 47, 8: 48, 9: 49}}
df2 = pd.DataFrame(data2)

# 1. 转换日期列为 datetime 类型
df1['start date'] = pd.to_datetime(df1['start date'])
df1['end date'] = pd.to_datetime(df1['end date'])
df2['DATE'] = pd.to_datetime(df2['DATE'])

# 2. 将 df2 转换为长格式并排序
tmp = df2.melt('DATE', var_name='company').sort_values('DATE')

# 3. 对 df1 进行排序,以满足 merge_asof 的要求
df1_sorted = df1.sort_values('start date')

# 4. 使用 merge_asof 进行近似合并
# left_on='DATE' 和 right_on='start date' 确保将 df2 的 DATE 与 df1 中不大于该 DATE 的最近 start date 合并
tmp = pd.merge_asof(tmp, df1_sorted, by='company', left_on='DATE', right_on='start date')

# 5. 根据日期范围条件筛选值
# 只有当 df2 的 DATE 在 df1 定义的 [start date, end date] 范围内时,才保留其值
df3 = tmp.assign(value=tmp['value'].where(
    (tmp['DATE'] >= tmp['start date']) & (tmp['DATE'] <= tmp['end date'])
)) \
         .pivot(index='DATE', columns='company', values='value') \
         .rename_axis('', axis=1) \
         .reset_index()

print("\n最终结果 df3:")
print(df3)
注意事项与总结
- 日期类型的重要性: 始终确保涉及日期比较的列是 datetime 类型。不一致的类型会导致错误或意外结果。
- merge_asof 的排序要求: merge_asof 函数要求左右 DataFrame 的合并键(在本例中是 DATE 和 start date)必须是已排序的。如果未排序,结果将不准确。
- 数据重塑的必要性: melt 和 pivot 操作是处理这种宽-长-宽转换问题的关键。它们使得在多列之间应用条件变得可行。
- 条件逻辑: (tmp['DATE'] >= tmp['start date']) & (tmp['DATE'] <= tmp['end date']) 是实现日期范围筛选的核心逻辑。where() 方法提供了一种简洁的方式来应用此条件并用 NaN 替换不符合条件的值。
- 性能考量: 对于非常大的数据集,melt 和 pivot 操作可能会消耗较多内存和计算资源。在处理大规模数据时,应评估其性能影响。
通过上述步骤,我们能够高效且准确地根据复杂的日期范围条件,从一个 DataFrame 中有选择性地填充另一个 DataFrame 的数据,这在财务分析、事件日志处理等领域具有广泛应用。
遇到PHP递归报错时,不要盲目调大max_nesting_level。本文教你区分Xdebug限制、内存耗尽和正则递归错误,提供代码级的终止条件优化与迭代替代方案,彻底解决栈溢出问题。
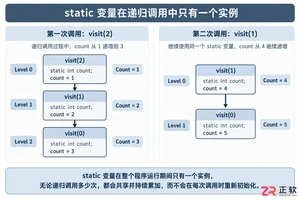
本文分析PHP递归中static变量导致的状态污染及引用传递引发的共享数据修改问题。提供具体的代码复现、缓存键设计建议及调试打印技巧,帮助开发者避免隐蔽的逻辑错误。
解析PHP递归函数在树形数据处理中的性能瓶颈,提供预加载数据消除I/O、使用显式栈替代深层递归的实战方案,帮助开发者在代码可读性与执行效率间做出合理取舍。
详细讲解在Java单元测试中如何使用Mockito模拟依赖对象,包括引入依赖、创建Mock、打桩返回值、行为验证以及Mock与Spy的核心差异和常见陷阱排查。

详细分析链表删除节点的时间复杂度,深入探讨单链表与双向链表在不同已知前提下的查找与删除开销,并结合完整代码与清晰图解进行对比总结。

想知道如何让AI写出的代码更贴合你的习惯?本文手把手教你在VS Code中调整Codex相关模型参数,通过修改配置文件优化温度值和令牌限制,解决代码建议不准确或响应慢的问题。

通过实测展示Claude Code在终端中如何理解自然语言指令、自动修改代码文件并处理复杂编程任务,帮助开发者评估其实际辅助能力。

本教程详细讲解如何使用Visual Studio创建WinForms项目,通过添加按钮和标签控件并编写点击事件代码,实现一个基础的计数器功能,适合C#初学者快速上手Windows窗体应用开发。

详解Cursor编辑器中自动补全功能的开启与优化设置,涵盖Tab触发机制、上下文窗口调整及模型切换,帮助开发者解决补全延迟、干扰大等问题,提升编码流畅度。

详解Pandas中数据格式转换的核心方法,包括astype强制转换、to_numeric容错处理及日期解析技巧,解决常见类型错误并提升数据处理效率。




Photoshop 2026 是 Adobe 推出的专业图像处理与视觉设计软件,支持 Windows、macOS 和 iPad 等平台,广泛应用于摄影修图、电商设计、平面海报、数字绘画及视觉合成等创作场景。

Blender 是一款免费开源、跨平台的专业 3D 创作软件,集建模、动画、渲染、视频编辑与视觉合成等功能于一体,广泛应用于影视动画、游戏设计和建筑可视化等领域。软件支持 Cycles 物理渲染器与 Eevee 实时渲染引擎,并提供多边形建模、骨骼绑定、物理模拟等专业工具。Blender 兼容 Windows、macOS 和 Linux 系统,安装包轻巧、运行流畅,依托活跃的全球开发者社区持续更新,是从初学者到专业创作者都值得选择的正版 3D 创作工具。


Photoshop 2026 是 Adobe 推出的专业图像处理与视觉设计软件,支持 Windows、macOS 和 iPad 等平台,广泛应用于摄影修图、电商设计、平面海报、数字绘画及视觉合成等创作场景。
Blender 是一款免费开源、跨平台的专业 3D 创作软件,集建模、动画、渲染、视频编辑与视觉合成等功能于一体,广泛应用于影视动画、游戏设计和建筑可视化等领域。软件支持 Cycles 物理渲染器与 Eevee 实时渲染引擎,并提供多边形建模、骨骼绑定、物理模拟等专业工具。Blender 兼容 Windows、macOS 和 Linux 系统,安装包轻巧、运行流畅,依托活跃的全球开发者社区持续更新,是从初学者到专业创作者都值得选择的正版 3D 创作工具。