

清华文生3D方法在扩散模型下超越SOTA达到监督NeRF
用文字合成3D图形的AI模型,又有了新的SOTA!近日,清华大学刘永进教授课题组提出了一种基于扩散模型的文生3D新方式。无论是不同视角间的一致性,还是与提示词的匹配度,都比此前大幅提升。图片文生3D是3DAIGC的热点研究内容,得到了学术界和工业界的广泛关注。刘永进教授课题组此次提出的新模型叫做TICD(Text-ImageConditionedDiffusion),在T3Bench数据集上达到了SOTA水平。目前相关论文已经发布,代码也即将开源。测评成绩已达SOTA为了评估TICD方法的效果,研究团队首
用文字合成3D图形的AI模型,又有了新的SOTA!
近日,清华大学刘永进教授课题组提出了一种基于扩散模型的文生3D新方式。
无论是不同视角间的一致性,还是与提示词的匹配度,都比此前大幅提升。
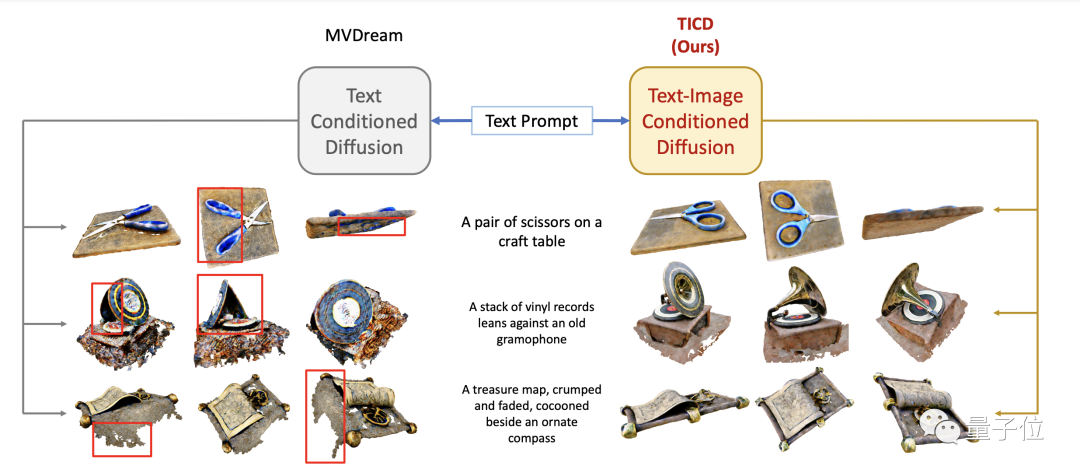 图片
文生3D是3D AIGC的热点研究内容,得到了学术界和工业界的广泛关注。
刘永进教授课题组此次提出的新模型叫做TICD(Text-Image Conditioned Diffusion),在T3Bench数据集上达到了SOTA水平。
目前相关论文已经发布,代码也即将开源。
测评成绩已达SOTA
为了评估TICD方法的效果,研究团队首先进行了定性实验,并对比了此前一些较好的方法。
结果显示,用TICD方法生成的3D图形质量更好、图形更清晰,与提示词的匹配程度也更高。
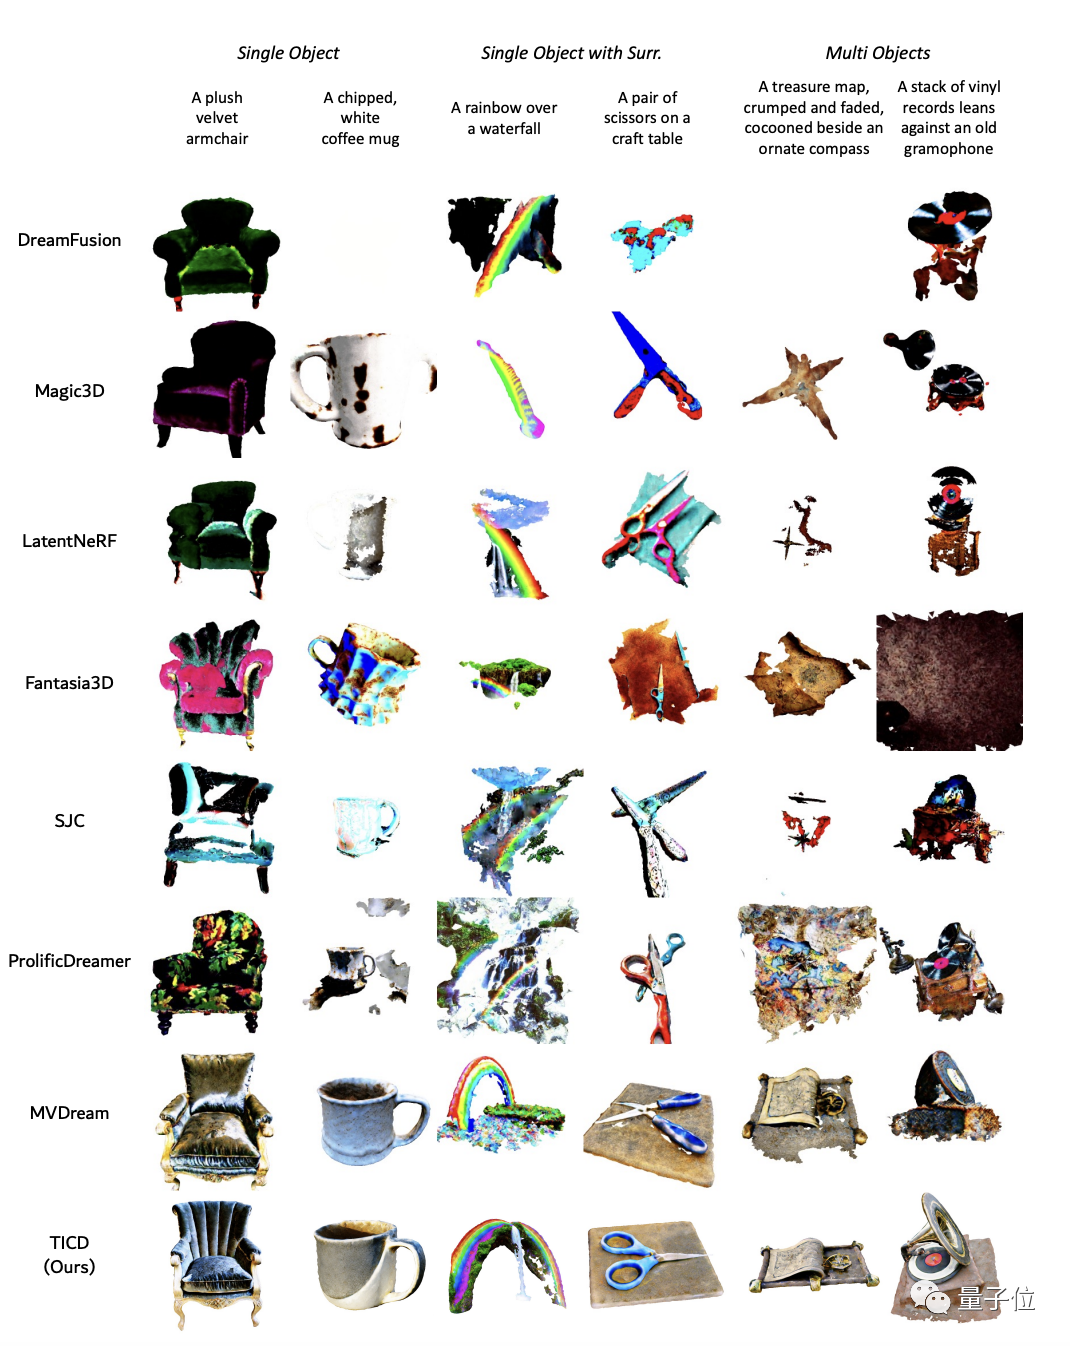 图片
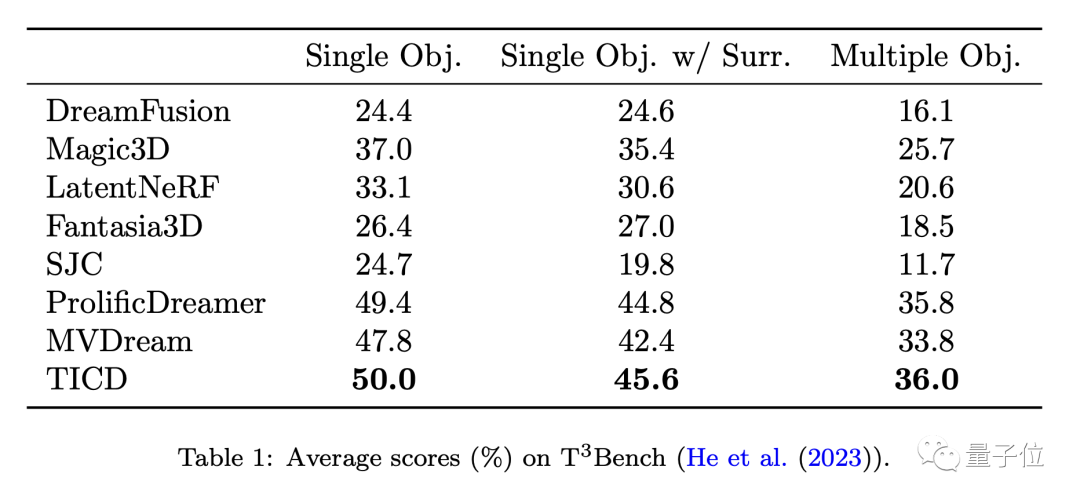
为了进一步评估这些模型的表现,团队在T3Bench数据集上将TICD与这些方法进行了定量测试。
结果显示,TICD在单对象、单对象带背景、多对象这三个提示集上都取得了最好的成绩,证明了它在生成质量和文本对齐性上都具有整体优势。
 图片
此外,为了进一步评估这些模型的文本对齐性,研究团队还对3D物体渲染得到的图片与原始提示词的CLIP余弦相似度上进行了测试,结果依然是TICD的表现最佳。
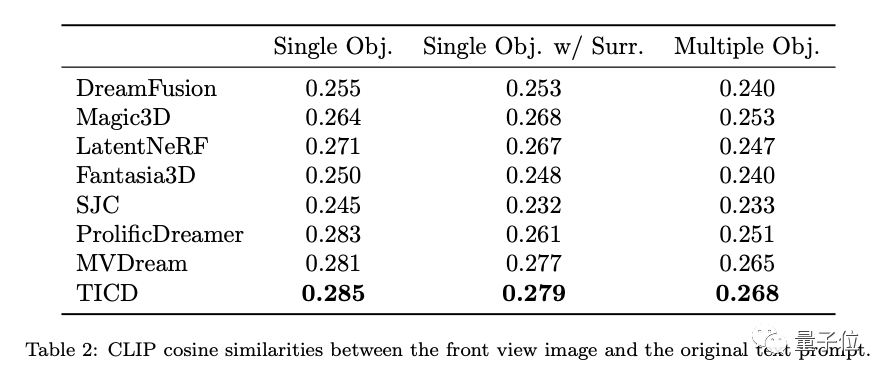
那么,TICD方法是如何实现这样的效果的呢?
将多视角一致性先验纳入NeRF监督
目前主流的文本生成3D方法大多使用预训练的2D扩散模型,通过得分蒸馏采样(Score Distillation Sampling, SDS)优化神经辐射场(NeRF)来生成全新的3D模型。
然而,这种预训练扩散模型提供的监督仅限于输入的文本本身,并未约束多视角间的一致性,可能会出现生成几何结构较差等问题。
为了在扩散模型的先验中引入多视角一致性,一些最新的研究通过使用多视角数据对2D扩散模型进行微调,但仍然缺乏细粒度的视角间连续性。
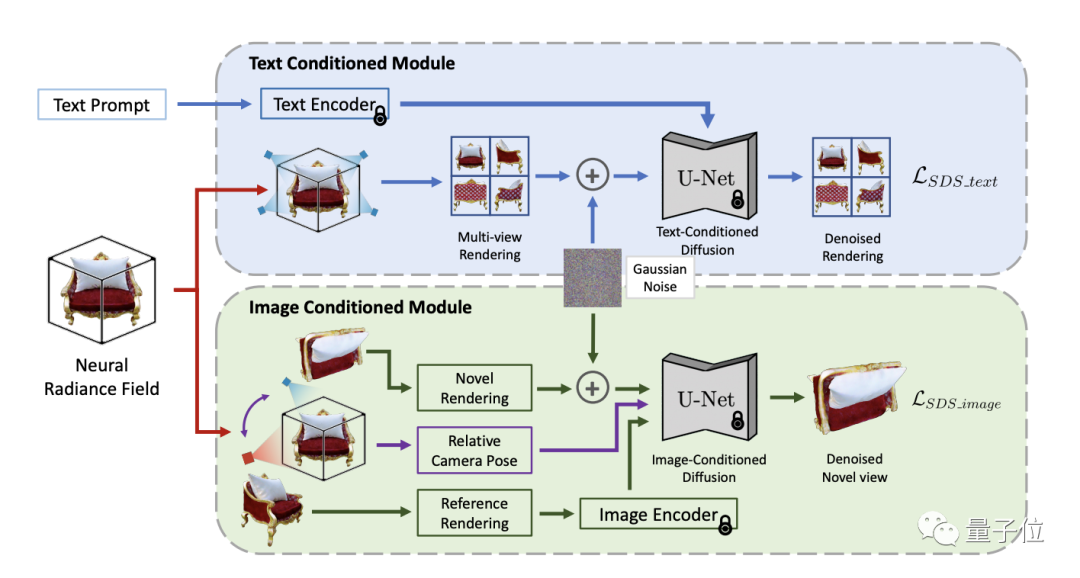
为了解决这一挑战,TICD方法将以文本为条件的和图像为条件的多视角图像纳入NeRF优化的监督信号中,分别保证了3D信息与提示词的对齐和3D物体不同视角间的强一致性,有效提升了生成3D模型的质量。
 图片
工作流程上,TICD首先采样若干组正交的参考相机视角,使用NeRF渲染出对应的参考视图,然后对这些参考视图运用基于文本的条件扩散模型,约束内容与文本的整体一致性。
在此基础上选取若干组参考相机视角,并对于每个视角渲染一个额外新视角下的视图。接着以这两个视图与视角间的位姿关系作为新条件,使用基于图像的条件扩散模型约束不同视角间的细节一致性。
结合两种扩散模型的监督信号,TICD可对NeRF网络的参数进行更新并循环迭代优化,直到获得最终的NeRF模型,并渲染出高质量、几何清晰且与文本一致的3D内容。
此外,TICD方法可以有效消除现有方法面对特定文本输入时可能产生的几何信息消失、错误几何信息过量生成、颜色混淆等问题。
论文地址:https://arxiv.org/abs/2312.11774
5月30日,华为推出了全新的AI模型——盘古UltraMoE,该模型的参数量达到了7180亿。作为一款接近万亿参数的MoE(MixtureofExperts)模型,它在整个训练过程中完全基于华为的昇腾AI平台完成,标志着华为在超大规模模型训练方面取得了重要进展。盘古UltraMoE的成功训练离不开盘古团队研发的一系列创新技术。例如,Depth-ScaledSandwich-Norm(DSSN)稳定架构的引入,显著改善了超大规模模型训练期间出现的梯度异常及
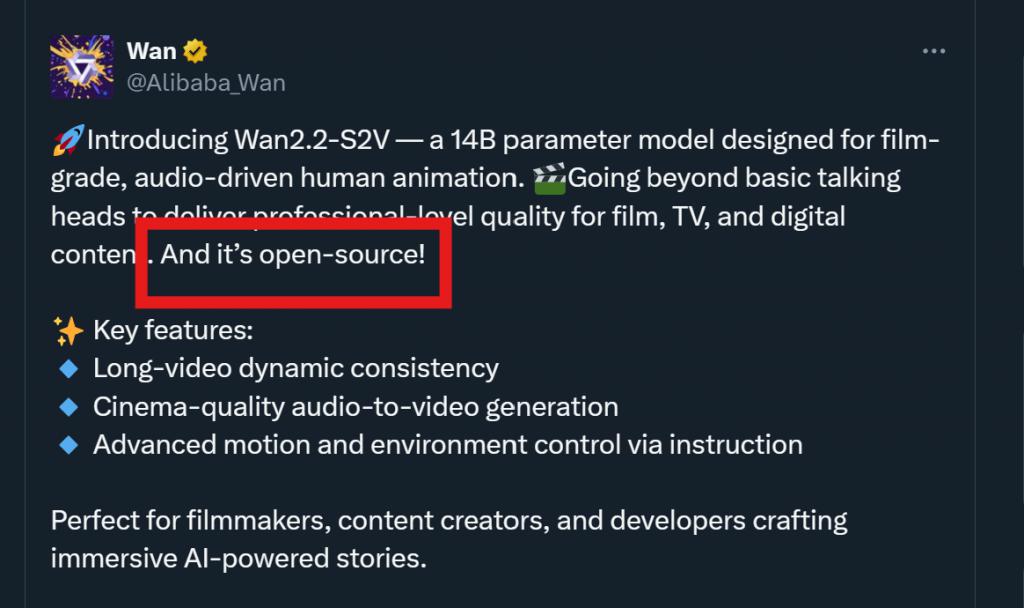
AI视频生成正迎来属于“通义”的高光时刻!就在昨晚,阿里巴巴悄然推出了一款由音频驱动的14B视频大模型——Wan2.2-S2V。只需上传一张静态图片和一段音频,就能生成出面部表情生动、口型精准匹配、肢体动作流畅自然的电影级数字人视频,效果惊艳。实际效果展示如下:△来自@AIMIRAI46487更令人振奋的是,这款新模型一经发布便全面开源,现在所有人都可以免费在通义万相官网体验使用。据官方介绍,Wan2.2-S2V的核心优势包括:支持最长分钟级的单次视频生成,画面稳定且具有一致性;具备影院级别的音
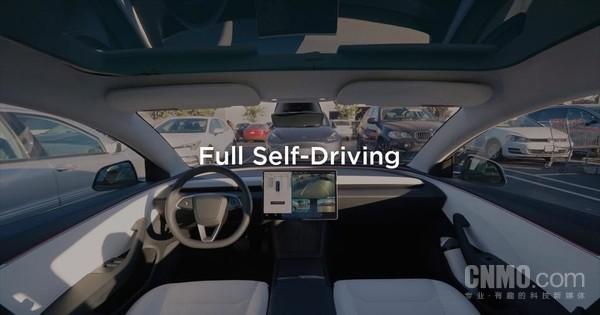
近日,有汽车领域博主爆料,特斯拉的FSD(完全自动驾驶)辅助系统将迎来一次重要升级,或将实现更真实的环境场景还原。在最新曝光的软件代码中,发现了大量新增的渲染模型,涵盖多种车辆与行人类型。这些新增模型包括救护车、消防车、垃圾清运车、校车、半挂式卡车、高尔夫球车、骑电动滑板车的行人、使用轮椅的行人、玩滑板的行人、推婴儿车的行人,以及道路清扫车、三轮车、拖车、火车和有轨电车等。这一系列高精度建模意味着FSD系统将能更准确识别并响应复杂交通参与者的行为。据CNMO掌握的消息,日本方面已为特斯拉FSD系统的落地扫
大语言模型面对加密数据,即便最新的Qwen3也会感到压力!尽管当下各类推理模型在多种基准测试中表现优异,但在密码学这样对逻辑严谨性和细节准确性要求极高的专业领域,模型的推理能力还有待深入挖掘。密码学不仅要求模型具备高级数学运算能力和严密的逻辑推理链,还需要其能够精准辨识复杂加密模式中的潜在规律;成功解密要求模型拥有极强的综合推理能力。上海AILab等联合推出的CipherBank测评,使用大量真实隐私场景数据和多种密码算法,严苛挑战当前最先进的大模型。CipherBank的测评结果显示,目前的大语言模型
强化学习(RL)结合真实搜索引擎可以显著提升大模型的检索和推理能力。然而,这一方法面临两大挑战:搜索引擎返回的文档质量不稳定,导致训练过程中的噪音和不稳定性;RL训练需要频繁部署,产生大量API开销,限制了可扩展性。针对这些问题,阿里通义实验室推出了开源解决方案ZeroSearch,这是一个无需与真实搜索引擎交互的强化学习框架。实验表明,ZeroSearch只需使用3B参数的LLM作为检索模块,就能有效提升搜索能力,并大幅节省API成本。ZeroSearch让LLM实现自给自足
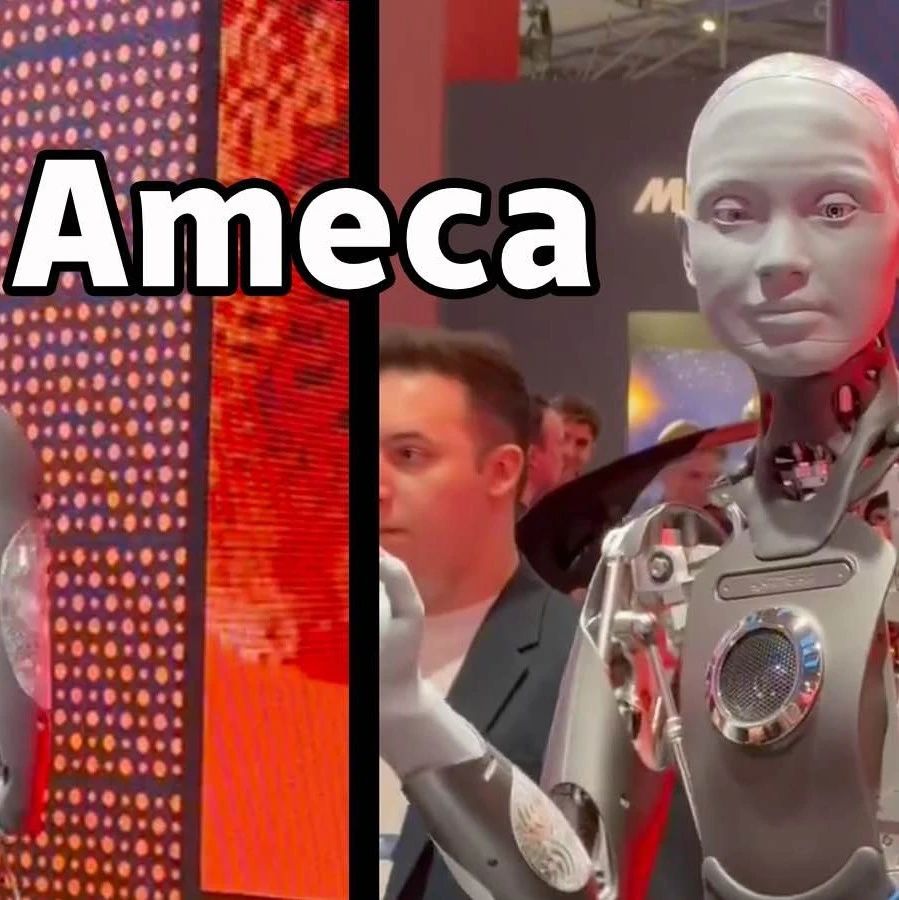
编辑:桃子【新智元导读】第二代Ameca升级亮相,搭载GPT-4技术,实现实时对话。人形机器人Ameca迎来了它的第二代版本!近期,在2024年世界移动通信大会(MWC)上,全球最先进的机器人Ameca再度亮相。Ameca在会场周围吸引了大量观众。通过GPT-4的增强,Ameca能够即时回应各种问题。「展示一段舞蹈吧」。当被问及是否有情感时,Ameca通过一系列逼真的面部表情作出回应。就在几天前,开发Ameca的英国机器人公司EngineeredArts展示了他们团队的最新成果。视频中,Ameca具备了
4月2日,HuggingFace大模型榜单迎来更新,阿里通义千问近期开源的端到端全模态大模型Qwen2.5-Omni力压群雄,荣登榜首!DeepSeek-V3-0324和群核的SpatialLM-Llama-1B紧随其后,杭州公司包揽榜单前三甲。Qwen2.5-Omni展现出卓越的多模态处理能力,能够流畅处理文本、图像、音频和视频等多种数据类型,并实时生成文本及语音输出。在OmniBench等权威多模态融合任务评测中,其性能表现创下新纪录。令人惊喜的是,它仅拥有70亿参数的小巧体积,这使得全模态大模
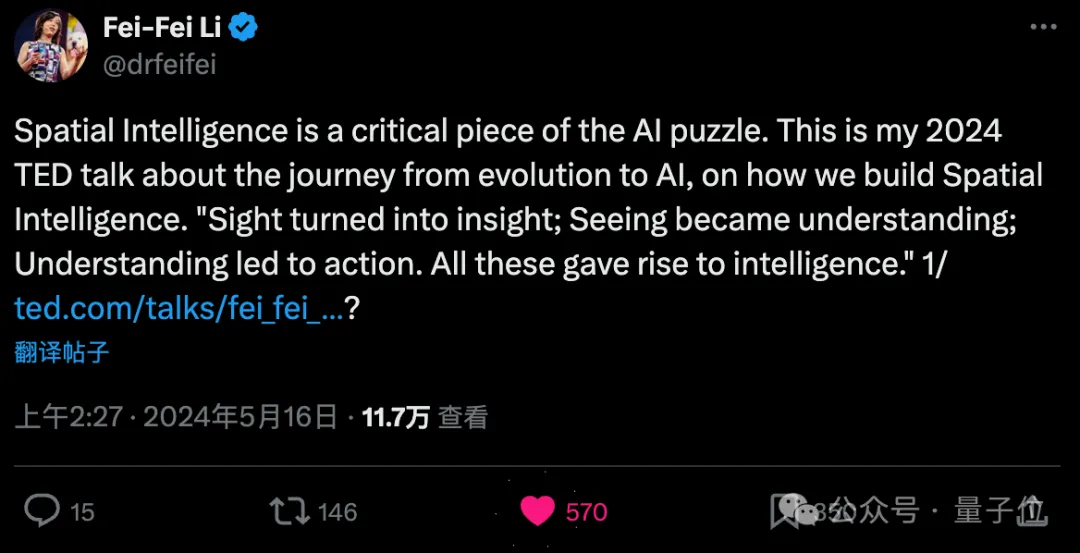
斯坦福李飞飞创业后,首次揭秘新概念“空间智能”。这不仅是她的创业方向,也是指引她的“北极星”,被她认为是“解决人工智能难题的关键拼图”。视觉化为洞察;看见成为理解;理解导致行动。在李飞飞15分钟TED演讲完整公开的基础上,从数亿年前生命进化的起源开始,到人类如何不满足于自然赋予而发展人工智能,直到下一步如何构建空间智能。9年前,李飞飞在同一个舞台上,向世界介绍了刚诞生不久的ImageNet——这一轮深度学习爆发的起点之一。她本人也向网友自我安利:如果把两个视频都看了,你就能对过去10年的计算机视觉、空间智





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



