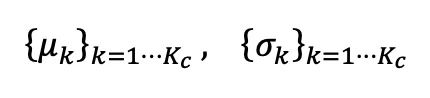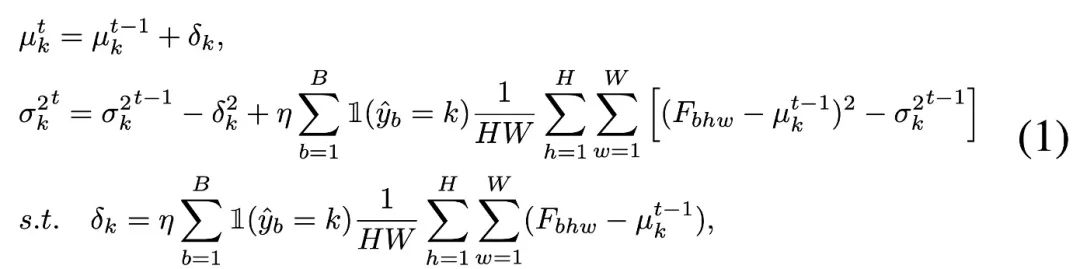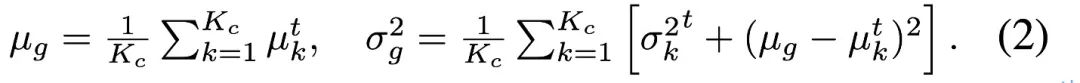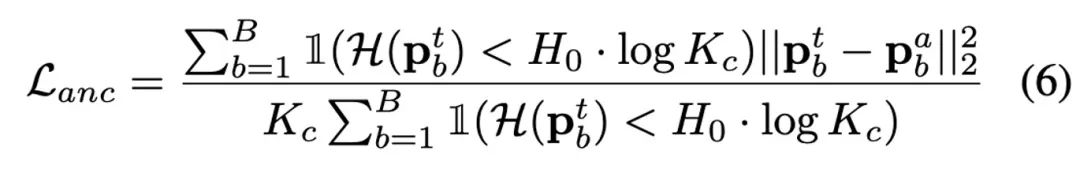当前位置:

首页 > 业界资讯 > TRIBE在多真实场景下取得SOTA,确保测试时领域适应的鲁棒性

TRIBE在多真实场景下取得SOTA,确保测试时领域适应的鲁棒性

测试时领域适应(Test-TimeAdaptation)的目的是使源域模型适应推理阶段的测试数据,在适应未知的图像损坏领域取得了出色的效果。然而,当前许多方法都缺乏对真实世界场景中测试数据流的考虑,例如:测试数据流应当是时变分布(而非传统领域适应中的固定分布)测试数据流可能存在局部类别相关性(而非完全独立同分布采样)测试数据流在较长时间里仍表现全局类别不平衡近日,华南理工、A*STAR和港中大(深圳)团队通过大量实验证明,这些真实场景下的测试数据流会对现有方法带来巨大挑战。该团队认为,最先进方法的失败首先

本文目录
    测试时领域适应(Test-Time Adaptation)的目的是使源域模型适应推理阶段的测试数据,在适应未知的图像损坏领域取得了出色的效果。然而,当前许多方法都缺乏对真实世界场景中测试数据流的考虑,例如:

    • 测试数据流应当是时变分布(而非传统领域适应中的固定分布)
    • 测试数据流可能存在局部类别相关性(而非完全独立同分布采样)
    • 测试数据流在较长时间里仍表现全局类别不平衡

    近日,华南理工、A*STAR 和港中大(深圳)团队通过大量实验证明,这些真实场景下的测试数据流会对现有方法带来巨大挑战。该团队认为,最先进方法的失败首先是由于不加区分地根据不平衡测试数据调整归一化层造成的。

    为此,研究团队提出了一种创新的平衡批归一化层 (Balanced BatchNorm Layer),以取代推理阶段的常规批归一化层。同时,他们发现仅靠自我训练(ST)在未知的测试数据流中进行学习,容易造成过度适应(伪标签类别不平衡、目标域并非固定领域)而导致在领域不断变化的情况下性能不佳。

    因此,该团队建议通过锚定损失 (Anchored Loss) 对模型更新进行正则化处理,从而改进持续领域转移下的自我训练,有助于显著提升模型的鲁棒性。最终,模型 TRIBE 在四个数据集、多种真实世界测试数据流设定下稳定达到 state-of-the-art 的表现,并大幅度超越已有的先进方法。研究论文已被 AAAI 2024 接收。

    AAAI 2024 | 测试时领域适应的鲁棒性得以保证,TRIBE在多真实场景下达到SOTA

    论文链接:https://arxiv.org/abs/2309.14949
    代码链接:https://github.com/Gorilla-Lab-SCUT/TRIBE

    引言

    深度神经网络的成功依赖于将训练好的模型推广到 i.i.d. 测试域的假设。然而,在实际应用中,分布外测试数据的鲁棒性,如不同的照明条件或恶劣天气造成的视觉损坏,是一个需要关注的问题。最近的研究显示,这种数据损失可能会严重影响预先训练好的模型的性能。重要的是,在部署前,测试数据的损坏(分布)通常是未知的,有时也不可预测。

    因此,调整预训练模型以适应推理阶段的测试数据分布是一个值得价值的新课题,即测试时领域适 (TTA)。此前,TTA 主要通过分布对齐 (TTAC++, TTT++),自监督训练 (AdaContrast) 和自训练 (Conjugate PL) 来实现,这些方法在多种视觉损坏测试数据中都带来了显著的稳健提升。

    现有的测试时领域适应(TTA)方法通常基于一些严格的测试数据假设,如稳定的类别分布、样本服从独立同分布采样以及固定的领域偏移。这些假设启发了许多研究者去探究真实世界中的测试数据流,如 CoTTA、NOTE、SAR 和 RoTTA 等。

    最近,对真实世界的 TTA 研究,如 SAR(ICLR 2023)和 RoTTA(CVPR 2023)主要关注局部类别不平衡和连续的领域偏移对 TTA 带来的挑战。局部类别不平衡通常是由于测试数据并非独立同分布采样而产生的。直接不加区分的领域适应将导致有偏置的分布估计。

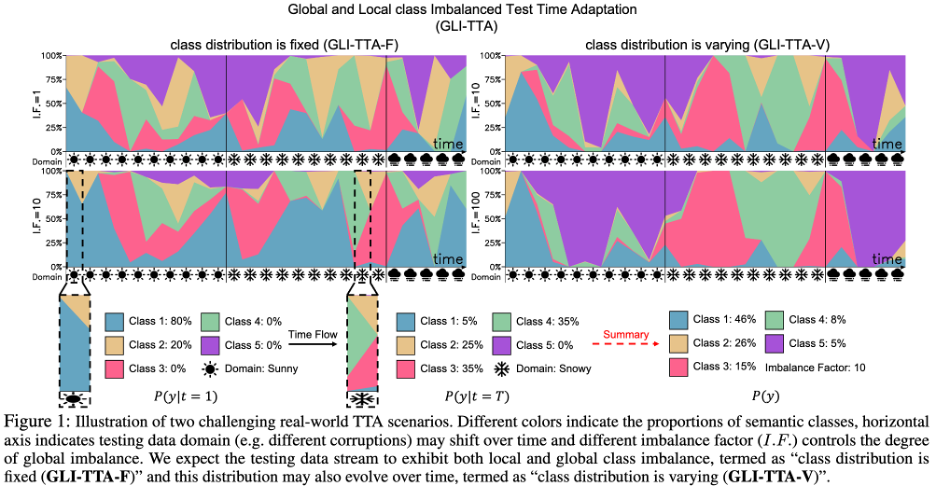
    最近有研究提出了指数式更新批归一化统计量(RoTTA)或实例级判别更新批归一化统计量(NOTE)来解决这个挑战。其研究目标是超越局部类不平衡的挑战,考虑到测试数据的总体分布可能严重失衡,类的分布也可能随着时间的推移而变化。在下图 1 中可以看到更具挑战性的场景示意图。
    AAAI 2024 | 测试时领域适应的鲁棒性得以保证,TRIBE在多真实场景下达到SOTA

    由于在推理阶段之前,测试数据中的类别流行率未知,而且模型可能会通过盲目的测试时间调整偏向于多数类别,这使得现有的 TTA 方法变得无效。根据经验观察,对于依靠当前批数据来估计全局统计量来更新归一化层的方法来说,这个问题变得尤为突出(BN, PL, TENT, CoTTA 等)。

    这主要是由于:
    1.当前批数据会受到局部类别不平衡的影响带来有偏置的整体分布估计;
    2.从全局类别不平衡的整个测试数据中估计出单一的全局分布,全局分布很容易偏向多数类,导致内部协变量偏移。

    为了避免有偏差的批归一化(BN),该团队提出了一种平衡的批归一化层(Balanced Batch Normalization Layer),即对每个单独类别的分布进行建模,并从类别分布中提取全局分布。平衡的批归一化层允许在局部和全局类别不平衡的测试数据流下得到分布的类平衡估计。

    随着时间的推移,领域转移在现实世界的测试数据中经常发生,例如照明 / 天气条件的逐渐变化。这给现有的 TTA 方法带来了另一个挑战,TTA 模型可能由于过度适应到领域 A 而当从领域 A 切换到领域 B 时出现矛盾。

    为了缓解过度适应到某个短时领域,CoTTA 随机还原参数,EATA 用 fisher information 对参数进行正则化约束。尽管如此,这些方法仍然没有明确解决测试数据领域中层出不穷的挑战。

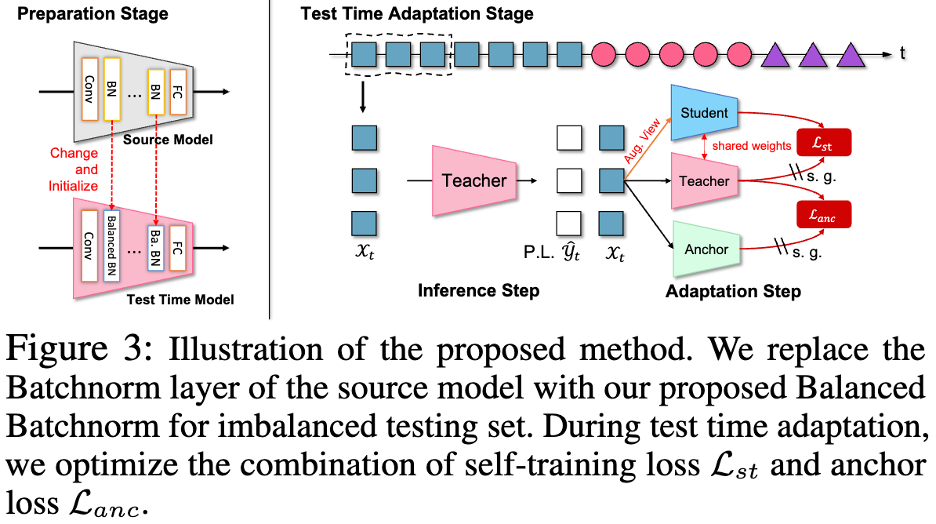
    本文在两分支自训练架构的基础上引入了一个锚定网络(Anchor Network)组成三网络自训练模型(Tri-Net Self-Training)。锚定网络是一个冻结的源模型,但允许通过测试样本调整批归一化层中的统计量而非参数。并提出了一个锚定损失利用锚定网络的输出来正则化教师模型的输出以避免网络过度适应到局部分布中。

    最终模型结合了三网络自训练模型和平衡的批归一化层(TRI-net self-training with BalancEd normalization, TRIBE)在较为宽泛的的可调节学习率的范围里表现出一致的优越性能。在四个数据集和多种真实世界数据流下显示了大幅性能提升,展示了独一档的稳定性和鲁棒性。

    方法介绍

    论文方法分为三部分:
    • 介绍真实世界下的 TTA 协议;
    • 平衡的批归一化;
    • 三网络自训练模型。

    真实世界下的 TTA 协议

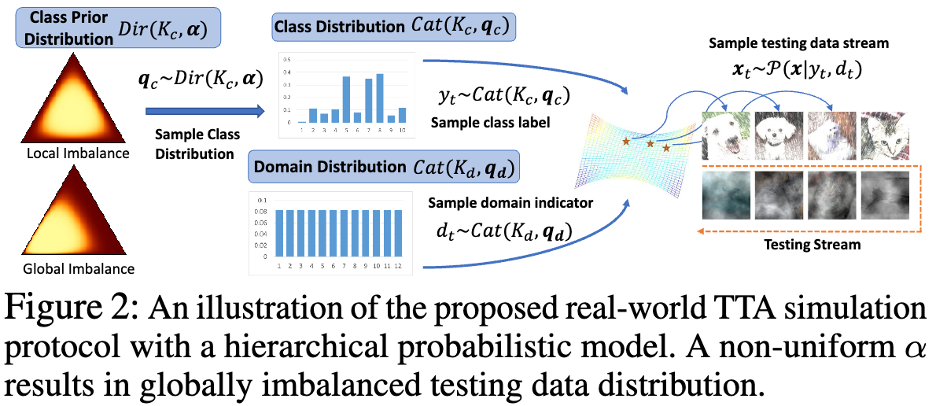
    作者采用了数学概率模型对真实世界下具有局部类别不平衡和全局类别不平衡的测试数据流,以及随着时间变化的领域分布进行了建模。如下图 2 所示。

    AAAI 2024 | 测试时领域适应的鲁棒性得以保证,TRIBE在多真实场景下达到SOTA

    平衡的批归一化

    为了纠正不平衡测试数据对 BN 统计量产生的估计偏置,作者提出了一个平衡批归一化层,该层为每个语义类分别维护了一对统计量,表示为:

    AAAI 2024 | 测试时领域适应的鲁棒性得以保证,TRIBE在多真实场景下达到SOTA

    为了更新类别统计量,作者在伪标签预测的帮助下应用了高效的迭代更新方法,如下所示:

    AAAI 2024 | 测试时领域适应的鲁棒性得以保证,TRIBE在多真实场景下达到SOTA


    通过伪标签对各个类别数据的采样点进行单独统计,并通过下式重新得到类别平衡下的整体分布统计量,以此来对齐用类别平衡的源数据学习好的特征空间。AAAI 2024 | 测试时领域适应的鲁棒性得以保证,TRIBE在多真实场景下达到SOTA
    在某些特殊情况下,作者发现当类别数量较多AAAI 2024 | 测试时领域适应的鲁棒性得以保证,TRIBE在多真实场景下达到SOTA或伪标签准确率较低 (accuracy<0.5) 的情况下,以上的类别独立的更新策略效果没那么明显。因此,他们进一步用超参数 γ 来融合类别无关更新策略和类别独立更新策略,如下式:
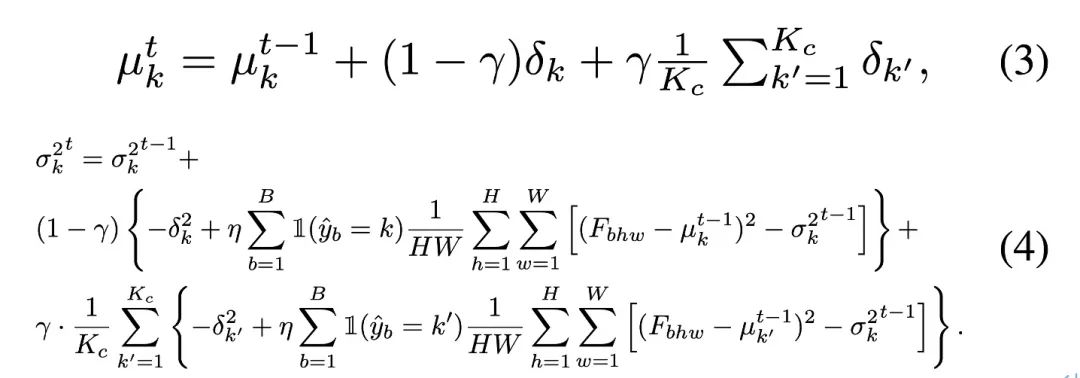
    AAAI 2024 | 测试时领域适应的鲁棒性得以保证,TRIBE在多真实场景下达到SOTA

    通过进一步分析和观察,作者发现当 γ=1 时,整个更新策略就退化成了 RoTTA 中的 RobustBN 的更新策略,当 γ=0 时是纯粹的类别独立的更新策略,因此,当 γ 取值 0~1 时可以适应到各种情况下。

    三网络自训练模型

    作者在现有的学生 - 教师模型的基础上,添加了一个锚定网络分支,并引入了锚定损失来约束教师网络的预测分布。这种设计受到了 TTAC++ 的启发。TTAC++ 指出在测试数据流上仅靠自我训练会容易导致确认偏置的积累,这个问题在本文中的真实世界中的测试数据流上更加严重。TTAC++ 采用了从源域收集到的统计信息实现领域对齐正则化,但对于 Fully TTA 设定来说,这个源域信息不可收集。

    同时,作者也收获了另一个启示,无监督领域对齐的成功是基于两个领域分布相对高重叠率的假设。因此,作者仅调整了 BN 统计量的冻结源域模型来对教师模型进行正则化,避免教师模型的预测分布偏离源模型的预测分布太远(这破坏了之前的两者分布高重合率的经验观测)。大量实验证明,本文中的发现与创新是正确的且鲁棒的。以下是锚定损失的表达式:

    AAAI 2024 | 测试时领域适应的鲁棒性得以保证,TRIBE在多真实场景下达到SOTA

     下图展示了 TRIBE 网络的框架图:

    AAAI 2024 | 测试时领域适应的鲁棒性得以保证,TRIBE在多真实场景下达到SOTA

    实验部分

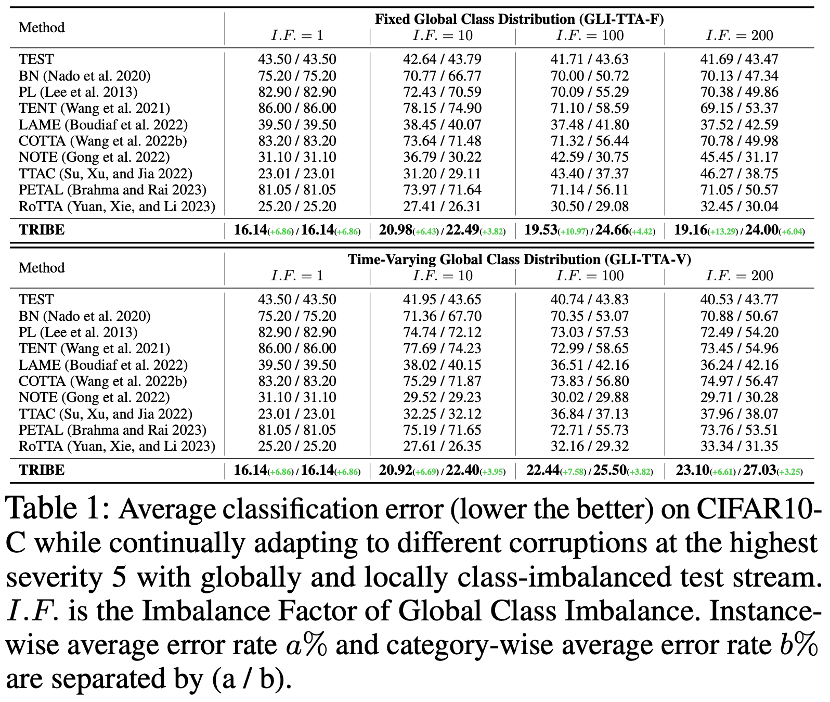
    论文作者在 4 个数据集上,以两种真实世界 TTA 协议为基准,对 TRIBE 进行了验证。两种真实世界 TTA 协议分别是全局类分布固定的 GLI-TTA-F 和全局类分布不固定的 GLI-TTA-V。

    AAAI 2024 | 测试时领域适应的鲁棒性得以保证,TRIBE在多真实场景下达到SOTA

    上表展示了 CIFAR10-C 数据集两种协议不同不平衡系数下的表现,可以得到以下结论:

    1.只有 LAME, TTAC, NOTE, RoTTA 和论文提出的 TRIBE 超过了 TEST 的基准线,表明了真实测试流下更加鲁棒的 TTA 方法的必要性。

    2.全局类别不平衡对现有的 TTA 方法带来了巨大挑战,如先前的 SOTA 方法 RoTTA 在 I.F.=1 时表现为错误率 25.20% 但在 I.F.=200 时错误率升到了 32.45%,相比之下,TRIBE 能稳定地展示相对较好的性能。

    3. TRIBE 的一致性具有绝对优势,超越了先前的所有方法,并在全局类别平衡的设定下 (I.F.=1) 超越先前 SOTA (TTAC) 约 7%,在更加困难的全局类别不平衡 (I.F.=200) 的设定下获得了约 13% 的性能提升。

    4.从 I.F.=10 到 I.F.=200,其他 TTA 方法随着不平衡度增加,呈现性能下跌的趋势。而 TRIBE 能维持较为稳定的性能表现。这归因于引入了平衡批归一化层,更好地考虑了严重的类别不平衡和锚定损失,这避免了跨不同领域的过度适应。
     
    更多数据集的结果可查阅论文原文。

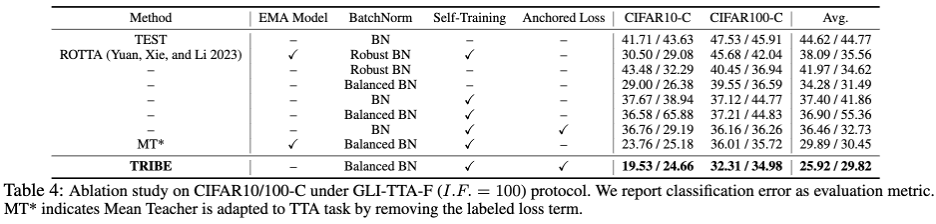
    此外,表 4 展示了详细的模块化消融,有以下几个观测性结论:

    AAAI 2024 | 测试时领域适应的鲁棒性得以保证,TRIBE在多真实场景下达到SOTA

    1.仅将 BN 替换成平衡批归一化层 (Balanced BN),不更新任何模型参数,只通过 forward 更新 BN 统计量,就能带来 10.24% (44.62 -> 34.28) 的性能提升,并超越了 Robust BN 的错误率 41.97%。

    2.Anchored Loss 结合 Self-Training,无论是在之前 BN 结构下还是最新的 Balanced BN 结构下,都得到了性能的提升,并超越了 EMA Model 的正则化效果。
     
    本文的其余部分和长达 9 页的附录最终呈现了 17 个详细表格结果,从多个维度展示了 TRIBE 的稳定性、鲁棒性和优越性。附录中也含有对平衡批归一化层的更加详细的理论推导和解释。

    总结和展望

    为应对真实世界中 non-i.i.d. 测试数据流、全局类不平衡和持续的领域转移等诸多挑战,研究团队深入探索了如何改进测试时领域适应算法的鲁棒性。为了适应不平衡的测试数据,作者提出了一个平衡批归一化层(Balanced Batchnorm Layer),以实现对统计量的无偏估计,进而提出了一种包含学生网络、教师网络和锚定网络的三层网络结构,以规范基于自我训练的 TTA。

    但本文仍然存在不足和改进的空间,由于大量的实验和出发点都基于分类任务和 BN 模块,因此对于其他任务和基于 Transformer 模型的适配程度仍然未知。这些问题值得后续工作进一步研究和探索。
    本站声明:本文内容由网友自发贡献,版权归原作者所有,本站不承担相应法律责任。如您发现有涉嫌抄袭侵权的内容,请联系bd@zhengruan.com
    作者最新文章
    业界资讯
    相关文章 更多
    Llama3训练每3小时崩一次?豆包大模型、港大团队为脆皮万卡训练提效
    Llama3训练每3小时崩一次?豆包大模型、港大团队为脆皮万卡训练提效

    伴随大模型迭代速度越来越快,训练集群规模越来越大,高频率的软硬件故障已经成为阻碍训练效率进一步提高的痛点,检查点(Checkpoint)系统在训练过程中负责状态的存储和恢复,已经成为克服训练故障、保障训练进度和提高训练效率的关键。近日,字节跳动豆包大模型团队与香港大学联合提出了ByteCheckpoint。这是一个PyTorch原生,兼容多个训练框架,支持Checkpoint的高效读写和自动重新切分的大模型Checkpointing系统,相比现有方法有显著性能提升和易用性优势。本文介绍了大模型训练提效中C

    TPAMI 2024 | ProCo: 无限contrastive pairs的长尾对比学习
    TPAMI 2024 | ProCo: 无限contrastive pairs的长尾对比学习

    AIxiv专栏是本站发布学术、技术内容的栏目。过去数年,本站AIxiv专栏接收报道了2000多篇内容,覆盖全球各大高校与企业的顶级实验室,有效促进了学术交流与传播。如果您有优秀的工作想要分享,欢迎投稿或者联系报道。投稿邮箱:liyazhou@jiqizhixin.com;zhaoyunfeng@jiqizhixin.com本论文第一作者杜超群是清华大学自动化系2020级直博生。导师为黄高副教授。此前于清华大学物理系获理学学士学位。研究兴趣为不同数据分布上的模型泛化和鲁棒性研究,如长尾学习,半监督学习,迁移

    亚马逊云创新「神经稀疏检索」:仅需要文本匹配就能实现语义搜索
    亚马逊云创新「神经稀疏检索」:仅需要文本匹配就能实现语义搜索

    AIxiv专栏是本站发布学术、技术内容的栏目。过去数年,本站AIxiv专栏接收报道了2000多篇内容,覆盖全球各大高校与企业的顶级实验室,有效促进了学术交流与传播。如果您有优秀的工作想要分享,欢迎投稿或者联系报道。投稿邮箱:liyazhou@jiqizhixin.com;zhaoyunfeng@jiqizhixin.com本文作者是来自OpenSearch中国研发团队的机器学习负责人杨扬博士以及机器学习工程师耿志超和管聪。OpenSearch是一个由亚马逊云科技发起的纯开源搜索和实时分析引擎项目。目前软件

    将图像自动文本化,图像描述质量更高、更准确了
    将图像自动文本化,图像描述质量更高、更准确了

    AIxiv专栏是本站发布学术、技术内容的栏目。过去数年,本站AIxiv专栏接收报道了2000多篇内容,覆盖全球各大高校与企业的顶级实验室,有效促进了学术交流与传播。如果您有优秀的工作想要分享,欢迎投稿或者联系报道。投稿邮箱:liyazhou@jiqizhixin.com;zhaoyunfeng@jiqizhixin.com皮仁杰:香港科技大学博士三年级学生,师从张潼教授和周晓方教授。于2024年获得苹果奖学金。目前主要研究方向是多模态大语言模型和数据为中心的AI。张鉴殊:武汉大学本科三年级学生,目前在张潼
    告别逐一标注,一个提示实现批量图片分割,高效又准确
    告别逐一标注,一个提示实现批量图片分割,高效又准确

    仅需一个任务描述,即可一键分割所有图片!SegmentationAnythingModel(SAM)的提出在图像分割领域引起了巨大的关注,其卓越的泛化性能引发了广泛的兴趣。然而,尽管如此,SAM仍面临一个无法回避的问题:为了使SAM能够准确地分割出目标物体的位置,每张图片都需要手动提供一个独特的视觉提示。如下图所示,即使点击的是同一物体(图(b)-(d)),微小位置变化都会导致分割结果的显著差异。这是因为视觉提示语义信息的缺乏,即使提供了想要分割的目标物体上,仍然可能引发歧义。框提示和涂鸦提示(图(e)(
    CVPR 2024 | 分割一切模型SAM泛化能力差?域适应策略给解决了
    CVPR 2024 | 分割一切模型SAM泛化能力差?域适应策略给解决了

    第一个针对「SegmentAnything」大模型的域适应策略来了!相关论文已被CVPR2024接收。引言大语言模型(LLMs)的成功激发了计算机视觉领域探索分割基础模型的兴趣。这些基础分割模型通常通过PromptEngineer来进行zero/few图像分割。其中,SegmentAnythingModel(SAM)是最先进的图像分割基础模型。图SAM在多个下游任务上表现不佳但是最近的研究表明,SAM在多种下游任务中并非具有很强的鲁棒性与泛化性,例如在医学图像、伪装物体、添加干扰的自然图像等领域表现较差。

    ECCV 2024 | 提升GPT-4V、Gemini检测任务性能,你需要这种提示范式
    ECCV 2024 | 提升GPT-4V、Gemini检测任务性能,你需要这种提示范式

    AIxiv专栏是本站发布学术、技术内容的栏目。过去数年,本站AIxiv专栏接收报道了2000多篇内容,覆盖全球各大高校与企业的顶级实验室,有效促进了学术交流与传播。如果您有优秀的工作想要分享,欢迎投稿或者联系报道。投稿邮箱:liyazhou@jiqizhixin.com;zhaoyunfeng@jiqizhixin.com本文作者来自浙江大学、上海人工智能实验室、香港中文大学、悉尼大学和牛津大学。作者列表:吴逸璇,王逸舟,唐诗翔,吴文灏,贺通,WanliOuyang,PhilipTorr,JianWu。其
    贾佳亚团队联手剑桥清华等共推评测新范式 一秒侦破大模型“高分低能”
    贾佳亚团队联手剑桥清华等共推评测新范式 一秒侦破大模型“高分低能”

    颠覆过往大模型评测标准,最新、最全、最权威的测评数据集MR-Ben来了!这是继今年4月发布堪称GPT-4+DALL-E-3的王炸产品超强视觉语言模型Mini-Gemini后,港中文贾佳亚团队再次提出的极具代表性的作品。在MR-Ben的“监督”下,大模型不仅要像学生那样会答题,还要像老师那样会阅卷,真实的推理能力无所遁形。MR-Ben细致地评测了不少国内外一线的开源和闭源模型,如GPT4-Turbo、Cluade3.5-Sonnet、Mistral-Large、Zhipu-GLM4、

    ICML 2024高分论文 | 零阶优化器微调大模型,大幅降低内存
    ICML 2024高分论文 | 零阶优化器微调大模型,大幅降低内存

    AIxiv专栏是本站发布学术、技术内容的栏目。过去数年,本站AIxiv专栏接收报道了2000多篇内容,覆盖全球各大高校与企业的顶级实验室,有效促进了学术交流与传播。如果您有优秀的工作想要分享,欢迎投稿或者联系报道。投稿邮箱:liyazhou@jiqizhixin.com;zhaoyunfeng@jiqizhixin.com本文共同第一作者简介:张逸骅:密歇根州立大学计算机系博士三年级学生,师从SijiaLiu教授,主要研究方向是大模型的安全、隐私和效率问题。李平治:本科毕业于中国科学技术大学,将于2024

    哈工大提出创新迭代推理框架 DPE-MNER :充分发挥多模态表示潜力
    哈工大提出创新迭代推理框架 DPE-MNER :充分发挥多模态表示潜力

    AIxiv专栏是本站发布学术、技术内容的栏目。过去数年,本站AIxiv专栏接收报道了2000多篇内容,覆盖全球各大高校与企业的顶级实验室,有效促进了学术交流与传播。如果您有优秀的工作想要分享,欢迎投稿或者联系报道。投稿邮箱:liyazhou@jiqizhixin.com;zhaoyunfeng@jiqizhixin.com该文章的作者团队来自于哈工大社会计算与信息检索研究中心,作者团队构成:郑子豪、张梓涵、王泽鑫、付瑞吉、刘铭、王仲远、秦兵。多模态表示多模态命名实体识别,作为构建多模态知识图谱的一项基础而


    查看更多
    精品专题 更多
    装机必备
    装机必备

    正软商城装机必备专区,精选办公、浏览器、安全防护、影音播放、压缩解压、设计创作和系统工具等电脑常用正版软件,帮助用户快速完成新电脑软件配置。

    Windows
    Windows

    正软商城Windows软件专区,汇集适用于Windows电脑的办公、设计、安全防护、影音播放、开发工具和系统优化软件,提供软件介绍、系统要求、正版授权及购买下载服务。

    PDF教程
    PDF教程

    正软商城PDF教程频道提供PDF编辑、转换、合并、拆分、压缩及格式处理方法,同时介绍常用PDF软件和工具的使用技巧。

    Mac软件 更多
    讯飞智作 网页版
    讯飞智作 网页版
    Windows/ macOS/ Linux

    讯飞智作是一款基于语音合成技术、虚拟人驱动技术与数字人形象声音构建能力的 AI 数字人音视频创作平台。

    火山引擎 网页版
    火山引擎 网页版
    Windows/ macOS/ Linux

    火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。

    Aperty macOS版
    Aperty macOS版
    macOS

    Aperty 是 Skylum 推出的 AI 人像修图软件,支持自然肤质修饰、瑕疵处理、面部与身体调整、预设及批量同步。

    WINDOWS 更多
    讯飞智作 网页版
    讯飞智作 网页版
    Windows/ macOS/ Linux

    讯飞智作是一款基于语音合成技术、虚拟人驱动技术与数字人形象声音构建能力的 AI 数字人音视频创作平台。

    火山引擎 网页版
    火山引擎 网页版
    Windows/ macOS/ Linux

    火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。

    PixTV 网页版
    PixTV 网页版
    Windows

    PixTV 是一款在浏览器中使用的 AI 视觉内容创作平台,提供图片、视频、音频、文字生成、AI 分镜、局部重绘、提示词反推和无限画布等工具,适合短剧、漫剧、广告及社交媒体内容制作。