

揭秘Java爬虫的效用:优秀的网络数据采集工具
网络数据采集利器:探秘Java爬虫抓取网页数据的实用工具导语:随着互联网的发展,海量的数据被不断产生和更新,对这些数据进行采集和处理,成为了许多企业和个人的需求。为了满足这一需求,爬虫技术应运而生。本文将探讨Java语言下,用于抓取网页数据的实用工具,并附带具体代码示例。爬虫技术简介爬虫技术是指利用程序自动化地访问并分析网络数据,从而获取所需的信息。在Jav
网络数据采集利器:探秘Java爬虫抓取网页数据的实用工具
导语:随着互联网的发展,海量的数据被不断产生和更新,对这些数据进行采集和处理,成为了许多企业和个人的需求。为了满足这一需求,爬虫技术应运而生。本文将探讨Java语言下,用于抓取网页数据的实用工具,并附带具体代码示例。
爬虫技术简介
爬虫技术是指利用程序自动化地访问并分析网络数据,从而获取所需的信息。在Java领域中,常用的爬虫实现方式包括使用HttpURLConnection、Jsoup和HttpClient三个工具。下面分别介绍这三种工具的使用方法。
- HttpURLConnection
HttpURLConnection是Java自带的一个包,用于发送HTTP请求和接收HTTP响应。通过用HttpURLConnection读取网页的HTML代码,可以获取到相关的数据。
下面是一个使用HttpURLConnection实现简单爬虫功能的示例代码:
import java.io.BufferedReader;
import java.io.IOException;
import java.io.InputStreamReader;
import java.net.HttpURLConnection;
import java.net.URL;

public class HttpURLConnectionExample {

    public static void main(String[] args) throws IOException {
        // 设置需要爬取的URL
        String url = "http://example.com";

        // 创建URL对象
        URL obj = new URL(url);
        // 打开连接
        HttpURLConnection con = (HttpURLConnection) obj.openConnection();

        // 获取响应码
        int responseCode = con.getResponseCode();
        System.out.println("Response Code: " + responseCode);

        // 创建BufferedReader对象,读取网页内容
        BufferedReader in = new BufferedReader(new InputStreamReader(con.getInputStream()));
        String inputLine;
        StringBuilder content = new StringBuilder();
        while ((inputLine = in.readLine()) != null) {
            content.append(inputLine);
        }
        in.close();

        // 输出网页内容
        System.out.println(content);
    }
}- Jsoup
Jsoup是一款非常强大的Java HTML解析器,可用于解析、处理和操作HTML文档。使用Jsoup,我们可以轻松地获取网页提取所需的数据。
下面是一个使用Jsoup实现爬虫功能的示例代码:
import org.jsoup.Jsoup;
import org.jsoup.nodes.Document;
import org.jsoup.nodes.Element;
import org.jsoup.select.Elements;

import java.io.IOException;

public class JsoupExample {

    public static void main(String[] args) throws IOException {
        // 设置需要爬取的URL
        String url = "http://example.com";

        // 使用Jsoup连接到网页
        Document doc = Jsoup.connect(url).get();

        // 获取所有的a标签
        Elements links = doc.getElementsByTag("a");
        for (Element link : links) {
            // 输出a标签的href属性值和文本内容
            System.out.println("Link: " + link.attr("href") + ", Text: " + link.text());
        }
    }
}- HttpClient
HttpClient是Apache开源组织提供的一个Java库,用于发送HTTP请求和处理HTTP响应。相比于HttpURLConnection,HttpClient具有更加灵活和强大的功能。
下面是一个使用HttpClient实现爬虫功能的示例代码:
import org.apache.http.HttpEntity;
import org.apache.http.HttpResponse;
import org.apache.http.client.HttpClient;
import org.apache.http.client.methods.HttpGet;
import org.apache.http.impl.client.DefaultHttpClient;
import org.apache.http.util.EntityUtils;

import java.io.IOException;

public class HttpClientExample {

    public static void main(String[] args) throws IOException {
        // 设置需要爬取的URL
        String url = "http://example.com";

        // 创建HttpClient对象
        HttpClient client = new DefaultHttpClient();
        // 创建HttpGet对象,设置URL
        HttpGet request = new HttpGet(url);

        // 发送HTTP请求
        HttpResponse response = client.execute(request);

        // 获取响应实体
        HttpEntity entity = response.getEntity();

        // 将实体转为字符串
        String content = EntityUtils.toString(entity);

        // 输出网页内容
        System.out.println(content);
    }
}
总结
本文介绍了在Java语言下利用HttpURLConnection、Jsoup和HttpClient三个工具进行爬虫的方法,并附带相应的代码示例。这些工具具有各自的特点和优势,在实际开发中根据需求选择合适的工具非常重要。同时,我们也需要注意合法合规地使用爬虫技术,遵守法律和道德规范,确保数据采集行为的合法性。
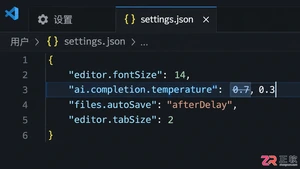
想知道如何让AI写出的代码更贴合你的习惯?本文手把手教你在VS Code中调整Codex相关模型参数,通过修改配置文件优化温度值和令牌限制,解决代码建议不准确或响应慢的问题。
通过实测展示Claude Code在终端中如何理解自然语言指令、自动修改代码文件并处理复杂编程任务,帮助开发者评估其实际辅助能力。
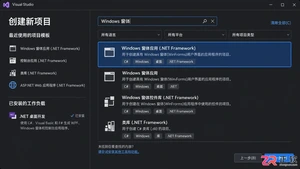
本教程详细讲解如何使用Visual Studio创建WinForms项目,通过添加按钮和标签控件并编写点击事件代码,实现一个基础的计数器功能,适合C#初学者快速上手Windows窗体应用开发。
详解Cursor编辑器中自动补全功能的开启与优化设置,涵盖Tab触发机制、上下文窗口调整及模型切换,帮助开发者解决补全延迟、干扰大等问题,提升编码流畅度。
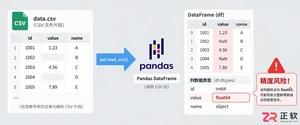
详解Pandas中数据格式转换的核心方法,包括astype强制转换、to_numeric容错处理及日期解析技巧,解决常见类型错误并提升数据处理效率。
详细介绍在Visual Studio Code中安装Chinese (Simplified)语言包的方法,包括通过扩展市场搜索、安装及自动重启切换至简体中文界面的完整步骤,帮助开发者快速将编辑器本地化。
针对Cursor安装包默认锁定C盘且无路径选择界面的问题,提供通过手动移动文件并创建目录联结(Symbolic Link)的解决方案,实现将软件安装在其他磁盘分区。
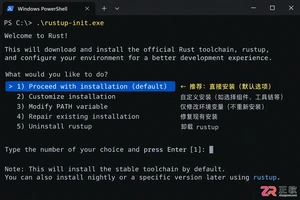
详解Windows系统下Rust语言的安装步骤,重点解析rustup工具链管理机制,解决环境变量配置错误及MSVC链接器缺失问题,提供可复制的命令验证方法与常见报错的因果排查思路。
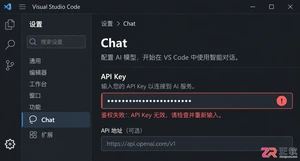
详解VS Code中Chat插件的安装与核心配置步骤,重点解决API连接失败、响应慢等常见问题,通过优化上下文设置提升代码生成质量,适合希望集成AI辅助工具的开发者阅读。
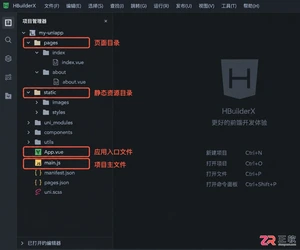
本教程通过实战案例详解UniApp开发流程,包括项目初始化、页面结构解析、数据绑定与事件处理,帮助初学者快速上手跨平台应用开发。



Blender 是一款免费开源、跨平台的专业 3D 创作软件,集建模、动画、渲染、视频编辑与视觉合成等功能于一体,广泛应用于影视动画、游戏设计和建筑可视化等领域。软件支持 Cycles 物理渲染器与 Eevee 实时渲染引擎,并提供多边形建模、骨骼绑定、物理模拟等专业工具。Blender 兼容 Windows、macOS 和 Linux 系统,安装包轻巧、运行流畅,依托活跃的全球开发者社区持续更新,是从初学者到专业创作者都值得选择的正版 3D 创作工具。


赤友清理大师是一款为 Mac 设计的智能清理优化工具,可精准扫描垃圾、大文件、重复文件等,释放磁盘空间。做扫描整理、文字提取和表格转换时,它能把识别后的处理步骤接得更顺,资料录入这类场景会省下不少时间。
Blender 是一款免费开源、跨平台的专业 3D 创作软件,集建模、动画、渲染、视频编辑与视觉合成等功能于一体,广泛应用于影视动画、游戏设计和建筑可视化等领域。软件支持 Cycles 物理渲染器与 Eevee 实时渲染引擎,并提供多边形建模、骨骼绑定、物理模拟等专业工具。Blender 兼容 Windows、macOS 和 Linux 系统,安装包轻巧、运行流畅,依托活跃的全球开发者社区持续更新,是从初学者到专业创作者都值得选择的正版 3D 创作工具。

Windows 10 是一款微软推出的经典操作系统,拥有硬件兼容性与多任务处理能力。它更偏向把系统状态查看和常用调节动作放在一起,适合需要持续观察和微调设备状态的场景。

极度公式是一款跨平台专业LaTeX公式识别编辑软件,支持OCR公式识别和多平台编辑。和使用说明,避免使用,享受完整功能与稳定支持。做扫描整理、文字提取和表格转换时,它能把识别后的处理步骤接得更顺,资料录入这类场景会省下不少时间。