

国内最大规模!中科曙光6万卡AI4S计算集群投入使用
引言:当算力成为新时代的“水电煤” 不知你是否注意到,我们正身处一个奇妙的拐点。从前,谈论技术突破,焦点多在算法模型;如今,风向悄然转变,一股更基础、更磅礴的力量——算力,正从幕后走向台前,成为驱动智能时代前行的核心引擎。这不再是实验室里的远景,而是真切发生在数据中心、云服务账单和产业竞争格局中的现
引言:当算力成为新时代的“水电煤”
不知你是否注意到,我们正身处一个奇妙的拐点。从前,谈论技术突破,焦点多在算法模型;如今,风向悄然转变,一股更基础、更磅礴的力量——算力,正从幕后走向台前,成为驱动智能时代前行的核心引擎。这不再是实验室里的远景,而是真切发生在数据中心、云服务账单和产业竞争格局中的现实。
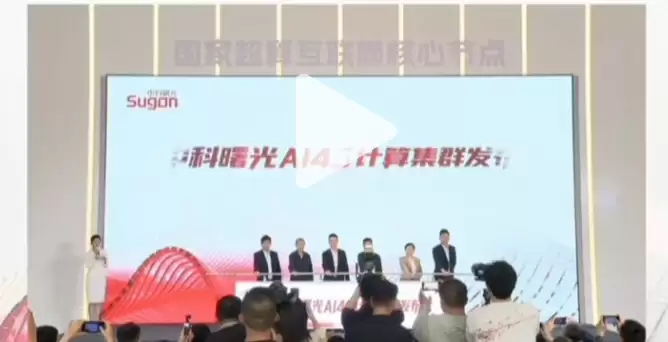
点击图片跳转视频
那么,这股算力浪潮究竟意味着什么?它仅仅是更快的芯片和更大的数据中心吗?答案远非如此简单。算力的爆发式增长,正在重新定义技术应用的边界、商业模式的逻辑乃至国家竞争力的基石。接下来,我们将从几个关键维度,拆解这场静默却深刻的变革。
一、 从“模型驱动”到“算力驱动”:范式转移进行时
回顾人工智能的发展历程,一个清晰的轨迹是:每一次重大飞跃,都伴随着对算力需求的指数级攀升。早期的规则系统、浅层机器学习,对计算资源的需求尚在可控范围内。然而,当深度学习,尤其是大规模预训练模型登上舞台,游戏规则彻底改变了。
训练一个千亿参数级别的模型,所需的算力消耗足以媲美一座小型城市数日的能耗。这带来一个根本性转变:算法的精妙构想,必须建立在坚实的算力地基之上。没有足够的算力支撑,再优秀的算法设计也只能是“巧妇难为无米之炊”。可以说,算力已经从支撑性的“配角”,升级为决定创新上限的“主角”。
二、 算力堆叠:不仅是“量”的竞赛,更是“效”的博弈
面对激增的需求,行业的第一反应往往是“堆硬件”。更先进的制程工艺、更庞大的集群规模,这确实是提升算力总量的直接路径。但问题随之而来:单纯的数量增长,是否可持续?
这里存在一个效率瓶颈。随着芯片制程逼近物理极限,性能提升的代价(成本与能耗)越来越高。于是,竞争的焦点开始从单纯的“峰值算力”向“有效算力”迁移。如何通过芯片架构创新(如存算一体、异构计算)、软件栈优化和系统级协同,让每一瓦特电力产生更多的有效计算,成为摆在所有玩家面前的核心课题。这场博弈,比拼的不仅是财力,更是全栈的技术深度与生态整合能力。
三、 应用场景下沉:从“云端巨兽”到“边缘毛细血管”
过去,海量算力几乎等同于集中的、超大规模的数据中心。如今,故事有了新的篇章。随着物联网、自动驾驶、实时交互AI的普及,对低延迟、高隐私、高可靠性的计算需求爆炸式增长。这催生了算力部署的“下沉”趋势——边缘计算。
想象一下,未来的智能工厂、自动驾驶汽车、家用机器人,它们需要在瞬间处理大量传感器数据并做出决策,将全部数据传回云端再等待反馈,显然不现实。因此,一部分算力必须前置,部署在靠近数据产生源的“边缘”。这意味着,算力网络正演变成一个层次化的复杂体系:云端负责重型训练和复杂全局分析,边缘端则处理实时推理和即时响应,二者协同构成智能的“神经系统”。
四、 生态之争:谁的平台,定义谁的未来
当算力成为一种普适性资源,其竞争维度便再次升维。单一的硬件或软件优势,已难以构筑长期壁垒。真正的决胜点,在于“生态”。
一个强大的算力生态包含什么?它至少需要:性能卓越且可持续迭代的硬件体系、能够充分释放硬件潜力的软件工具链和开发框架、丰富且易于获取的应用模型库、以及活跃的开发者社区。本质上,这是在争夺“标准”和“入口”。哪家平台能吸引更多开发者,能更高效地孵化创新应用,谁就能在下一轮产业周期中掌握定义权。历史经验表明,开放的生态往往比封闭的系统更具生命力和扩张性。
五、 挑战与展望:平衡的艺术
展望算力的未来,一片蓝海之下也暗流涌动。至少有几个平衡需要谨慎把握:
首先是创新与可持续的平衡。算力增长伴随巨大的能源消耗,绿色计算、液冷技术、可再生能源利用不再是可选项,而是生存与发展的必答题。
其次是集中与分布的平衡。如何在保障核心关键技术自主可控的同时,参与并塑造全球开放的算力协作网络,这是一道复杂的战略考题。
最后是投入与产出的平衡。算力基础设施投资巨大,如何通过商业模式的创新,让算力像水电一样既普惠又可计量地服务千行百业,真正将技术实力转化为经济动能,是商业化成功的关键。
结语:拥抱算力定义一切的新纪元
总而言之,我们正在步入一个由算力深度定义的新纪元。它不仅是技术进步的标尺,更是产业升级的燃料和国家安全的后盾。这场变革并非遥不可及,它已经渗透到从科研、商业到日常生活的每一个角落。
对于身处其中的每一个组织和个人而言,理解算力演进的内在逻辑,洞察其从底层硬件到顶层应用的传导链条,或许是在智能时代保持竞争力的重要一课。未来已来,而它的基石,正是我们今日所谈论和构建的——无处不在的智慧算力。
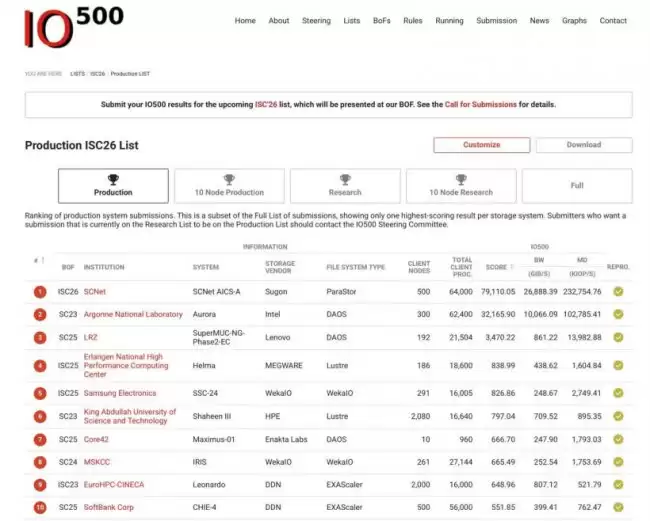
中科曙光ParaStorF9000分布式全闪存储系统在ISC2026上包揽IO500生产型总榜与10节点挑战榜双冠军,刷新世界纪录。该系统已在数万卡集群稳定运行超一年,可缩短千亿参数大模型部署时间一半、提升训练效率50%,全栈自研并完成414.7亿原子第一性原理精度模拟。
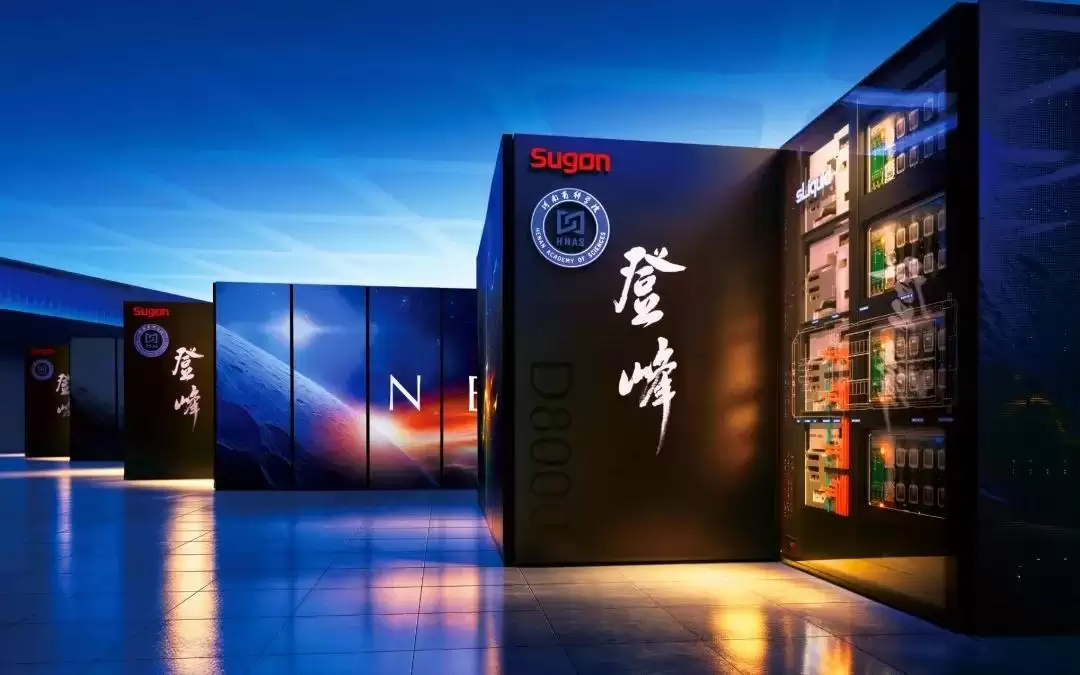
中国首个全国产10万卡AI超集群“曙光8000(登峰)”落成并接入国家超算互联网,实现超智融合与全精度覆盖,全链路自研,采用浸没式相变液冷技术,能效显著优化,标志着算力进入十万卡级时代。
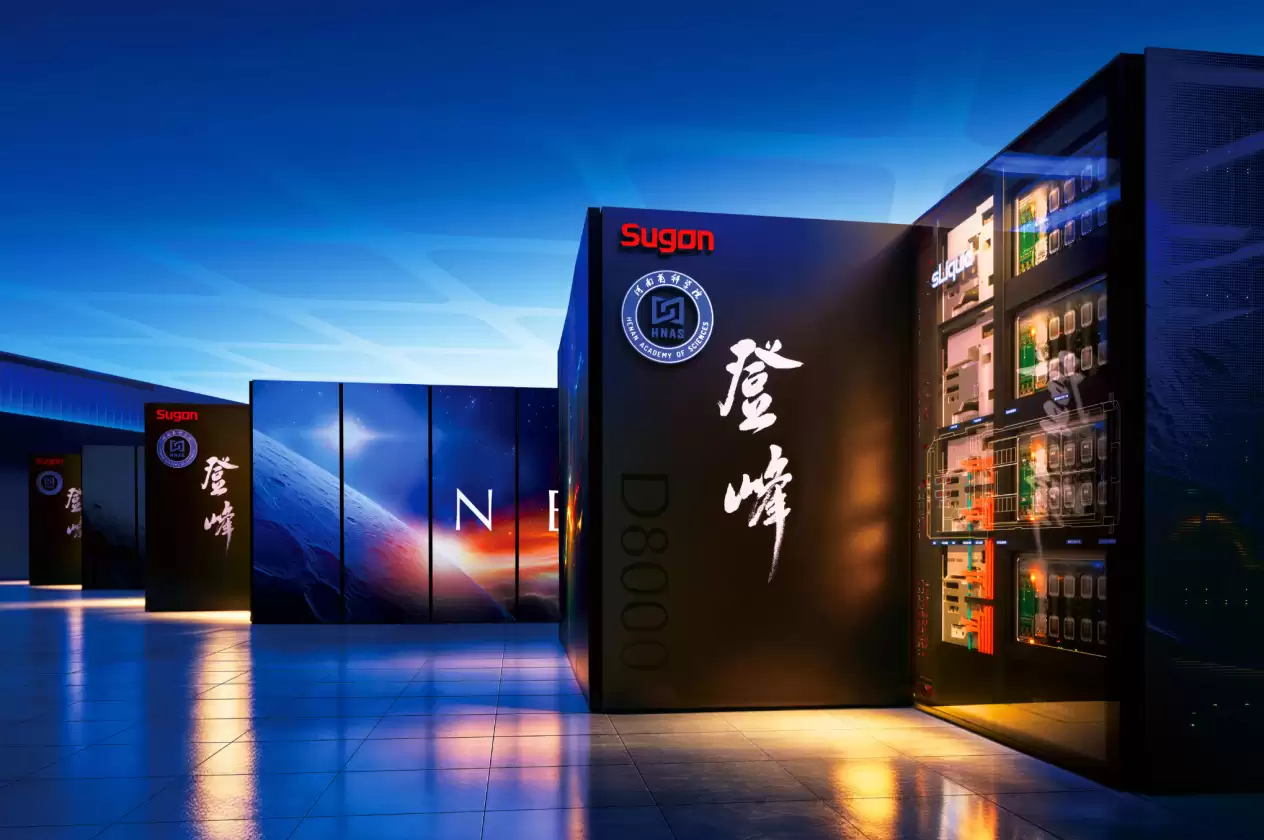
中科曙光建成国内首个全国产十万卡AI超集群曙光8000,采用“原生超智融合”架构,实现全类型计算一体化。集群搭载自研ParaStor存储、400G原生无损网络及浸没相变液冷,配合Gridview7.0智能平台,攻克大规模算力瓶颈,已应用于大模型、科学计算等领域,标志国产AI基础设施迈入十万卡阶段。
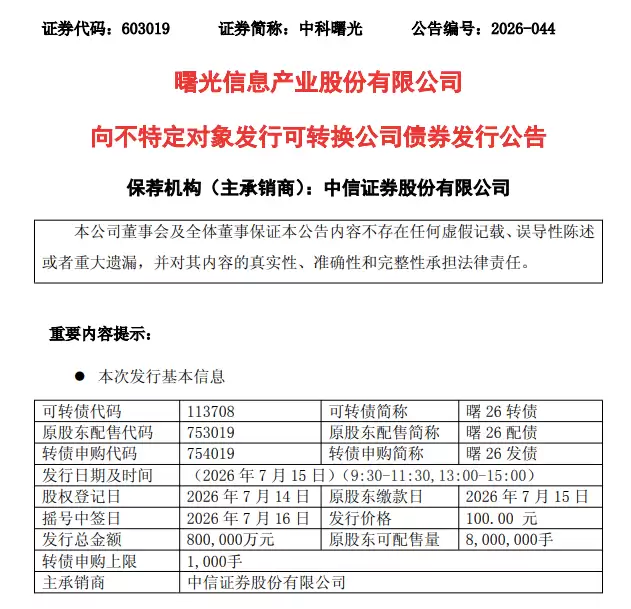
中科曙光于7月13日宣布发行80亿元可转债“曙26转债”,7月15日申购。原股东优先配售,社会公众可网上申购,申购时无需缴款。债券期限六年,初始转股价108.89元/股,票面利率逐年递增,到期赎回价105%。
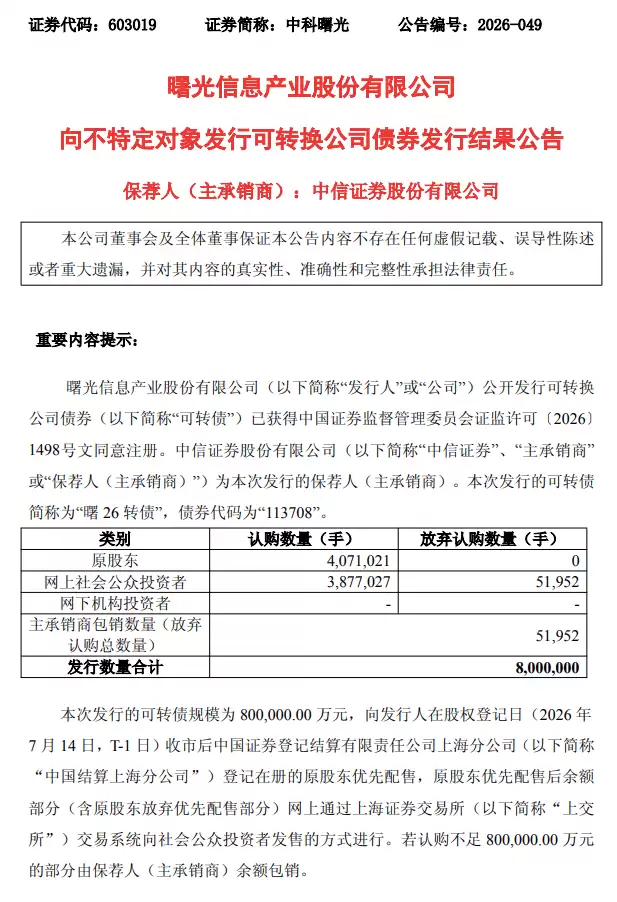
中科曙光发行80亿元“曙26转债”,原股东配售40.71亿元,网上认购38.77亿元,弃购5195.2万元由主承销商中信证券包销,包销比例仅0.65%,显示市场认购热情较高,资金面充裕。
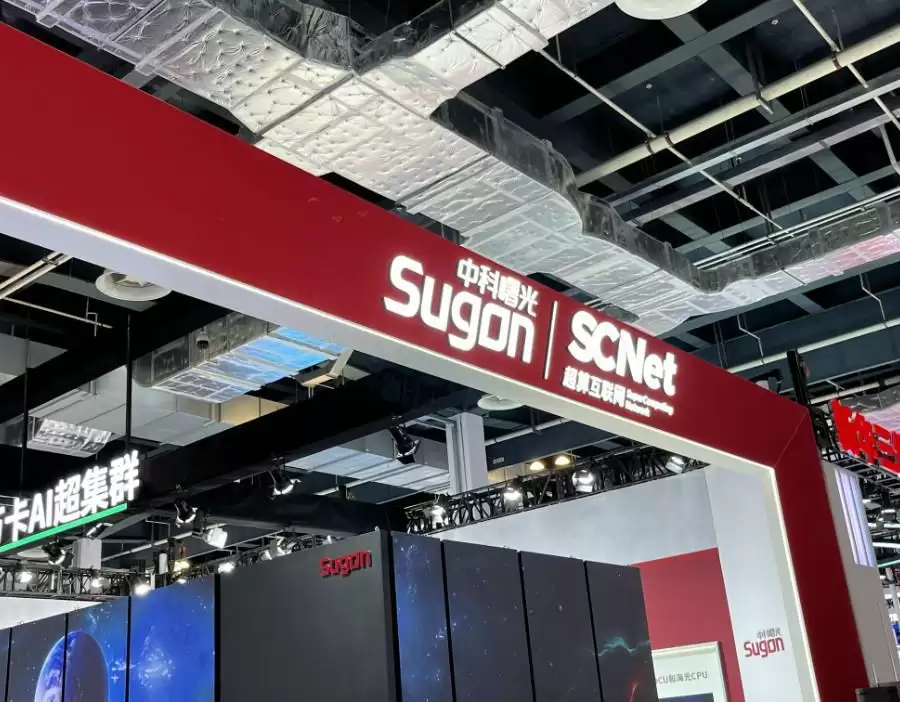
从WAIC 2026浦江生态论坛上传来了一个值得关注的消息。上海人工智能实验室联合中科曙光等国产算力产业链伙伴,正式发布了面向科学智能的超智融合算力架构——DeepLink Fabric。而支撑这一架构运转的,是一个被称为“硬核底座”的存在:中科曙光全球首款无线缆箱式超节点scaleX40。这款产品
7月23日,中科曙光正式发布了Gridview 7.0超智融合平台。这个平台亮相于光合组织2026智能计算应用大会,现场见证了来自中国科学院计算机网络信息中心、国家超算中心、大湾区大学、中科院国家天文台等多领域专家的共同见证。它的核心命题很明确:在超智融合时代,如何打通高性能计算与人工智能计算资源?
据悉,中科曙光宣布,其新一代高性能通用计算平台将于六月十五日正式发布,宣传语为“百核聚变,超算新境”,预示将采用高核心数处理器。当天下午十四时同步开启直播活动,本次发布活动值得期待。
中科曙光宣布将于6月15日发布新一代高性能通用计算平台。这一升级迭代标志着通用计算平台正成为算力基础设施竞争的关键节点,其性能、能效及应用场景的突破值得关注。
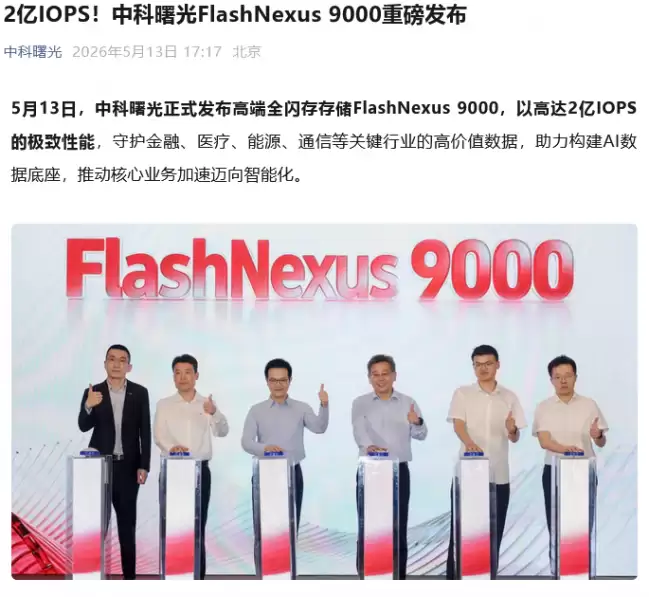
中科曙光发布新一代全闪存存储FlashNexus9000,性能达2亿IOPS,较上代提升近7倍,时延低至0.09毫秒。系统可靠性达99.99999%,具备多重硬件故障容忍能力。其核心部件实现100%国产化,软件全栈自研,兼容主流系统。在金融、医疗、电信等领域应用中,能显著提升交易处理、系统响应及结算效率。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



