

Python读写txt文件的多种方法
Python内置功能可高效处理txt文件。写入时使用write等方法并注意编码与模式;读取时根据文件大小选择一次性、逐行或分块读取。推荐用with语句管理资源并明确指定编码。路径处理可借助os.path等模块,大文件或结构化数据需采用相应策略。
文本文件,也就是我们常说的.txt文件,可以说是数据世界里的“万金油”。从记录程序运行日志、存储配置文件,到在不同系统间交换原始数据,它无处不在。对于Python开发者来说,处理txt文件是一项基础且高频的操作。好消息是,Python内置的功能已经足够强大和易用,无需借助任何第三方库,就能轻松玩转文件的读写。今天,我们就来系统性地梳理一下这些方法,从最基础的打开关闭,到应对大文件、处理编码难题等高级技巧,一网打尽。
1. 写入txt文件
1.1 使用open()和write()方法
一切从open()函数开始。这是最直接、最经典的写入方式:
# 打开文件进行写入(如果文件不存在会自动创建)
with open('example.txt', 'w', encoding='utf-8') as file:
    file.write("这是第一行文本\n")
    file.write("这是第二行文本\n")
    file.write("这是第三行文本\n")
这里有几个关键点值得注意:
'w':代表写入模式。注意,这个模式是“覆盖写”,如果目标文件已存在,其原有内容会被清空。encoding='utf-8':强烈建议始终明确指定编码。UTF-8能很好地支持多语言字符,避免乱码问题。with语句:这是最佳实践。它能确保文件在使用完毕后被正确关闭,即便程序中间发生了异常,也能自动处理,避免资源泄露。
1.2 写入多行内容
如果你已经有一个字符串列表,想一次性全部写入,writelines()方法会更高效。不过要记住,它不会自动帮你添加换行符,需要你自己在每行字符串末尾加上\n。
lines = ["第一行\n", "第二行\n", "第三行\n"]

with open('multiline.txt', 'w', encoding='utf-8') as file:
    file.writelines(lines)
1.3 追加内容到文件
不想覆盖旧文件,只想在末尾添加新内容?把模式从'w'换成'a'(append)就行了。
with open('example.txt', 'a', encoding='utf-8') as file:
    file.write("这是追加的内容\n")
1.4 格式化写入
写入的内容常常是动态的。这时,结合Python强大的字符串格式化功能,就能轻松生成内容丰富的文本。
name = "张三"
age = 25

with open('formatted.txt', 'w', encoding='utf-8') as file:
    file.write(f"姓名: {name}, 年龄: {age}\n")
    # 或者使用format方法
    file.write("职业: {}\n".format("工程师"))
2. 读取txt文件
2.1 读取整个文件
对于小文件,最简单粗暴的方式就是一次性全部读入内存。read()方法会返回整个文件内容作为一个字符串。
with open('example.txt', 'r', encoding='utf-8') as file:
    content = file.read()
    print(content)
2.2 逐行读取
文件对象本身是可迭代的,这意味着你可以直接用一个for循环来逐行处理。这种方式内存友好,是处理文本文件的推荐做法之一。
with open('example.txt', 'r', encoding='utf-8') as file:
    for line in file:  # 迭代器方式逐行读取
        print(line.strip())  # strip()去除行尾换行符
2.3 读取所有行到列表
如果你需要随机访问文件的任意一行,或者需要对所有行进行多次处理,readlines()方法可以一次性将文件所有行读入一个列表。
with open('example.txt', 'r', encoding='utf-8') as file:
    lines = file.readlines()  # 返回包含所有行的列表
    for i, line in enumerate(lines, 1):
        print(f"第{i}行: {line.strip()}")
2.4 处理大文件
当面对动辄几个G的日志文件时,一次性读取整个文件显然不现实。这时,内存友好的读取策略就至关重要。
# 方法1:逐行读取(最常用,内存友好)
with open('large_file.txt', 'r', encoding='utf-8') as file:
    for line in file:
        process_line(line)  # 处理每一行的函数

# 方法2:分块读取(适用于非行结构或超大行)
chunk_size = 1024 * 1024  # 每次读取1MB
with open('large_file.txt', 'r', encoding='utf-8') as file:
    while True:
        chunk = file.read(chunk_size)
        if not chunk:  # 读取到文件末尾
            break
        process_chunk(chunk)  # 处理每个数据块的函数
3. 文件路径处理
3.1 相对路径与绝对路径
路径问题常常是跨平台开发的第一个绊脚石。Python提供了os.path模块来优雅地处理。
# 相对路径(相对于当前Python脚本运行的工作目录)
with open('./data/example.txt', 'r') as file:
    ...

# 绝对路径(推荐使用os.path处理,保证跨平台兼容性)
import os
file_path = os.path.join('C:', 'Users', 'username', 'Documents', 'example.txt')
with open(file_path, 'r') as file:
    ...
3.2 使用pathlib(Python 3.4+推荐)
如果你用的是Python 3.4或更高版本,那么pathlib模块提供了更面向对象、更直观的路径操作方式,可以说是现代Python文件路径处理的“标准答案”。
from pathlib import Path

# 创建Path对象
file_path = Path('data/example.txt')

# 检查文件是否存在
if file_path.exists():
    # 读取文件内容
    content = file_path.read_text(encoding='utf-8')
    print(content)

    # 写入文件
    file_path.write_text("新内容\n", encoding='utf-8')
4. 编码问题处理
4.1 常见编码问题
读写文本文件时,最令人头疼的莫过于编码错误。常见的报错包括:
UnicodeDecodeError:尝试用错误的编码(如用UTF-8去读一个GBK文件)解码文件时抛出。UnicodeEncodeError:尝试将无法用指定编码表示的字符写入文件时抛出。
4.2 解决方案
对于来源不明的文件,一种稳妥的策略是尝试多种常见编码。
# 准备一个常见编码的列表进行尝试
encodings = ['utf-8', 'gbk', 'gb2312', 'big5', 'latin1']

def read_with_fallback(filename):
    for encoding in encodings:
        try:
            with open(filename, 'r', encoding=encoding) as file:
                return file.read()
        except UnicodeDecodeError:
            continue  # 尝试下一种编码
    raise UnicodeDecodeError(f"无法解码文件 {filename},尝试了所有常见编码")

# 写入时,如果实在无法处理特殊字符,可以忽略(慎用)
with open('output.txt', 'w', encoding='utf-8', errors='ignore') as file:
    file.write("包含特殊字符的文本")
5. 高级技巧
5.1 同时读写文件
使用'r+'模式可以打开一个文件同时进行读写。但要注意文件指针的位置,通常需要配合seek()方法来移动指针。
with open('example.txt', 'r+', encoding='utf-8') as file:
    content = file.read()  # 读取后,指针在文件末尾
    file.seek(0)  # 将指针移回文件开头
    file.write("新内容\n" + content)  # 在开头插入新内容
5.2 CSV格式文本处理
很多以.txt结尾的文件,实际上存储的是逗号分隔值(CSV)格式。虽然可以用字符串分割手动处理,但使用csv模块更专业、更安全。
import csv

# 写入CSV格式文本
with open('data.txt', 'w', newline='', encoding='utf-8') as file:
    writer = csv.writer(file)
    writer.writerow(['姓名', '年龄', '城市'])
    writer.writerow(['张三', 25, '北京'])
    writer.writerow(['李四', 30, '上海'])

# 读取CSV格式文本
with open('data.txt', 'r', encoding='utf-8') as file:
    reader = csv.reader(file)
    for row in reader:
        print(row)
5.3 JSON格式文本处理
对于结构化的配置或数据,JSON格式非常流行,有时也会用.txt扩展名保存。Python的json模块让读写变得异常简单。
import json

data = {
    "name": "张三",
    "age": 25,
    "skills": ["Python", "数据分析"]
}

# 写入JSON到文本文件
with open('data.txt', 'w', encoding='utf-8') as file:
    json.dump(data, file, ensure_ascii=False, indent=4)  # ensure_ascii=False确保中文正常显示

# 从文本文件读取JSON
with open('data.txt', 'r', encoding='utf-8') as file:
    loaded_data = json.load(file)
    print(loaded_data)
6. 最佳实践
掌握了各种方法后,遵循一些最佳实践能让你的代码更健壮、更专业:
- 始终使用
with语句:这是保证文件资源被正确管理的铁律。 - 明确指定编码:尤其是涉及中文或其他非ASCII字符时,
encoding='utf-8'应成为你的默认选择。 - 处理异常:使用
try...except块来捕获文件不存在、无权限读写等异常,增强程序鲁棒性。 - 避免硬编码路径:使用
os.path.join()或pathlib.Path来构建路径,保证代码在不同操作系统上的可移植性。 - 大文件处理:养成习惯,对于可能的大文件,优先考虑逐行读取或分块读取的方案。
- 路径分隔符:不要再手动写
\或/了,让os.path或pathlib来操心。
完整示例
最后,我们用一个综合性的例子,把前面提到的路径创建、文件读写、异常预防等知识点串联起来:
from pathlib import Path

def process_file_operations():
    # 创建目录(如果不存在)
    data_dir = Path('data')
    data_dir.mkdir(exist_ok=True)

    # 写入文件
    file_path = data_dir / 'example.txt'
    file_path.write_text(
        "第一行文本\n"
        "第二行文本\n"
        "第三行文本\n",
        encoding='utf-8'
    )

    # 读取并处理文件
    if file_path.exists():
        content = file_path.read_text(encoding='utf-8')
        print("文件内容:")
        print(content)

        # 追加内容
        file_path.write_text(
            content + "\n这是追加的内容\n",
            encoding='utf-8'
        )
    else:
        print("文件不存在")

if __name__ == "__main__":
    process_file_operations()
结论
总的来说,Python为处理纯文本文件提供了一套既简单又强大的工具集。从最基础的open()、read()、write(),到应对复杂场景的路径管理、编码处理和大型文件读写,这些核心技能覆盖了日常开发中的绝大多数需求。对于简单的任务,内置函数足以胜任;而当项目变得复杂,需要更好的跨平台性和现代API时,pathlib模块的优势就显现出来了。记住,良好的习惯——比如总是明确编码、使用上下文管理器、考虑异常情况——是写出稳健、可维护代码的关键。把这些技巧融入你的工具箱,下次再面对文本数据时,你就能更加游刃有余了。
本篇LangGraph Python中文入门教程详解,系统梳理StateGraph状态机定义、节点编写、边与条件路由、检查点持久化(MemorySaver)等核心机制,提供从环境安装到完整循环智能体构建的代码示例与实操指导。
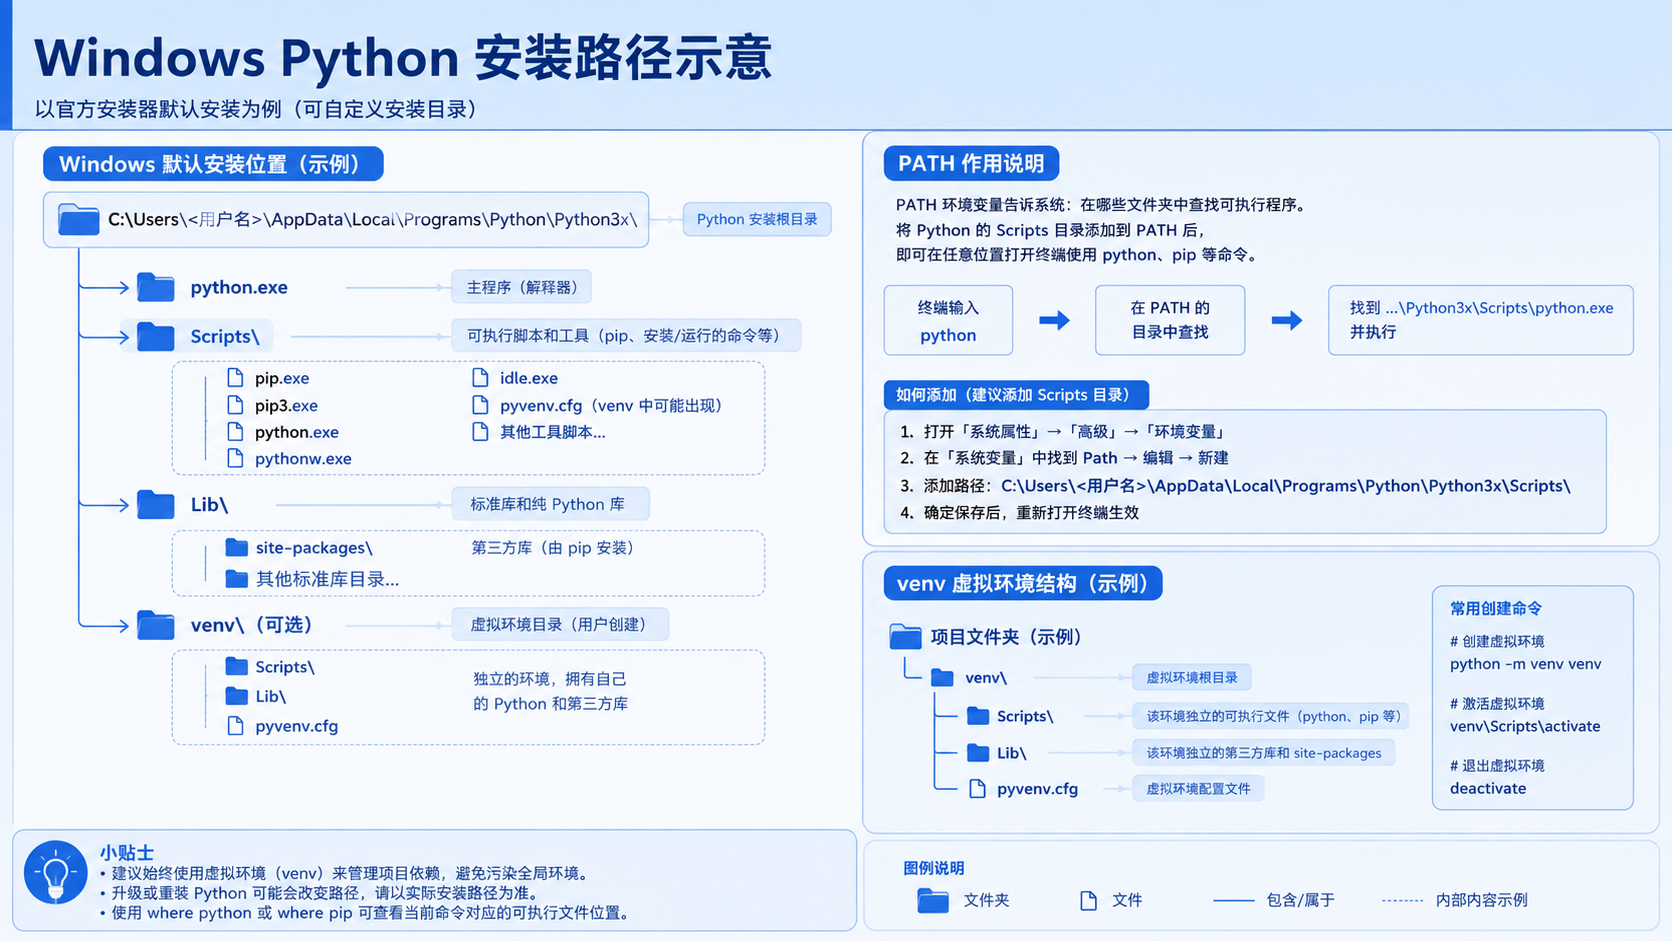
面向后端开发者,基于 Python 官方文档说明如何在 Windows 上安装 Python、创建 venv 虚拟环境及使用 pip 管理依赖。包含可复制命令、验证方法及工具选择边界,避免常见配置误区。
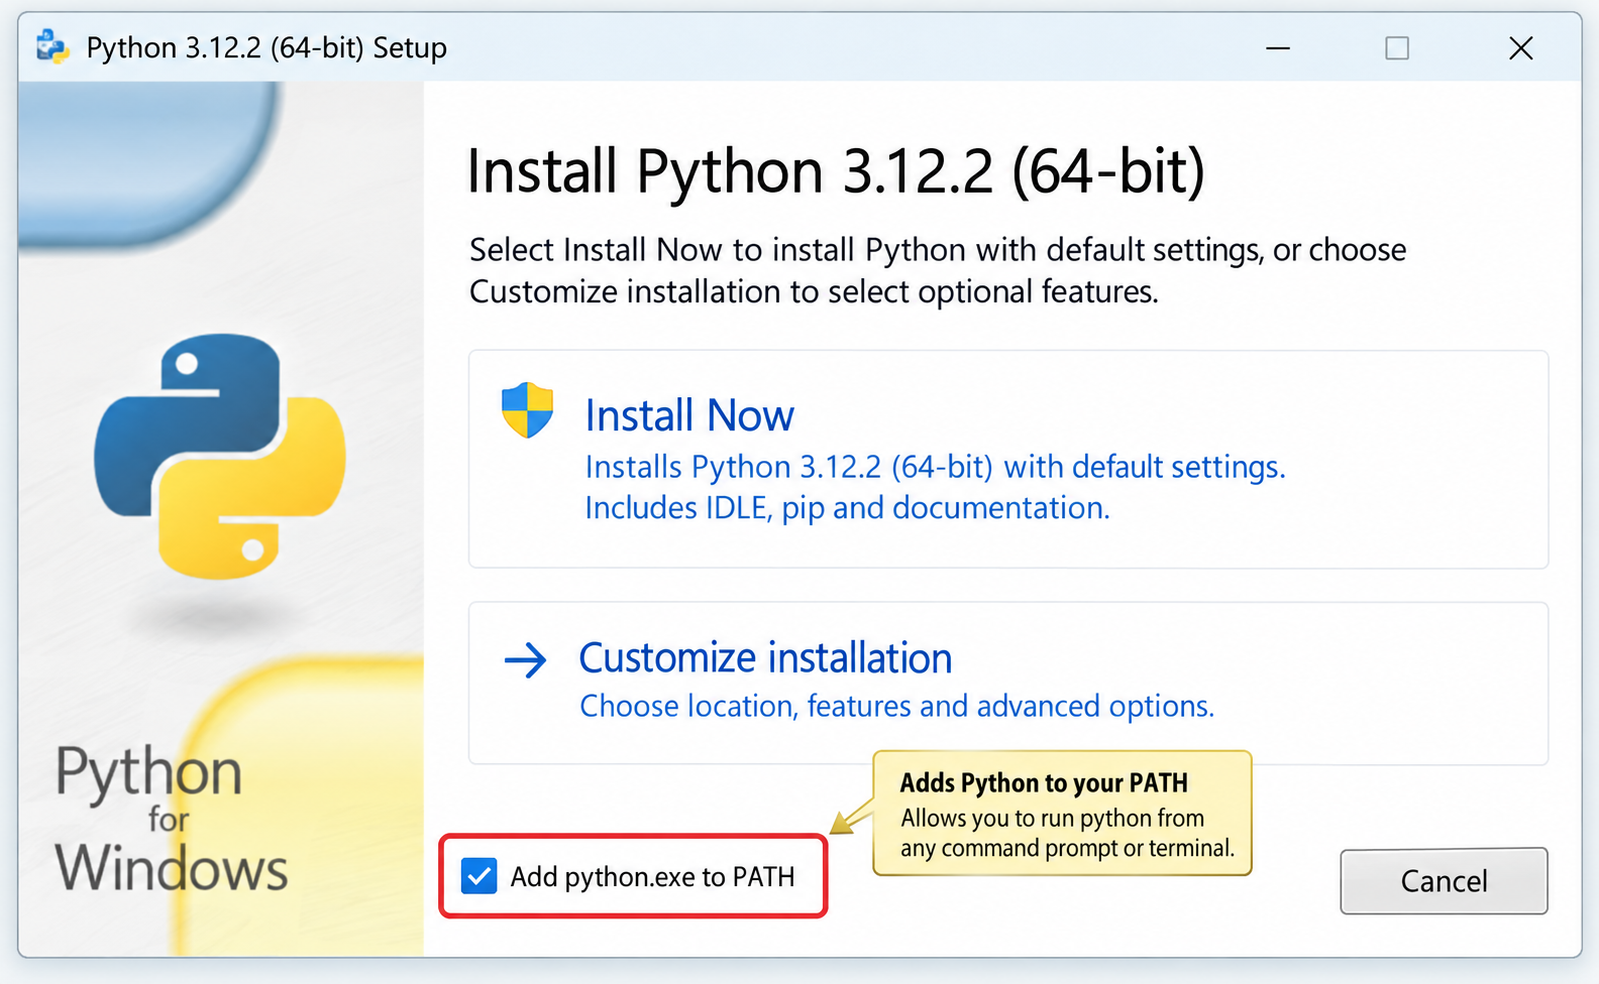
针对Windows初学者的Python安装实战指南。详细讲解如何从Python官网下载匹配架构的安装包,重点演示安装首屏勾选“Add python.exe to PATH”的关键操作,并提供使用python --version和py命令验证环境变量的具体步骤,帮助新手快速搭建开发环境并排查路径问题。
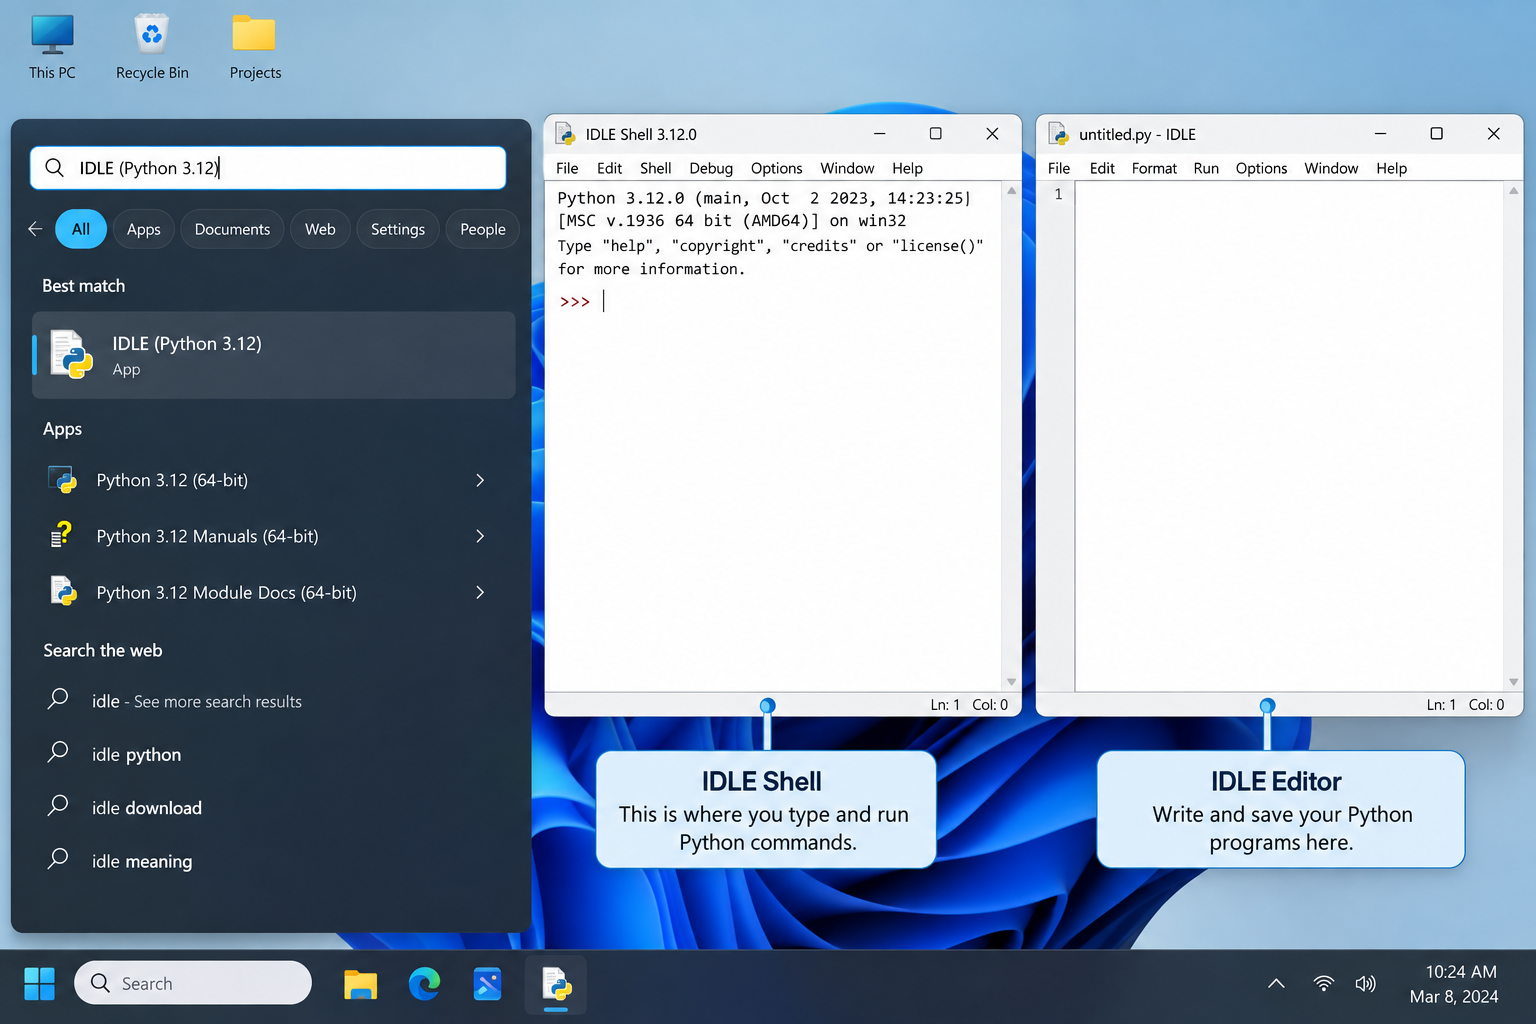
刚在Windows安装好Python却不知道如何启动?本文详细演示如何通过开始菜单找到并打开IDLE集成开发环境,以及如何在PowerShell或命令提示符中使用python和py命令启动交互式解释器、运行.py脚本文件。包含退出解释器的方法及常见启动问题排查,帮助初学者快速验证安装成功并开始编写代码。

了解Python编程领域中最好的就业行业导语:近年来,Python作为一种易学易用的编程语言,越来越受到企业和开发者的青睐。在Python编程领域中,有许多就业机会,涵盖了各个行业。本文将介绍一些Python编程领域中最好的就业行业,并提供相应的代码示例。数据科学和机器学习数据科学和机器学习是Python编程领域中最热门的行业之一。Python在数据科学和机
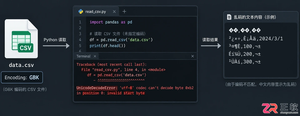
针对Python处理CSV文件时常见的编码报错、内存溢出和数据类型错误,本文对比标准库csv与Pandas库的适用场景,提供可复制的代码示例和因果排查思路,帮助开发者选择最优处理方案。
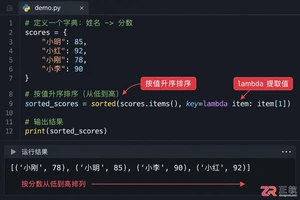
本文介绍如何使用Python的sorted函数对字典按值进行升序和降序排序,结合具体代码示例和应用场景,帮助读者理解排序逻辑及其在数据处理中的实际价值。
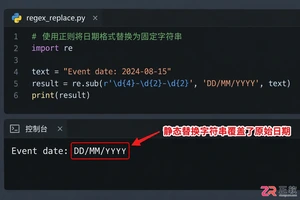
深入讲解Python中使用re.sub进行正则匹配与替换的技巧,涵盖基础语法、分组引用及回调函数应用,帮助开发者解决复杂字符串修改需求,提升代码效率与可维护性。
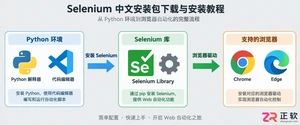
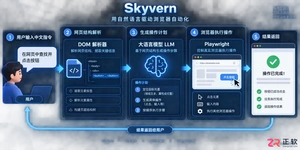
Skyvern是一款基于大语言模型的开源浏览器自动化框架,目前仅提供英文界面且无官方中文版。本文指导用户通过GitHub获取源码,使用Docker快速部署本地环境,并解释其如何通过DOM树解析与自然语言指令实现网页自动操作,同时提供针对中文用户的配置建议与替代方案。



Adobe Acrobat Pro 是面向办公、法务、财务、教育及出版用户的专业PDF处理软件,可在Mac上创建、编辑、转换、合并和保护文档,并提供OCR文字识别、表单、批注、内容比较、敏感信息遮盖及电子签名功能。

Blender 是一款免费开源、跨平台的专业 3D 创作软件,集建模、动画、渲染、视频编辑与视觉合成等功能于一体,广泛应用于影视动画、游戏设计和建筑可视化等领域。软件支持 Cycles 物理渲染器与 Eevee 实时渲染引擎,并提供多边形建模、骨骼绑定、物理模拟等专业工具。Blender 兼容 Windows、macOS 和 Linux 系统,安装包轻巧、运行流畅,依托活跃的全球开发者社区持续更新,是从初学者到专业创作者都值得选择的正版 3D 创作工具。

Shapr3D是一款面向工业设计、机械工程、建筑概念和三维打印工作流的CAD软件。Mac版采用Parasolid建模内核,支持草图约束、实体建模、工程图、可视化渲染及常见CAD格式交换,并可通过账户在多台设备之间同步项目。

AutoCAD 是 Autodesk 推出的专业计算机辅助设计软件,Windows 版支持精确二维绘图、三维实体与曲面建模、图纸标注、布局发布和任务自动化,并包含多套行业专业化工具组合,适用于建筑、机械、电气、工程建设及制造设计人员。
Adobe Acrobat Pro 是面向专业 PDF 工作的综合解决方案,可在 Windows 中创建、编辑、转换、比较、整理和保护文档,并支持表单、电子签名、扫描件文字识别及敏感信息永久遮盖。订阅还包含网页、移动服务和云端协作能力,
Blender 是一款免费开源、跨平台的专业 3D 创作软件,集建模、动画、渲染、视频编辑与视觉合成等功能于一体,广泛应用于影视动画、游戏设计和建筑可视化等领域。软件支持 Cycles 物理渲染器与 Eevee 实时渲染引擎,并提供多边形建模、骨骼绑定、物理模拟等专业工具。Blender 兼容 Windows、macOS 和 Linux 系统,安装包轻巧、运行流畅,依托活跃的全球开发者社区持续更新,是从初学者到专业创作者都值得选择的正版 3D 创作工具。