

世界模型的门槛,谷歌可能迈过去了
谷歌未发布的GeminiOmni模型生成的两段视频引发关注。一段视频中教授讲解数学证明时手部动作自然、板书与语音精准同步;另一段则逼真呈现人物与物体的物理交互。这表明模型可能实现了跨模态深度协调,对现实世界约束有了整体理解。若其真正统一多模态能力并与谷歌生态整合,或将重塑视。
Google可能要放大招了。
就在Google I/O 2026开幕前夕,两条由尚未发布的新视频模型Gemini Omni生成的视频悄悄流出。没有预告,没有造势,整个社交媒体瞬间被引爆。
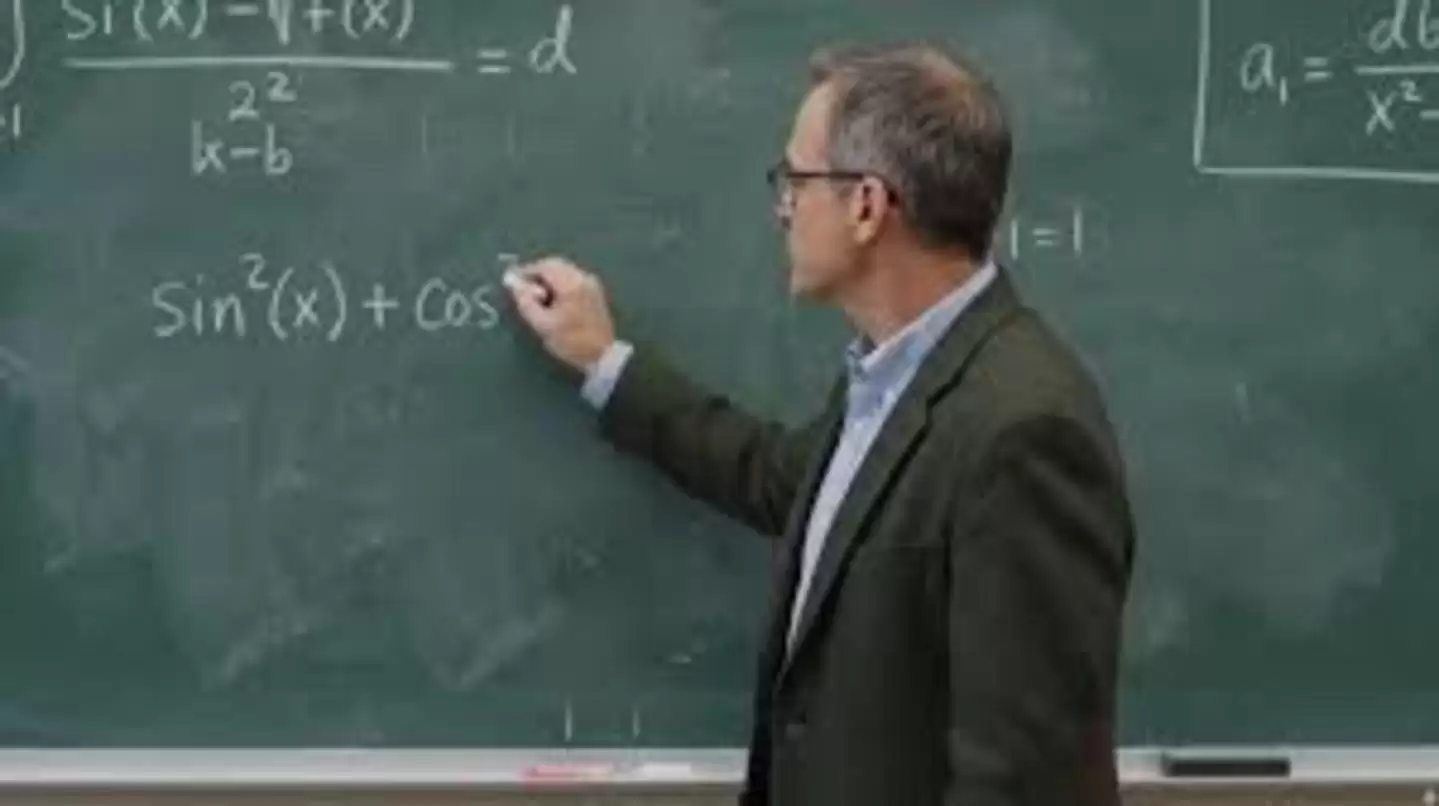
一条视频里,一位教授站在黑板前,手持粉笔,一步步推导着三角恒等式;另一条,则是两名男士坐在海边的高档餐厅里,安静地享用意大利面。
Reddit和X的评论区,几乎被同一句话刷屏:“这不可能是现有的技术水平。”
两个看似普通的日常场景,凭什么能让见惯了AI大场面的技术圈集体侧目?
令人震惊的视频
先看那条“教授黑板讲课”的视频。生成它,只用了一条简单的指令:
“一位教授在传统黑板上写出三角恒等式的数学证明,同时用语言解释他当前正在推导的步骤。”
就这么一句话,没有多轮对话,也没有分步骤控制。
结果呢?教授手持粉笔,逐步写下公式,同时开口讲解,画面流畅,板书工整。
听起来似乎平平无奇?
但如果你了解当前视频生成模型的技术边界在哪里,就会明白Gemini Omni同时做到了三件事——而这三件事,在过去从未被同一个模型完美实现。
第一,推理对了。
黑板上的证明过程,在数学上是成立的。这不是视觉上长得像公式的符号堆砌,而是数学意义上真实有效的推导。要做到这一点,模型必须在基础的token预测之外,具备一定的符号推理能力。它得“知道”下一步应该出现什么公式,而不是随机采样一个看起来像数学的图案。这种语义准确性叠加在视觉生成之上,正是大多数视频模型会在这类测试中翻车的原因。
第二,空间关系对了。
评测者描述,粉笔书写时的手部和手臂动作“读起来是自然的”,黑板上的方程式清晰可辨。手部,是AI视频生成里公认的“鬼门关”。手指数量错误、关节扭曲、与物体的空间关系失真,几乎是每一代视频模型都栽过的坑。而在这里,一支粉笔被正确握持,在黑板上留下有意义的笔迹,手腕的力道、落笔的角度,都在合理的范围内。这一关,比单纯画一只正常的手还要难,因为它要求手与黑板、粉笔、书写行为之间,形成一套完整的空间逻辑。
第三,时序对了。
这是最容易被低估的一点。教授写下某个推导步骤的同时,口头讲解的正是这个步骤,板书进度与语音内容保持完美同步。这远不止是音视频的帧级对齐,而是视觉事件、语义事件、时间事件三者之间的跨模态协调。任何一个维度的理解出现偏差,结果就会是“手在写A,嘴在讲C”。这种错位,人类观众一眼就能感知到。
如果这三件事只是分别做到,我们可以认为是三个专项模块拼凑的结果。但三者同时成立、彼此协调,更可能意味着模型在某个表征层面上,已经对“教授在黑板上讲课”这件事形成了整体性的语义理解。换句话说,它似乎理解了这件事在现实世界里是什么样子,以及其中各个元素之间的约束关系。这也正是“世界模型”这个词,会在这条视频流出后被频繁提及的原因。
在黑板视频流出的同时,另一条视频也一起曝光:两名男士在海边高档餐厅吃意大利面。
这个场景的选择,绝非偶然。2024年,一段AI生成的“Will Smith吃意大利面”视频曾在网上疯传。画面里手指数量不对,面条像活物一样扭动,叉子和嘴的空间关系完全失控。那段视频,成了早期AI视频生成能力的“耻辱柱”。
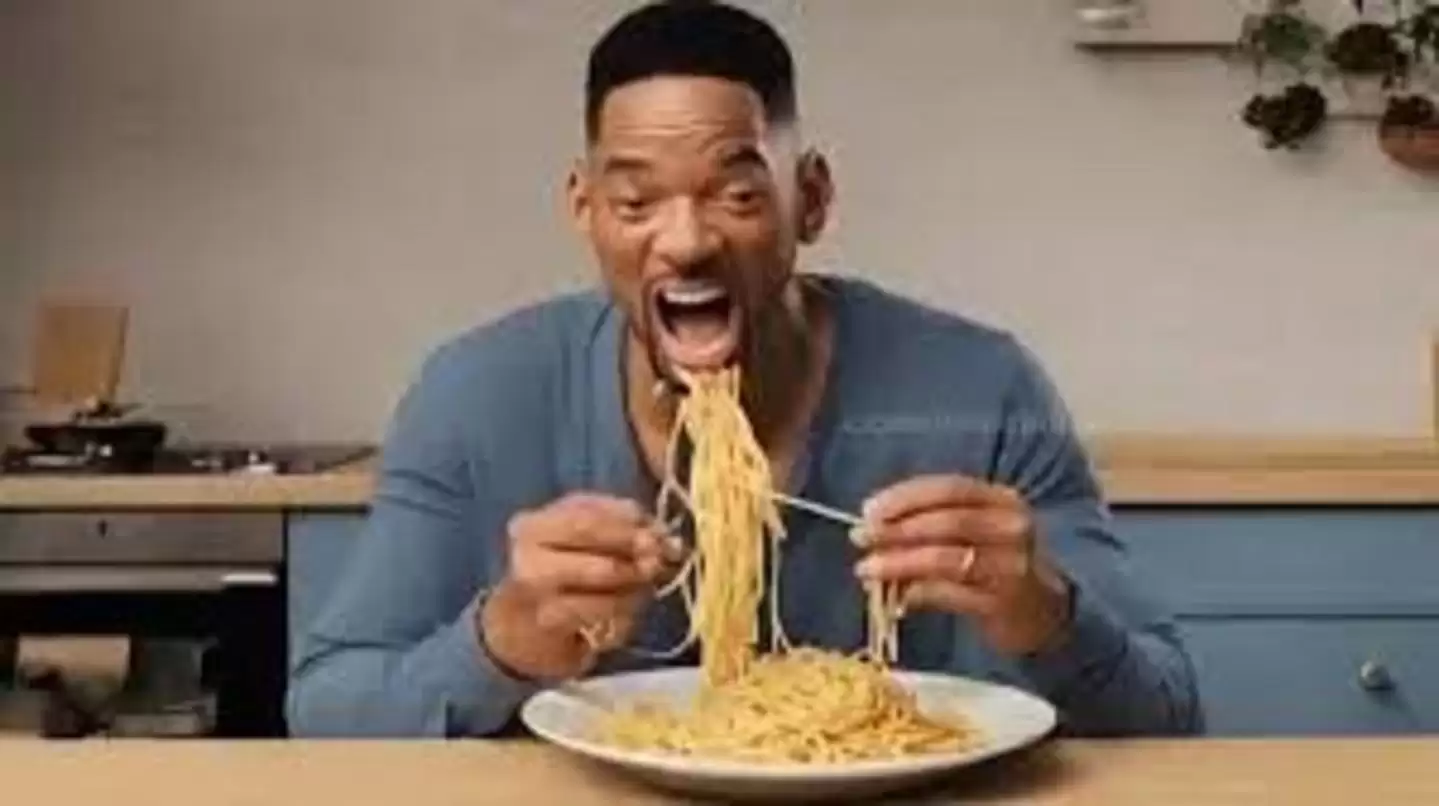
图为“Will Smith吃意大利面”视频截图
而这一次,Gemini Omni生成的结果,被用户评论为“令人难以置信地真实”。这背后考验的,是模型对刚体与柔性体之间动态交互的建模能力:叉子是硬的,面条是软的,两者在接触时会产生形变,而形变的方式必须符合现实世界里的物理直觉。这正是早期生成模型在隐式物理模拟上的致命短板。
一个模型,在两条视频里,分别挑战了视频生成最难的两类问题:一类是符号、语音与画面的同步,另一类是人与物体、刚体与柔性体的交互。并且,它把这些问题都推进到了一个更可用的状态。Gemini Omni展示的,更像是一个对世界有着更深层理解的基座模型。
Gemini Omni的冲击
截至目前,Google尚未发布Gemini Omni的任何技术文档,也没有公开模型参数或基准测试数据。但关于它的架构,外界已有三种主流解读。
最保守的说法是,Omni只是Veo的品牌重命名,底层推理引擎没有根本变化;第二种说法则认为,Omni是在Gemini架构下重新训练的全新视频模型,与Veo并行但独立;第三种说法最激进,认为Omni是一个真正意义上的原生多模态统一模型,能在单一架构里原生处理文字、图像、视频和音频。
基于那两段视频的表现,第三种解读反而像是“Omni”这个命名最合理的指向——毕竟在拉丁语中,“omnis”意味着“所有”。
如果Omni真正打通了多模态链路,那么模型竞争的焦点就会发生根本性转变。竞争将不再是谁能拍出更像电影的画面,而是谁能成为内容创作者的“唯一目的地”。
虽然现在还不能断言Gemini Omni已经是世界模型,但它至少表明,视频生成技术正在逼近世界模型要解决的核心问题:如何在时间中维持一个可解释、可编辑、可连续推演的场景。
产品层面的冲击同样不容忽视。今天,一条AI视频的生产链路通常需要串联语言模型写脚本、图像模型做故事板、视频模型做动画渲染,再用外部剪辑软件做后期处理。每一次跨工具切换,都意味着信息损耗和风格漂移。一旦Gemini Omni的对话式视频编辑能力成立,这条冗长的链路就可能被一个简单的对话窗口替代。
更关键的是,如果Omni被深度整合进Gemini入口,并与Gmail、Google Docs、YouTube、Android等生态打通,那么这种由分发和生态构筑的壁垒,将是字节的Seedance、快手的Kling等竞争对手在短期内难以复制的。技术能力决定上限,而生态决定规模。Gemini Omni真正的威胁,或许不在于它今天生成的视频有多好,而在于它把顶级的视频生成能力,放在了竞争对手根本进不去的生态位里——这几乎构成了一种降维打击。
世界模型时刻或许来临
回顾过去几年,生成式AI的进化路径相对清晰:语言模型学会了读和写,图像模型学会了看和画,视频模型学会了动。每一个模态都在自己的赛道上狂奔,但它们之间,始终存在一道隐形的墙。模型知道文字,也知道图像,但它未必理解文字和图像之间、声音和动作之间、逻辑和画面之间在现实世界中的约束关系。
如果说ChatGPT时刻定义了语言的边界,Sora时刻定义了视频的边界,那么Gemini Omni所指向的,很可能是第一个真正意义上的“世界模型时刻”。模型第一次开始尝试理解,不同模态在现实世界中的内在关联与约束,而不仅仅是分别生成它们。这无疑是一次质的飞跃。
当然,Gemini Omni是否真正实现了这一点,在5月19日Google I/O 2026大会正式揭晓之前,没有人能给出确定的答案。但泄露出来的视频,给出的信号已经足够有力。接下来Google会在台上说什么,我们很快就会知道。
认识AI Agent、Genie 4与机器人的区别:任务输入不等于完成结果,世界模拟不等于现实执行,装载机动作展示也不能替代完整工程验收。
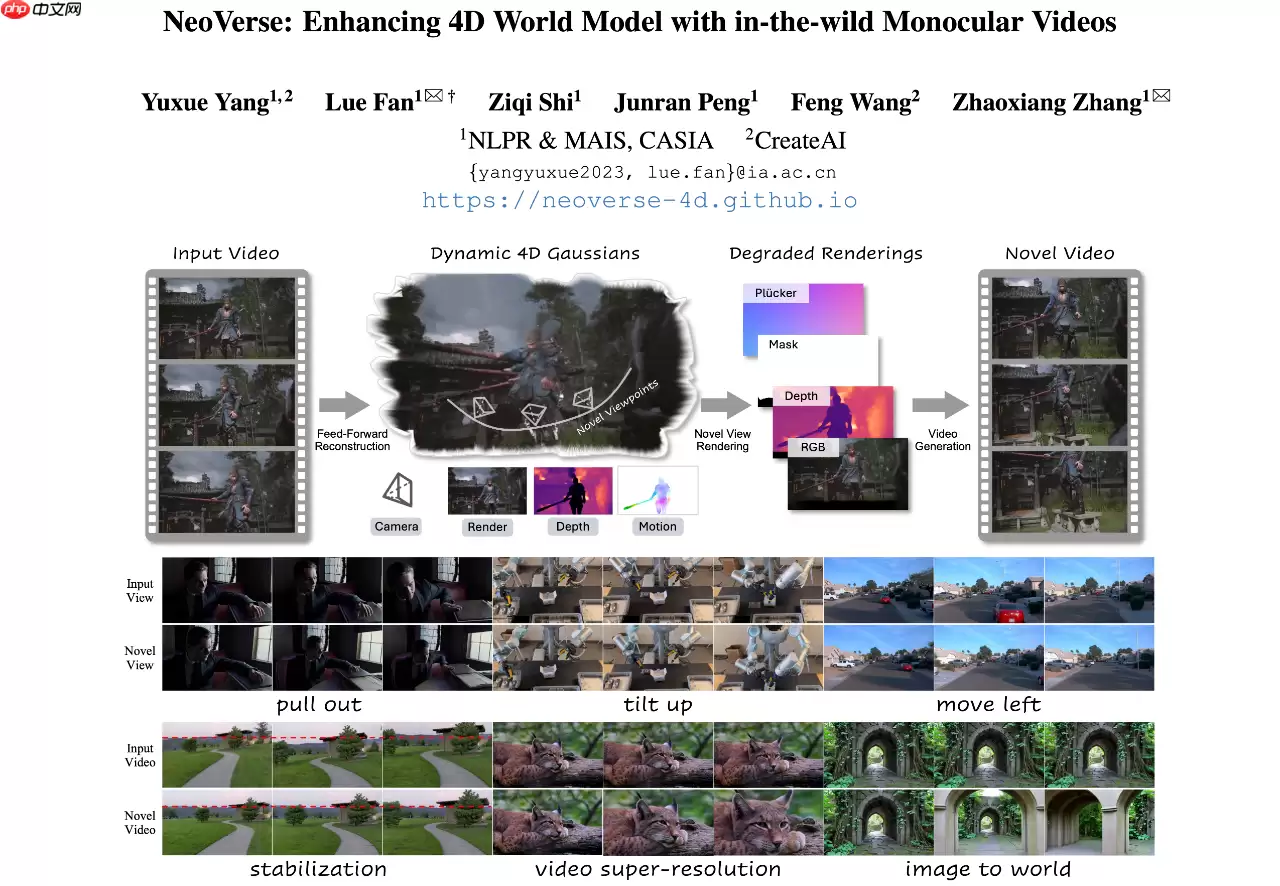
CreateAI联合中科院自动化所推出NeoVerse4D世界模型,融合扩散模型与4D高斯溅射,基于百万段单目视频训练,30秒即可构建通用型4D世界。该模型实现“重建→生成→再重建”闭环,支持4D场景重建、自由漫游、视角生成、视频编辑及点云跟踪,适用影视、具身智能、自动驾驶等领域,并集成蒸馏LoRAs,可在消费级显卡上端到端推理。
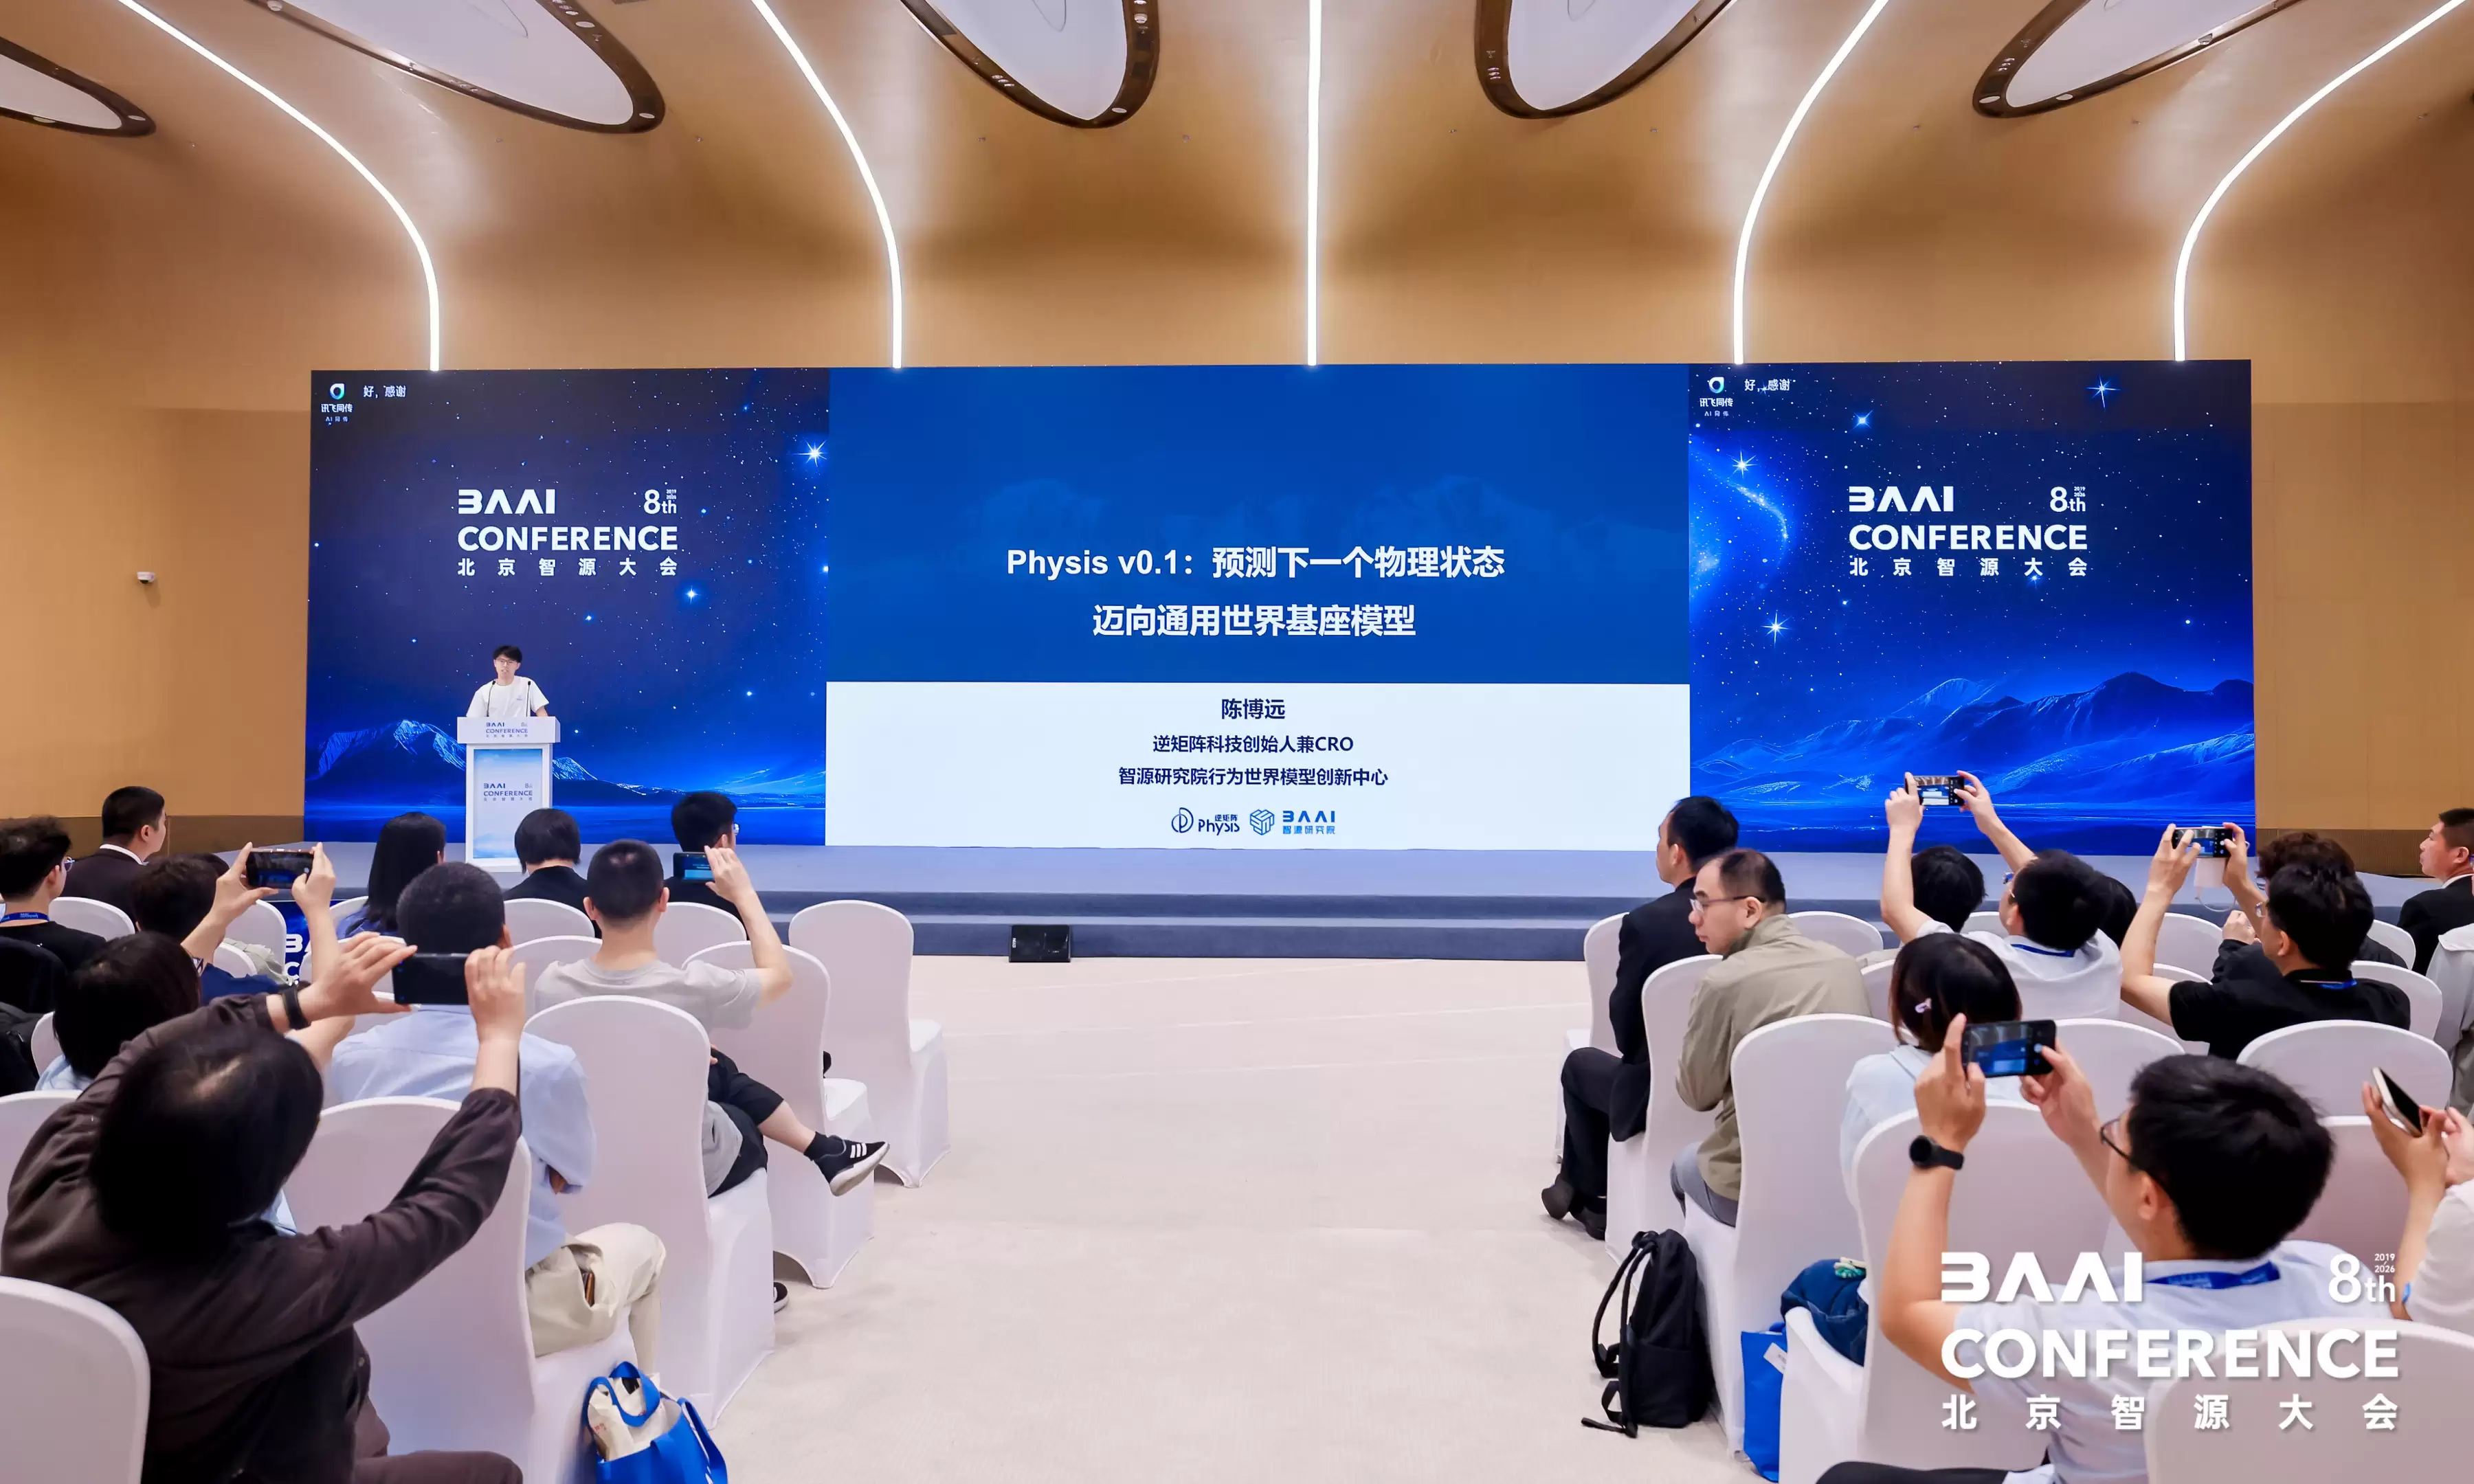
逆矩阵科技完成超亿美元种子++轮融资,由经纬创投、蚂蚁集团等投资。资金将用于通用世界基座模型预训练及规模化训练。公司由北大青年学者陈博远、吉嘉铭创立,已发布全球首个通用世界基座模型悟界·Physis-v0.1。
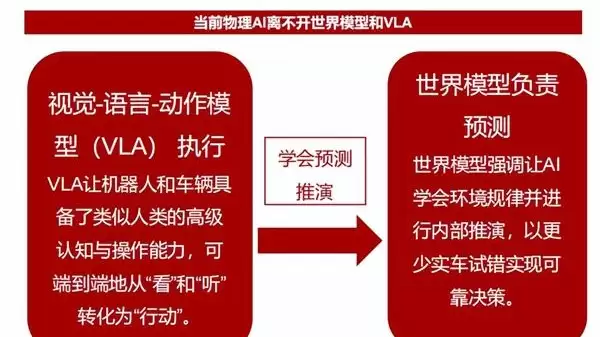
物理AI依赖的世界模型面临概念定义混乱、真实物理数据稀缺及技术路线分歧等困境,导致模型构建困难。业界预计未来三到五年将持续迭代,从像素模拟走向因果推理仍是根本挑战。
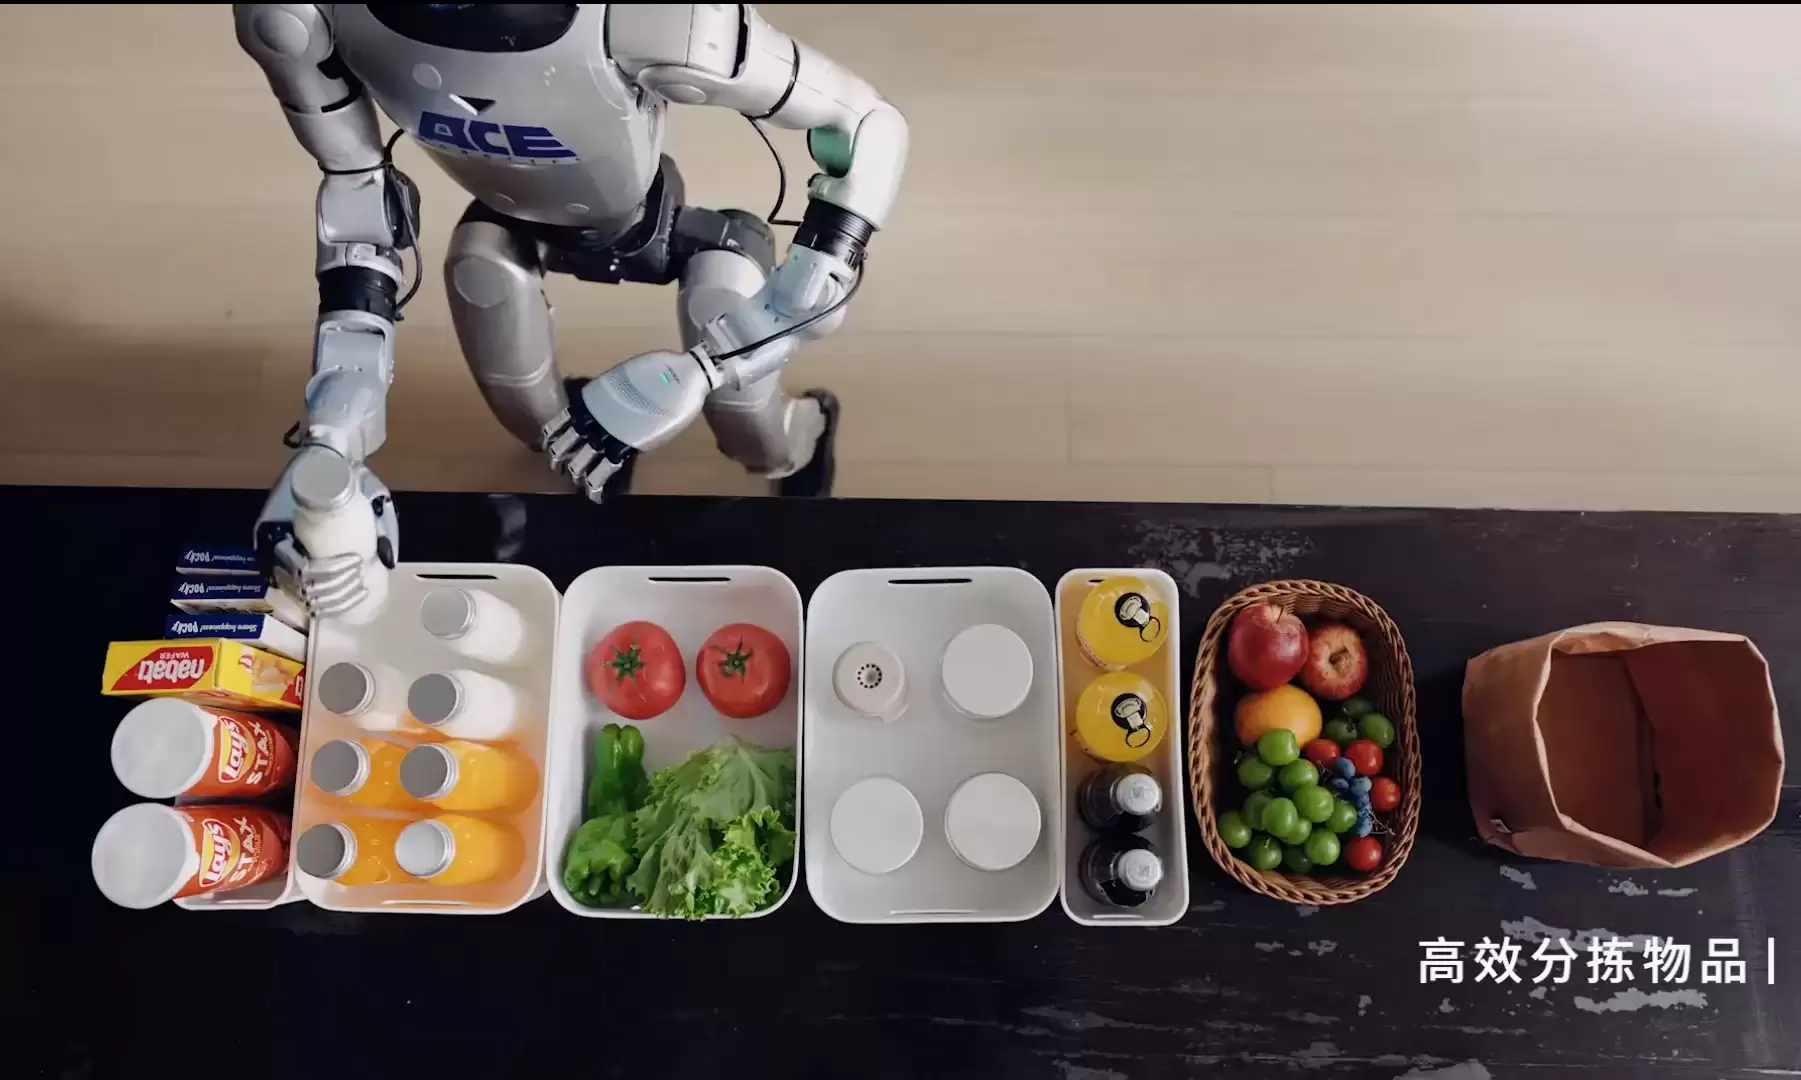
世界模型是今年具身智能领域最热的方向,但各家对它的理解并不一致。最近一次媒体沟通会上,大晓机器人展示了开悟3.1世界模型,以及基于它落地的行业解决方案。整场听下来,能明显感觉到世界模型正在从技术概念变成能商用的产品。(ID:leitech)也参加了这场沟通会。按照大晓世界模型负责人王飞的说法,世界模
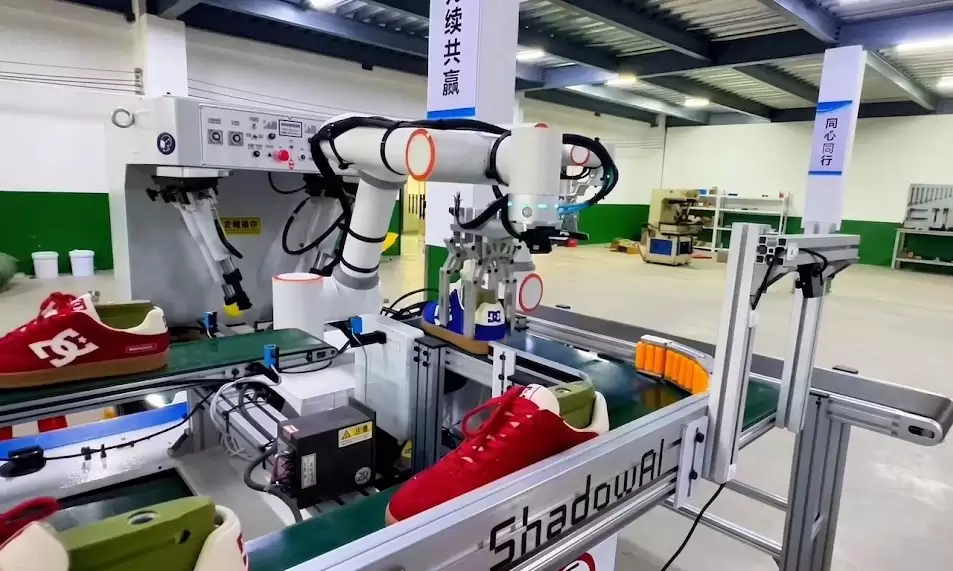
影身智能凭借原生4D基座世界模型,在制鞋产线实现规模化落地,跑通数据生成、模型训练、场景部署与反馈迭代的自进化闭环。该模型融合渲染、仿真、规划三大能力,以高维4D数据驱动物理理解与泛化,获得数亿元柔性智造订单,标志着世界模型跨入工业量产阶段。
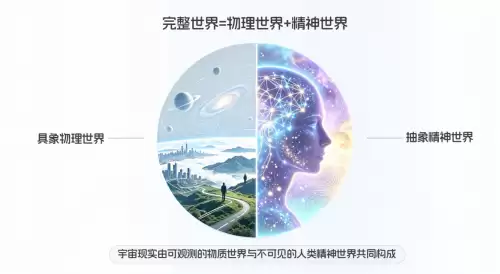
一眸科技聚焦情感与认知AI,源自北大实验室,构建人类身心情智维度专属世界模型。其跨学科团队融合AI、心理学等领域,实现精细表情识别与无接触视觉心率检测等多模态感知突破,推动人工智能从感知迈向认知与情感。
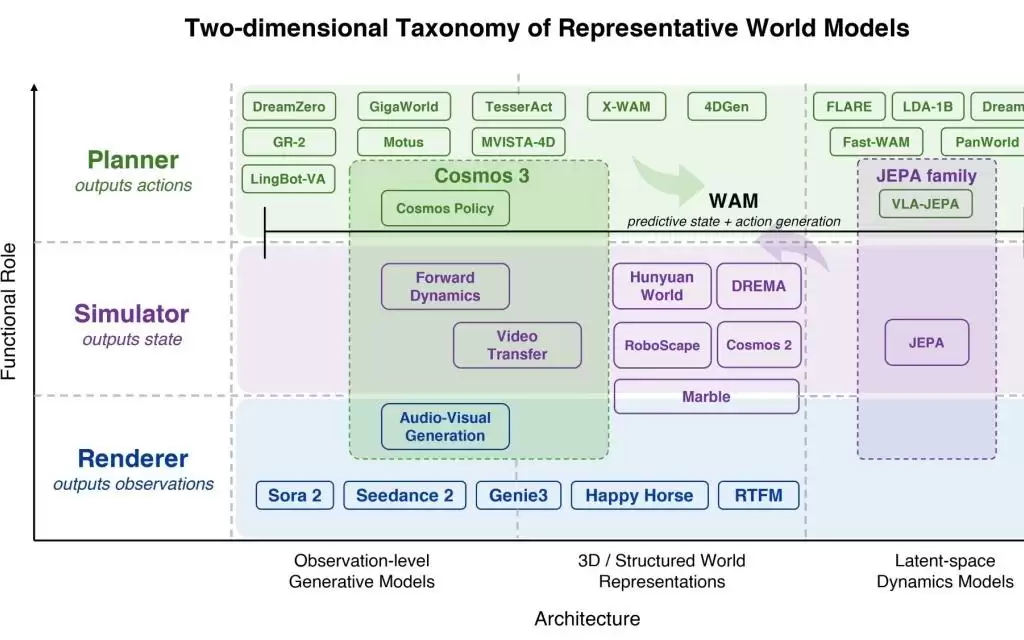
世界模型这个概念,现在在AI圈火得不行,但也经常被拿来乱用。无论是视频生成还是机器人领域,似乎都在往“世界模型”这个筐里装东西。可问题是,它到底是什么?应该预测什么?怎么造?圈子里其实没什么共识。正好,上海AI Lab团队最近发了一篇综述,算是把这个概念好好梳理了一遍。他们对世界模型进行了科学定义,
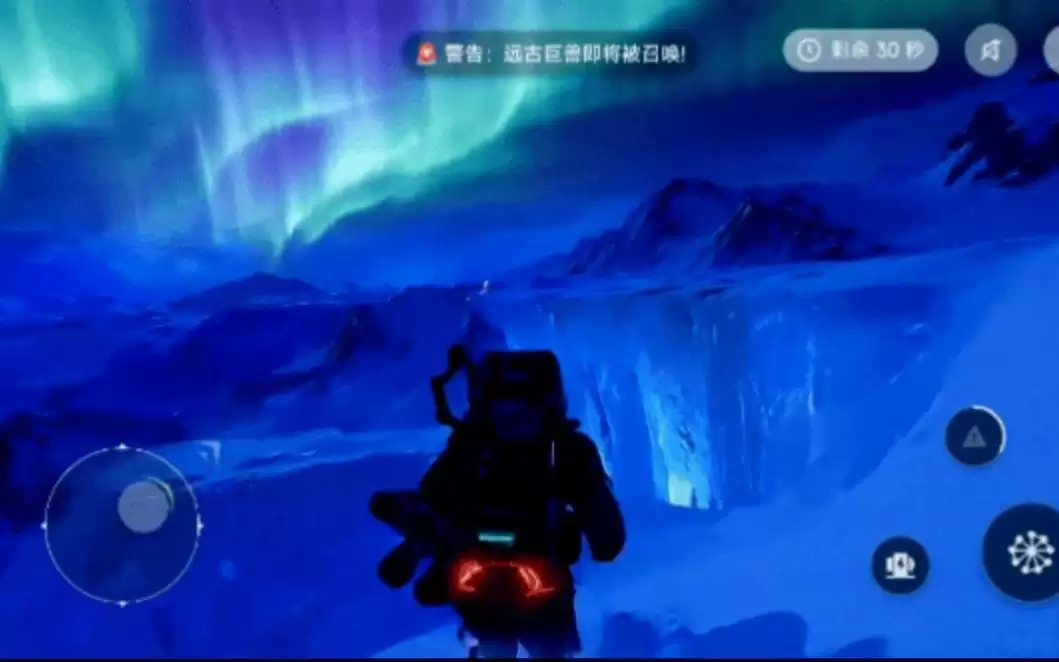
灵光App升级世界模型功能,接入蚂蚁灵波LingBot-World2.0,用户上传一张图片即可在手机端生成可自由漫步且支持施法、射箭等交互操作的沉浸式3D世界。新版实现720P高清画质、30帧以上流畅运行,响应延迟低至百毫秒级。
灵光App升级世界模型2.0,接入LingBot-World2.0,手机上传图片即可生成可战斗互动的3D世界,支持攻击、射箭等操作并实时反馈。技术实现720P高清、30帧流畅运行、百毫秒级响应,Agent驱动场景持续演化,无需技术背景即可体验。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



