
当前位置:

首页 > 硬件相关 > 摩尔线程:计划推出两款芯片,分别面向高性能图形渲染以及专注AI训练与推理加速

摩尔线程:计划推出两款芯片,分别面向高性能图形渲染以及专注AI训练与推理加速

摩尔线程宣布其训推一体智算卡MTTS5000已量产商用,该芯片支持FP8计算精度。公司下一代产品将基于全新架构,计划推出分别专注高性能图形渲染和AI训练推理的两款芯片,展现其在图形与计算领域的双重布局。

本文目录

    5月18日,摩尔线程-U(股票代码:688795.SH)发布了最新的投资者关系活动记录。这份记录透露了一个关键进展:公司的旗舰产品——训推一体全功能智算卡MTT S5000,已经进入量产阶段并成功实现了商业化落地。值得注意的是,MTT S5000是国内市场上少数能够支持FP8计算精度的训推一体芯片之一,这无疑为其在激烈的AI算力竞争中增添了重要砝码。

    与此同时,公司的下一代产品路线图也浮出水面。新一代产品将基于全新的“花港”芯片架构进行开发,并计划推出两款侧重点不同的芯片:“庐山”系列将专注于高性能图形渲染领域,而“华山”系列则定位于AI训练与推理加速。这一布局清晰地展示了摩尔线程在图形与计算两大核心赛道同时发力的战略意图。
    本站声明:本文内容由网友自发贡献,版权归原作者所有,本站不承担相应法律责任。如您发现有涉嫌抄袭侵权的内容,请联系bd@zhengruan.com
    作者最新文章
    硬件相关
    相关文章 更多
    CPO已成超大规模AI训练必选技术路径,中际旭创、新易盛、剑桥科技等多股创历史新高
    CPO已成超大规模AI训练必选技术路径,中际旭创、新易盛、剑桥科技等多股创历史新高

    CPO概念股集体创新高,集邦咨询预测其市场规模将从2025年约1亿美元增至2030年超390亿美元,增长迅猛。CPO通过共封装降低功耗、提升带宽,已成为业界公认的超大规模AI训练集群必选技术路径,未来成长空间极为广阔。
    蚂蚁与西湖大学联手:AI训练数据不够用?让模型自己
    蚂蚁与西湖大学联手:AI训练数据不够用?让模型自己"出题考自己"

    蚂蚁集团联合西湖大学等提出RODS方法,让AI训练系统实时定位模型能力边界并动态生成新题,仅用400道种子题即可达到近17000道离线数据的训练效果,显著提升多轮工具调用智能体的性能。
    清华与腾讯联手破解AI训练瓶颈:让大模型在
    清华与腾讯联手破解AI训练瓶颈:让大模型在"学习"路上走得更远

    由清华大学深圳国际研究生院与腾讯混元联合提出的STARE方法,通过词级别优势重加权有效缓解了AI强化学习中的策略熵崩溃问题。在1.5亿至320亿参数模型上验证,AIME24与AIME25基准测试准确率提升4%至8%,并支持更长训练周期。
    卡内基梅隆大学与Meta联手发现AI训练中被忽视的隐患
    卡内基梅隆大学与Meta联手发现AI训练中被忽视的隐患

    卡内基梅隆大学与Meta研究发现,AI训练中的奖励模型存在过度敏感性,对同等质量的答案给出差异悬殊的分数,导致AI学偏方向。研究提出奖励聚类离散化方法,无需重新训练即可消除该问题,实验证实其能显著提升训练效果。
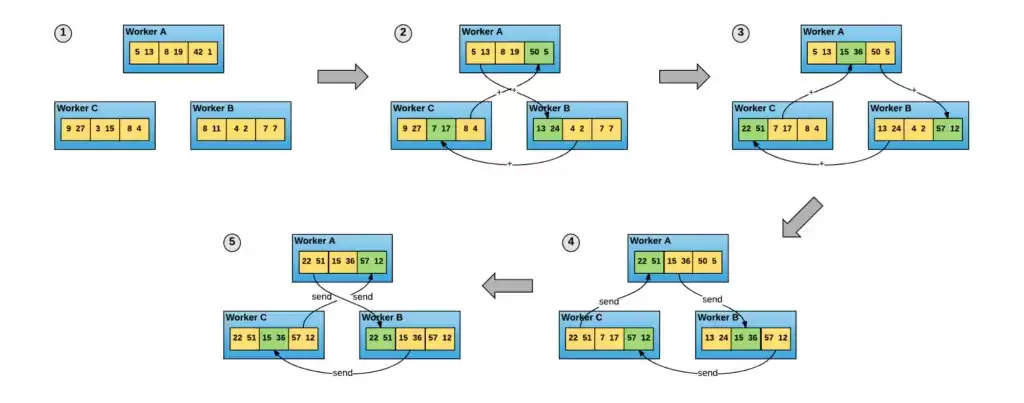
    云原生的弹性AI训练系列之一:基于AllReduce的弹性分布式训练实践
    云原生的弹性AI训练系列之一:基于AllReduce的弹性分布式训练实践

    引言随着模型规模和数据量的不断增大,分布式训练已经成为了工业界主流的 AI 模型训练方式。基于 Kubernetes 的 Kubeflow 项目,能够很好地承载分布式训练的工作负载,业已成为了云原生 AI 领域的事实标准,在诸多企业内广泛落地。尽管 Kubeflow 让基于 Kubernetes 的
    中南大学团队打造
    中南大学团队打造"自我进化"的AI训练数据工厂

    中南大学与香港科技大学提出DataEvolver系统,通过分析被淘汰训练图片的失败信号,形成反馈闭环持续优化数据收集策略。在75万数据规模下,训练模型在文字渲染质量上提升超85%,且数据集覆盖更广,避免了冷门主题被忽略。
    三种AI训练方法其实只是同一个旋钮的三种拨法
    三种AI训练方法其实只是同一个旋钮的三种拨法

    三种训练方法GRPO、Dr.GRPO、DAPO本质是对同一数字——组内标准差的不同操作:作分母、去分母或过滤零值。组内标准差即学习信号本身,答案分歧越大学习越多,全对或全错时无学习信号。该发现揭示了强化学习信号的本质。
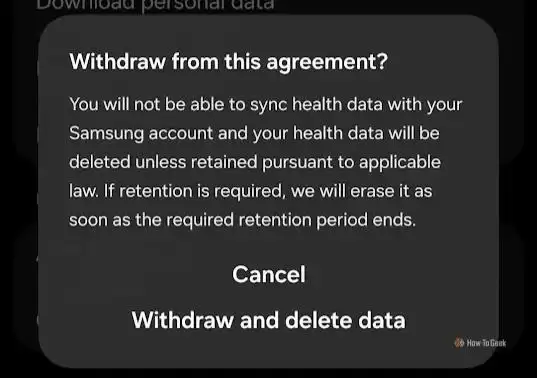
    三星健康被指存“霸王条款”:拒绝AI训练授权恐失去备份能力
    三星健康被指存“霸王条款”:拒绝AI训练授权恐失去备份能力

    三星健康更新强制选项,用户若拒绝将睡眠、用药、医疗记录等数据用于AI训练,将无法备份数据,且相关数据可能被删除。三星声称此举旨在提升应用体验,部分数据由人工审核。
    独立研究者提出
    独立研究者提出"分层优化器":让AI训练内存占用缩减97%,普通显卡也能训练百亿参数模型?

    针对稀疏混合专家模型,独立研究者提出分层优化器SkewAdam,将优化器状态从50.55GB降至1.29GB,训练峰值内存从81.4GB降至31.3GB,使40GB显卡可训练67亿参数模型。该方法对骨干网络保留动量,对专家层仅用分解式二阶动量,验证困惑度优于AdamW等基线,内存节省显著且收敛更快。
    清华大学如何让AI训练像流水线一样高效?
    清华大学如何让AI训练像流水线一样高效?

    清华大学提出单轮异步优化方法,通过单轮异步训练、双边裁剪屏蔽、价值模型及冻结注意力等机制,解决大型语言模型强化学习中的同步等待和离策略偏差问题。在数学推理和编程任务上超越GRPO,训练稳定超1000步,性能达世界顶尖水平。


    查看更多
    精品专题 更多
    装机必备
    装机必备

    正软商城装机必备专区,精选办公、浏览器、安全防护、影音播放、压缩解压、设计创作和系统工具等电脑常用正版软件,帮助用户快速完成新电脑软件配置。

    Windows
    Windows

    正软商城Windows软件专区,汇集适用于Windows电脑的办公、设计、安全防护、影音播放、开发工具和系统优化软件,提供软件介绍、系统要求、正版授权及购买下载服务。

    PDF教程
    PDF教程

    正软商城PDF教程频道提供PDF编辑、转换、合并、拆分、压缩及格式处理方法,同时介绍常用PDF软件和工具的使用技巧。

    Mac软件 更多
    讯飞智作 网页版
    讯飞智作 网页版
    Windows/ macOS/ Linux

    讯飞智作是一款基于语音合成技术、虚拟人驱动技术与数字人形象声音构建能力的 AI 数字人音视频创作平台。

    火山引擎 网页版
    火山引擎 网页版
    Windows/ macOS/ Linux

    火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。

    Aperty macOS版
    Aperty macOS版
    macOS

    Aperty 是 Skylum 推出的 AI 人像修图软件,支持自然肤质修饰、瑕疵处理、面部与身体调整、预设及批量同步。

    WINDOWS 更多
    讯飞智作 网页版
    讯飞智作 网页版
    Windows/ macOS/ Linux

    讯飞智作是一款基于语音合成技术、虚拟人驱动技术与数字人形象声音构建能力的 AI 数字人音视频创作平台。

    火山引擎 网页版
    火山引擎 网页版
    Windows/ macOS/ Linux

    火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。

    PixTV 网页版
    PixTV 网页版
    Windows

    PixTV 是一款在浏览器中使用的 AI 视觉内容创作平台,提供图片、视频、音频、文字生成、AI 分镜、局部重绘、提示词反推和无限画布等工具,适合短剧、漫剧、广告及社交媒体内容制作。


