当前位置:

首页 > 业界资讯 > 通过操纵代码语料,大模型和智能体共同释放出更强大的能量

通过操纵代码语料,大模型和智能体共同释放出更强大的能量

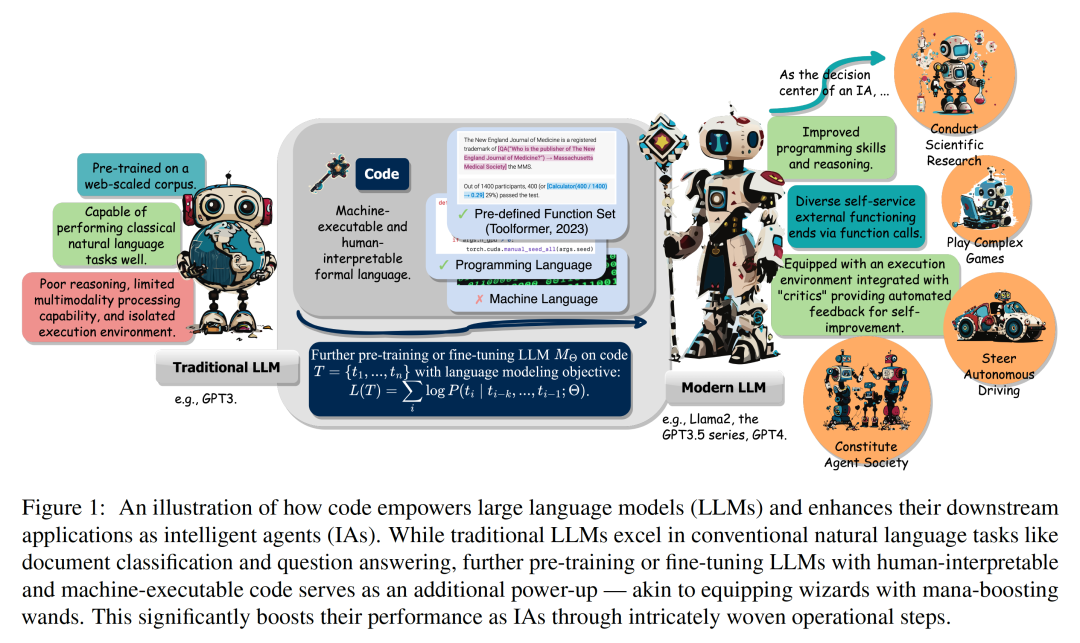
正如瑞斯福兹魔杖缔造了诸如邓布利多在内的历代非凡魔法师的传奇,具有巨大潜能的传统大型语言模型,在经过代码语料的预训练/精调后,掌握了更超出本源的执行力。具体来说,进阶版的大模型在编写代码、更强推理、自主援引执行接口、自主完善等方面都获得了提升,这将为它作为AI智能体、执行下游任务时方方面面带来增益。近日,伊利诺伊大学厄巴纳-香槟分校(UIUC)的研究团队发布了一项重要综述。论文链接:https://arxiv.org/abs/2401.00812这篇综述探讨了代码(Code)如何赋予大型语言模型(LLMs
本文目录
    正如瑞斯福兹魔杖缔造了诸如邓布利多在内的历代非凡魔法师的传奇,具有巨大潜能的传统大型语言模型,在经过代码语料的预训练 / 精调后,掌握了更超出本源的执行力。

    具体来说,进阶版的大模型在编写代码、更强推理、自主援引执行接口、自主完善等方面都获得了提升,这将为它作为 AI 智能体、执行下游任务时方方面面带来增益。

    近日,伊利诺伊大学厄巴纳 - 香槟分校(UIUC)的研究团队发布了一项重要综述。

    挥舞起代码语料的魔杖,大模型和智能体将召唤出更强大的能量

    论文链接: https://arxiv.org/abs/2401.00812

    这篇综述探讨了代码(Code)如何赋予大型语言模型(LLMs)及其基于此的智能体(Intelligent Agents)强大的能力。挥舞起代码语料的魔杖,大模型和智能体将召唤出更强大的能量
    其中,code 特指机器可执行且人类可读的形式语言,如编程语言、预定义函数集等。类似于我们指导 LLMs 理解 / 生成传统自然语言,让 LLMs 精通 code,仅需要将相同的语言建模训练目标应用在 code 数据上。

    和传统语言模型不同,当今通用的 LLMs,如 Llama2、GPT4,不仅在体量上显著提升,并且它们经历了独立于典型自然语言语料的 code 语料训练。Code 具有标准化的语法、逻辑一致性、抽象性和模块化特性,并且能将高层次的目标转化为可执行的步骤,使之成为连接人类和计算机的理想媒介。

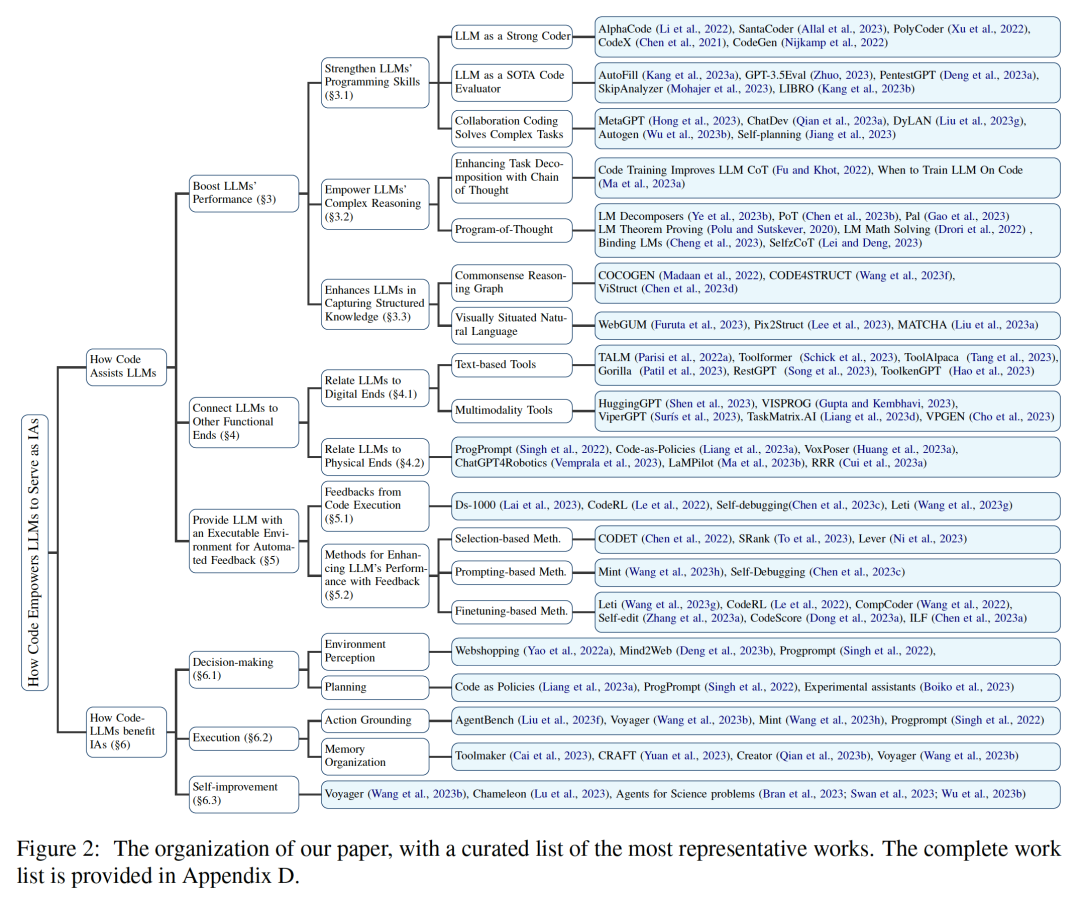
    如图 2 所示,在本篇综述中,研究人员通过辑录相关工作,详细分析阐明了将 code 纳入 LLMs 训练数据的各种优点。

    挥舞起代码语料的魔杖,大模型和智能体将召唤出更强大的能量

    具体来说,研究人员观察到 code 的独特属性有助于:

    1. 增强 LLMs 的 code 编写能力、推理能力,以及结构化信息处理能力,使其能够应用于更复杂的自然语言任务;
    2. 引导 LLMs 产生结构化的、精确的中间步骤,这些步骤可以通过函数调用与外部执行端连接;
    3. 利用 code 的编译、执行环境,为模型自主改进提供多样化反馈。

    此外,研究人员也深察了这些由 code 赋予的 LLMs 的优化项,如何强化它们作 Intelligent Agent 的决策中心,理解指令、分解目标、规划和执行行动以及从反馈中改进的一系列能力。

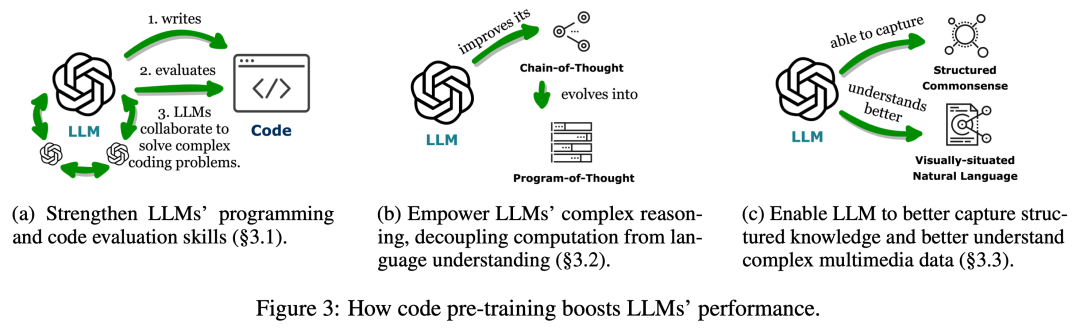
    如图 3 所示,在第一个部分中,研究人员发现 LLMs 在 code 上的预训练,已将 LLMs 的任务范围扩展到自然语言之外。这些模型能够支持多样化的应用,包括为数学理论生成 code、常规编程任务,以及数据检索等。Code 需要产生逻辑上连贯、有序的步骤序列,这对于有效执行至关重要。此外,code 中每个步骤的可执行性允许逐步验证逻辑。在预训练中利用并嵌入这些 code 属性提高了 LLMs 在许多传统自然语言下游任务中的思维链(CoT)表现,验证了它们在复杂推理技能上的改进。同时,通过对 code 结构化格式的隐式学习,codeLLMs 在常识性结构化推理任务上表现更佳,如与标记语言、HTML 和图表理解相关的任务。
    挥舞起代码语料的魔杖,大模型和智能体将召唤出更强大的能量
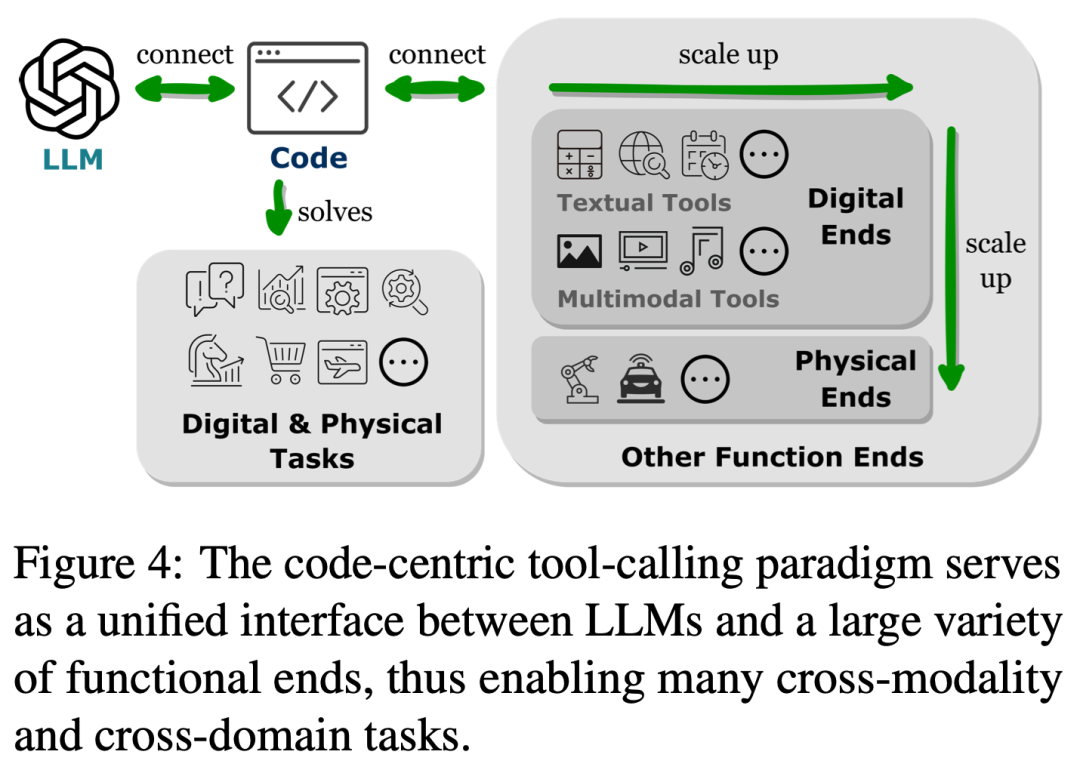
    如图 4 所示,将 LLMs 与其他功能端相连接(即通过外部工具和执行模块扩展 LLMs 能力)有助于 LLMs 更准确、可靠地执行任务。

    挥舞起代码语料的魔杖,大模型和智能体将召唤出更强大的能量

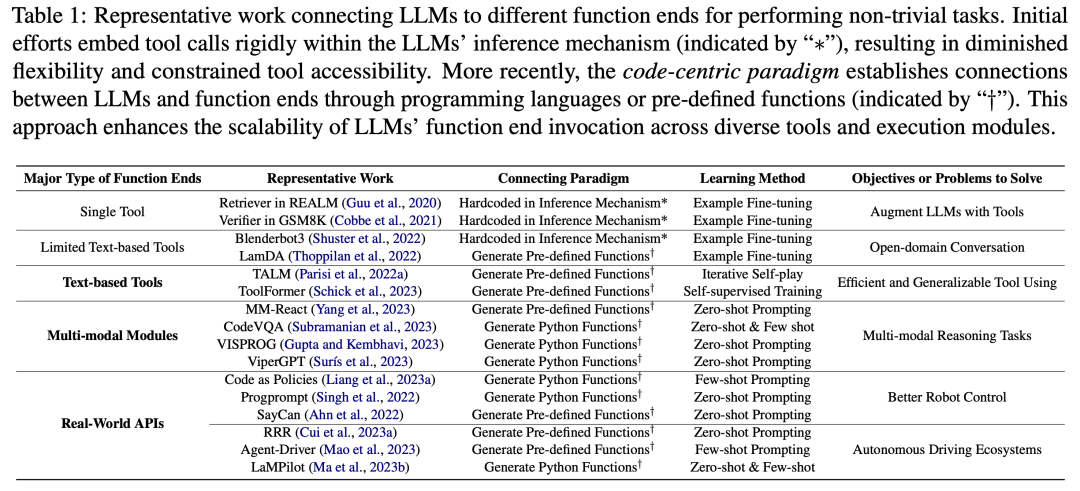
    在第二个部分中,如表 1 所示,研究人员观察到一种普遍趋势:LLMs 通过生成编程语言或利用预定义函数与其他功能端建立连接。这种 “以 code 为中心的范式” 不同于严格在 LLMs 推理机制中硬编码工具调用的刻板做法,它允许 LLMs 动态生成调用执行模块的令牌,具有可调整的参数。

    挥舞起代码语料的魔杖,大模型和智能体将召唤出更强大的能量

    这种范式为 LLMs 与其他功能端的互动提供了一种简单明确的方式,增强了它们应用的灵活性和可扩展性。更为重要的是,它也允许 LLMs 与涵盖多种模态和领域的众多功能端进行互动。通过扩展 LLMs 可访问的功能端的数量和种类,LLMs 能够处理更复杂的任务。

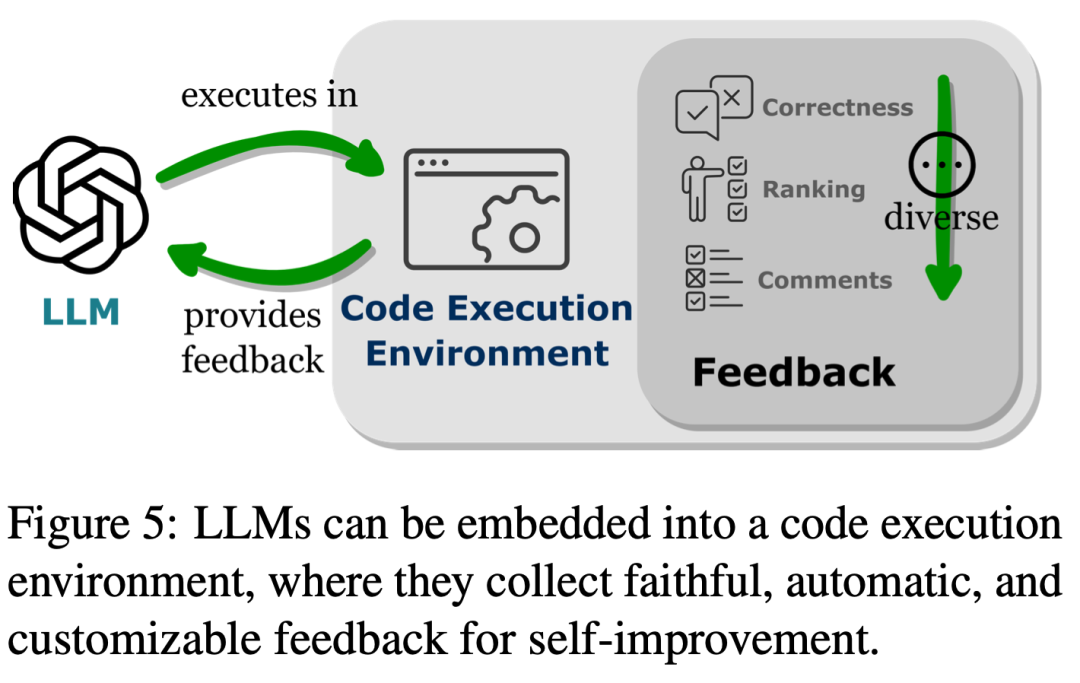
    如图 5 所示,将 LLMs 嵌入 code 执行环境可以实现自动化反馈和模型自主改进。LLMs 的表现超出了其训练参数的范围,部分原因是它们能够接纳反馈。然而,必须谨慎选择反馈,因为嘈杂的提示输入可能会妨碍 LLMs 在下游任务上的表现。此外,由于人力资源代价高昂,反馈需要在保持真实性的同时满足自动收集。在第三个部分中,研究人员发现将 LLMs 嵌入 code 执行环境可以获得满足所有这些标准的反馈。

    挥舞起代码语料的魔杖,大模型和智能体将召唤出更强大的能量

    首先,由于 code 执行是确定性的,从执行 code 的结果中获取反馈能够直白忠实反映 LLM 执行的任务。此外,code 解释器为 LLMs 提供了一种自动查询内部反馈的途径,消除了在利用 LLMs 调试或优化错误 code 时需要昂贵的人工注释的需求。Code 编译与执行环境也允许 LLMs 纳入多样化和全面的外部反馈形式,如简单的生成二值的正确和错误评价、稍复杂的对执行结果的自然语言解释,以及各种带有回馈值的排名方法,他们都使得提高性能的方法高度可定制化。

    通过分析 code 训练数据集成如何增强 LLMs 能力的各种方式,研究人员进一步发现,code 赋能 LLMs 的优势在 Intelligent Agent 的研发这项关键的 LLM 应用领域尤为明显。

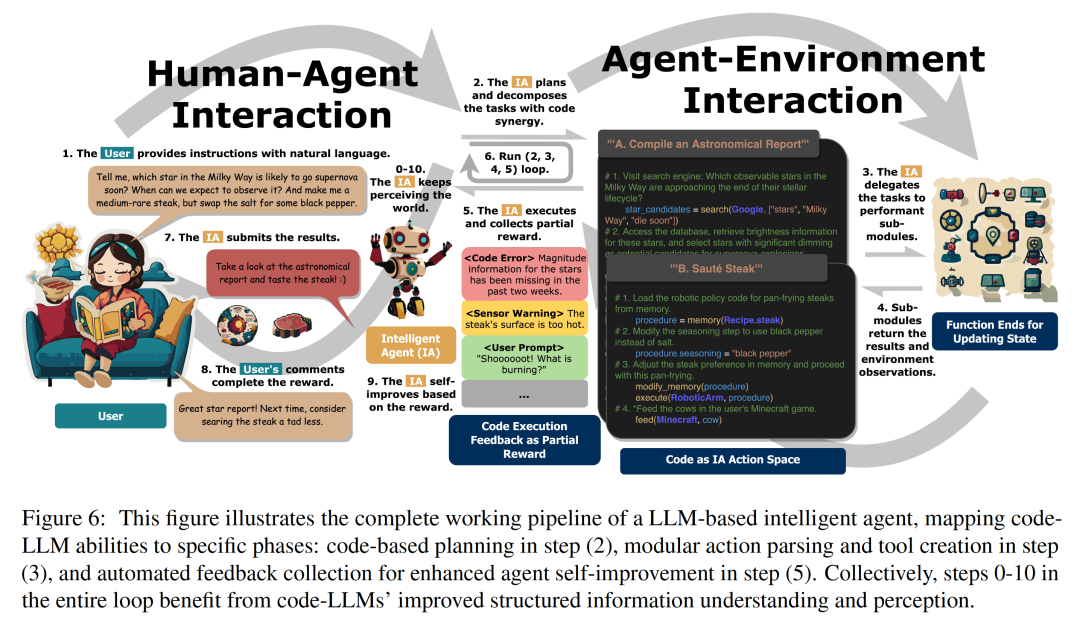
    图 6 显示了一个智能助理的标准工作流程。研究人员观察到,通过 code 训练在 LLMs 中带来的改进,也同时一一作用于它们作为智能助理时的实际步骤。

    挥舞起代码语料的魔杖,大模型和智能体将召唤出更强大的能量

    这些步骤包括:(1) 增强 IA 在环境感知和规划方面的决策能力, (2) 通过将行动落实于模块化动作原语和高效组织记忆来优化策略执行,以及 (3) 通过从 code 执行环境自动派生的反馈优化性能。

    总的来说,在本篇综述中,研究人员分析并阐明了 code 如何赋予 LLMs 强大能力,以及 code 如何协助 LLMs 作为 Intelligent Agents 决策中心工作。

    通过全面的文献回顾,研究人员观察到经过 code 训练后,LLMs 提高了它们的编程技能和推理能力,获得了实现与跨模式和领域的多种功能端的灵活连接能力,以及强化了与 code 执行环境中集成的评估模块进行互动并实现自动自我提升的能力。

    此外,code 训练带来的 LLMs 能力提升有助于它们作为 Intelligent Agent 在下游应用中的表现,体现于如决策、执行和自我提升等特定操作步骤。回顾以往的研究之外,研究人员也提出了该领域的几个挑战,作为未来潜在发展方向的指导要素。

    更多细节请参考原文!
    本站声明:本文内容由网友自发贡献,版权归原作者所有,本站不承担相应法律责任。如您发现有涉嫌抄袭侵权的内容,请联系bd@zhengruan.com
    作者最新文章
    业界资讯
    相关文章 更多
    Llama3训练每3小时崩一次?豆包大模型、港大团队为脆皮万卡训练提效
    Llama3训练每3小时崩一次?豆包大模型、港大团队为脆皮万卡训练提效

    伴随大模型迭代速度越来越快,训练集群规模越来越大,高频率的软硬件故障已经成为阻碍训练效率进一步提高的痛点,检查点(Checkpoint)系统在训练过程中负责状态的存储和恢复,已经成为克服训练故障、保障训练进度和提高训练效率的关键。近日,字节跳动豆包大模型团队与香港大学联合提出了ByteCheckpoint。这是一个PyTorch原生,兼容多个训练框架,支持Checkpoint的高效读写和自动重新切分的大模型Checkpointing系统,相比现有方法有显著性能提升和易用性优势。本文介绍了大模型训练提效中C

    TPAMI 2024 | ProCo: 无限contrastive pairs的长尾对比学习
    TPAMI 2024 | ProCo: 无限contrastive pairs的长尾对比学习

    AIxiv专栏是本站发布学术、技术内容的栏目。过去数年,本站AIxiv专栏接收报道了2000多篇内容,覆盖全球各大高校与企业的顶级实验室,有效促进了学术交流与传播。如果您有优秀的工作想要分享,欢迎投稿或者联系报道。投稿邮箱:liyazhou@jiqizhixin.com;zhaoyunfeng@jiqizhixin.com本论文第一作者杜超群是清华大学自动化系2020级直博生。导师为黄高副教授。此前于清华大学物理系获理学学士学位。研究兴趣为不同数据分布上的模型泛化和鲁棒性研究,如长尾学习,半监督学习,迁移

    亚马逊云创新「神经稀疏检索」:仅需要文本匹配就能实现语义搜索
    亚马逊云创新「神经稀疏检索」:仅需要文本匹配就能实现语义搜索

    AIxiv专栏是本站发布学术、技术内容的栏目。过去数年,本站AIxiv专栏接收报道了2000多篇内容,覆盖全球各大高校与企业的顶级实验室,有效促进了学术交流与传播。如果您有优秀的工作想要分享,欢迎投稿或者联系报道。投稿邮箱:liyazhou@jiqizhixin.com;zhaoyunfeng@jiqizhixin.com本文作者是来自OpenSearch中国研发团队的机器学习负责人杨扬博士以及机器学习工程师耿志超和管聪。OpenSearch是一个由亚马逊云科技发起的纯开源搜索和实时分析引擎项目。目前软件

    将图像自动文本化,图像描述质量更高、更准确了
    将图像自动文本化,图像描述质量更高、更准确了

    AIxiv专栏是本站发布学术、技术内容的栏目。过去数年,本站AIxiv专栏接收报道了2000多篇内容,覆盖全球各大高校与企业的顶级实验室,有效促进了学术交流与传播。如果您有优秀的工作想要分享,欢迎投稿或者联系报道。投稿邮箱:liyazhou@jiqizhixin.com;zhaoyunfeng@jiqizhixin.com皮仁杰:香港科技大学博士三年级学生,师从张潼教授和周晓方教授。于2024年获得苹果奖学金。目前主要研究方向是多模态大语言模型和数据为中心的AI。张鉴殊:武汉大学本科三年级学生,目前在张潼
    告别逐一标注,一个提示实现批量图片分割,高效又准确
    告别逐一标注,一个提示实现批量图片分割,高效又准确

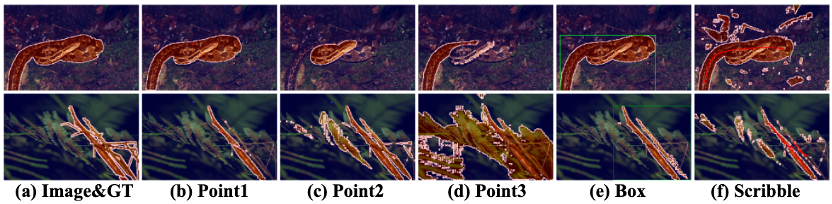
    仅需一个任务描述,即可一键分割所有图片!SegmentationAnythingModel(SAM)的提出在图像分割领域引起了巨大的关注,其卓越的泛化性能引发了广泛的兴趣。然而,尽管如此,SAM仍面临一个无法回避的问题:为了使SAM能够准确地分割出目标物体的位置,每张图片都需要手动提供一个独特的视觉提示。如下图所示,即使点击的是同一物体(图(b)-(d)),微小位置变化都会导致分割结果的显著差异。这是因为视觉提示语义信息的缺乏,即使提供了想要分割的目标物体上,仍然可能引发歧义。框提示和涂鸦提示(图(e)(
    CVPR 2024 | 分割一切模型SAM泛化能力差?域适应策略给解决了
    CVPR 2024 | 分割一切模型SAM泛化能力差?域适应策略给解决了

    第一个针对「SegmentAnything」大模型的域适应策略来了!相关论文已被CVPR2024接收。引言大语言模型(LLMs)的成功激发了计算机视觉领域探索分割基础模型的兴趣。这些基础分割模型通常通过PromptEngineer来进行zero/few图像分割。其中,SegmentAnythingModel(SAM)是最先进的图像分割基础模型。图SAM在多个下游任务上表现不佳但是最近的研究表明,SAM在多种下游任务中并非具有很强的鲁棒性与泛化性,例如在医学图像、伪装物体、添加干扰的自然图像等领域表现较差。

    ECCV 2024 | 提升GPT-4V、Gemini检测任务性能,你需要这种提示范式
    ECCV 2024 | 提升GPT-4V、Gemini检测任务性能,你需要这种提示范式

    AIxiv专栏是本站发布学术、技术内容的栏目。过去数年,本站AIxiv专栏接收报道了2000多篇内容,覆盖全球各大高校与企业的顶级实验室,有效促进了学术交流与传播。如果您有优秀的工作想要分享,欢迎投稿或者联系报道。投稿邮箱:liyazhou@jiqizhixin.com;zhaoyunfeng@jiqizhixin.com本文作者来自浙江大学、上海人工智能实验室、香港中文大学、悉尼大学和牛津大学。作者列表:吴逸璇,王逸舟,唐诗翔,吴文灏,贺通,WanliOuyang,PhilipTorr,JianWu。其
    贾佳亚团队联手剑桥清华等共推评测新范式 一秒侦破大模型“高分低能”
    贾佳亚团队联手剑桥清华等共推评测新范式 一秒侦破大模型“高分低能”

    颠覆过往大模型评测标准,最新、最全、最权威的测评数据集MR-Ben来了!这是继今年4月发布堪称GPT-4+DALL-E-3的王炸产品超强视觉语言模型Mini-Gemini后,港中文贾佳亚团队再次提出的极具代表性的作品。在MR-Ben的“监督”下,大模型不仅要像学生那样会答题,还要像老师那样会阅卷,真实的推理能力无所遁形。MR-Ben细致地评测了不少国内外一线的开源和闭源模型,如GPT4-Turbo、Cluade3.5-Sonnet、Mistral-Large、Zhipu-GLM4、

    ICML 2024高分论文 | 零阶优化器微调大模型,大幅降低内存
    ICML 2024高分论文 | 零阶优化器微调大模型,大幅降低内存

    AIxiv专栏是本站发布学术、技术内容的栏目。过去数年,本站AIxiv专栏接收报道了2000多篇内容,覆盖全球各大高校与企业的顶级实验室,有效促进了学术交流与传播。如果您有优秀的工作想要分享,欢迎投稿或者联系报道。投稿邮箱:liyazhou@jiqizhixin.com;zhaoyunfeng@jiqizhixin.com本文共同第一作者简介:张逸骅:密歇根州立大学计算机系博士三年级学生,师从SijiaLiu教授,主要研究方向是大模型的安全、隐私和效率问题。李平治:本科毕业于中国科学技术大学,将于2024

    哈工大提出创新迭代推理框架 DPE-MNER :充分发挥多模态表示潜力
    哈工大提出创新迭代推理框架 DPE-MNER :充分发挥多模态表示潜力

    AIxiv专栏是本站发布学术、技术内容的栏目。过去数年,本站AIxiv专栏接收报道了2000多篇内容,覆盖全球各大高校与企业的顶级实验室,有效促进了学术交流与传播。如果您有优秀的工作想要分享,欢迎投稿或者联系报道。投稿邮箱:liyazhou@jiqizhixin.com;zhaoyunfeng@jiqizhixin.com该文章的作者团队来自于哈工大社会计算与信息检索研究中心,作者团队构成:郑子豪、张梓涵、王泽鑫、付瑞吉、刘铭、王仲远、秦兵。多模态表示多模态命名实体识别,作为构建多模态知识图谱的一项基础而


    查看更多
    精品专题 更多
    装机必备
    装机必备

    正软商城装机必备专区,精选办公、浏览器、安全防护、影音播放、压缩解压、设计创作和系统工具等电脑常用正版软件,帮助用户快速完成新电脑软件配置。

    Windows
    Windows

    正软商城Windows软件专区,汇集适用于Windows电脑的办公、设计、安全防护、影音播放、开发工具和系统优化软件,提供软件介绍、系统要求、正版授权及购买下载服务。

    PDF教程
    PDF教程

    正软商城PDF教程频道提供PDF编辑、转换、合并、拆分、压缩及格式处理方法,同时介绍常用PDF软件和工具的使用技巧。

    Mac软件 更多
    讯飞智作 网页版
    讯飞智作 网页版
    Windows/ macOS/ Linux

    讯飞智作是一款基于语音合成技术、虚拟人驱动技术与数字人形象声音构建能力的 AI 数字人音视频创作平台。

    火山引擎 网页版
    火山引擎 网页版
    Windows/ macOS/ Linux

    火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。

    Aperty macOS版
    Aperty macOS版
    macOS

    Aperty 是 Skylum 推出的 AI 人像修图软件,支持自然肤质修饰、瑕疵处理、面部与身体调整、预设及批量同步。

    WINDOWS 更多
    讯飞智作 网页版
    讯飞智作 网页版
    Windows/ macOS/ Linux

    讯飞智作是一款基于语音合成技术、虚拟人驱动技术与数字人形象声音构建能力的 AI 数字人音视频创作平台。

    火山引擎 网页版
    火山引擎 网页版
    Windows/ macOS/ Linux

    火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。

    PixTV 网页版
    PixTV 网页版
    Windows

    PixTV 是一款在浏览器中使用的 AI 视觉内容创作平台,提供图片、视频、音频、文字生成、AI 分镜、局部重绘、提示词反推和无限画布等工具,适合短剧、漫剧、广告及社交媒体内容制作。