

AI能预测未来的科学发现吗?
这项由牛津大学、斯坦福大学与艾伦人工智能研究所联合开展的研究,于2026年5月以预印本形式发布,编号为arXiv:2605.22681v1。研究团队构建了一个名为CUSP(Cutoff-conditioned Unseen Scientific Progress,即"截止日期条件下的未见科学进展")
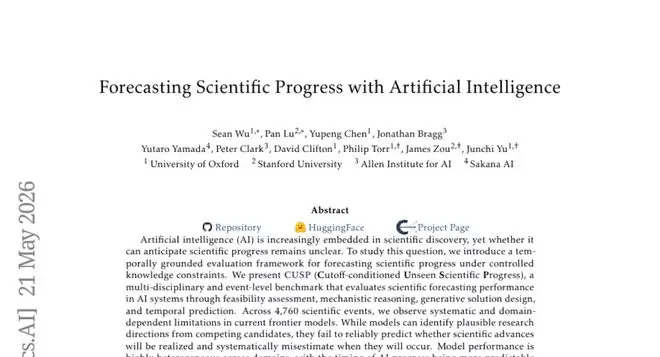
这项由牛津大学、斯坦福大学与艾伦人工智能研究所联合开展的研究,于2026年5月以预印本形式发布,编号为arXiv:2605.22681v1。研究团队构建了一个名为CUSP(Cutoff-conditioned Unseen Scientific Progress,即"截止日期条件下的未见科学进展")的测评框架,系统考察了当前最先进的AI系统是否真的能够预测科学发展的走向。
科学界一直存在一个颇为迷人的期待:如果AI掌握了人类积累的所有知识,它能否像一位洞察力超群的学者那样,提前预见下一个重大发现?毕竟,历史上不乏规律可循的科学进展,半导体领域有著名的摩尔定律——每隔约两年,芯片上的晶体管数量就会翻倍;深度学习领域有规模定律——模型越大、数据越多,性能越好。这些规律曾经帮助工程师和研究者制定路线图、分配资源。如今,AI系统被寄予厚望,人们希望它们不只是知识的检索工具,而是能够真正参与科学预见的"智能伙伴"。
然而,这项研究用4760个真实科学里程碑事件告诉我们:现有的AI系统在科学预测这件事上,表现远不如我们期待的那样出色。
一、研究者到底测了什么
为了搞清楚AI究竟能不能预测科学进展,研究团队精心设计了一套考试体系,而不是随便找几道题考考AI就算了。他们收集的素材来自《自然》《科学》《细胞》三大顶级学术期刊,以及Hugging Face、社区驱动的AI论文榜单,还有GPQA Diamond、MMLU-Pro和"人类最后的考试"(Humanity's Last Exam)等知名AI能力排行榜。时间跨度从2024年1月到2026年3月,涵盖生物学、人工智能、医学、神经科学、材料科学、物理学、环境科学、化学等九大领域。
核心思路是"时间封锁":研究者给AI划定一条时间红线,只允许它使用红线之前的知识,然后要求它预测红线之后发生的科学事件。这就好比让一位1990年代的科学家,仅凭当时的知识,预测2000年代会出现哪些重大发现。研究团队从每篇论文中剔除了所有会泄露答案的线索——包括新提出的方法名称、模型缩写、系统代号——确保AI无法靠"认出答案"来蒙混过关。
最终,17429个结构化预测任务从4760个科学里程碑中生成,分布在五种考题类型中。第一种是"是否题":某个具体的科学声明到某个日期之前能否实现?比如,"到2025年5月,某种方法能否在特定条件下将某类化学反应的产率提升30%?"第二种是变体版"是否题",将原始声明中的数字或条件做了微调,变成一个"听起来合理但实际上没有实现"的陈述,考察AI是否能识别这种细微差别。第三种是四选一的机制推理题:在四个听起来都很合理的技术路线中,选出真正被用来实现突破的那一个。第四种是开放性设计题:根据科学问题的背景,要求AI提出一套可行的解决方案。第五种是时间预测题:某个科学里程碑大约会在哪个月份实现?
所有题目都经过了两轮严格的质量把关。首先由Grok-3这个独立的AI系统审核,确保每道题都忠实于原始论文、可客观验证、没有信息泄露;然后由多所高校的研究生级别的人类专家进行人工复核。研究者还测量了AI审核员和人类审核员的一致性,结果显示两者在"保留题目"这件事上的精确率非常高——这意味着这套质量把关是可靠的。
二、AI被考出了什么成绩
研究团队测试了六款当前最先进的AI系统,包括OpenAI的GPT-5.4和GPT-4o、Anthropic的Claude Sonnet 4.5、Meta的LLaMA 3.3-70B、开放模式的GPT-OSS 20B,以及DeepSeek R1。这些模型代表了2024年底到2025年中期各个知识截止节点的AI系统。
机制推理题的成绩是六种题型中最好看的。GPT-5.4以81.9%的准确率领跑,而随机猜测的概率只有25%(四选一),所以所有模型都显著优于瞎猜。这说明AI确实具备一定的科学知识积累,能够在给定问题背景的情况下,从竞争性候选方案中识别出合理的技术路径。就像一个熟悉烹饪的厨师,即使不知道某道菜的具体食谱,也能在四种烹饪方法中猜出哪种更适合处理某种食材。
然而,一旦进入真正需要"预见未来"的环节,AI的表现就大打折扣了。在"是否题"上,所有模型的准确率都在45%到52%之间徘徊——而完全随机猜测的正确率是50%。换句话说,AI在判断一项科学声明是否会在指定日期前实现时,几乎和掷硬币没有区别。更耐人寻味的是,不同模型呈现出截然相反的答题偏见:LLaMA 3.3有强烈的"什么都说能实现"的倾向(在原题上答"是"的比例高达93%),而GPT-4o和GPT-OSS则有强烈的"什么都说不能实现"的倾向(在原题上答"是"的比例只有19%左右)。这种偏见并不反映真实的科学判断,而是模型自身的系统性"脾气"。
时间预测题揭示了另一种有趣的错误模式。所有模型都系统性地把科学事件的发生时间往后推——也就是说,它们认为科学进展会比实际发生得更晚。平均预测误差在四到三十六个月之间,GPT-4o的中位误差高达26个月,而LLaMA 3.3相对较好,中位误差只有4个月。值得注意的是,LLaMA 3.3在时间预测上排名第一,但这部分原因来自一个有趣的"意外":它倾向于把大量预测集中锁定在2025年中期附近,形成了一个密集的"时间锚",当真实事件恰好落在那个区间时,它的得分就会比较高。从散点图上看,各模型的预测点呈现出横向的带状分布,而非沿对角线分布——理想的预测应该是散点紧密分布在对角线附近,说明预测日期和真实日期接近。
开放性设计题的表现则展示了AI能力的一个独特裂缝。GPT-5.4的综合得分最高(5.04分,满分10分),通过率(得分≥5)达到60.3%,其他所有模型的通过率都在20%以下。更有意思的细节在于:几乎所有模型的"技术具体性"得分都远高于"方向吻合度"得分,两者之间的差距高达1到3分。这意味着AI能够写出听起来非常专业、细节丰富的技术方案,但这些方案往往并不是真正解决了问题的那条路。就像一个厨师写了一份详尽的菜谱,食材选择合理,步骤清晰,但做出来的菜和真正的目标料理相差甚远。这是一种"精确地跑偏"的能力。
三、AI在自己熟悉的领域和陌生领域表现有何不同
直觉上,我们会认为AI应该对它"见过"的事件表现更好,对它"没见过"的事件表现更差。毕竟,一个人如果曾经读过某篇论文,理应对其内容更了解。
研究团队专门对此进行了验证。他们把所有测试事件分为两类:发生在各模型知识截止日期之前的"已知事件",和发生在截止日期之后的"未知事件"。结果颇为出人意料——两类事件的得分差距非常小,在大多数题型上几乎没有显著区别。GPT-5.4在机制推理题上,已知事件得分0.830,未知事件得分0.792;在开放性设计题上,两者都是5.04分。Claude S4.5、DeepSeek R1等模型的情况类似。
这个发现打破了"AI表现差是因为不知道答案"的简单解释。如果问题只是知识盲区,那么对于已知事件应该表现显著更好;但事实上并非如此。这至少意味着两种可能:一是AI在训练时虽然"见过"这些事件,但并没有真正将相关信息整合为可以用于预测的知识;二是即便拥有完整的知识,AI也缺乏将知识转化为可靠预测的能力。换句话说,知道发生了什么,并不等于能够预测它会发生。
四、给AI更多信息有帮助吗
既然AI表现不佳,一个自然的疑问是:如果给它提供更多参考资料,结果会不会更好?
研究团队设计了一个受控实验,对500个测试事件进行了三种条件下的对比。第一种是让AI单独作答,不提供任何额外信息;第二种是给AI配备网络搜索工具,但限制只能搜索截止日期之前的内容(即历史知识增强);第三种是允许AI进行无限制搜索,可以获取包括目标事件在内的全部信息(即"开卷考试")。
历史知识增强确实带来了明显的改善。在GPT-4o上,是否题的正确率从19.2%提升到47.6%,机制推理题从54.2%提升到58.9%,开放性设计题的平均分从3.28提升到3.72。这说明AI在基础模式下并没有充分调用自己应当拥有的历史知识,有相当一部分知识在回答这类问题时是"睡着的"。
但关键的发现在于:即使提供了截止日期前的所有历史知识,AI在预测未来事件上仍然和"全知模式"(允许搜索目标事件本身)之间存在巨大差距。研究者将这个差距分解为两部分:一是"知识鸿沟",代表历史知识增强带来的性能提升;二是"预测鸿沟",代表在历史知识已经充分的情况下,AI仍然无法追平全知模式的剩余差距。在时间预测任务上,GPT-5.4的预测鸿沟(0.436)远大于知识鸿沟(0.070)。这说明,预测能力的缺失不能用信息不足来完全解释,AI本身在"向前看"这件事上存在根本性的局限。
更有意思的是,这个预测鸿沟与科学发现的影响力密切相关。研究者按照论文被引用次数将测试事件分为四个档次,发现越是高影响力的突破性发现,AI的预测鸿沟越大。在GPT-5.4上,低引用量论文的预测鸿沟约为0.060,而高引用量论文的预测鸿沟飙升至0.875。也就是说,AI对那些真正改变领域走向的重大发现,预测能力最弱。这有点像说,AI能猜到下个月的小新闻,但对于改变历史进程的大事件,它几乎猜不准。
五、AI在哪些科学领域表现更好,哪些领域更差
科学发现并非铁板一块,不同领域的研究节奏、方法体系、可预测性差异很大。研究结果也清晰地呈现出这种异质性。
在机制推理题上,环境科学(66.2%)、神经科学(65.8%)和物理学(62.1%)的准确率相对较高,而化学(49.8%)、材料科学(54.2%)和AI(54.3%)相对较低。这可能反映了不同领域的技术路线集中程度——物理学的实验手段相对固定,更容易从候选方案中识别正确路径;而化学合成路线千变万化,AI更难做出准确判断。
时间预测的领域差异最为突出。AI领域的时间预测得分(0.461)显著高于其他所有领域(通常在0.18到0.28之间)。这并不难理解:AI领域的进展高度依赖于可量化的指标,比如各类基准测试的成绩,而且这些数据在互联网上公开更新、记录完整,模式更为规律。相比之下,生物学、化学和物理学的突破往往来自意想不到的实验发现,很难从历史趋势中推断时间节点。
在开放性设计题上,神经科学(4.11分)、生物学(4.05分)和AI(4.04分)表现最好,而化学(3.54分)、物理学(3.74分)和材料科学(3.80分)相对较弱。化学和物理学的低分反映了这两个领域高度专业化的特点,与AI训练数据中覆盖更广的普通知识之间存在较大差距。
有一个发现在所有领域都保持一致:是否题的正确率在任何领域都没有突破随机水平(46%到52%之间),甚至在AI领域也不例外。这意味着,无论在哪个科学领域,AI都无法可靠地判断一项具体的科学声明是否会在规定时间内实现。
六、AI对自己的预测有多自信,又有多准
自信和准确是两回事。医生可以自信地给出诊断,但自信不等于正确。研究者专门测量了AI的"自信度"(stated confidence)和实际正确率之间的差距。
结果显示,几乎所有模型在所有题型上都系统性地过于自信。在是否题上,模型平均自信度比实际准确率高出约0.2分;在机制推理题上,高出幅度更大,DeepSeek R1甚至高出0.3分以上;在时间预测题上,GPT-4o的过度自信幅度高达0.6分。这种校准误差在统计学中用"期望校准误差"(ECE)来衡量,值越低越好,而大多数模型的ECE都在0.2以上,属于严重失准的范畴。
更微妙的发现在于,这种过度自信的程度在知识截止日期前后呈现出不同的变化模式。在机制推理题上,几乎所有模型在面对截止日期之后的"未知"事件时,过度自信程度反而增加了——尽管准确率没有相应提升。这就好比一个学生考到自己没复习过的章节时,反而变得更自信了,这显然是一种危险的信号。相比之下,在时间预测题上,过度自信程度在截止日期之后明显下降,一些模型的过度自信值甚至转变为负数(即对自己的时间判断过于谦虚)。是否题的过度自信则没有一致的变化方向,在不同模型之间表现各异。
这些发现共同表明:AI并没有一套稳定、统一的不确定性感知机制。它的自信程度是"碎片化的",在不同题型、不同时间范围之间呈现出不同的失准模式,而且这种失准并不是简单地随着"难度增加而变得更谦虚",而是以复杂、不可预测的方式变化。
七、向未来发出的"时间胶囊"
研究团队还做了一件颇有趣味的事:他们构建了一组"时间胶囊"问题,即真实结果尚未揭晓、需要等待未来验证的预测题目。这些题目涵盖科学里程碑(如超导临界温度记录)、机构荣誉(如2026年诺贝尔物理学奖的颁奖方向)、量化指标(如2027年全球二氧化碳排放量)以及AI能力预测(如未来某个时间节点上Humanity's Last Exam的得分)。
在全球碳排放预测上,六款模型都认为2027年的排放量会高于2025年,但具体数值分歧明显。Claude S4.5、DeepSeek R1和GPT-4o的预测相对保守,接近历史趋势的延续;GPT-5.4的预测略高;LLaMA 3.3和GPT-OSS的预测最为激进,LLaMA 3.3给出了所有模型中最高的预测值。这说明不同AI系统内嵌了不同的"世界模型"——关于减碳速度、技术进步对能源结构影响的隐含判断各有不同。
在AI能力预测上,六款模型对GPQA Diamond和MMMLU这两个已经接近饱和的榜单都预测会进一步提升,但幅度普遍不大(1%到3%),暗示它们预期这些榜单很快就会被"考满"。对于Humanity's Last Exam这个更开放、更难的测试,预测分歧更大,GPT-5.4最为乐观,预测到2027年10月无工具版本的得分会从当前56.8%跃升至74%,有工具版本从64.7%升至82%;DeepSeek R1则更为保守,预测幅度较小。六款模型都预期AI能力会在2026到2027年间持续提升,这种一致性本身也很有意思——它反映了AI系统对自身领域未来走向的某种"共识",尽管这种共识很可能来自对过去规律的外推,而非真正的洞察。
八、研究者如何保证这场考试是公平的
这套评测框架的可信度依赖于一系列严格的质量控制措施,值得单独介绍。
在题目生成阶段,研究团队使用GPT-4o将每篇论文摘要分解为三个结构化组件:问题陈述、技术路径和结果指标。在这个过程中,所有可能泄露答案的信息都被剔除——包括论文新提出的名词缩写、方法命名和系统名称。这确保了AI在答题时无法通过"认出"答案来得分。
题目质量由Grok-3进行独立审核(之所以用Grok-3而不是GPT-4o,是为了避免"自己出题自己打分"的偏差)。审核标准分为四类:忠实性(题目是否准确反映论文内容)、可验证性(结论是否可以客观判断是非)、扰动有效性(对于变体是否题,改动是否真正使陈述不再成立)以及干扰项质量(对于四选一题目,错误选项是否足够迷惑人而又不正确)。
研究者还招募了十位来自牛津大学、耶鲁大学、密歇根大学、芝加哥大学和香港中文大学深圳校区的研究生级别专家,在同样的标准下对题目进行人工审核,并与Grok-3的判断进行比对。结果显示AI审核员在保留高质量题目方面比人类更为严格,误伤有效题目的情况较少,而人类审核员在某些情况下对模糊边界的容忍度更高。总体而言,两者的一致性足够高,确认了自动化审核流程的可靠性。
开放性设计题的评分则采用了另一套机制:先由带有网络搜索能力的GPT-5.4 mini检查AI的回答是否包含截止日期之后才出现的信息(如果包含则视为泄题,该答案不计分),然后再从方向吻合度、技术具体性、新颖性、可行性四个维度分别打0到10分,取平均值作为最终得分。研究者还对这套评分系统进行了人机一致性验证,在60个例子上与三位CS博士评委的打分进行对比,皮尔逊相关系数为0.34(具有统计显著性),平均绝对误差为0.75分,AI评委略微偏宽松(平均高估0.26分),但总体上与人类判断有足够的相关性。
说到底,这项研究的结论可以用一个简单的比喻来概括:AI像一个知识渊博、博览群书的图书管理员,能够在你提问时迅速找到相关资料,甚至能在四个候选技术路径中识别出哪个最合理。但当你问它"这本书大概什么时候会出版",或者"这项研究最终会不会成功",它的回答和随机猜测几乎没有区别——而且它还会用非常自信的语气告诉你它的"猜测"。
这并不是AI的失败,而是对AI当前能力边界的精确描绘。预测科学进展不只需要知识,还需要理解发现是如何在不确定性中诞生的,需要感知哪些研究方向正在蓄积能量,哪些看似可行实则走入了死胡同。这种能力,目前的大语言模型还远远没有掌握。
有一个细节特别值得记住:AI对高影响力的突破性发现预测最差,而对普通水准的研究预测相对较好。这意味着,AI系统的知识图谱虽然广博,但对于那些真正改变领域走向的"奇点时刻",它的预测能力最弱——而这恰恰是科学预测最有价值的部分。有兴趣深入了解这项研究的读者,可以通过arXiv编号2605.22681查阅完整论文。
Q&A
Q1:CUSP基准测试包含哪些类型的题目?
A:CUSP包含五种题目类型:判断某项科学声明能否在指定日期前实现的是否题、将原始声明微调后形成的变体是否题(正确答案为"否")、从四个技术路径中选出真正实现突破的机制推理选择题、要求AI提出解决方案的开放性设计题,以及预测某个科学里程碑发生月份的时间预测题。
Q2:AI在科学预测中最大的问题是什么?
A:AI在科学预测中存在两大核心问题。第一是"是否判断"几乎等同于随机猜测,准确率在45%到52%之间,与掷硬币无异。第二是系统性过度自信,AI的自信程度远高于实际准确率,在时间预测上尤为严重,而且这种失准在截止日期前后呈现出复杂、不一致的变化模式,说明AI没有稳定可靠的不确定性感知机制。
Q3:为什么给AI更多历史知识也无法显著提升科学预测能力?
A:研究发现,即使为AI提供充分的历史知识,它在预测未来科学事件上仍与"全知模式"存在巨大的"预测鸿沟"。这说明预测能力的缺失不能用信息不足来解释——AI缺少的是将已有知识转化为可靠前瞻判断的能力。特别是对于高影响力的突破性发现,这个鸿沟最大,GPT-5.4在高引用论文上的预测鸿沟高达0.875。
发现显卡风扇不转先别慌,这很可能是正常的智能启停功能。本文详解如何区分待机静音与硬件故障,提供从软件检测到物理清理的完整解决思路。
笔记本加装新内存后遇到黑屏或无法开机?不要慌张,本文通过重新插拔、清洁金手指、单根测试等具体操作步骤,帮你快速判断是安装失误还是硬件不兼容,并给出相应解决办法。
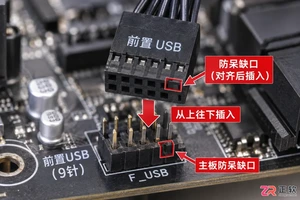
针对电脑主机前置USB接口无法识别设备的问题,本文提供一套基于因果逻辑的排查流程。涵盖检查机箱内部USB针脚连接、验证BIOS中USB控制器状态、更新芯片组驱动以及排除供电不足等常见原因,帮助用户快速恢复接口功能。
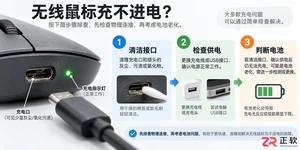
遇到无线鼠标充不进电的问题,不要急于更换设备。本文详解从清理接口氧化层、更换数据线到检测电池电压的完整排查流程,帮助你判断是临时故障还是硬件损坏。
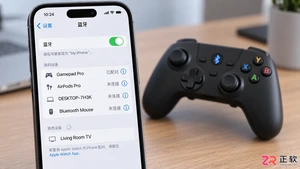
想知道如何用蓝牙手柄玩吃鸡游戏?本文详细讲解手机蓝牙手柄的连接步骤、主流映射软件的使用方法以及实战中的键位布局技巧,助你提升射击手感,同时解析外设玩家的匹配机制与注意事项。
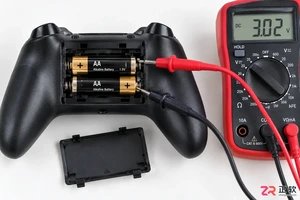
本文深入分析游戏手柄蓝牙频繁断开且需重连的根本原因,涵盖电池电压检测、操作系统电源管理策略及驱动冲突。通过具体的系统设置调整和固件更新步骤,解决蓝牙握手失败问题,恢复手柄的稳定连接状态。
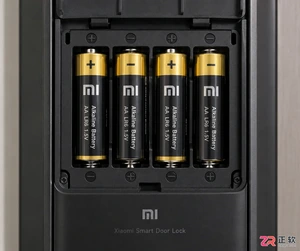
小米智能门锁更换新电池后无法开机或屏幕不亮?本文详解电池极性检查、金属触点清洁及强制重启方法,帮你快速解决供电问题,让门锁恢复正常使用。
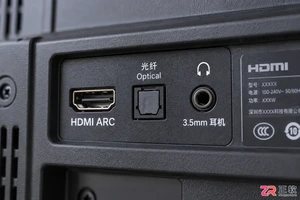
想让电视声音更震撼?本文详解如何通过HDMI ARC、光纤、蓝牙和3.5mm接口将电视连接至外置音响,包含具体设置步骤与常见问题排查,助你轻松打造家庭影院。




Photoshop 2026 是 Adobe 推出的专业图像处理与视觉设计软件,支持 Windows、macOS 和 iPad 等平台,广泛应用于摄影修图、电商设计、平面海报、数字绘画及视觉合成等创作场景。

Blender 是一款免费开源、跨平台的专业 3D 创作软件,集建模、动画、渲染、视频编辑与视觉合成等功能于一体,广泛应用于影视动画、游戏设计和建筑可视化等领域。软件支持 Cycles 物理渲染器与 Eevee 实时渲染引擎,并提供多边形建模、骨骼绑定、物理模拟等专业工具。Blender 兼容 Windows、macOS 和 Linux 系统,安装包轻巧、运行流畅,依托活跃的全球开发者社区持续更新,是从初学者到专业创作者都值得选择的正版 3D 创作工具。


Photoshop 2026 是 Adobe 推出的专业图像处理与视觉设计软件,支持 Windows、macOS 和 iPad 等平台,广泛应用于摄影修图、电商设计、平面海报、数字绘画及视觉合成等创作场景。
Blender 是一款免费开源、跨平台的专业 3D 创作软件,集建模、动画、渲染、视频编辑与视觉合成等功能于一体,广泛应用于影视动画、游戏设计和建筑可视化等领域。软件支持 Cycles 物理渲染器与 Eevee 实时渲染引擎,并提供多边形建模、骨骼绑定、物理模拟等专业工具。Blender 兼容 Windows、macOS 和 Linux 系统,安装包轻巧、运行流畅,依托活跃的全球开发者社区持续更新,是从初学者到专业创作者都值得选择的正版 3D 创作工具。