

AI算力变局:TPU正成为“另一个选项”
随着AI算力需求从训练转向推理,谷歌TPU凭借集群效率与成本优势加速崛起。第八代TPU将训练与推理拆分,并传出与英特尔、三星合作。未来AI芯片市场或形成442格局,TPU正成为GPU之外的重要选项。
TPU的关注度,确实肉眼可见地在上涨。
就在过去一个月,围绕谷歌TPU的新闻接连不断。4月底,谷歌发布了第八代TPU,这次它做了一个很有意思的决定——把训练和推理拆成了两款独立的芯片。紧接着,市场上又传出谷歌向英特尔下了大规模采购订单,还打算跟三星联手开发新一代TPU。虽然谷歌方面对这些消息都没公开回应,但一个趋势已经越来越清晰:随着谷歌TPU大举入局,过去几年几乎成为AI算力代名词的GPU,终于不再是唯一的主角了。当算力需求的重心从训练转向推理,TPU的优势开始显现,它正在从一个“配角”,逐步站上主舞台。
先简单区分一下这两种芯片。GPU诞生已经二十多年,全称是图形处理器,技术非常成熟,代表公司是英伟达和AMD。而TPU是谷歌从2015年开始专门为AI设计的新品类,全称是张量处理器,它的核心任务就是深度学习里最常用的矩阵运算。
集群计算需求增长
那么,TPU为什么偏偏在现在成为焦点?要理解这一点,先得看看市场需求正在经历什么样的变化。
国家数据局发布的《全国数据资源调查报告(2025年)》显示,2025年,中国AI推理数据量首次超过了训练数据量。TrendForce集邦咨询的数据预测,北美五大云服务商2026年AI训练算力预计增长56%,而推理算力将暴增122%,后者增速是前者的两倍以上。IDC也预测,到2029年,中国市场的推理算力占比将接近八成。
推理正在成为算力需求的主战场,而这恰恰为TPU创造了机会。
原因之一是,模型越做越大,单颗芯片已经扛不住了。必须依靠多颗芯片的集群协同才能完成推理任务,而TPU在集群效率上有先天优势。中昊芯英创始人杨龚轶凡打了个比方:“智能体正在逐步替代人类的部分工作,本质是用写程序的能力控制电脑。只有当模型足够大时,才能完成程序员能做的事。现在模型参数已经从亿级到了万亿级,单颗芯片根本没法承载完整的推理任务,必须靠几十甚至上百颗芯片互联集群协同运算。”
中昊芯英是一家专注TPU芯片技术研发的企业。杨龚轶凡进一步解释,GPU的强项是单卡通用算力和软件生态,而TPU的优势恰恰体现在大规模集群的通信与协同效率上。
一位前谷歌TPU工程师在一档视频节目中讲得更具体:GPU单机内部靠NVLink、板载NVSwitch实现多卡互联,但跨机架的大规模集群还得额外采购交换机和光模块来搭建高速网络,这些配套硬件本身就是一笔巨大的基建开支。而TPU机柜内的芯片可以直接互通,只有在跨机柜扩展时才用到自研的光电路交换机,完全不需要大批量采购商用高速交换设备。在同等集群通信性能下,整体部署硬件成本要低得多。
另一个关键因素是,推理阶段对性价比的敏感度远高于训练。当Token消耗呈指数级暴增,单位算力成本就成了更受重视的指标。从架构上看,TPU是专用芯片,它剔除了GPU的图形渲染、通用计算等功能,一门心思扑在深度学习矩阵运算上。杨龚轶凡指出,谷歌TPU在发布时,对比同等生产工艺的GPU,有3到5倍的性能提升。
细分场景里的选择
那么,到底什么场景下GPU更合适,什么场景下TPU更优?这个问题得回到芯片设计的原点来看。
杨龚轶凡解释说,GPU最早是为了在电脑屏幕上显示逼真的3D游戏画面而设计的。它要把三维物体从各个角度算成二维画面,还要算光线、颜色,让画面足够真实。这就导致GPU里塞了上万个计算核心,像一个大工厂里有一万名工人同时干活。优点是并发能力强,处理图像和矩阵运算非常快。但缺点也很明显——一旦某个工人算错了,你根本没法在一万名工人里快速找到是谁出了问题。
而AI深度学习的计算模式完全不同。深度学习模型是一层一层往下计算的,每一层内部可以高并发,但层与层之间有先后顺序。这种模式不需要GPU那么复杂的调试和通用能力。于是,TPU这类专门为AI设计的芯片应运而生,只聚焦深度学习最常用的运算。
这就好比,从之前要同时调度一万个工人,变成只需要调度一千个按固定流水线工作的工人,控制逻辑简单得多。
基于这种架构差异,杨龚轶凡预测,未来AI芯片市场将形成“442”格局:40%是极致性价比的纯ASIC芯片,只能跑固定一两个模型的推理,性价比做到极致;40%是可编程的DSA芯片,比如TPU,支持深度学习网络的算法,芯片利用率不如ASIC,但比GPU强很多;剩下20%是通用GPU,留给还在快速变化的新算法和研究场景。
不过,这并不意味着TPU对GPU是替代关系。关键在于具体场景的适配。杨龚轶凡认为,20%的GPU市场会长期存在。原因在于,AI领域的新算法、新方向还在不断涌现,研究人员需要一个通用、灵活的平台来快速验证想法。CUDA生态经过20年打磨,成熟度极高,当新的计算场景出现时,GPU仍然是首选。
而TPU的优势在于性价比和生态建设成本。杨龚轶凡举了一个例子:TPU的设计思路是让开发者“只管开车,不用修车”。它的硬件指令专为AI计算优化,同时适配PyTorch这类主流框架。PyTorch就像一个AI“乐高工具箱”,开发者用熟悉的“积木”搭模型,剩下的交给TPU编译器自动优化,不用为了迁就硬件去学一套新编程语言。相比之下,CUDA更像一套“修车工具”,开发者必须懂“发动机原理”才能玩得转——这套工具是行业积累了十多年的成果。TPU则是依托现有成熟AI框架,大幅降低了软件适配门槛,这也是其性价比优势的重要来源。
当下,AI Agents正在逐步进化成全球社会生产力的核心基座,带动Token消耗量指数级攀升,“Token经济”时代已经来临。当Token消耗呈指数级增长,芯片的利用率和性价比就成了更重要的比拼项。TPU正迎来新的机会,它正在成为AI芯片赛道上,除GPU之外的“另一个选项”。
立昂云数据与优刻得达成战略合作,联合打造“AI算力资源池”,整合GPU集群与云计算能力,面向智能制造、智慧城市等领域提供弹性算力服务,加速AI行业应用落地,具体投资金额未披露。
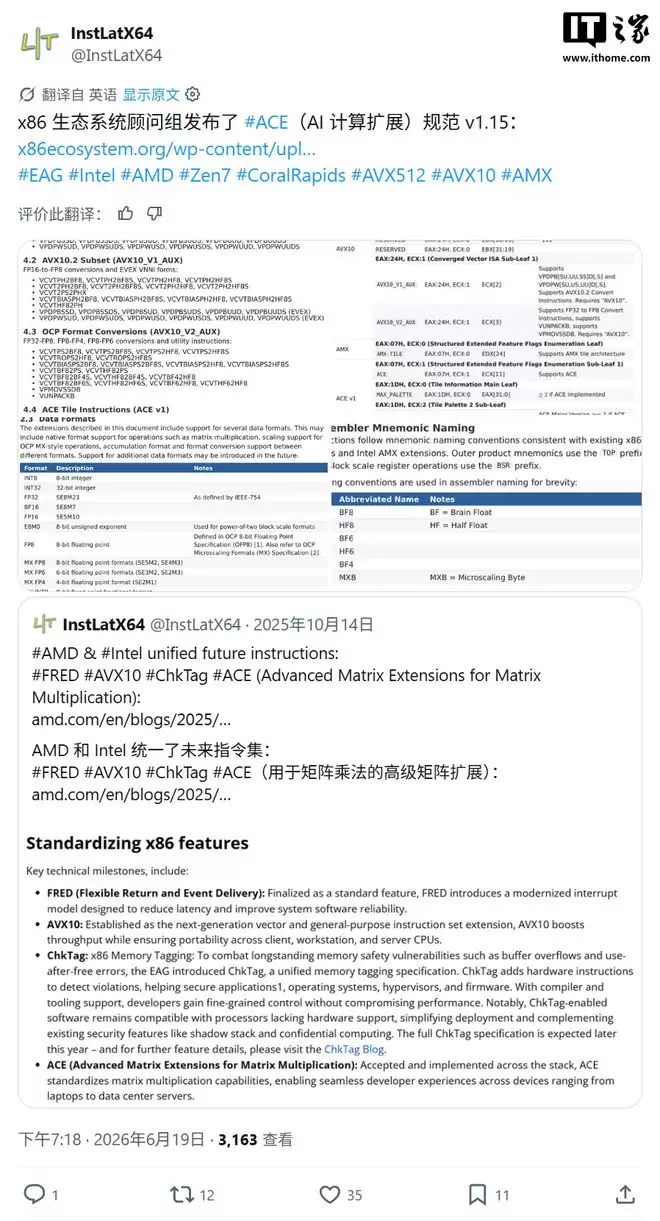
ACE规范1.15版本发布,通过原生矩阵乘法引擎和低精度格式,增强x86架构AI性能。指令集优化矩阵运算与低精度处理,由英特尔与AMD联合推动,避免生态碎片化。AMD计划在Zen6及Zen7中引入全新AI支持。
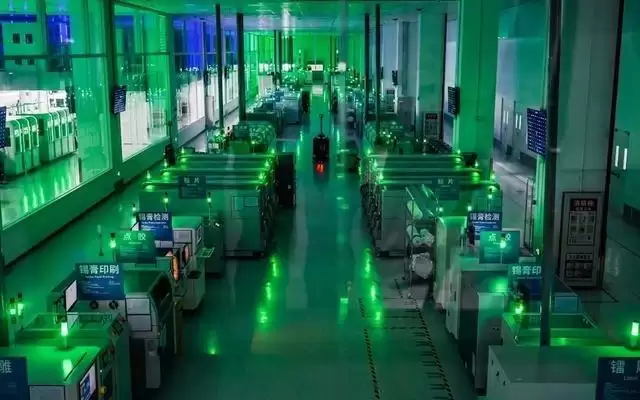
梅卡曼德机器人从北京研发到天津生产,雄安规划总部,体现京津冀产业共生。联想天津工厂实现9秒下线一台电脑,研发与量产零距离协同。京津“双城记”从技术转移走向深度产业共生,创新与制造优势互补催生新质生产力。
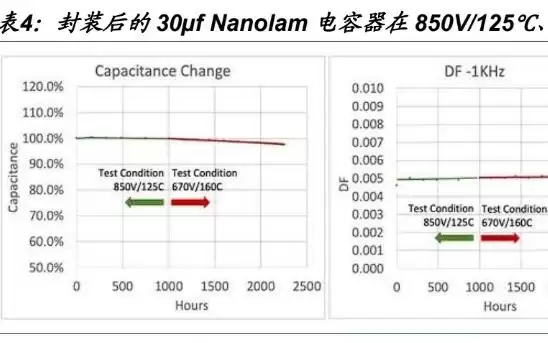
电容在AI算力系统充当“电RAM”缓冲能量。市场测算多局限于PSU内部“白区”,忽视电网至机柜“灰区”增量。机柜功率提升与供电高压化下,电容需求弹性远超GPU增速,叠加高端材料瓶颈与海外保守扩产,具备上游优势的国产厂商迎来份额扩张与定价权提升。
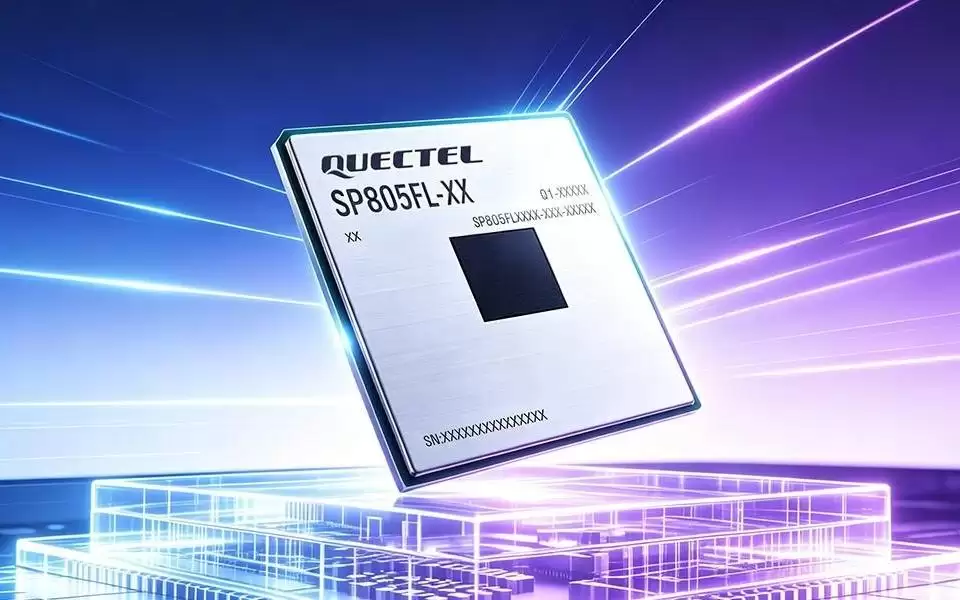
移远通信推出首款联发科旗舰级AI算力模组SP805FL系列,基于GenioPro5100芯片,采用3nm制程,配备50+TOPSNPU,支持多种数据格式,集成Wi-Fi7和蓝牙6.0,接口丰富,面向机器人、智能头盔等高端边缘AI场景。
英伟达与澳大利亚AI公司合作在印尼建设数据中心,加速“AI即服务”战略向东南亚渗透。此举拉动国内光模块、服务器等算力产业链海外需求,中际旭创、浪潮信息等核心企业深度受益,云计算ETF覆盖相关环节。
Meta与数据中心运营商Crusoe签署AI算力协议,获得约1.6吉瓦绿色算力资源。Crusoe利用伴生天然气发电降低碳排放,此举既满足算力需求,又控制能源足迹,预示未来AI竞争取决于稳定、低成本的电力与算力基础设施。
2026年厄尔尼诺引发极端高温,全球AI数据中心面临严峻考验。高功耗芯片稳定性受威胁,恶劣天气已成数据中心保险损失首要原因,全球79%容量面临气候灾害。AI算力需求激增与高温叠加,冷却系统能耗攀升,电网承压。科技巨头加速布局液冷技术以应对气候风险。
华丰科技集中发布二十余款新品,覆盖AI算力、航空航天、低空经济、具身智能、新能源五大领域。AI算力方面推出224G高速连接器及6.4TNPO光模块,航空航天领域发布宇航级56Gbps高速I/O连接器,同时推出低空防坠毁记录仪、新能源充电插座及工业级“灵巧手”产品。
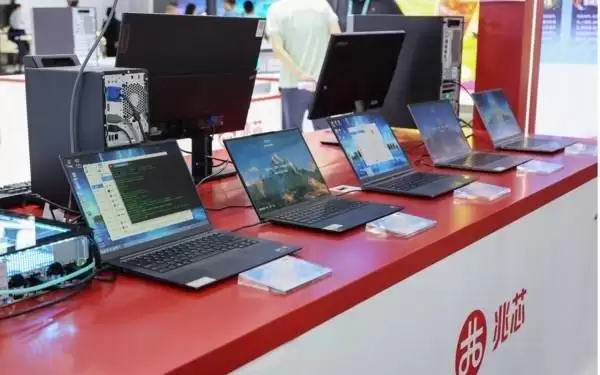
AI智能体兴起,CPU在AI算力中重回前排。兆芯KH-50000等产品表明,CPU作为异构系统算力基座,负责调度、虚拟化及智能体运行,支撑云端企业级AI应用。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



