

如何通过Stream API实战实现对大规模社交网络变量的共同好友提取
先说结论:用Ja va Stream API提取共同好友,逻辑说到底就是求两个好友集合的交集,只不过用函数式风格写出来,代码干净、易读,调试也挺顺手。它不像MapReduce或者图计算框架那样重,适合处理几万到百万级用户关系的数据量——再大的话,硬扛内存可能会有压力。 先理顺数据结构 得先把原始文本
先说结论:用Ja va Stream API提取共同好友,逻辑说到底就是求两个好友集合的交集,只不过用函数式风格写出来,代码干净、易读,调试也挺顺手。它不像MapReduce或者图计算框架那样重,适合处理几万到百万级用户关系的数据量——再大的话,硬扛内存可能会有压力。
先理顺数据结构
得先把原始文本转成Ja va可操作的对象。假设每行数据长这样:A:B,C,D,意思就是用户A的好友为B、C、D。
- 用 Map
- 读文件时可以用 Files.lines() + stream() 流式处理,不用一次把整个文件塞进内存。
- 对每行做 split(":") 和 split(","),再用 Collectors.toSet() 把好友们收进一个集合里。
算任意两个人的共同好友
给两个用户ID,比如"A"和"B",直接走这一行逻辑就行:
- friendsMap.get("A").stream().filter(friendsMap.get("B")::contains).collect(Collectors.toList())
- 注意提前判空。如果某个用户压根不存在,或者好友集合是null,直接返回空列表,别让它崩出NullPointerException。
- 需要排序或截取前几个结果的话,可以在filter后面接 sorted() 或 limit(5)。
批量找出所有有共同好友的用户对
这里用了一点技巧,不是搞暴力双重循环去两两比对,而是利用Stream的组合来降低复杂度:
- 从 friendsMap.entrySet().stream() 开始,遍历所有用户。
- 对每个用户u,用 flatMap 展开它的好友v,然后以(v, u)为键生成用户对——记得控制u < v的字典序,避免重复计算。
- 对每对(u,v),计算它们的共同好友集合,再用 filter(common -> !common.isEmpty()) 把空结果的筛掉。
- 最后用 Collectors.toMap() 整理成 Map
>
性能和边界几个容易踩的坑
实际跑起来卡住的地方往往不是算法本身,反而是细节处理不到位:
- 原始数据里随时可能夹着空行、多余空格、甚至大小写不一致——用 map(String::trim) 和 filter(s -> !s.isEmpty()) 先做一遍清洗,养成习惯。
- 好友ID里偶尔会混进一些不可见字符,比如\uFEFF这种BOM头。遇到这种情况,建议用 strip() 来替代 trim(),处理得更干净。
- 如果数据量超过100万行,可以考虑用 parallelStream() 并行处理。但要留意线程安全问题。Set本身操作是安全的,但collect过程里记得选线程安全的collector。
- 导结果时别图省事用System.out.println逐行打印,改用 Files.write() 批量写入,性能能差出十倍以上。
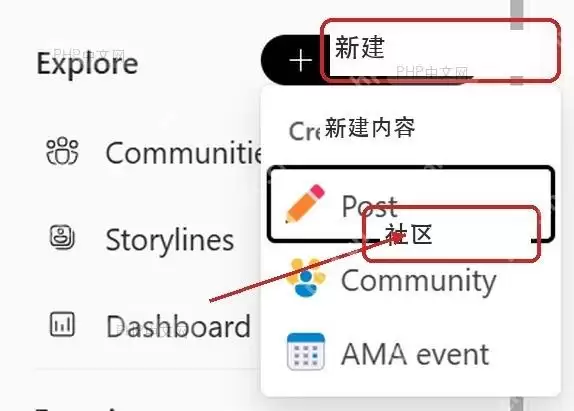
使用VivaEngage从单个试点社区起步,配置权限、成员与资源,设置业务和IT管理员分工。上线后重点监控加入、响应和文件访问,持续将群聊讨论收拢至社区沉淀知识,避免一次性建大量社区。

PHP、Unity3D和Workerman的综合应用:如何打造一个全新的社交网络随着互联网的普及和技术的不断进步,社交网络已经成为人们日常生活中不可或缺的一部分。无论是通过文字、图片、音频还是视频,我们都可以轻松地与朋友、家人和世界各地的人们进行交流和分享。本文将介绍如何利用PHP、Unity3D和Workerman这三个强大的工具来打造一个全新的社交网络平
如何用Go语言开发一个简单的社交网络应用引言社交网络已经成为人们日常生活中不可或缺的一部分。随着技术的发展,开发一个属于自己的社交网络应用已经变得越来越简单。本文将以Go语言为开发工具,介绍如何快速开发一个简单的社交网络应用。第一步:设计数据库模式在开始开发之前,我们需要设计数据库模式。一个典型的社交网络应用通常包含用户、好友关系、帖子等实体。可以使用关系数
从零开始的Java开发经验分享:构建社交网络应用随着互联网的快速发展和智能设备的普及,社交网络应用成为了人们生活中不可或缺的一部分。今天,我将和大家分享一下,如何从零开始使用Java开发构建一个社交网络应用的经验。一、确定需求和功能在开始开发之前,我们首先需要明确社交网络应用的需求和功能。社交网络应用通常包括用户注册登录、个人资料管理、好友关系建立和管理、消
Redis在社交网络中的应用探索Redis是一个高性能的键值存储数据库,广泛应用于Web应用、缓存、队列等场景。在社交网络中,Redis的应用场景也非常丰富,本文将通过具体的代码示例,探索Redis在社交网络中的应用。一、用户信息的存储在社交网络中,用户信息的存储是非常重要的。用户的个人信息、好友列表、关注列表、粉丝列表等等,都需要被存储起来。下面是一个用户
PHP中基于Elasticsearch的社交网络关系图搜索与分析随着互联网的迅速发展,社交网络已经成为人们生活中不可或缺的一部分。无论是Facebook、Twitter、Instagram还是微博、微信,人们都在这些平台上建立了广泛的社交网络。随着社交网络的扩大和用户数量的增加,人们对于社交网络的搜索和分析需求也越来越大。而Elasticsear
PHP学习笔记:社交网络与微博应用引言社交网络与微博应用在如今的互联网世界中已经变得非常普遍和流行。无论是个人用户还是企业机构,都可以利用这些应用来建立社交网络,分享信息和与其他用户进行交流。PHP作为一种常用的服务器端脚本语言,可以用于开发各种社交网络和微博应用。本文将介绍一些相关的概念和使用PHP开发社交网络和微博应用的示例代码。一、社交网络应用的实现用
如何使用MySQL和RubyonRails开发一个简单的社交网络功能在当今数字时代,社交网络已经成为人们生活的一部分。为了满足用户的需求,开发一个简单但功能齐全的社交网络应用是非常有必要的。本文将介绍如何使用MySQL和RubyonRails开发一个简单的社交网络应用,并提供具体的代码示例。环境准备在开始之前,确保你已经安装了MySQL和Rubyo


先看提示属于哪类:名称占用就加后缀,实名不一致就重填本人信息,证件不清晰就重拍。统一社会信用代码逐位核对,连续三次失败别改材料重投,直接联系客服人工核。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



