

进阶版Lightning Attention-2:无限序列长度、持续稳定计算力、增强建模精度
当前大语言模型的应用受到了序列长度限制的制约,这限制了其在人工智能领域中的应用。例如,在多轮对话、长文本理解和多模态数据处理与生成方面存在一定的挑战。造成这种限制的根本原因是目前大语言模型普遍采用的Transformer架构,其计算复杂度与序列长度呈二次关系。因此,随着序列长度的增加,计算资源的需求会呈几何倍数增长。因此,如何高效地处理长序列一直是大语言模型所面临的挑战之一。过去的方法主要集中在让大语言模型在推理阶段适应更长的序列。其中一种方法是采用Alibi或类似的相对位置编码,以使模型能够自适应不同长
当前大语言模型的应用受到了序列长度限制的制约,这限制了其在人工智能领域中的应用。例如,在多轮对话、长文本理解和多模态数据处理与生成方面存在一定的挑战。造成这种限制的根本原因是目前大语言模型普遍采用的Transformer架构,其计算复杂度与序列长度呈二次关系。因此,随着序列长度的增加,计算资源的需求会呈几何倍数增长。因此,如何高效地处理长序列一直是大语言模型所面临的挑战之一。
过去的方法主要集中在让大语言模型在推理阶段适应更长的序列。其中一种方法是采用Alibi或类似的相对位置编码,以使模型能够自适应不同长度的输入序列。另一种方法是使用RoPE或类似的相对位置编码进行差值,对已经训练完成的模型进行短暂的微调,以扩展序列长度。这些方法使得大模型具备了一定的长序列建模能力,但训练和推理的开销并未减少。
OpenNLPLab团队开源了一种名为Lightning Attention-2的新型线性注意力机制,旨在解决大语言模型长序列问题。这种机制使得训练和推理长序列与1K序列长度的成本保持一致,从而实现了一劳永逸的解决方案。即使在遇到显存瓶颈之前,增加序列长度也不会对模型训练速度产生负面影响,因此可以实现无限长度的预训练。此外,与1K Tokens相比,超长文本的推理成本也保持一致甚至更低,从而极大地降低了当前大语言模型的推理成本。如下图所示,当模型大小为400M、1B和3B时,随着序列长度的增加,FlashAttention2加持的LLaMA的训练速度开始快速下降,而Lightning Attention-2加持的TansNormerLLM的速度几乎没有变化。

图 1

- 论文:Lightning Attention-2: A Free Lunch for Handling Unlimited Sequence Lengths in Large Language Models
- 论文地址:https://arxiv.org/pdf/2401.04658.pdf
- 开源地址:https://github.com/OpenNLPLab/lightning-attention
Lightning Attention-2 简介
让大模型的预训练速度在不同序列长度下保持一致听起来是一个不可能的任务。然而,自从2020年线性注意力横空出世以来,研究人员一直在努力使线性注意力的实际效率符合其理论线性计算复杂度。在2023年中期之前,关于线性注意力的研究主要集中在与Transformer架构的精度对齐上。终于,在改进的线性注意力机制问世后,它在精度上能够与最先进的Transformer架构相媲美。 然而,线性注意力中最关键的“左乘变右乘”的计算trick在实际实现中远慢于直接左乘的算法。这是因为右乘的实现需要使用包含大量循环操作的累积求和(cumsum),而大量的I/O操作使得右乘的效率远低于左乘。 因此,要让大模型的预训练速度在不同序列长度下保持一致,仍然面临着挑战。研究人员需要进一步探索和改进线性注意力的实现方式,以提高其计算效率并减少I/O操作。这将有助于实现预训练速度的一致性,从而更好地应对不同序列长度的任务需求。

图 2
为了更好的理解 Lightning Attention-2 的思路,让我们先回顾下传统 softmax attention 的计算公式:O=softmax ((QK^T)⊙M_) V,其中 Q, K, V, M, O 分别为 query, key, value, mask 和输出矩阵,这里的 M 在单向任务(如 GPT)中是一个下三角的全 1 矩阵,在双向任务(如 Bert)中则可以忽略,即双向任务没有 mask 矩阵。
作者将 Lightning Attention-2 的整体思路总结为以下三点进行解释:
1. Linear Attention 的核心思想之一就是去除了计算成本高昂的 softmax 算子,使 Attention 的计算公式可以写为 O=((QK^T)⊙M_) V。但由于单向任务中 mask 矩阵 M 的存在,使得该形式依然只能进行左乘计算,从而不能获得 O (N) 的复杂度。但对于双向任务,由于没有没有 mask 矩阵,Linear Attention 的计算公式可以进一步简化为 O=(QK^T) V。Linear Attention 的精妙之处在于,仅仅利用简单的矩阵乘法结合律,其计算公式就可以进一步转化为:O=Q (K^T V),这种计算形式被称为右乘,相对应的前者为左乘。通过图 2 可以直观地理解到 Linear Attention 在双向任务中可以达到诱人的 O (N) 复杂度!
2. 但是随着 decoder-only 的 GPT 形式的模型逐渐成为 LLM 的事实标准,如何利用 Linear Attention 的右乘特性加速单向任务成为了亟待解决的难题。为了解决这个问题,本文作者提出了利用 “分而治之” 的思想,将注意力矩阵的计算分为对角阵和非对角阵两种形式,并采用不同的方式对他们进行计算。如图 3 所示,Linear Attention-2 利用计算机领域常用的 Tiling 思想,将 Q, K, V 矩阵分别切分为了相同数量的块 (blocks)。其中 block 自身(intra-block)的计算由于 mask 矩阵的存在,依然保留左乘计算的方式,具有 O (N^2) 的复杂度;而 block 之间(inter-block)的计算由于没有 mask 矩阵的存在,可以采用右乘计算方式,从而享受到 O (N) 的复杂度。两者分别计算完成后,可以直接相加得到对应第 i 块的 Linear Attention 输出 Oi。同时,通过 cumsum 对 KV 的状态进行累积以在下一个 block 的计算中使用。这样就得到了整个 Lightning Attention-2 的算法复杂度为 intra-block 的 O (N^2) 和 inter-block 的 O (N) 的 Trade-off。怎么取得更好的 Trade-off 则是由 Tiling 的 block size 决定的。
3. 细心的读者会发现,以上的过程只是 Lightning Attention-2 的算法部分,之所以取名 Lightning 是因为作者充分考虑了该算法过程在 GPU 硬件执行过程中的效率问题。受到 FlashAttention 系列工作的启发,实际在 GPU 上进行计算的时候,作者将切分后的 Q_i, K_i, V_i 张量从 GPU 内部速度更慢容量更大的 HBM 搬运到速度更快容量更小的 SRAM 上进行计算,从而减少大量的 memory IO 开销。当该 block 完成 Linear Attention 的计算之后,其输出结果 O_i 又会被搬回至 HBM。重复这个过程直到所有 block 被处理完毕即可。
想要了解更多细节的读者可以仔细阅读本文中的 Algorithm 1 和 Algorithm 2,以及论文中的详细推导过程。Algorithm 以及推导过程都对 Lightning Attention-2 的前向和反向过程进行了区分,可以帮助读者有更深入的理解。

图 3


Lightning Attention-2 精度对比
研究人员首先在小规模(400M)参数模型上对比了 Lightning Attention-2 与 Lightning Attention-1 的精度区别,如下图所示,二者几无差别。

随后研究人员在 1B、3B 上将 Lightning Attention-2 加持的 TransNormerLLM(TNL-LA2)与其它先进的非 Transformer 架构的网络以及 FlashAttention2 加持的 LLaMA 在相同的语料下做了对比。如下图所示,TNL-LA2 与 LLaMA 保持了相似的趋势,并且 loss 的表现更优。这个实验表明,Lightning Attention-2 在语言建模方面有着不逊于最先进的 Transformer 架构的精度表现。

在大语言模型任务中,研究人员对比了 TNL-LA2 15B 与 Pythia 在类似大小下的大模型常见 Benchmark 的结果。如下表所示,在吃掉了相同 tokens 的条件下,TNL-LA2 在常识推理和多项选择综合能力上均略高于基于 Softmax 的注意力的 Pythia 模型。

Lightning Attention-2 速度对比
研究人员对 Lightning Attention-2 与 FlashAttention2 进行了单模块速度与显存占用对比。如下图所示,相比于 Lightning Attention-1 和 FlashAttention2,在速度上,Lightning Attention-2 表现出了相比于序列长度的严格线性增长。在显存占用上,三者均显示出了类似的趋势,但 Lightning Attention-2 的显存占用更小。这个的原因是 FlashAttention2 和 Lightning Attention-1 的显存占用也是近似线性的。

笔者注意到,这篇文章主要关注点在解决线性注意力网络的训练速度上,并实现了任意长度的长序列与 1K 序列相似的训练速度。在推理速度上,并没有过多的介绍。这是因为线性注意力在推理的时候可以无损地转化为 RNN 模式,从而达到类似的效果,即推理单 token 的速度恒定。对于 Transformer 来说,当前 token 的推理速度与它之前的 token 数量相关。
笔者测试了 Lightning Attention-1 加持的 TransNormerLLM-7B 与常见的 7B 模型在推理速度上的对比。如下图所示,在近似参数大小下,Lightning Attention-1 的吞吐速度是百川的 4 倍,ChatGLM 的 3.5 倍以上,显示出了优异的推理速度优势。

小结
Lightning Attention-2 代表了线性注意力机制的重大进步,使其无论在精度还是速度上均可以完美的替换传统的 Softmax 注意力,为今后越来越大的模型提供了可持续扩展的能力,并提供了一条以更高效率处理无限长序列的途径。OpenNLPLab 团队在未来将研究基于线性注意力机制的序列并行算法,以解决当前遇到的显存屏障问题。

近日,有汽车领域博主爆料,特斯拉的FSD(完全自动驾驶)辅助系统将迎来一次重要升级,或将实现更真实的环境场景还原。在最新曝光的软件代码中,发现了大量新增的渲染模型,涵盖多种车辆与行人类型。这些新增模型包括救护车、消防车、垃圾清运车、校车、半挂式卡车、高尔夫球车、骑电动滑板车的行人、使用轮椅的行人、玩滑板的行人、推婴儿车的行人,以及道路清扫车、三轮车、拖车、火车和有轨电车等。这一系列高精度建模意味着FSD系统将能更准确识别并响应复杂交通参与者的行为。据CNMO掌握的消息,日本方面已为特斯拉FSD系统的落地扫
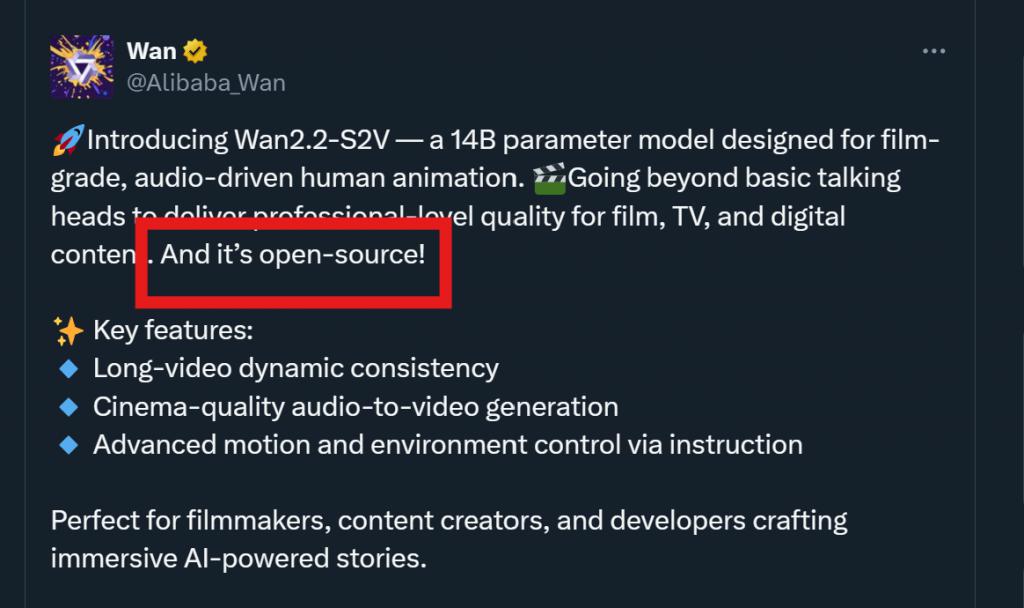
AI视频生成正迎来属于“通义”的高光时刻!就在昨晚,阿里巴巴悄然推出了一款由音频驱动的14B视频大模型——Wan2.2-S2V。只需上传一张静态图片和一段音频,就能生成出面部表情生动、口型精准匹配、肢体动作流畅自然的电影级数字人视频,效果惊艳。实际效果展示如下:△来自@AIMIRAI46487更令人振奋的是,这款新模型一经发布便全面开源,现在所有人都可以免费在通义万相官网体验使用。据官方介绍,Wan2.2-S2V的核心优势包括:支持最长分钟级的单次视频生成,画面稳定且具有一致性;具备影院级别的音

5月30日,华为推出了全新的AI模型——盘古UltraMoE,该模型的参数量达到了7180亿。作为一款接近万亿参数的MoE(MixtureofExperts)模型,它在整个训练过程中完全基于华为的昇腾AI平台完成,标志着华为在超大规模模型训练方面取得了重要进展。盘古UltraMoE的成功训练离不开盘古团队研发的一系列创新技术。例如,Depth-ScaledSandwich-Norm(DSSN)稳定架构的引入,显著改善了超大规模模型训练期间出现的梯度异常及

大语言模型面对加密数据,即便最新的Qwen3也会感到压力!尽管当下各类推理模型在多种基准测试中表现优异,但在密码学这样对逻辑严谨性和细节准确性要求极高的专业领域,模型的推理能力还有待深入挖掘。密码学不仅要求模型具备高级数学运算能力和严密的逻辑推理链,还需要其能够精准辨识复杂加密模式中的潜在规律;成功解密要求模型拥有极强的综合推理能力。上海AILab等联合推出的CipherBank测评,使用大量真实隐私场景数据和多种密码算法,严苛挑战当前最先进的大模型。CipherBank的测评结果显示,目前的大语言模型

现在,请大家一起来数一下"1"、"2"。OK,仅仅2秒的时间,一个接近万亿规模的MoE大模型就已经掌握了如何解答一道高等数学难题的方法!而且呢,这个大模型还是完全依靠国产设备进行训练的,整个流程都体现了浓浓的“国产”特色。这就是华为借助"昇腾+PanguUltraMoE"这一组合实现的成果——不仅达成了国产算力与国产模型在全流程上的自主可控训练闭环,还在集群训练系统的性能方面达到了行业顶尖水平。有多顶尖?来看一组数据:预训练阶段:昇腾Atlas800TA2万卡集群的MFU提升

只需动动嘴,就能操控GUI代理?由美团与浙江大学联合推出的GUIRoboTron-Speech——让你彻底解放双手,直接对设备“发号施令”。这是首个可以直接通过语音指令和屏幕截图进行端到端(End-to-End)决策的自主GUI智能体,致力于为用户提供更自然、高效且无障碍的人机交互方式。从文本到语音,智能代理的新一轮进化目前,基于大语言模型(LLMs)的自主GUI智能体已经能够通过文本指令自动完成跨应用、多步骤的复杂操作,显著提升用户效率。然而,这种依赖文本输入的方式在某些场景中存在明显局限

强化学习(RL)结合真实搜索引擎可以显著提升大模型的检索和推理能力。然而,这一方法面临两大挑战:搜索引擎返回的文档质量不稳定,导致训练过程中的噪音和不稳定性;RL训练需要频繁部署,产生大量API开销,限制了可扩展性。针对这些问题,阿里通义实验室推出了开源解决方案ZeroSearch,这是一个无需与真实搜索引擎交互的强化学习框架。实验表明,ZeroSearch只需使用3B参数的LLM作为检索模块,就能有效提升搜索能力,并大幅节省API成本。ZeroSearch让LLM实现自给自足


编辑:桃子【新智元导读】第二代Ameca升级亮相,搭载GPT-4技术,实现实时对话。人形机器人Ameca迎来了它的第二代版本!近期,在2024年世界移动通信大会(MWC)上,全球最先进的机器人Ameca再度亮相。Ameca在会场周围吸引了大量观众。通过GPT-4的增强,Ameca能够即时回应各种问题。「展示一段舞蹈吧」。当被问及是否有情感时,Ameca通过一系列逼真的面部表情作出回应。就在几天前,开发Ameca的英国机器人公司EngineeredArts展示了他们团队的最新成果。视频中,Ameca具备了






Windows 10 是一款微软推出的经典操作系统,拥有硬件兼容性与多任务处理能力。它更偏向把系统状态查看和常用调节动作放在一起,适合需要持续观察和微调设备状态的场景。

极度公式是一款跨平台专业LaTeX公式识别编辑软件,支持OCR公式识别和多平台编辑。和使用说明,避免使用,享受完整功能与稳定支持。做扫描整理、文字提取和表格转换时,它能把识别后的处理步骤接得更顺,资料录入这类场景会省下不少时间。
