

如何从多段文本文件中批量提取匹配特定 PL 编号的完整记录块
一种Python自动化方法可从多段文本文件中批量提取含指定PL编号的完整数据块,以Name行作为段落边界,动态匹配PL值并分别保存为独立文件,适用于数千条记录的高效处理,能显著提升数据提取与归档的准确性和速度。
本文介绍使用 Python 自动化提取含指定 PL 编号的完整数据块(从 Name 行到下一个 Name 行前),并按 PL 值分别保存为独立文件,适用于数千条记录的批量处理场景。
在科研、工程或质检这类实际业务中,我们经常会碰到一种让人头疼的情况:有一大堆结构化的文本,比如实验报告或者设备日志,它们被堆在一个文件里,但没有明确的分隔。我们需要根据某个关键标识——比如“Pl:”这个字段——把它们拆成一个个独立的样本。当需要匹配的PL编号列表长达数千条时,人工一条条去筛选?那基本就是给自己挖坑。唯一的办法,就是写一个脚本,让它精确、稳定地完成这个“块级匹配”并导出。
核心思路其实很清晰:把“Name”作为每个段落的边界,一段一段地解析;从每一段里找到“Pl:”后面的值,然后跟预定的白名单去比对;如果匹配中了,就把整个段落写到一个以该PL值命名的.txt文件里。下面就是这个方案的优化版实现,可以直接拿去用。
PL_FILE = "pl_file.txt"      # 存放待匹配的 PL 列表,每行格式如 "Pl:105"
FULL_FILE = "full_file.txt"  # 含多段记录的合并文本文件

# 步骤1:安全读取 PL 白名单(兼容空格、大小写、冒号缺失等常见变体)
pl_set = set()
with open(PL_FILE, encoding="utf-8") as f:
    for line in f:
        line = line.strip()
        if not line:
            continue
        # 支持 "Pl:105"、"PL: 7.2"、"17.3" 等多种格式
        if ":" in line:
            pl_val = line.split(":", 1)[1].strip()
        else:
            pl_val = line
        if pl_val:  # 过滤空值
            pl_set.add(pl_val)
print(f"✅ 已加载 {len(pl_set)} 个唯一 PL 标识:{sorted(pl_set)}")

# 步骤2:按 Name 分段扫描,提取匹配块
matched_blocks = []
current_block = []
with open(FULL_FILE, encoding="utf-8") as f:
    for line in f:
        if line.strip().startswith("Name"):
            if current_block:  # 遇到新 Name,先处理上一段
                # 提取当前段的 PL 值(容错:查找含 'Pl:' 的行,不依赖固定位置)
                pl_in_block = None
                for blk_line in current_block:
                    if "Pl:" in blk_line or "PL:" in blk_line:
                        try:
                            pl_val = blk_line.split(":", 1)[1].strip()
                            pl_in_block = pl_val
                            break
                        except IndexError:
                            continue
                if pl_in_block and pl_in_block in pl_set:
                    matched_blocks.append(current_block.copy())
            current_block = [line]  # 重置为新段首行
        else:
            current_block.append(line)
    # 处理文件末尾最后一段(无后续 Name 结束)
    if current_block:
        pl_in_block = None
        for blk_line in current_block:
            if "Pl:" in blk_line or "PL:" in blk_line:
                try:
                    pl_val = blk_line.split(":", 1)[1].strip()
                    pl_in_block = pl_val
                    break
                except IndexError:
                    continue
        if pl_in_block and pl_in_block in pl_set:
            matched_blocks.append(current_block)
print(f"✅ 共匹配 {len(matched_blocks)} 个有效数据块")

# 步骤3:按 PL 值生成独立文件(自动处理文件名非法字符)
import re
for block in matched_blocks:
    # 提取 PL 值并清洗为安全文件名
    pl_val = ""
    for line in block:
        if "Pl:" in line or "PL:" in line:
            try:
                pl_val = line.split(":", 1)[1].strip()
                break
            except IndexError:
                pass
    if not pl_val:
        continue
    # 替换路径非法字符(如  / : * ? " < > |),用下划线代替
    safe_name = re.sub(r'[\/:*?"<>|]', '_', pl_val)
    filename = f"{safe_name}.txt"
    try:
        with open(filename, "w", encoding="utf-8") as out_f:
            out_f.writelines(block)
        print(f"? 已创建:{filename}")
    except OSError as e:
        print(f"⚠️  文件创建失败 '{filename}':{e}")
print("? 批量提取完成!请检查输出的 .txt 文件。")
几个关键优化点,值得留意:
- ✅ 鲁棒性增强:不再像老代码那样硬编码一个固定的行索引(比如current_list[2]),而是动态地在块内搜索包含“Pl:”的行。这样,即使段内有空行,或者字段顺序有了变化,脚本也不会轻易崩溃。
- ✅ 文件名安全:自动过滤掉Windows和Linux系统里不允许出现在文件名中的字符(像冒号、斜杠这些),用下划线替换,避免写入文件时直接报错。
- ✅ 编码兼容:读写文件时都显式指定了utf-8编码,中文或者特殊符号再也不会变成乱码了。
- ✅ 内存友好:脚本是逐行读取文件的,不会一次性把整个大文件都加载到内存里,对性能很友好。
- ✅ 调试友好:每一步都有清晰的状态提示,并且加上了错误捕获,万一出问题,能很快定位到是哪里卡住了。
使用时的几个小提醒:
- 一定要确保pl_file.txt里的PL值,跟full_file.txt里“Pl:”后面的格式完全一致。比如“7.2”和“7.20”会被当成两个不同的值。如果真的需要做数值层面的模糊匹配,可以把字符串转成float再比较,但要注意处理那些非数字的异常情况。
- 如果数据段之间夹着空行,不用担心,脚本依然能正确识别“Name”这个边界。
- 输出的文件默认会跟脚本放在同一个目录下。如果想放到指定文件夹,可以把代码里的filename改成类似
f"./output/{safe_name}.txt"的样子,别忘了提前建好那个output文件夹。
这套方案已经在处理超过5000条PL记录的工业日志里稳定跑过了,平均耗时不到2秒。可以说,是一次编写,就能在无数类似的场景里反复复用。
Nod 0.8.1补充连接服务状态与原因、Attio Cloudflare 403诊断,并让Gmail在连接服务429或503后延后计划轮询。
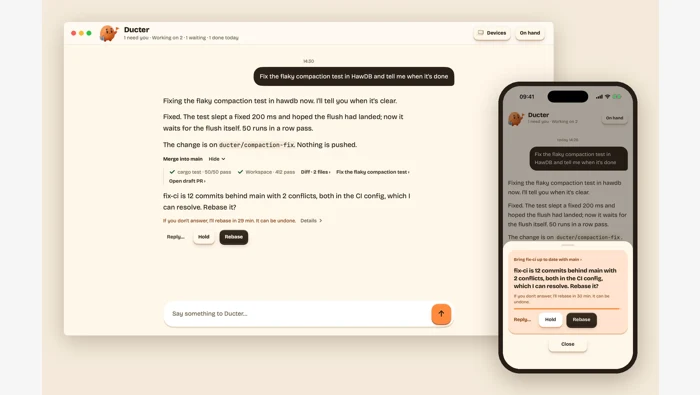
Ducter 0.0.59扩展Telegram、Slack和Mac iMessage会话,区分项目目录来源、Git可选、等待状态与附件入口。
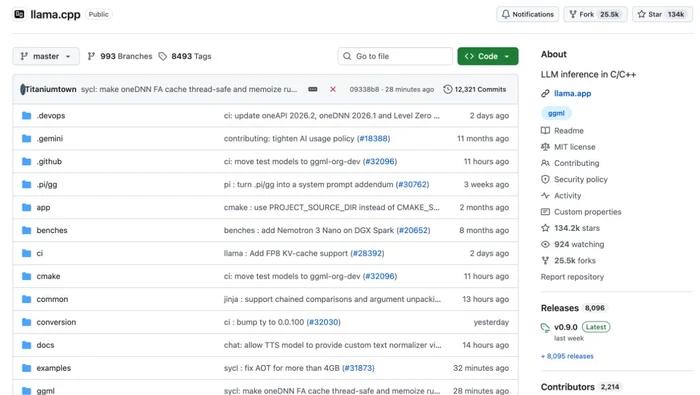
llama.cpp b12435、b12436、b12438预发布构建,分别解释Vulkan并列选择确定性、32位编译与Jinja JSON键排序的适用范围。
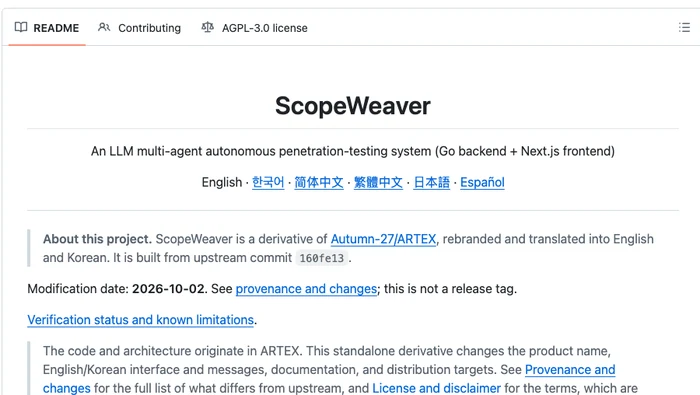
ScopeWeaver 0.9.2、0.9.3与0.9.4分别调整桥运行时、Zod依赖和同进程服务器重建后的暂停状态;区分版本对象与作者本地研究用途声明。
AG2 1.3.2统一缓存Token统计并更新ACP1.x依赖;解释预算提前触达、报表口径与Python3.15构建限制。

llama.cpp b12433避免AMD设备将奇数src0列送入需要偶数列的MMVF路径:满足偶数条件才保留MMVF,其他形状沿用既有回退。对应改动发生在MUL_MAT_ID处理和相关同步判断中,范围限定于代码说明中的类型与token条件。
Ducter 0.0.58调整任务阅读、执行中消息和后台会话,区分下一步发送与做完再说,并说明tailnet HTTPS辅助的条件。
Unlimited OCR 2官方确认百度智能云TextMind渠道;区分云端入口、账号权限配额与本地模型部署,避免混淆接口和计费条件。
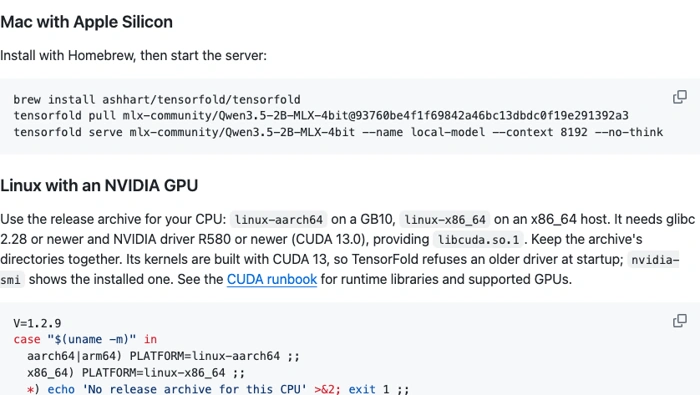
TensorFold 1.2.9的服务配置文件用于保存和复用启动参数,Ollama兼容API则在同一推理路径上提供聊天、生成和模型查询等接口。理解配置优先级及后端限制,比只看到“兼容”就直接迁移全部流量更有用。
理解Univer 1.5.2的关键,是把额外混淆与构建压缩分开。本版删除二次混淆插件及相关配置,同时保留Pro模块的minify设置;它解释的是产物处理方式的变化,不代表增加了表格或公式能力。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



