

ElasticSearch使用CompositeAggregation实现桶的分页查询功能
ElasticSearch的CompositeAggregation利用游标机制和after参数实现桶的批量分页查询,通过指定每页桶数并传递上一页的after_key逐步获取后续数据,避免了传统偏移量分页的性能问题,适用于海量数据分组后的高效分页。
官方文档
https://www.elastic.co/guide/en/elasticsearch/reference/current/search-aggregations-bucket-composite-aggregation.html#_pagination
概述
先聊点实在的:当我们需要分页查询大量桶(bucket)的时候,composite 聚合是当前最优雅的解法。它允许我们通过分页的方式,逐步把桶结果“挤”出来,而不是一口气把所有数据全部砸给你——这在数据量大的场景下简直是救命稻草。
注意,它和传统分页的思路完全不同。传统玩法依赖偏移量(offset)来控制页码,而 composite aggregation 使用的是游标机制。简单说,它不跟你纠结“从第几条开始”,而是直接告诉你“从上一个桶之后接着拿”。这就从根本上绕过了经典分页的性能瓶颈,越往后翻数据效率越稳。
Composite Aggregation 概览
说白了,composite aggregation 是 ES 专门为分页展示聚合结果设计的一种玩法。你去翻翻看,传统的聚合方式大多是一次性返回所有数据,但 composite 不一样——它通过 after 参数来标注“分页锚点”,而不是依赖 from 和 size 来硬算偏移量。这种基于游标的分页模型,在处理大量数据时优势非常明显。
实战:基本的分页查询
假设你有一个索引叫 your_index_name,里面每篇文档都有一个字段 your_field_name。现在你要按这个字段分组,并且每次只取 10 个聚合结果来看。看看下面这个基础查询:
GET /your_index_name/_search{ "size": 0, "aggs": { "my_composite_agg": { "composite": { "size": 10, "sources": [ { "my_terms_agg": { "terms": { "field": "your_field_name" } } } ] } } }}几个要点值得细说一下:
size: 0:我们只关心聚合结果,不想要原始文档内容。这能省下不少传输开销。composite聚合:这是分页的关键构造,它会按你指定的聚合规则返回一个分页桶结果集。size: 10:控制每页返回多少桶,相当于传统分页里的“每页条数”。sources:定义分组逻辑的地方。上面这个例子就是用terms按字段值分组。
翻页:获取下一页
分页的核心在于,你得告诉 ES:“我已经看到这个位置了,接下来从这儿往后翻。” 这个“位置”就是上一页返回的最后一个桶的 key 值,用法是通过 after 参数传进去。
来看第二页怎么查:
GET /your_index_name/_search{ "size": 0, "aggs": { "my_composite_agg": { "composite": { "size": 10, "after": ["bucket_key_from_first_page"], "sources": [ { "my_terms_agg": { "terms": { "field": "your_field_name" } } } ] } } }}这个小细节很关键:
after参数的值就是上一页返回结果中的after_key。你可以在查询响应的聚合信息里直接找到它。
举个例子,假设第一次查询的返回结果长这样:
{ "aggregations": { "my_composite_agg": { "buckets": [ { "key": { "your_field_name": "value1" }, "doc_count": 10 }, { "key": { "your_field_name": "value2" }, "doc_count": 15 } ], "after_key": { "your_field_name": "value2" } } }}那么第二页查询时,你就把 after 设为 { "your_field_name": "value2" },ES 就知道从这儿接着往下查了。
官方案例
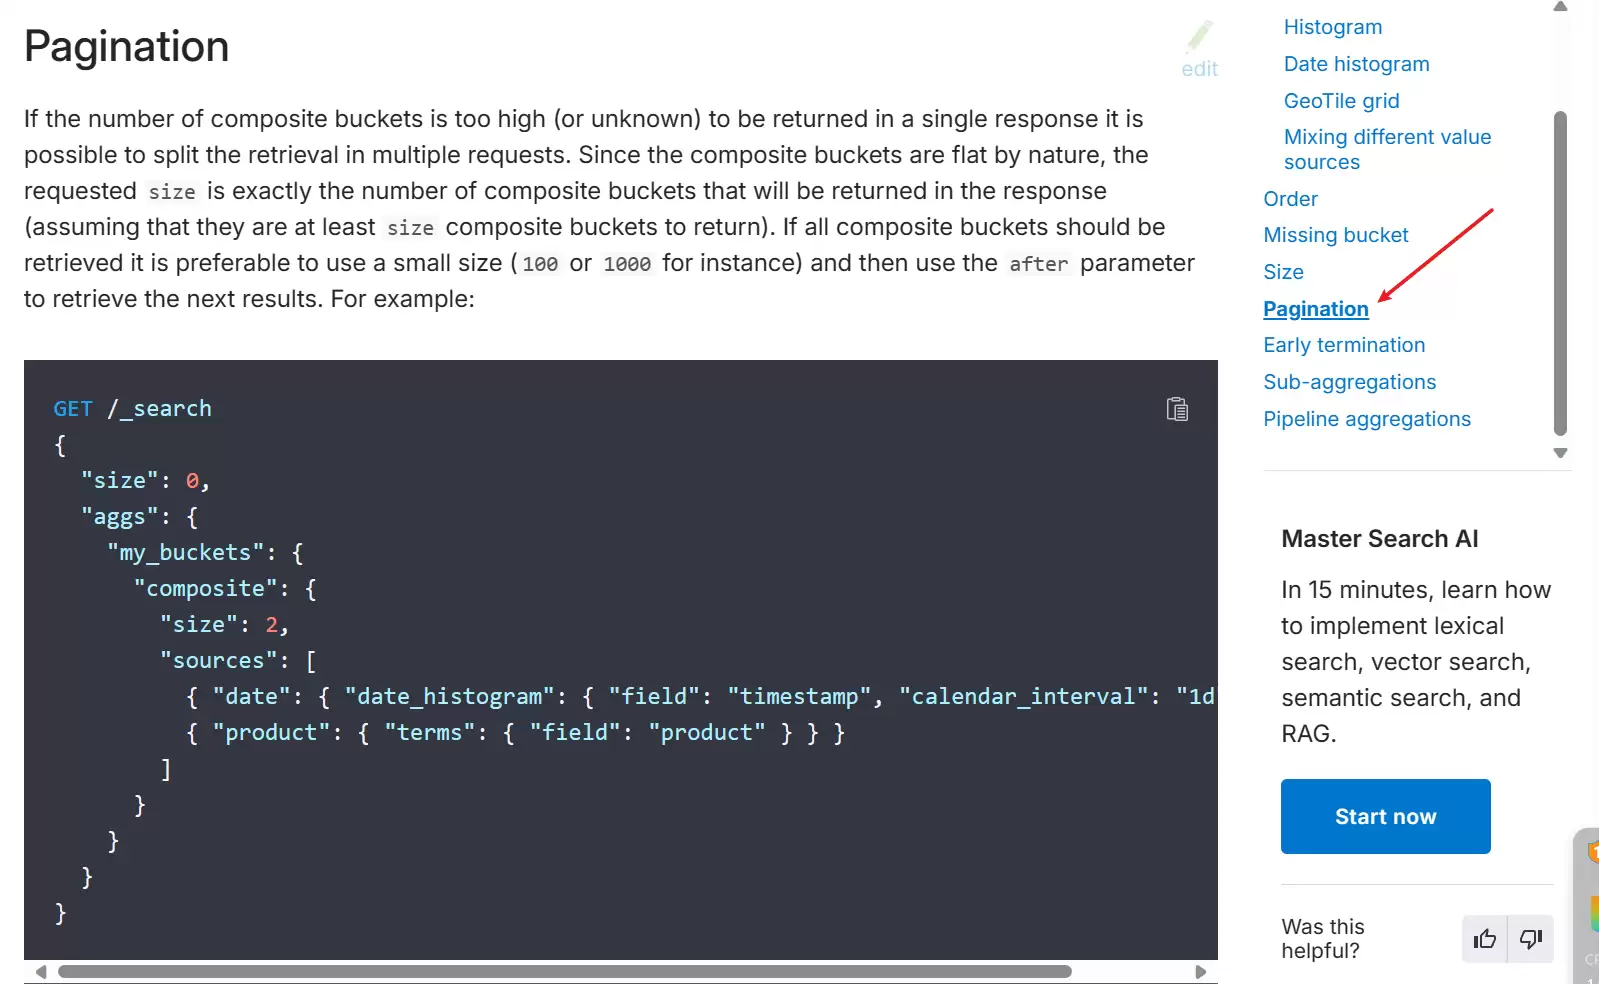
GET /_search{ "size": 0, "aggs": { "my_buckets": { "composite": { "size": 2, "sources": [ { "date": { "date_histogram": { "field": "timestamp", "calendar_interval": "1d" } } }, { "product": { "terms": { "field": "product" } } } ] } } }}返回结果:
{ "aggregations": { "my_buckets": { "after_key": { "date": 1494288000000, "product": "mad max" }, "buckets": [ { "key": { "date": 1494201600000, "product": "rocky" }, "doc_count": 1 }, { "key": { "date": 1494288000000, "product": "mad max" }, "doc_count": 2 } ] } }}下次查询直接带着 after 走起:
GET /_search{ "size": 0, "aggs": { "my_buckets": { "composite": { "size": 2, "sources": [ { "date": { "date_histogram": { "field": "timestamp", "calendar_interval": "1d", "order": "desc" } } }, { "product": { "terms": { "field": "product", "order": "asc" } } } ], "after": { "date": 1494288000000, "product": "mad max" } } } }}什么场景最适用?
说白了,composite aggregation 的强项就是解决下面这几类痛点:
- 海量数据分页:桶的数量越多,传统偏移量方案越吃力。用
composite可以彻底绕开这类性能陷阱。 - 按字段分组后的分页展示:如果你的场景是先分组、再翻页,那它就是最趁手的工具。
- 防止数据丢或重:传统分页如果遇上数据变动,容易导致翻页时出现数据丢失或重复。而
composite aggregation的游标机制天然免疫这类问题。
几点需要特别注意
after参数的类型必须和sources中定义的字段类型保持一致。字符串字段就传字符串,数值字段就传数值,类型对不上可是会报错的。- 分页顺序依赖于聚合字段的排序规则。如果数据分布不够均匀,每一页返回的桶数可能会略有波动,这点在初始化设计时需要心里有数。
- 虽然
size可以控制每页桶数,但composite aggregation单次最多只能返回 10,000 个桶。如果你覆盖的数据范围超出了这个上限,就需要考虑数据分片或其他优化策略了。
篇幅有限,我们就说到这儿。记住一点:掌握好 composite aggregation,你就能轻松应对大规模桶数据的高效分页查询。


先看提示属于哪类:名称占用就加后缀,实名不一致就重填本人信息,证件不清晰就重拍。统一社会信用代码逐位核对,连续三次失败别改材料重投,直接联系客服人工核。


0.170.0 的语音更新限于终端通话协商能力的明确新增,同名工具服务器跨环境支持仍标注实验性质;连接部分则修复大请求回退、认证竞态和云端重连等具体问题。这份正式版公告不足以证明所有账户、所有客户端都已具备完整语音功能。


OpenAI Python SDK 3.55.0 升级看点:Live MCP 服务配置与预算接口变化。说明已核实的更新范围、类型兼容性和本地版本确认方法。

OpenAI Java SDK 4.108.0 面向 Live MCP 工具接入与 Managed Agents 预算状态处理,说明新增模型、事件含义、正式发布范围和适用限制。

Free Claude Code 6.19.37 在自动搜索时保留客户端工具及选择条件,代理执行搜索后仍返回普通调用。说明适用场景、历史信息保留、请求约束与第三方项目的版本边界。

Google GenAI Go SDK 1.78.0 将 Gemini Developer API 默认改为 v1,可用 HTTPOptions.APIVersion 或环境变量保留 v1beta,Vertex AI 默认值不变。






火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



