

Go内存分配器深度透析:从mcache到mheap的对象分配全路径
一、分配器的隐藏成本:为什么一次 malloc 的代价远超你的想象 Go 程序的内存分配,走的可不是系统 libc 的 malloc,而是一套自研的分配器——TCMalloc 变体。它的设计目标很明确:在高并发场景下,让分配操作尽可能无锁,最好就在 L1/L2 Cache 内完成。但别误会,了解这套
一、分配器的隐藏成本:为什么一次 malloc 的代价远超你的想象
Go 程序的内存分配,走的可不是系统 libc 的 malloc,而是一套自研的分配器——TCMalloc 变体。它的设计目标很明确:在高并发场景下,让分配操作尽可能无锁,最好就在 L1/L2 Cache 内完成。但别误会,了解这套机制不是为了炫技,而是为了解决一个很实际的问题——为什么两个功能完全一样、只是内存分配模式不同的程序,在 CPU 密集型场景下,性能竟然能差出 3 到 8 倍?
答案就藏在分配路径里。Go 分配器对三种大小对象采用了完全不同的处理路径:微小对象(小于 16B)走无锁的 per-P mcache 缓存;小对象(16B-32KB)按 Size Class 分级分配,还有概率触发 GC;大对象(大于 32KB)则直接走 mheap 向操作系统申请。如果在热路径里频繁分配 33KB 的对象——刚好超过小对象上限——每次都会跨越 mheap 的全局锁。在高并发下,这个锁的竞争能让 16 核 CPU 的有效利用率降到 40% 以下。
flowchart TD
    A[新对象分配请求] --> B{对象大小判断}
    B -->|"≤ 32KB(小对象)"| C[查找 Size Class]
    B -->|"> 32KB(大对象)"| L["直接走 mheap
mmap/madvise 系统调用"]
    C --> C1["Tiny Allocator
(< 16B, 非指针)"]
    C --> C2["固定 Size Class
(16B-32KB)"]
    C1 --> C1A["mcache.tiny + tinyoffset
(P 本地缓存,无锁)"]
    C1A --> D{本地缓存有空闲?}
    C2 --> C2A["mcache.alloc[sizeclass]
(P 本地缓存,无锁)"]
    C2A --> D
    D -->|是| E["直接分配
(< 5ns, 纯内存操作)"]
    D -->|否| F["mcentral.cacheSpan
(全局中心缓存,可能加锁)"]
    F --> G{mcentral 有空闲 p?}
    G -->|是| H["转移 p 到 mcache
(批量补充)"]
    G -->|否| I["mheap_.alloc
(页分配器,全局锁)"]
    I --> J["pageAlloc.alloc
(基数树查找空闲页)"]
    J --> K["调用 mmap 扩展堆
(系统调用,~1μs)"]
    L --> I
    H --> E
    K --> E
二、三级缓存架构:mcache → mcentral → mheap
2.1 mcache:P 本地的零锁分配缓存
先看第一级:mcache。每个 P 都有一个专属的 mcache 结构体,这是分配器的第一级缓存,也是性能关键路径上的核心。从 mcache 中分配对象完全无锁——因为每个 P 同一时刻只执行一个 goroutine,不存在竞争。
// mcache 的核心数据结构(runtime/mcache.go 简化)
type mcache struct {
    // 微小对象分配器
    tiny       uintptr  // 当前 tiny 块的起始地址
    tinyoffset uintptr  // 当前 tiny 块内的偏移
    // 每个 Size Class 对应一个 mp 链表
    // alloc[0] 对应 8B, alloc[1] 对应 16B, ... , alloc[66] 对应 32768B
    // 一共 67 个 Size Class
    alloc [numSpanClasses]*mp
    // 本地统计:用于判断是否需要触发 GC
    local_scan  uintptr
    local_nsmall uintptr
}
Tiny Allocator 是 Go 1.4 引入的优化,专门处理小于 16 字节且不包含指针的单体对象。它的思路很简单:把多个微小对象合并到同一个 16 字节块中,避免每个小对象都独立分配一个 mp,就像拼车一样节省空间和开销。
// Tiny Allocator 的分配逻辑:将多个微小对象拼放到同一块内存中
// 原理:如果分配 4 字节的 int32, 正常 Size Class 会分配 8 字节(向上取整)
// Tiny Allocator 找到一块已在使用的 16 字节内存,将 4 字节插入其中
// 节省了空间的浪费和分配开销
2.2 mcentral:Size Class 级别的全局缓存
当 mcache 中某个 Size Class 的本地缓存用完了,就会转向 mcentral 申请补充。mcentral 维护该 Size Class 的两个链表——nonempty(有剩余空间的 p)和 empty(已满的 p)。
// mcentral 的结构(runtime/mcentral.go 简化)
type mcentral struct {
    pclass pClass       // 对应的 p 类型
    partial [2]pSet        // 部分空闲的 p
    full    [2]pSet        // 已满的 p
}
// 从 mcentral 获取 p 的逻辑:
// 1. 优先从 nonempty 表取
// 2. 如果 nonempty 为空,从 empty 表找一个已满 p,标记为 nonempty
// 3. 如果 empty 也为空,向 mheap 申请新 p
从 mcentral 到 mcache 的转移是批量进行的:一次性将整个 p(通常是 8KB 的页的倍数)从 mcentral 转移到 mcache,然后 mcache 从中逐块分配。
2.3 mheap:向操作系统的最终入口
mheap 是分配器的最后一级——当 mcentral 也无法提供空闲 p 时,mheap 通过页分配器向操作系统申请内存。Go 1.16 之后的页分配器使用基数树(Radix Tree)而非 bitmap 来跟踪页的分配状态,将查询复杂度从 O(n) 降低到 O(log n)。
// 页分配器核心结构(runtime/mpagealloc.go 简化)
type pageAlloc struct {
    // 基数树:每个节点代表 8KB * 64 = 512KB 的地址空间
    // 三层结构覆盖 2^48 字节的完整 64 位地址空间
    chunks [1 << 20]*pallocData  // 每个 chunk 4MB
}
// 大对象分配路径(>32KB → 直接 mheap)
func (h *mheap) allocLarge(npages uintptr) *mp {
    // 1. 在基数树中查找连续的 npages 个空闲页
    // 2. 标记这些页为已分配
    // 3. 如果堆空间不足,调用 sysAlloc (mmap) 扩展堆
    // 4. 返回新创建的 p
}
mheap 的锁争用,可以说是 Go 内存分配器最大的性能瓶颈。高并发下,多个 P 同时向 mheap 申请内存,都会在 mheap_.lock 上排队。这才是为什么“避免大对象频繁分配”对 Go 程序性能至关重要的底层原因。
三、逃逸分析对分配路径的决定性影响
逃逸分析是 Go 编译器在编译时做的一项决定性优化。它判断一个变量是否“逃逸”出了当前函数的栈帧。如果未逃逸,变量分配在 goroutine 的栈上(约 2ns,纯栈指针移动);如果逃逸,变量分配在堆上(走 mcache → mcentral → mheap 路径,约 20ns-1μs)。
一个常见的“性能事故”是意外的逃逸。举个例子,在一个循环中向 []interface{} 追加 int——int 会被隐式装箱为 interface{} 类型,接口值的指针部分会逃逸到堆上,导致每次循环迭代都触发堆分配。
// ❌ 意外逃逸:[]interface{} 导致 int 装箱,每次循环堆分配
func sumAsInterface(nums []int) int {
    var result int
    var temp []interface{}
    for _, n := range nums {
        temp = append(temp, n) // n 装箱为 interface{} → 堆分配
        result += n
    }
    return result
}
// ✅ 无逃逸:直接操作 int,全部在栈上
func sumDirect(nums []int) int {
    var result int
    for _, n := range nums {
        result += n // 纯栈操作,无分配
    }
    return result
}
使用 go build -gcflags="-m" 可以查看编译器的逃逸分析报告。在性能敏感代码的 Code Review 中,检查逃逸分析输出应该成为标准步骤。
四、针对分配器的性能优化策略
理解了分配路径,就能总结出三条核心优化策略。
减少堆分配次数:预分配 slice 的容量(make([]T, 0, expectedSize))、使用 sync.Pool 复用频繁分配的对象、避免在循环中拼接字符串(用 strings.Builder 预分配 buffer)。
控制对象大小在 Size Class 边界内:Go 的 Size Class 并非连续。如果对象尺寸从 1025 字节增加到 2049 字节,它就跨越了一个 Size Class 边界,分配的 p 尺寸可能从 1024 跳到 1280(增长 25%),导致内存利用率下降。
最小化大对象分配:大于 32KB 的对象直接走 mheap,每次分配都会触发全局锁竞争。对于确需处理大数据块的场景(如文件读写),使用 []byte 的复用缓冲池,而非每次都分配新的。
五、总结
总结一下。Go 内存分配器的三级缓存架构(mcache → mcentral → mheap),在 mcache 命中时可以做到约 5ns 的零锁分配,这是 Go 在高并发场景下的核心竞争力之一。但一旦分配路径穿透到 mcentral 或 mheap,延迟就飙升到 50ns-1μs,还可能触发全局锁竞争。
性能优化的核心原则,就是让分配路径尽可能停留在 mcache 层:减少堆分配次数(预分配、sync.Pool)、避免意外逃逸(检查 -gcflags="-m" 输出)、控制对象大小在合适的 Size Class 区间内。在 Code Review 中,不妨把“这个分配是否会到达 mheap”作为评估代码性能影响的一个维度。
rust-analyzer v0.3.3121 稳定版修复大 u128 转为负浮点数的问题,并为 target_os 与 target_env 补齐 macOS、iOS、Android 和 musl 相关候选。
llama.cpp b12464 为 OpenCL A7 增加 Q8_0 非 MoE 二进制内核,解释 Adreno X1、矩阵乘法和适用条件。
llama.cpp b12463 修正 Muse Glimmer 视觉编码器缩放位置嵌入时的坐标顺序,使其与训练一致,解释非方形图像为何更能体现差异。
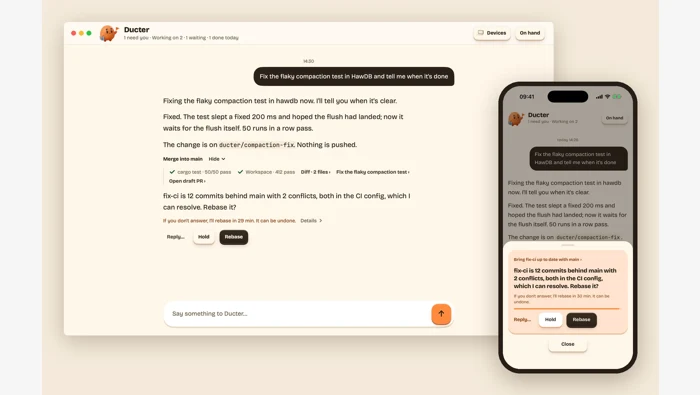
Ducter 0.0.67 区分运行中引导与当前一轮后的补充消息,同时把其他代理记录的读取交给用户主动触发。两项变化分别影响任务执行时机和背景信息来源。
llama.cpp b12441、b12442、b12448、b12449、b12451、b12452、b12453、b12455、b12456 均为预发布,涉及后端、聊天模板、设备参数、界面与音频,按场景对应各构建。
ChatGPT for Academic Researchers 的五万份资助面向下一轮合格申请,全计划二十万人是长期覆盖目标。试点调查另有独立样本与证据口径。
llama.cpp b12457 为 OpenCL 的 A7 路径增加 Q4_K 非 MoE 二进制内核,说明后端、量化及模型执行路径的适用范围。
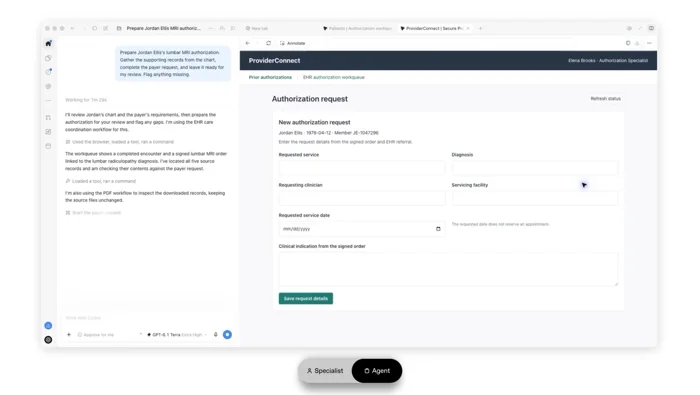
ChatGPT for Healthcare 将代理、搜索和医疗插件放在同一产品体系中。开通资格与组织设置决定成员能看到哪些工具。
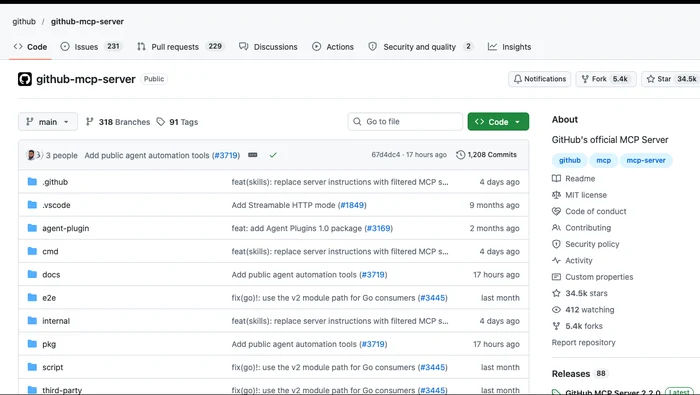
GitHub MCP Server v2.2.0 提供可选的过滤技能目录、代理自动化工具和秘密扫描告警隐藏参数。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



