

测试面试必备之JMeter的正则表达式实例详解
JMeter正则表达式是从服务器响应中提取动态数据的文本匹配工具,用于接口与性能测试中的关联。通过正则表达式提取器配置引用名称、正则表达式、模板、匹配数字和缺省值,可实现单个或多值提取。语法基于Perl风格,支持元字符、捕获组及非贪婪匹配、断言等高级技巧。
聊到JMeter正则表达式,这里有个关键点必须搞清楚:它本质上是帮我们从服务器响应里“捞”数据的工具。不管你是做接口测试还是性能测试,总会遇到上个请求的回包内容要往下个请求传的场景——这时候就得靠正则表达式来精准定位、提取那些动态数据了。
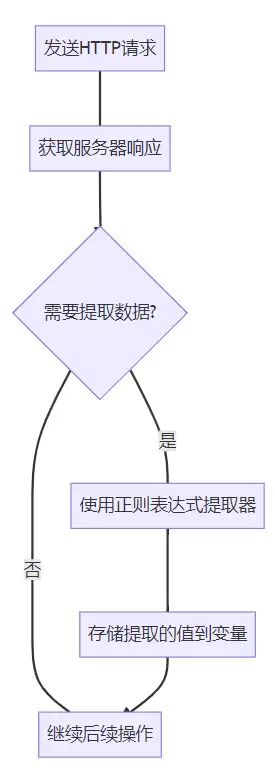
什么是JMeter正则表达式
简单说,JMeter里的正则表达式就是一种文本匹配机制,用来从服务器返回的响应中定位并捕获特定字符串。你定义好一个搜索模式,它就去响应里找匹配的内容。这项能力在关联测试中尤其关键——很多动态数据的提取,都离不了它。
正则表达式提取器基础
在JMeter里添加正则表达式提取器,操作路径如下:
- 右键点击HTTP请求
- 选择“添加” → “后置处理器” → “正则表达式提取器”
主要配置字段
| 字段名 | 说明 |
|---|---|
| 引用名称 | 存储提取结果的变量名 |
| 正则表达式 | 用于匹配文本的模式 |
| 模板 | 指定使用哪个捕获组($1$表示第一个组) |
| 匹配数字 | 0表示随机,1表示第一个匹配,-1表示所有匹配 |
| 缺省值 | 匹配失败时的默认值 |
JMeter正则表达式语法
JMeter底层用的是Jakarta ORO正则表达式库,语法上和Perl兼容,所以如果你写过Perl风格的正则,上手会非常快。
常用元字符
.匹配任意单个字符\d匹配数字\w匹配字母、数字或下划线\s匹配空白字符*匹配前一个元素0次或多次+匹配前一个元素1次或多次?匹配前一个元素0次或1次{n}匹配前一个元素恰好n次
捕获组
圆括号()是用来创建捕获组的,这样才能把匹配到的特定部分单独提取出来:
// Ja va代码示例:演示正则表达式捕获组
import ja va.util.regex.*;
public class RegexExample {
    public static void main(String[] args) {
        String text = "Order ID: 12345, Date: 2023-05-20";
        Pattern pattern = Pattern.compile("Order ID: (\\d+), Date: (\\d{4}-\\d{2}-\\d{2})");
        Matcher matcher = pattern.matcher(text);
        if (matcher.find()) {
            System.out.println("Order ID: " + matcher.group(1));
            System.out.println("Date: " + matcher.group(2));
        }
    }
}
JMeter正则表达式示例
示例1:提取单个值
假设响应是这样的:,我们想拿到那个token值。
flowchart TD
    A[响应文本] --> B[正则表达式提取器]
    B --> C[正则表达式: name="csrfToken" value="(.+?)"]
    C --> D[模板: $1$]
    D --> E[变量: csrfToken=a1b2c3d4e5]
配置参数如下:
- 引用名称:
csrfToken - 正则表达式:
name="csrfToken" value="(.+?)" - 模板:
$1$ - 匹配数字:
1 - 缺省值:
NOT_FOUND
示例2:提取多个值
这次响应是JSON格式:{"users":[{"id":101,"name":"Alice"},{"id":102,"name":"Bob"}]},想把所有用户ID都提取出来。
// Ja va代码示例:提取JSON中的多个用户ID
import ja va.util.regex.*;
public class MultiValueExample {
    public static void main(String[] args) {
        String json = "{\"users\":[{\"id\":101,\"name\":\"Alice\"},{\"id\":102,\"name\":\"Bob\"}]}";
        Pattern pattern = Pattern.compile("\"id\":(\\d+)");
        Matcher matcher = pattern.matcher(json);
        int count = 0;
        while (matcher.find()) {
            System.out.println("User " + (++count) + " ID: " + matcher.group(1));
        }
    }
}
JMeter里对应的配置:
- 引用名称:
userId - 正则表达式:
"id":(\\d+) - 模板:
$1$ - 匹配数字:
-1(提取所有匹配项) - 缺省值:
NOT_FOUND
后续使用时可以通过userId_1、userId_2这样的变量名访问每个值。
高级技巧
非贪婪匹配
这一点在实际工作中经常踩坑。默认情况下,量词(如*、+)是贪婪的,会尽可能多地匹配字符。加个?能让它变“懒”:
- 贪婪:
a.*b在 “aabab” 中匹配的是 “aabab” - 非贪婪:
a.*?b在 “aabab” 中会匹配出 “aab” 和 “ab”
断言和前后查找
- 正向前查找:
(?=pattern) - 负向前查找:
(?!pattern) - 正向后查找:
(?<=pattern) - 负向后查找:
(?
举个例子,如果只想提取price后面的数值,而不把price本身带出来,可以这么写:
(?<=price":)\d+
常见问题解决
匹配不到数据:先确认响应里确实有你想要的内容,再检查正则中的特殊字符有没有正确转义。实在不行就写个简单表达式先测一步,逐步缩小范围。
提取了错误数据:说明你的正则写得不够“严谨”。可以增加上下文约束,使用非贪婪匹配,或者加上边界条件让匹配更精确。
性能问题:正则太复杂了就跑得慢。对于大体积响应,建议加一些边界限制来缩小搜索范围。
最佳实践
- 动手写正则之前,务必先看一眼响应数据长什么样
- 正则表达式越具体越好,模糊匹配容易翻车
- 如果响应是HTML或XML,XPath或CSS选择器可能是更好的选择
- 加个调试采样器,把提取到的变量值打印出来,方便排查问题
- 变量名起得有含义一点,别用a、b、c这种
- 缺省值一定要填,否则测试会因为一次提取失败就崩掉
掌握JMeter正则表达式之后,处理动态内容就不再是难题了,测试计划的灵活性和可维护性都会上一个台阶。
Nod 0.8.1补充连接服务状态与原因、Attio Cloudflare 403诊断,并让Gmail在连接服务429或503后延后计划轮询。
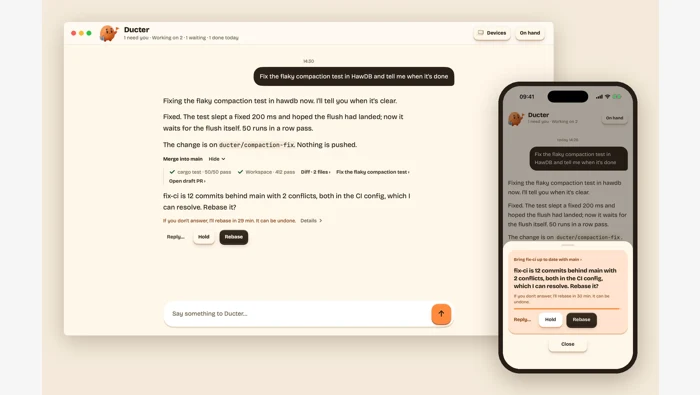
Ducter 0.0.59扩展Telegram、Slack和Mac iMessage会话,区分项目目录来源、Git可选、等待状态与附件入口。
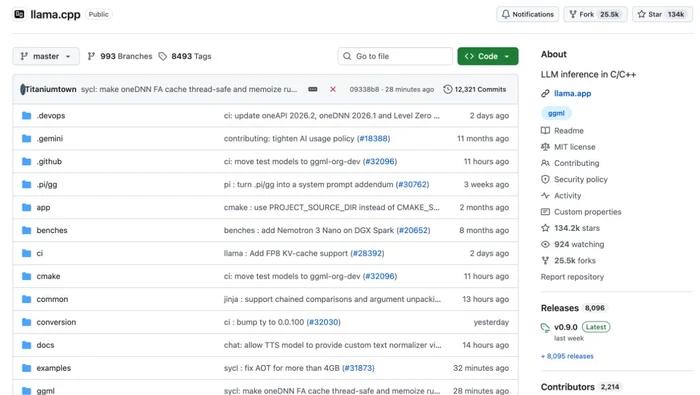
llama.cpp b12435、b12436、b12438预发布构建,分别解释Vulkan并列选择确定性、32位编译与Jinja JSON键排序的适用范围。
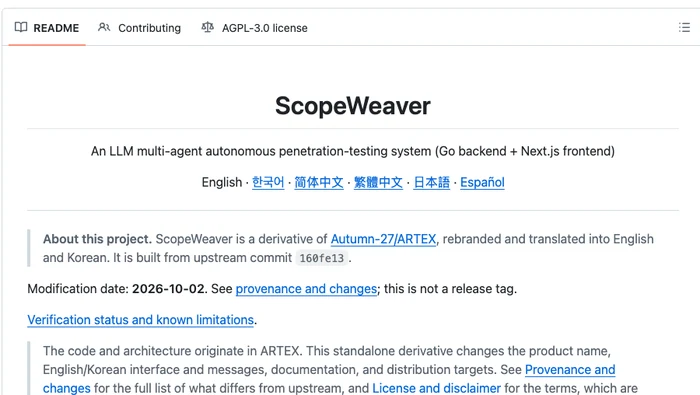
ScopeWeaver 0.9.2、0.9.3与0.9.4分别调整桥运行时、Zod依赖和同进程服务器重建后的暂停状态;区分版本对象与作者本地研究用途声明。
AG2 1.3.2统一缓存Token统计并更新ACP1.x依赖;解释预算提前触达、报表口径与Python3.15构建限制。

llama.cpp b12433避免AMD设备将奇数src0列送入需要偶数列的MMVF路径:满足偶数条件才保留MMVF,其他形状沿用既有回退。对应改动发生在MUL_MAT_ID处理和相关同步判断中,范围限定于代码说明中的类型与token条件。
Ducter 0.0.58调整任务阅读、执行中消息和后台会话,区分下一步发送与做完再说,并说明tailnet HTTPS辅助的条件。
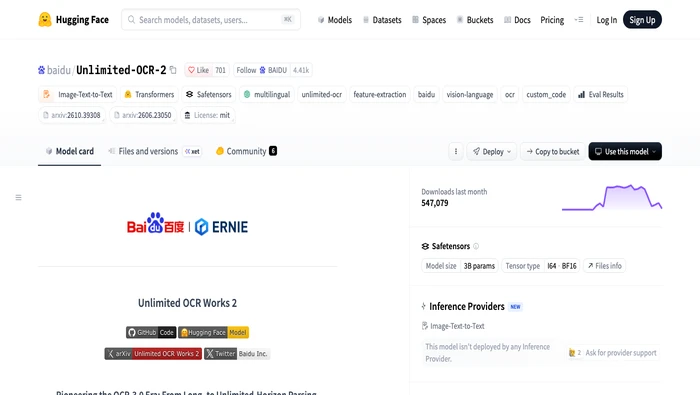
Unlimited OCR 2官方确认百度智能云TextMind渠道;区分云端入口、账号权限配额与本地模型部署,避免混淆接口和计费条件。
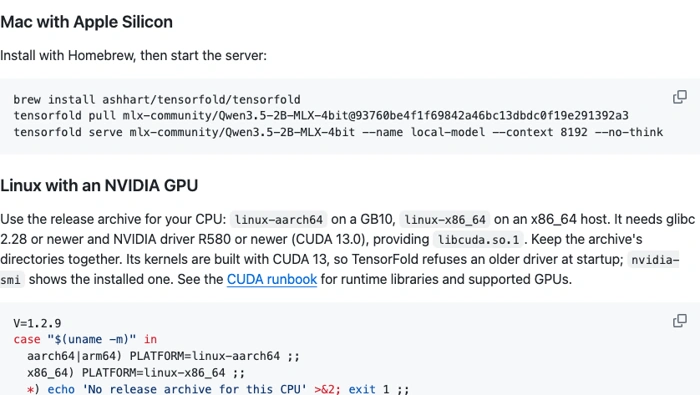
TensorFold 1.2.9的服务配置文件用于保存和复用启动参数,Ollama兼容API则在同一推理路径上提供聊天、生成和模型查询等接口。理解配置优先级及后端限制,比只看到“兼容”就直接迁移全部流量更有用。
理解Univer 1.5.2的关键,是把额外混淆与构建压缩分开。本版删除二次混淆插件及相关配置,同时保留Pro模块的minify设置;它解释的是产物处理方式的变化,不代表增加了表格或公式能力。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



