

我们用小米大模型做了个 3D 世界杯网站,没想到 46 秒就搞定了
“MiMo-V2.5-Pro-UltraSpeed 的推理速度世界第一。” 15分35秒 vs 46.3秒。同一个3D世界杯虚拟乐园任务,MiMo-V2.5-Pro-UltraSpeed比标准版模型快了整整20倍。 让MiMo-V2.5-Pro和UltraSpeed同时生成一个包含3D球场、48支球
“MiMo-V2.5-Pro-UltraSpeed 的推理速度世界第一。”
15分35秒 vs 46.3秒。同一个3D世界杯虚拟乐园任务,MiMo-V2.5-Pro-UltraSpeed比标准版模型快了整整20倍。
让MiMo-V2.5-Pro和UltraSpeed同时生成一个包含3D球场、48支球队展馆、支持拖拽缩放点击的3D世界杯虚拟乐园。两者都交付了可运行的页面,但等待时长截然不同。当模型把万亿参数推理从分钟级压缩到秒级,大模型产品会发生什么变化?
这也引出了一个更值得追问的问题:同样是万亿参数级模型,同样面对一个长代码生成任务,为什么一个像“慢速外包”,一个却更接近“实时搭档”?答案并不只是“模型更快”这么简单。
公开信息显示,MiMo-V2.5-Pro-UltraSpeed的底层模型来自MiMo-V2.5-Pro-FP4-DFlash,其模型规模达到1.02T总参数、42B激活参数,并支持1M上下文。通过模型与系统协同设计,它可以在单个标准8卡通用GPU节点上,将生成速度推过1000 tokens/s,峰值约1200 tokens/s。
过去,大模型通常需要在能力、上下文和速度之间做取舍:模型越大,推理越慢;上下文越长,延迟越高;Agent步骤越多,用户等待越久。UltraSpeed要挑战的,正是这个长期存在的不可能三角关系。
01
从3D世界杯实测切入:同一道题,等待体验相差一个数量级
为了验证MiMo-V2.5-Pro-UltraSpeed的速度提升到底有多明显,在MiMo正式分别调用了MiMo-V2.5-Pro和MiMo-V2.5-Pro-UltraSpeed,用同一个任务做了对比测试。
请生成一个3D世界杯虚拟乐园,3D球场,48支球队的3D展馆,运动风格,3D,可以点击互动,单文件。记住,给我一个3D的html文件。
这个任务要求模型在单个HTML文件里完成3D场景、世界杯主题、48支球队展馆、交互点击、运动风格视觉设计等多重约束,换句话说,它既考验长代码生成能力,也考验模型在复杂需求下的结构组织能力。这类任务也正是Coding Agent中最典型的token密集型场景:输出长、结构强、格式复杂,而且一旦生成速度慢,用户的等待感会被迅速放大。此外,也容易因为极小的错误导致bug,进一步引发更长的修改周期和用户等待时间。
一起来看看两个模型的表现:
俯视图:两个MiMo模型都完成了“单文件3D世界杯虚拟乐园”的基本命题,但取向明显不同。
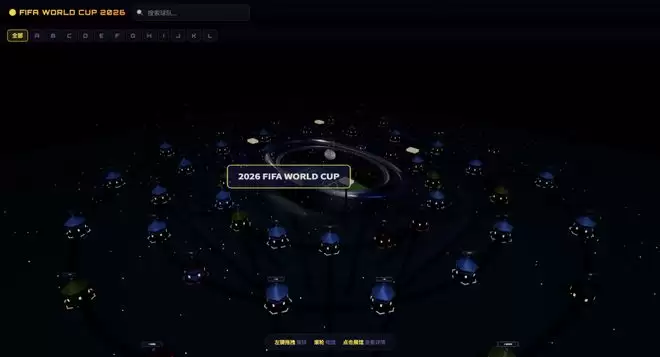
MiMo-V2.5-Pro构建的3D世界杯虚拟乐园俯视图
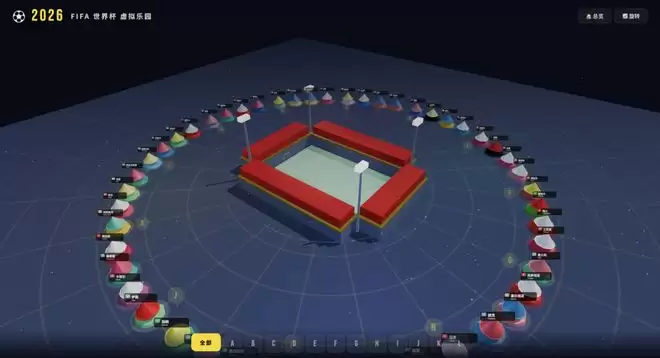
MiMo-V2.5-Pro-UltraSpeed构建的3D世界杯虚拟乐园俯视图
左侧MiMo-V2.5-Pro生成的页面更偏“氛围型”:整体采用暗色星空背景,中央球场和环形展馆被放置在类似夜间宇宙舞台的场景中,视觉重心集中在中央的“2026 FIFA WORLD CUP”标识,页面顶部提供搜索框和分组筛选,底部也给出了拖拽旋转、滚轮缩放、点击展馆查看详情等交互提示。整体沉浸感较强,夜景、星点、环形布局和发光元素共同构成了一个完整的3D展示空间;但部分展馆和文字标签较小,整体可读性偏弱,页面信息组织仅完成概念演示。
相比之下,MiMo-V2.5-Pro-UltraSpeed生成的结果更偏“产品型”:它同样生成了中心球场、环形球队展馆、顶部标题栏、右上角功能按钮以及底部字母筛选栏,画面更明亮,布局也更规整。48支球队展馆被更清晰地排列在球场外围,球队标签、分组筛选和场景结构的可辨识度更高,用户能更快理解页面的功能逻辑。尤其值得注意的是,UltraSpeed并没有因为生成速度更快而牺牲页面完整性:球场、展馆、标签、筛选入口和基础交互框架都被保留下来。
用户交互:两个模型都补上了拖拽旋转、滚轮缩放、点击展馆查看详情等基础操作。
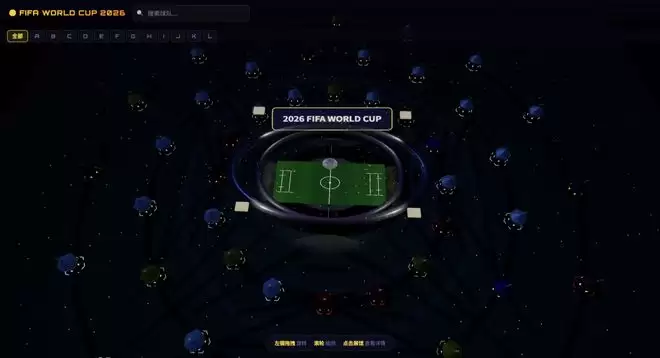
MiMo-V2.5-Pro构建的3D世界杯虚拟乐园缩小和拖拽视图
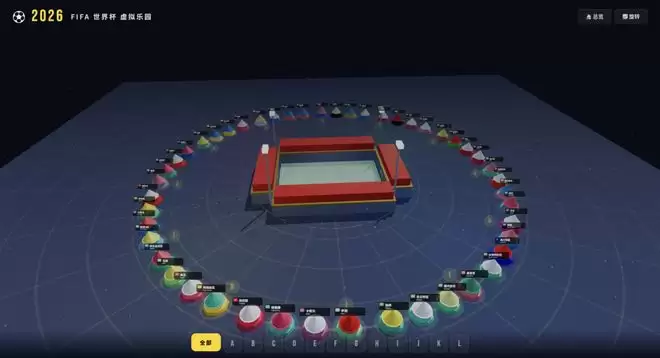
MiMo-V2.5-Pro-UltraSpeed构建的3D世界杯虚拟乐园缩小和拖拽视图
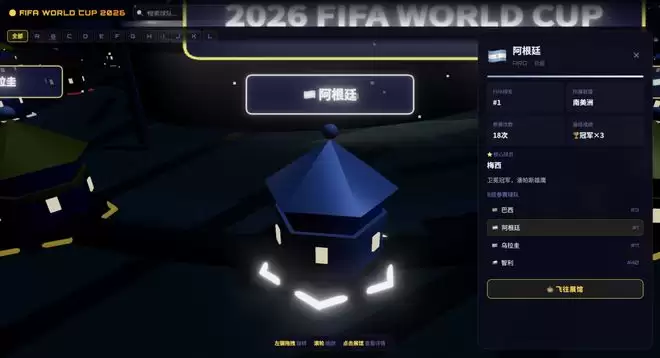
MiMo-V2.5-Pro构建的3D世界杯虚拟乐园局部放大视图
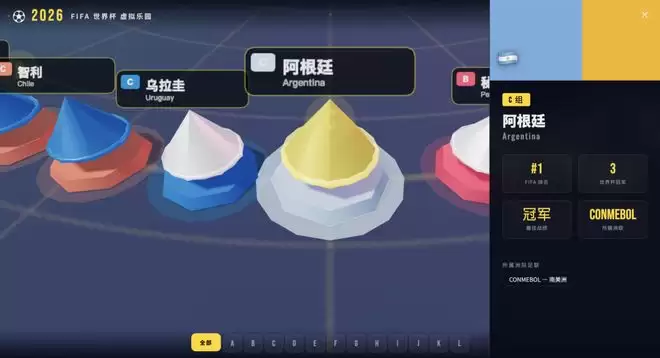
MiMo-V2.5-Pro-UltraSpeed构建的3D世界杯虚拟乐园局部放大视图
用户在MiMo-V2.5-Pro生成的页面中拖拽后可以切换到更近的球场视角,中央球场、环形轨道和球队展馆的空间关系保持稳定;点击阿根廷展馆后会自动放大到展馆视角,同时右侧会弹出较完整的球队信息面板,包括FIFA排名、所属联盟、参赛次数、最佳成绩、核心球员和同组球队等内容,整体更偏沉浸式导览体验。
MiMo-V2.5-Pro-UltraSpeed同样支持旋转、缩放和点击展馆,视角切换后画面更明亮,球队标签和展馆排列更清晰;点击阿根廷后,同样以该展馆为试图中心拉近视野,并在右侧弹出详情面板,展示排名、冠军数、最佳战绩和所属洲联等核心信息。相比Pro版本,UltraSpeed的交互氛围略弱一些,但信息组织更规整,可读性更好。
整体来看,两个模型都一次性完成了这道长代码生成任务,并交付了可拖拽、可缩放、可点击的3D演示页面。差异更多体现在呈现取向上:Pro版本更突出虚拟乐园的沉浸感和氛围营造,UltraSpeed则更强调页面结构、信息可读性和交互效率。考虑到二者本质上是同源模型,最终产出质量接近并不意外。真正值得观察的,是它们在完成同一任务时,生成过程到底有多快。
UltraSpeed以压倒性的速度完成任务
接下来再看token开支和“干活速度”,UltraSpeed的优势就更直观了。
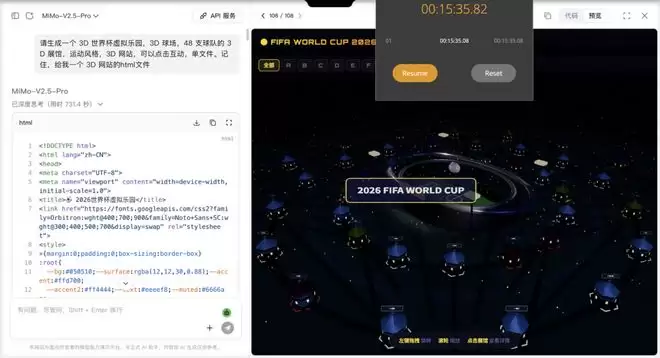
MiMo-V2.5-Pro思考耗时731.4秒

MiMo-V2.5-Pro-UltraSpeed思考耗时33.1秒,整个工作耗时46.3秒,使用35827 tokens
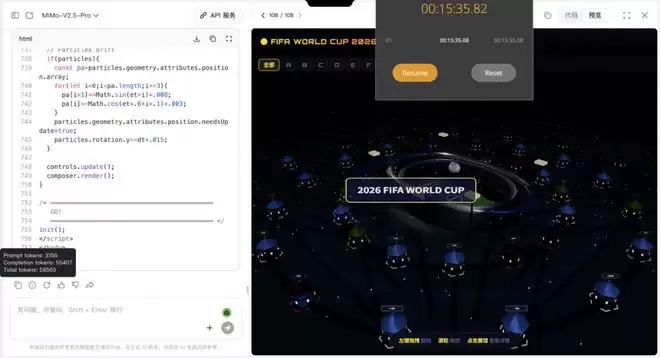
MiMo-V2.5-Pro完成整个工作耗时约15分35秒,58563 tokens
MiMo-V2.5-Pro花费58563个tokens生成了页面,其中思考阶段耗时731.4秒,最终大约经过15分35秒(935秒),生成了759行代码。整个过程像一次重型推理和长时间代码生成:模型先花了较长时间规划,再逐步输出完整HTML、CSS和Ja vaScript。
MiMo-V2.5-Pro-UltraSpeed的表现则明显不同,花费35827个tokens生成了829行代码,代码行数更多;同时,思考阶段仅用33.1秒,平均速度达到581 tokens/s,生成阶段耗时13.2秒,平均输出速度达到980 tokens/s。也就是说,在产出规模不低于Pro版本的情况下,UltraSpeed用更少的token开支和更短的等待时间,完成了同一类复杂前端任务。
两个MiMo模型的对比最能说明UltraSpeed的定位:它不是简单把回答“压短”来换速度,而是在长代码任务中显著压缩了推理和生成链路。对用户来说,Pro版本是“等一杯咖啡”的节奏,UltraSpeed更接近“眨几次眼,代码已经铺开”。对于需要反复生成、运行、修改的Coding Agent场景,这种速度差距会直接改变开发体验。
UltraSpeed的速度表现,基本把“高速版”的定位打到了明面上。
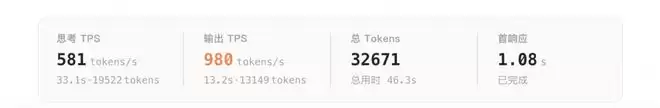
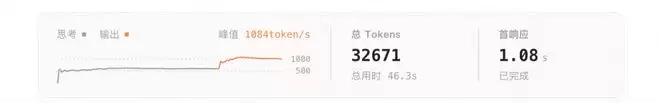
从统计看,UltraSpeed在排除prompt的3156 token后,完成任务的32671 tokens总用时46.3秒,首响应仅1.08秒。其中,思考阶段耗时33.1秒,处理了19522 tokens,平均速度达到581 tokens/s;进入正式输出阶段后,模型在13.2秒内生成13149 tokens,平均输出速度达到980 tokens/s,峰值更是冲到1084 tokens/s。更关键的是,它并不是通过减少内容来换速度:最终代码规模超过800行,页面也保留了球场、展馆、标签、筛选、点击详情和视角控制等关键模块。对于长代码生成来说,这种体验已经不只是“快”,而是把等待从分钟级压缩到了秒级。
功能优化测试:从新增场馆到保留风格的两次Debug
结合实际场景,开发需求往往在第一次开发后还需要进一步修改和打磨,接下来对UltraSpeed的Debug能力展开测试。
先让模型在上述3D世界杯虚拟乐园中添加“世界杯历史馆”和“美加墨2026世界杯对战馆”。
请在主场馆旁边分别添加“世界杯历史馆”和“美加墨2026世界杯对战馆”,在世界杯历史馆中梳理一个完整的世界杯历史比较记录,在对战馆中展示赛程表等
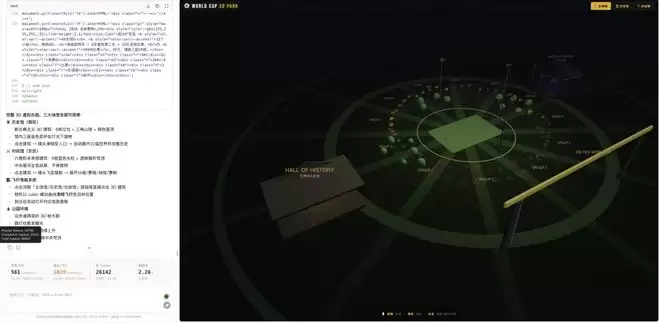
UltraSpeed经过33.6秒完成修改,增加了世界杯历史馆和对战馆,但风格完全不一样了。
UltraSpeed在3D世界杯乐园中新增了“世界杯历史馆”和“2026对战馆”,页面顶部也同步加入了“主场馆/历史馆/对战馆”的导航按钮。历史馆被设计成带有“HALL OF HISTORY”标识的博物馆式建筑,对战馆则采用蓝色透明的未来感结构,并补充了世界杯历史梳理、2026赛制、分组、赛程和城市等内容。这轮任务总计34765 tokens、输出26142 tokens,总用时约33.6秒,平均输出速度达到1029 tokens/s,说明它在长代码修改任务中依然能保持很高吞吐。不过,这一版虽然完成了“新增场馆”的功能目标,但整体更像重新组织了一版功能更丰富的新页面,并没有延续第一版网页的视觉风格和交互语言。
因此,又进行了第二轮Debug,将第一版源码重新提供给模型,并明确要求“在保留这个代码风格的前提下”增加历史馆和赛程中心馆:
[源码] 请在保留这个代码风格的前提下,增加世界杯历史馆和2026赛程中心馆
UltraSpeed第二次Debug,51.6秒交付风格一致的新需求版本。
这次,UltraSpeed没有再重新组织一套全新的页面,而是在原有3D世界杯虚拟乐园的视觉体系中,继续加入“世界杯历史馆”和“2026赛程中心”:中央球场、环形48支球队展馆、底部分组筛选、顶部功能按钮和整体明亮的运动风格都被保留下来。新增历史馆采用金色穹顶、金色立柱和奖杯造型,与原页面的世界杯主题保持一致;赛程中心则以蓝绿色几何建筑呈现,旁边保留了球队展馆的环形排布和标签系统。
内容层面,模型补充了22届世界杯历史统计、四大传奇纪录、1930—2024年完整赛事表格,以及48队、12组、104场、39天、16座主办城市、赛制说明和小组对阵等赛程信息。这一轮任务的上下文和输出规模更大,总tokens达到105568,输出45077 tokens,更多的token花费在带有源码的输入60491个,但总用时仍只有51.6秒,平均输出速度达到1134 tokens/s。更关键的是,这次修改不只是“加了功能”,而是开始符合真实开发中的要求:在理解已有代码和既定风格的基础上,完成局部扩展和Debug。
这是UltraSpeed在Coding Agent场景中的核心价值,模型不是每次都能一次性完美命中需求,但当每一轮反馈、修改和再生成都能在几十秒内完成时,开发者就可以更自然地进入连续协作节奏。
换句话说,UltraSpeed的意义不只是“一次生成快”,而是让生成—发现问题—补充约束—再次修改这一循环变得足够轻。
02
为什么UltraSpeed能这么快?
要理解这个速度差距,需要回到UltraSpeed的底层设计。
公开信息显示,UltraSpeed的底层模型是MiMo-V2.5-Pro-FP4-DFlash。它不是简单把模型砍小,而是在1.02T总参数、42B激活参数、1M上下文的基础上,通过FP4混合量化、DFlash块级投机解码和TileRT系统级优化,把万亿参数模型的推理链路重新拆了一遍。
简单说:
FP4让每一步读得少,DFlash让总步数跑得少,TileRT让GPU闲得少。
FP4:只压缩最该压缩的Experts
在万亿参数模型上,显存带宽是推理速度的核心瓶颈。MiMo没有把全模型粗暴压到4-bit,而是选择性量化:1) 只对MoE的Experts做MXFP4(Microscaling FP4)量化;2) 注意力投影(包括o_proj)和其他关键模块保持更高精度;3) 通过FP4 QAT(Quantization-Aware Training)在训练阶段就适配低精度表示。
这个策略很直接:MoE模型的大部分参数集中在Experts,而每次推理只激活其中一部分。压缩Experts,能显著降低显存和带宽压力;保留注意力等敏感模块,则尽量避免能力坍塌。
在Hugging Face发布的模型卡显示,MXFP4相比FP8在多项benchmark上并没有带来明显的能力断崖:
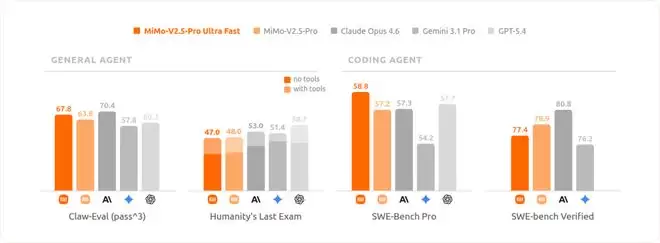
在通用Agent场景中,MiMo-V2.5-Pro UltraSpeed (Ultra Fast) 在Claw-Eval (pass^3) 上拿到67.8,高于原版MiMo-V2.5-Pro的63.8;在Humanity's Last Exam上为47.0,与原版48.0基本持平。到了Coding Agent场景,UltraSpeed (Ultra Fast) 在SWE-Bench Pro上达到58.8,略高于原版的57.2;在SWE-bench Verified上为77.4,低于原版78.9,但差距不大。
这说明MiMo的MXFP4路线不是简单牺牲精度换速度,而是在MoE架构上做“定点减重”:压缩参数量最大的Experts,同时保留注意力等关键路径的高精度,由此在降低显存和带宽压力的同时,将能力损失控制在较小范围内,也为后续DFlash投机解码和TileRT系统优化打下基础。
DFlash:一次猜一块,而不是一个token一个token猜
MXFP4解决的是“每一步太重”,DFlash解决的是“步数太多”。
传统自回归生成需要逐token推理。输出1000个token,理论上就要走约1000步。DFlash采用块级并行投机解码:一个5层轻量draft模型一次预测一个token block,再由MiMo主干模型统一验证。
具体地,DFlash的块 (block size) 设为8,其drafter不再逐token自回归生成,而是通过一次前向计算,直接填充整个被掩蔽的token块 (masked block);随后,MiMo主干模型会一次性验证多个token,通过验证的token被保留,未通过的部分则从对应位置重新生成。
根据最新的Acceptance Length,在WebDev (Coding) 测试中,每轮8个draft token中平均有6.30个被接受。这意味着主干模型不必每个token都亲自生成,前向计算次数被大幅压缩。
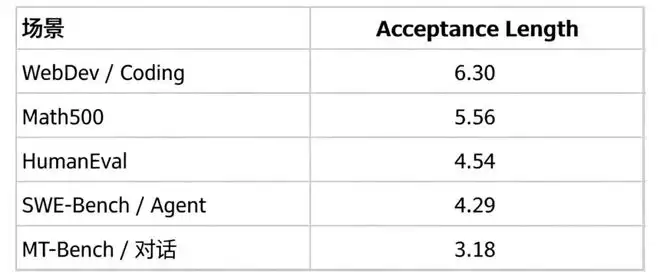
此外,速度也和任务类型有关,Coding场景明显高于开放对话场景,说明UltraSpeed在代码生成、结构化输出、Agent任务中更容易发挥优势。
TileRT:把理论加速跑到真实GPU上
有了FP4和DFlash,并不等于速度一定能跑出来。1T MoE模型部署在8卡GPU节点上,还会遇到kernel启动、跨卡通信、数据搬运、expert路由和流水线调度等系统瓶颈。
TileRT解决的是这部分“最后一公里”。
TileRT的优化主要集中在系统执行层面:一方面,它通过常驻内核减少计算内核反复启动带来的开销;另一方面,通过计算与数据搬运重叠,尽量压缩GPU等待数据的时间。同时,TileRT还会针对MXFP4 Expert计算、DFlash草稿生成、主干模型验证等不同阶段设计异构流水线,并配套定制编译引擎与计算核,以适配MXFP4量化和DFlash投机解码带来的动态执行特征。
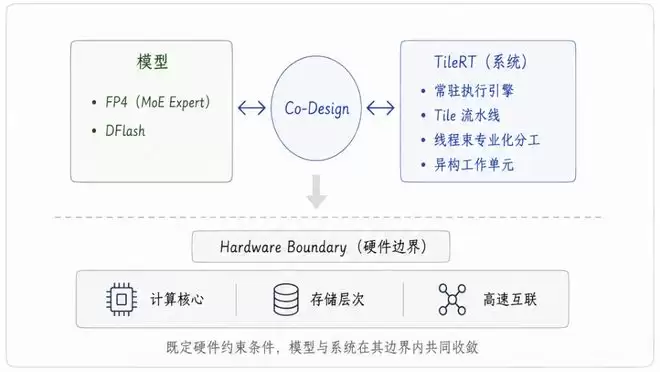
因此,UltraSpeed的1000 tokens/s不是单纯模型指标,而是一个系统工程指标。
03
速度不是免费的:UltraSpeed更适合时间敏感任务
当然,速度不是免费的。
UltraSpeed的速度也对应更高的调用成本:UltraSpeed的单价为Pro的3倍,因此,它是一种“时间优先”的选择。
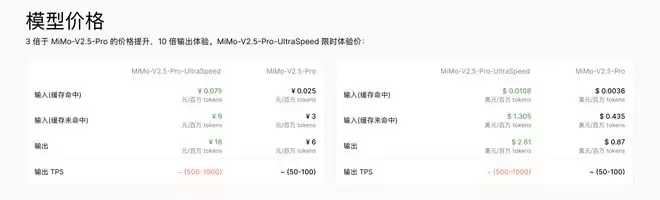
小米最新的模型价格
同时,这意味着它不是所有场景下的默认选择,也不一定适合普通闲聊、低频问答或对延迟不敏感的任务。而对于Coding Agent、长代码生成、多轮Debug、网页搭建和实时协作来说,成本判断不能只看“每token价格”,还要看“每轮迭代成本”。
如果每一轮都要等十几分钟,Agent再聪明也很难进入真实工作流;但如果每一轮都能在几十秒内完成,用户的操作节奏就会完全不同。
模型从“我问你答”,变成“我指挥,你执行;我调整,你立刻改”。
从这个角度看,UltraSpeed真正需要衡量的不是“贵不贵”,而是:当模型速度提升一个数量级时,节省下来的时间和迭代效率,是否足以覆盖更高的token单价。对于高频开发、实时协作和对响应速度敏感的Agent场景,这笔账很可能是成立的。
04
大模型从能回答走向能实时执行
过去一年,大模型能力竞争的主线,更多是在“答得准不准”、“推理强不强”和“代码会不会写”之间展开。但到了MiMo-V2.5-Pro-UltraSpeed这个模型上,一个新的分水岭开始变得清晰:模型不只是要会做任务,还要能在足够短的时间里把任务做完。
这不是一个简单的速度指标问题,而是大模型产品形态变化的前兆。
在传统聊天场景里,用户可以接受模型思考几十秒,甚至几分钟,因为交互本质上还是“提问—等待—回答”。但一旦进入Agent、代码生成、网页搭建、数据分析、自动化办公这些场景,模型就不再只是一个答案生成器,而是一个执行单元。它需要理解目标、拆解步骤、调用工具、生成代码、修复错误,并在用户的连续反馈中快速迭代。
用户不再需要把大模型当成一个“慢速外包”。过去让模型生成一段复杂代码,常常要经历长时间等待;等它输出完,再复制、运行、报错、修改,整个过程仍然像传统开发流程的低速版本。而当首响应压到1秒左右、完整生成压到1分钟以内,模型就开始接近一种新的工作方式:它可以成为实时协作的开发搭档。
如果每一轮都要等十几分钟,Agent再聪明也很难进入真实工作流;但如果每一轮都能在几十秒内完成,用户的操作节奏就会完全不同。模型从“我问你答”,变成“我指挥,你执行;我调整,你立刻改”。
从这个角度看,MiMo-V2.5-Pro和MiMo-V2.5-Pro-UltraSpeed的对比,不只是同源模型之间的性能差异,而是大模型发展方向的一次缩影:前者证明了模型可以完成复杂任务,后者进一步证明了复杂任务可以被快速完成。
很期待其他的模型也能进一步赶上来。
MiMo率先把万亿参数模型的生成速度推到了1000 tokens/s量级,但这不应该是少数玩家的专属能力,而应该成为整个行业的基准线。只有更多模型在保持能力的同时把推理成本降下来、把响应时间压下去,大模型才能真正从回答问题的工具,变成实时执行的基础设施。到那时,开发者不会因为等待而打断思路,Agent不会因为延迟而失去连续性,用户也不再需要模型的能力和时间中进行权衡。这一天越早到来,整个生态就越早受益。
想要免费体验DeepSeek大模型?本文提供DeepSeek网页版官方登录入口,详解注册步骤、免费额度规则及深度思考模式的使用技巧,助你安全、高效地利用AI提升工作效率。
深入解析大模型中 Temperature 和 Top-p 参数的区别。通过 Softmax 计算和累计概率示例,说明温度如何影响概率分布形状,Top-p 如何筛选候选词集合,帮助理解模型生成机制。
马斯克回应称中国大模型或于2027年一季度达到Fable级别。智谱GLM-5.2多项评测与海外头部模型差距缩小至1%-4%,在CodeArena获全球可用模型第一。智谱股价单日涨26%,市值破9000亿港元。科创板拟扩大第五套标准支持AI企业上市。
6月19日,我国首个水产育种专用智能大模型平台“蓝鲲智种”在海南发布,由青岛蓝色种业研究院联合中国海洋大学等打造,标志着水产育种领域拥有专属科学智能模型和基础平台。
研究团队提出并行循环Transformer,让70亿参数模型通过两次内部循环思考,在代码任务上超越数百亿参数的大模型,第三次循环后性能因收益-代价失衡而下降。结合显式推理链可进一步提升效果。
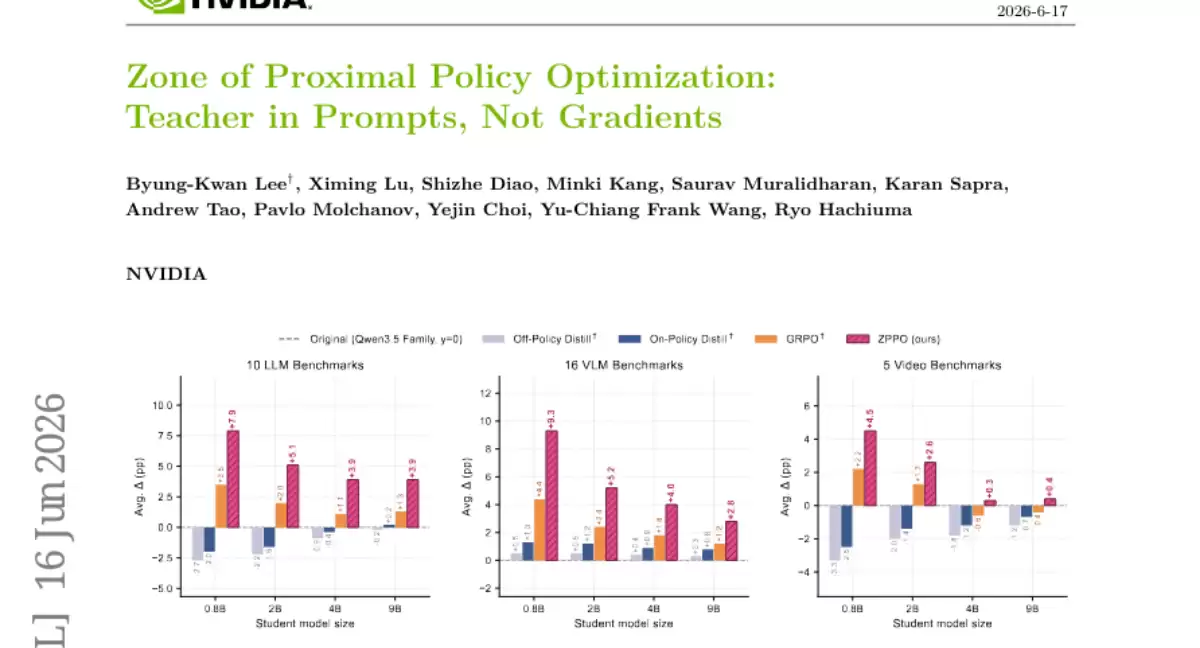
英伟达提出ZPPO方法,让大模型智慧以题目背景而非答案形式辅助小模型学习,通过二元候选、负面候选及回放缓冲区三大组件,在0.8B模型上视觉语言理解提升9.3%,全面超越现有方法。
闭源API成本高、依赖性强,开放权重模型因可部署、可控、低成本而受青睐。2026年智谱GLM-5.2在特定任务接近美国前沿水平,标志前沿能力通过开放权重扩散。企业转向混合路线,模型调度层成为新机会,核心问题从“谁最强”变为“谁还愿意一直租用AI能力”。
大模型监督微调SFT,过去一直被当作一个“数据越多越好”的活儿。但如果你真的在一线跑过训练,就会知道这个直觉有多离谱。2026年的产业数据很清楚:国内大模型训练的整体算力有效利用率,连五成都不到。大量GPU资源,其实都消耗在那些重复、低信息量、甚至带偏见的冗余样本上。 从根子上讲,全量样本训练不仅直
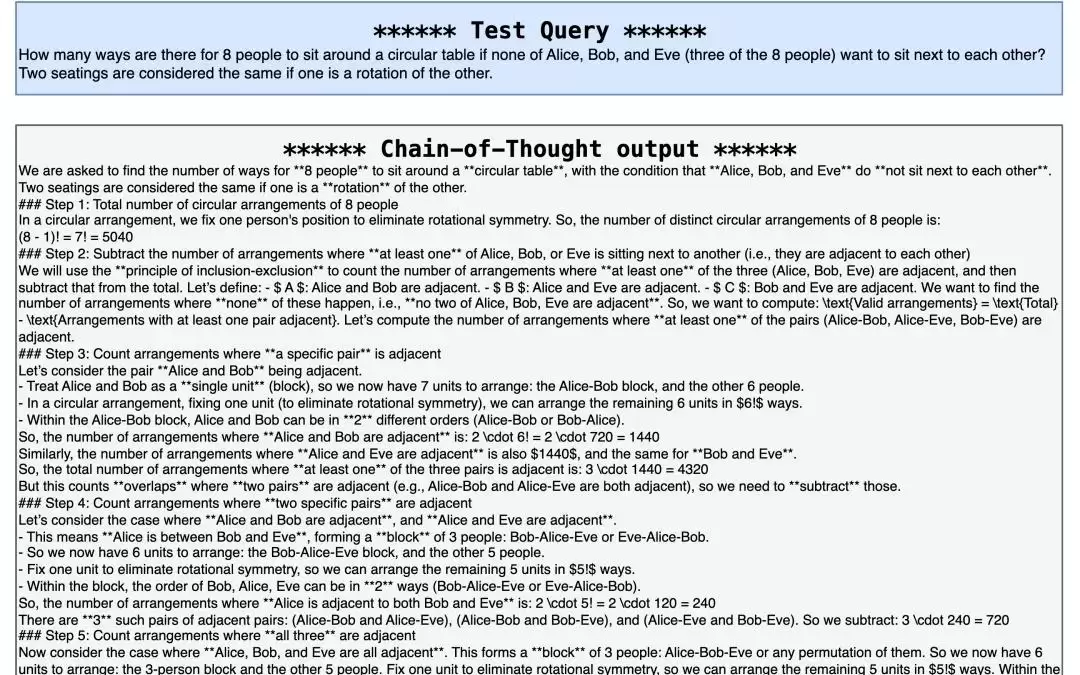
CLSR提出让大模型智能体自主生成演化机器语言符号体系,将推理链视为带宽受限的状态传输。实验表明,该方法在多种基准上将生成端token降低约3-6倍,基本维持原始CoT准确率,并改善accuracy-token帕累托前沿。
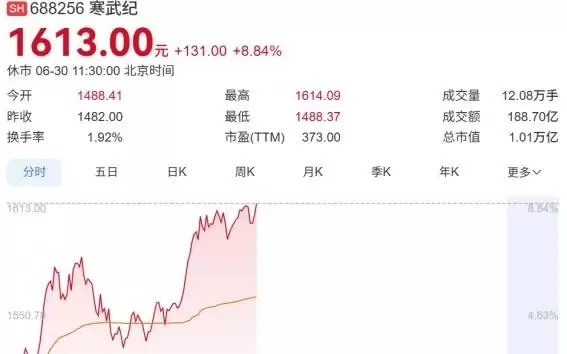
6月30日国产算力板块拉升,寒武纪涨超8%市值破万亿。美团发布LongCat-2.0,为首个完全基于国产算力训推的万亿参数大模型,参数超1.6万亿,测试版调用量全球前三,训练峰值算力超5万卡,成本低于同类模型。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



