

拆解Kimi K3技术报告:月之暗面开始给DeepSeek出题了
7月24日晚上,黄仁勋在X上发了人生第一条推文。他没推自家芯片,而是贴了一封25家公司联名签署的公开信,主张开源AI模型,呼吁国会不要过早设限。签名单上,英伟达、微软、Meta、IBM赫然在列。 这封信发出的同一周,Kimi K3的完整权重挂上了Hugging Face。 再往前推十天。7月16日,
7月24日晚上,黄仁勋在X上发了人生第一条推文。他没推自家芯片,而是贴了一封25家公司联名签署的公开信,主张开源AI模型,呼吁国会不要过早设限。签名单上,英伟达、微软、Meta、IBM赫然在列。
这封信发出的同一周,Kimi K3的完整权重挂上了Hugging Face。
再往前推十天。7月16日,K3上线仅仅几个小时,便在WebDev Arena登顶。这是开源模型第一次在编程盲测榜上,将所有闭源模型压在身下。Nathan Lambert写了一句后来被反复引用的话:“frontier open-weight models are now real”。而Kimi的C端,因为算力紧缺,甚至暂停了新用户订阅。
这一切,都发生在权重发布之前。Kimi是怎么做到的?这份刚刚发布的47页技术报告,足以回答绝大多数疑问。
K3在报告的引言里,直接就亮出了一个判断:
大模型的scaling有两条主轴。一条是部署前拼算力,堆更大的模型和更多的数据;另一条是部署后拼算力,拼推理时间、强化学习、agent的长程执行。过去两年,开源社区在后一条轴上跑得飞快,但在前一条轴上几乎原地踏步,绝大多数模型仍然停在1T参数这一档。当越来越精巧的后训练方法被用在规模相近的底座上,开源的进展会互相收敛,和最强闭源模型之间的差距,反而会越拉越大。
报告在这段判断后面,直接引用了DeepSeek V4。
一个多月前,V4的报告给出了另一条路线:重新设计注意力机制和训练配方,大幅压低百万上下文的成本,重心放在部署侧。而K3的路线则截然相反——预训练这条轴必须先跟上,两条轴一起推到前沿。两条路线落实到参数上,差别巨大。V4 Pro,1.6万亿总参数,每token激活49亿,在拼命往下压激活量;K3,2.78万亿总参数,每token激活1042亿,直接把激活量翻了一倍多。
两份技术报告,就这样隔空完成了对话。
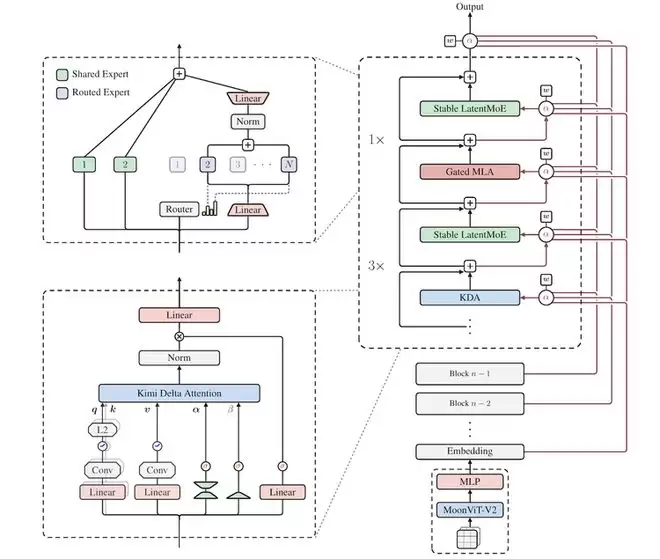
K3 整体架构图
2.5倍效率从哪来
K3的数据显示,相比上一代K2,整体scaling效率提升了约2.5倍。
这笔账是怎么算的?
简单来说,一个大模型处理信息,离不开三个方向:token和token之间怎么交流,这是序列方向;浅层和深层之间怎么传话,这是深度方向;每个token分给多少“专家”去处理,这是宽度方向。K3恰恰在这三个方向上,各做了一组关键改动,最终叠出了2.5倍的效果。
KDA:计算量从平方降到线性
传统注意力的计算方式,是让每个词回头比对前面所有词。文本长度翻倍,计算量就翻四倍。要做百万token的上下文,这个机制根本算不过来。K3的做法,是把四分之三的注意力层换成了一种叫KDA的线性注意力。它不再逐词回翻,只维护一份固定大小的状态,计算量随文本长度线性增长。
代价是,线性注意力的表达能力,确实不如传统注意力。所以K3的策略是“3:1混合”——每三层KDA之后,保留一层传统注意力(MLA)。日常处理交给KDA,需要全局视野时,再由MLA接管。这个思路,Qwen3-Next、MiniMax M1也在走,线性注意力混合架构,正在成为工程界的共识。
K3在自家之前的工作上,还做了一个关键改进:给KDA的衰减率加了一个下界。改动虽小,但价值巨大。之前的做法会导致中间数值无限增长,GPU算的时候必须走一条特殊路径,用不上最快的计算单元。加了下界之后,所有计算都能走统一的快速路径。一个参数的调整,就把整条计算链打通了。
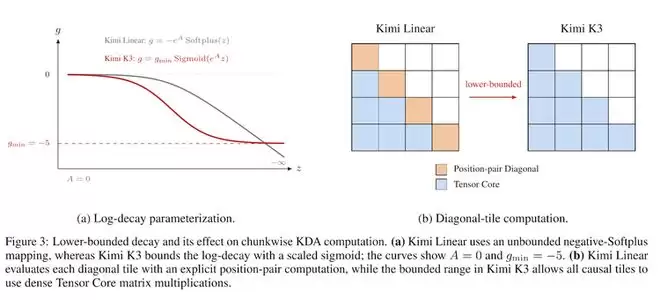
还有一个配套设计:K3完全去掉了位置编码。传统做法是给每个词标一个“座位号”,模型靠座位号知道谁在前谁在后。K3不标座位号,让KDA自己的衰减机制记住位置。好处很直接——模型可以直接处理100万token的上下文,不用事后做各种复杂的适配和插值工程。
AttnRes:让第93层直接翻看第1层的笔记
KDA解决了同一层里,词与词怎么高效交流的问题。但K3有93层,层和层之间怎么办?
过去十年,深度学习传信息,靠的是残差连接。每一层只能看到上一层递过来的状态,更早的信息全部压缩在这个状态里,一路往后传。层数少的时候没问题,但到了93层,早期层算出来的特征传到后面,几乎被稀释殆尽。
K3的解决方案叫AttnRes。它给每一层装上一组检索参数,让这一层能主动去前面所有层的输出里,挑自己需要的东西。第90层可以直接去读第1层的原始输出,也可以跳到第40层拿某个中间结果,不用等信息一层层传。这和KDA形成了一个“一横一竖”的格局:KDA管同一层里词与词的交流,AttnRes管层与层之间的交流。
当然,93层对93层全做检索,开销太大。K3把93层分成7个完整的12层block,加1个9层的尾block,连同embedding层,一共9个block。检索只在这9个压缩后的block之间做,开销大幅降低。
DeepSeek今年的工作,也在改这块十年没动过的基础结构。技术路径不同,但判断一致:标准残差连接,在百层规模上,已经成为瓶颈。
Stable LatentMoE:896个专家的稳定术
序列方向,KDA解决了;深度方向,AttnRes解决了。第三个方向是宽度——每个词进来,分给多少个专家去处理。
MoE(混合专家)的思路,是在模型里放很多个专家子网络,每次只调用其中几个。总参数量很大,但每个词实际用到的计算量可控。K3把这个配置推到了极端:896个专家,每个词只用16个,参数利用率不到2%。
推到这个量级,两个原本不严重的问题变得格外棘手。第一,计算链路太长,中间数值容易失控。K3的办法,是在关键节点加归一化层压住波动,并且把激活函数换成一种有天花板的版本(SiTU-GLU),小数值正常响应,大数值被截住。
第二,896个专家,有的可能被频繁调用,有的常年闲置。传统做法是加一个额外的惩罚项来纠偏,但专家多到这个数量级,惩罚项调起来非常不稳定。K3另辟蹊径,提出了分位数均衡的方法。它直接看所有词给每个专家打分的统计分布,从分布反推出每个专家应有的调度偏好,一次计算就能算完。报告里给出了数学证明,理论上能做到完美均衡。
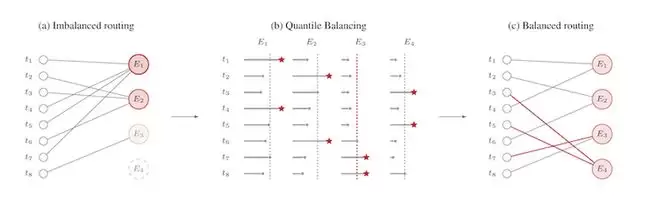
分位数均衡,直接改进了DeepSeek V3的方案。V3用固定步长逐步调整,负载一波动就跟不上;分位数均衡直接对齐分布,反应快得多。K3拿到对方的思路,承认方向对,但在这个基础上做得更好。
基础设施:5120万个沙箱和九个RL教师
前面三节都是架构设计,解决的是“模型长什么样”的问题。但设计好,还得练得出来。K3的2.5倍提升里,有一部分就来自训练层面。
视觉编码器这块,行业通行做法是拿别人预训练好的模型来初始化。K3反过来,完全从零训练。优化器和训练数据,也做了针对性调整。
基础设施层面,K3的MoonEP针对896个专家的并行训练,做了一套均衡方案。数学证明,只需预留少量冗余专家,就能保证任意负载下的平衡分配,训练永不中断。RL训练用的沙箱,基于轻量级虚拟机,训练和评估期间一共创建了5120万个,存档仅需133毫秒,恢复49毫秒。这个规模,足以说明K3在让模型自主执行任务这条训练线上,投入了巨大的精力。
后训练同样没省。K3在通用、agent、编程三个领域,各训了三个不同推理强度的模型作为教师。九个教师全部自研,最后把九个教师的能力,蒸馏回一个统一模型。结果如何?BrowseComp上达到91.2%,成本是GPT-5.6 Sol的一半;Kimi Code Bench上,比Claude Fable 5低4分,花费却只有38%。预训练和后训练两头都在发力,K3所说的“两条轴一起推”,报告里的数据就是最好的证明。
开源与闭源竞争势头的一次扭转
翻看K3的技术报告,DeepSeek的痕迹其实不少。MLA沿用了DeepSeek-V2的注意力压缩机制,不加辅助loss的路由策略来自V3,LatentMoE把共享专家和路由专家分开的设计,也建立在DeepSeek的研究之上。
但有意思的是,K3也开始给DeepSeek“出题”了。
技术报告里展示了一个GPU kernel优化的case study,让模型去优化四个代表性kernel,其中一个就是DSA(DeepSeek Sparse Attention)——DeepSeek自家的核心注意力算子。结果,K3把DSA的运行时间砍掉了55.1%。自家核心算子被别人提速过半,DeepSeek下一版,很难不做出回应。
K3给整个开源社区的东西,同样不少。KDA连带FlashKDA kernel和KDA Context Parallelism一起开源了,其他团队想试线性注意力,不用从零写起。Quantile Balancing改进了DeepSeek-V3的负载均衡方案。MoonEP的完美平衡证明,推进了DeepEP那条线上的工程问题。SiTU-GLU、AttnRes,可以被后续模型直接拿走复用。K3自研的MiniTriton,一个类Triton的GPU编译器,在NVIDIA L20上的核心benchmark,已经接近或超过最新Triton,也一并开源了。
一方的技术报告写得越详细,另一方就越容易在这个基础上往前走一步。DeepSeek-V3把MoE的辅助loss拿掉,K3就用分位数方法做得更精确;K3把线性注意力的工程问题解了一遍,下一个想用KDA的团队,就少走一大段弯路。
这份技术报告留下了很多悬念,不只是给Kimi自己的,也是给其他开源模型的。比如,DeepSeek的下一版模型,会不会用上分位数均衡和线性注意力混合架构?比如,更多的开源模型在同样往更大规模参数scale的时候,还会在Kimi开源的这些预训练框架基础上,再做哪些创新改进?
下一次在技术报告里隔空喊话的,可能就不只是Kimi和DeepSeek了。而这样的势头,正是过往几年开源社区共同构建起来的。也许,开源和闭源模型的竞争势头,在此刻之后,真的要发生根本性的逆转了。
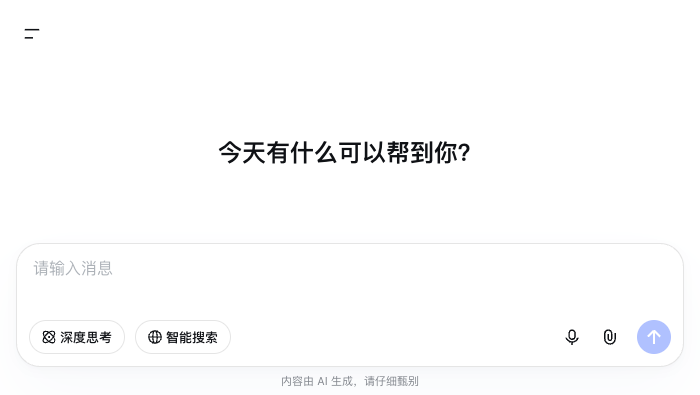
chat-demo v0.1.1可以作为静态聊天客户端在本地运行,但模型、搜索、文件和语音能力仍由DeepSeek API提供。源码运行环境为Node.js 22.12及以上、Git与pnpm。Demo版本号不等于应用API版本;这套应用API未单独标版本,默认聊天模型ID是deepseek-flash。
用DeepSeek辅助写小红书标题时,应先提供受众、核心卖点、真实素材、语气和字数限制,让模型批量生成候选标题,再人工核对事实、敏感表达和平台规范。标题是否获得高点击还受内容质量和账号表现影响,不能把模型结果当作爆款保证。
了解DeepSeek模型权重与DeepInfer推理框架的对象差异,查看官方项目入口,并从价格竞争、开发者协作和小团队参与三个角度理解开源策略。
理清幻方量化与DeepSeek的发展脉络,关键在于区分早期萤火二号的A100集群积累与DeepSeek-V3的H800训练配置。本文解析软硬件协同工程在其中的作用,避免将资金投入简单等同于模型能力。
DeepSeek返回空内容时,先检查content是否只有空格,再查看finish_reason、reasoning_content、tool_calls和流式事件。JSON模式提示不完整、输出预算不足、内容过滤、工具调用未处理或SSE解析错误都可能造成“看起来为空”。
DeepSeek开启流式输出只需在API请求中设置stream=true并逐块读取SSE事件。Chat Completions以data: [DONE]结束,Responses API则以response.completed、response.incomplete或response.failed结束,两种协议不能混用同一套结束判断。
DeepSeek开启JSON模式需要在请求中设置response_format为json_object,并在系统或用户提示词中明确要求输出JSON及字段示例,同时设置足够的max_tokens。返回后仍应解析和校验字段,空白内容或截断时执行重试。
DeepSeek-V4提示词可按“目标+背景+输入+约束+输出格式+验收标准+示例”编写。先明确要完成的任务,再提供必要材料和边界,最后规定可检查的输出结构,比堆砌角色词或空泛要求“更专业”更稳定。
DeepSeek上传文件提示超限时,先确认是在App、网页还是API中上传,再检查单文件大小、格式、图片尺寸、文件数量和账号存储配额。App或网页可压缩、拆分后重传;API图片文件单个最大64 MiB,并只支持JPEG、PNG、GIF和WebP。
DeepSeek-V4-Pro的推理强度可通过API的reasoning_effort设置为low、high或max,并配合thinking启用思考模式;网页和App通常只提供模式切换,不一定开放细粒度强度。本文给出参数、代码和无效配置排查方法。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



