

马萨诸塞大学阿默斯特分校与Adobe联合提出的智能检索新框架GRASP
马萨诸塞大学阿默斯特分校与Adobe研究院提出GRASP框架,为智能体检索增强生成配备语义搜索、关键词搜索和阅读段落三种粒度工具,并通过强化学习训练策略选择。在HotpotQA等数据集上,GRASP的检索召回率和问答准确率均优于现有方法,包括使用GPT-5mini的IRCoT。
这项研究由美国马萨诸塞大学阿默斯特分校与Adobe研究院联合完成,论文于2026年7月发布,编号arXiv:2607.10463v1,属于人工智能与自然语言处理领域。感兴趣的读者可以通过这个编号在arXiv上找到完整论文。
一、你的AI助手为什么总是答错多步骤的问题?
你有没有遇到过这样的情况:你问一个AI助手一个需要“查两遍资料”才能回答的问题,结果它给你一个听起来很自信但其实完全错误的答案?
举个例子,一道典型的“烧脑题”:哪张Eminem的专辑收录了一位曾发行过《Unapologetic》专辑的歌手的客串人声?要回答这道题,你得先搞清楚《Unapologetic》是谁的专辑(答案是Rihanna),然后再去查哪张Eminem的专辑收录了Rihanna的客串演唱(答案是《The Marshall Mathers LP 2》)。这是一个典型的“两跳”问题——得先找到中间那块“跳板”,才能抵达最终答案。
现有的AI问答系统在这类问题上表现糟糕,原因有三个层面。第一,如果AI只查一次资料,它可能恰好拿到了包含Rihanna和Eminem名字的两段文字,但这两段文字里还夹杂着大量无关信息——比如某张专辑的销售数据、某首歌的作词经历——这些“噪音”会把AI的注意力带跑偏,让它产生幻觉,把答案误判为《Encore》而非正确答案。第二,即便AI可以多次查资料,如果第一次查错了方向(比如误以为《Unapologetic》是Kelly Clarkson的专辑),那接下来的每一步都会沿着错误的轨道越走越远,最终得出一个看起来“有理有据”却完全错误的结论。第三,AI在查资料时通常只会用一种方式检索——要么按关键词精确匹配,要么按语义相似度模糊搜索——但不同的问题需要不同的检索方式,用单一策略应对所有情况,必然捉襟见肘。
正是为了解决这三个问题,马萨诸塞大学阿默斯特分校与Adobe研究院的研究团队提出了一个名为GRASP的新框架,全称是“粒度感知搜索策略”(Granularity-Aware Search Policy for Agentic RAG)。
二、AI界的“检索增强生成”是怎么一回事?
在正式介绍GRASP之前,有必要先解释一个背景概念:检索增强生成,英文简称RAG。
可以把大型语言模型(也就是ChatGPT这类AI)比作一个记性极好但知识截止于某个时间点的“百科全书脑”。它在训练时读了海量文字,把知识“记”在了大脑里,但一旦训练结束,它就再也无法主动更新自己的知识库了。如果你问它一件最近发生的事,它要么不知道,要么胡编乱造。
RAG的出现解决了这个问题。它的核心思路是:在AI回答问题之前,先让一个“助理”去外部文档库里查相关资料,把查到的内容递给AI,AI再基于这些新鲜资料生成答案。这个过程就像考试时允许你查参考书——有了参考资料,答题质量自然大幅提升。
传统的RAG是“静态”的,流程固定且简单:查一次资料,然后生成答案,完事。但对于需要多步推理的复杂问题,查一次往往远远不够——你需要根据第一次查到的内容,再去查第二次、第三次,逐步拼凑出完整的证据链。这种“边想边查、边查边想”的动态模式,就是所谓的“智能体RAG”(Agentic RAG)。
GRASP要解决的,正是如何让AI在这种动态多步检索过程中,做出更聪明的决策。
三、GRASP的核心设计:三把不同的“查资料”钥匙
GRASP给AI配备了三种不同的检索工具,它们各司其职,相互配合,就像一个侦探团队里的不同专家。
第一种工具叫做“语义搜索”。这种搜索不要求你知道确切的词语,它靠的是“意思相近”来匹配内容。就好比你告诉图书管理员“我想找一本讲人类为什么会做梦的书”,管理员会给你推荐心理学、神经科学等相关书目,即便那些书名里根本没有“做梦”这两个字。语义搜索擅长的是宏观的、概念性的探索——当你还不确定答案在哪里时,先撒一张大网。
第二种工具叫做“关键词搜索”。这种搜索非常精准,它要求文档里必须出现你指定的词语才算匹配。就像你告诉图书管理员“我要找书名里有'Rihanna'的书”,只有书名精确包含这个词才会出现在结果里。关键词搜索擅长的是锁定具体的人名、地名、专有名词——当你已经知道自己要找什么时,用它来精确定位。
第三种工具叫做“阅读段落”。前两种工具返回的是简短的“摘要片段”,就像图书馆的检索系统只给你看书名和简介。但有时候,一个简短的片段不足以说明问题,你需要把整段完整的原文读一遍,才能确认细节、建立上下文联系。这就是“阅读段落”工具的用途——当你发现某个片段“看起来很有希望”时,立刻调出它所在的完整段落,仔细核实。
这三种工具的关键创新之处在于:它们操作的“粒度”是不同的。语义搜索和关键词搜索返回的是句子级别的内容,而阅读段落则返回完整的段落。通过这种设计,AI可以先看“摘要”,确认相关后再读“全文”,避免一开始就把大量无关的长文本塞进自己的思考窗口里,干扰判断。
四、如何教会AI什么时候用哪把“钥匙”?——强化学习的妙用
设计好三种工具还不够,更难的是:怎么教AI学会在正确的时机、用正确的工具、检索正确粒度的内容?
研究团队采用了一种叫做“强化学习”的训练方法。可以把这个过程理解为训练一只导盲犬。你不可能逐字逐句地告诉它每一步该怎么做,但你可以在它做对了的时候给它奖励,做错了的时候不给奖励,让它通过反复试验自己摸索出正确的行为模式。
在GRASP的框架里,AI(也叫“智能体”或“策略”)会针对同一个问题,尝试多条不同的“检索路径”,每条路径就是一次完整的推理过程,包括中间的每次检索动作和最终给出的答案。训练结束后,每条路径都会被打分,AI通过比较不同路径的得分来调整自己的行为策略,逐渐学会哪种做法更有效。
打分的标准设计得相当细致,涵盖四个维度。
最重要的是“答案准确性”——最终给出的答案是否正确?这是最核心的评判标准,研究团队用的是“词语重叠度”这种客观指标来衡量,满分1.0分。
其次是“有根据的阅读”——AI在使用“阅读段落”工具时,是否真的在读与答案相关的“黄金段落”,而不是在读无关的干扰文章?如果AI频繁地去读那些与问题无关的段落,会浪费珍贵的“思考空间”,这种行为会被扣分。这项指标满分0.7分,是所有辅助指标中权重最高的。
第三个维度是“互补搜索”——AI在整个推理过程中,是否同时使用了语义搜索和关键词搜索这两种工具,并且两种工具都至少找到了一篇相关的“黄金文章”?如果AI只会反复用同一种工具,说明它没有学会灵活调配两种检索信号,这种行为会得0分。这项指标满分0.15分。
第四个维度是“步骤效率”——AI在给出正确答案的前提下,是否用了尽可能少的步骤?这是为了防止AI养成“漫无目的地乱查”的坏习惯。但有一个重要的前提:只有当最终答案足够正确时(准确度超过50%),效率奖励才会发放,否则AI可能会学会“少查两步、随便猜个答案”这种投机取巧的策略。这项指标同样满分0.15分。
四项得分加起来,总分上限是2.0分——其中答案准确性占1.0分,所有辅助项合计1.0分。这种设计确保了答案质量始终是最优先的目标,辅助项只起引导作用,而不会让AI去“钻空子”刷高某一个单项指标来换取更高总分。
具体的训练算法采用的是一种叫做GRPO(组相对策略优化)的方法。简单说,就是对同一个问题生成一批不同的解答路径,然后通过互相比较这批路径的好坏来更新AI的策略,而不是依赖一个绝对的评分标准。这种“相对比较”的方式在计算上更稳定,训练效果也更好。
五、实验设置:在真实的“多跳”问题集上接受考验
研究团队选用了三个公认的多跳问答基准数据集来检验GRASP的表现,分别是HotpotQA、2WikiMultiHopQA和MuSiQue。这些数据集的共同特点是:每道题都需要至少两步推理才能得出答案,而且题库里同时存在“正确支撑段落”和大量“干扰段落”,考验AI在信息噪声中精准定位证据的能力。
GRASP的主模型基于Qwen2.5-3B-Instruct——一个参数量为30亿的开源模型,规模算不上大,这对于一个需要在有限“大脑容量”下做复杂多步推理的任务来说是相当有挑战性的。研究团队在HotpotQA的训练集上训练GRASP,然后把训练好的模型直接拿去测试其他两个数据集,以此检验模型的“跨数据集泛化能力”——即在没见过的新场景下的表现。
语义检索器使用的是Qwen3-0.6B,关键词检索器使用的是经典的BM25算法,每次检索返回排名前5的结果。
对比的基线方法涵盖了多个类型。单步检索类基线分别测试了纯关键词检索、纯语义检索和混合检索(融合两者再用重排模型筛选)三种配置。多步检索类基线包括:IRCoT(一种通过思维链提示来引导多步检索的方法,使用GPT-5 mini这个强大的商业模型)、Search-R1(一种基于强化学习训练的单工具语义检索智能体,也是3B规模的开源模型,有PPO和GRPO两个版本)。此外还有一个“基础版”对比项:在没有经过强化学习训练的情况下,直接用GRASP的三工具提示模板让原始模型作答,以此衡量RL训练本身带来的提升。
六、实验结果:GRASP在各项指标上的全面表现
先看检索召回率,也就是“是否找到了所有答案所需的关键文章”。这是一个非常重要的前置指标——如果该找的文章根本没找到,答案自然不可能正确。
单步检索方法中,混合检索的表现最好,在HotpotQA上的召回率达到0.86,明显优于纯关键词检索的0.61和纯语义检索的0.73。这说明两种检索信号确实是互补的,合并使用比任意一种都强。但即便是最强的混合检索,也只有0.86的召回率,意味着每七道题里就有一道的关键证据没有被找到。
多步检索方法里,GRASP在三个数据集上都拿到了最高的召回率,分别是0.90、0.90和0.70,大幅领先于其他所有方法。排名第二的是IRCoT,得益于GPT-5 mini强大的推理能力,它生成的中间查询质量更高,召回率也相当不错。但GRASP是一个仅有3B参数的开源模型,能在召回率上超越使用顶级商业模型的IRCoT,足以说明其检索策略的有效性。
最能说明问题的是“基础版”的表现:同样的三工具提示模板,不经过RL训练,召回率只有0.36、0.27、0.24——比单步检索还要差得多。这意味着,仅仅“给AI三个工具”是远远不够的,关键在于通过强化学习让它学会如何正确使用这三个工具。
再看问答准确率,研究团队使用了三种指标:精确匹配(答案必须一字不差)、词语级F1分(部分匹配也计分)以及“AI法官”评分(用GPT-5 mini来判断答案是否在语义上正确)。
在HotpotQA上,GRASP的精确匹配率达到0.53,F1分达到0.66,AI法官评分达到0.71。相比之下,最强的单步方法(混合检索)只有0.37、0.48、0.56,Search-R1(GRPO版)是0.45、0.56、0.58。GRASP在所有三个数据集的几乎所有指标上都是最优或接近最优的。
有一个有意思的对比值得特别提出:IRCoT在“AI法官”这个指标上往往得分不低(比如在HotpotQA上达到0.63),但它的精确匹配和F1分却比Search-R1更低。这说明IRCoT生成的答案在语义层面上是靠谱的,但表达方式比较随意,和标准答案的措辞对不上,所以在字面匹配指标上吃了亏。相比之下,通过强化学习训练的系统更善于生成措辞精准的答案。
七、AI自发“学会”了人类读书的技巧
研究团队对GRASP训练完成后的行为进行了深入分析,发现了一些非常有趣的现象。
他们把AI的整个推理轨迹看作一个“行为序列”,统计了不同工具之间的切换模式。结果显示,GRASP形成了一套相当规律的行为逻辑,让研究者联想到认知科学家描述的“人类信息觅食”策略。
具体来说,AI往往这样展开推理:先用语义搜索广泛探索,找到一些与问题相关的候选段落。发现某个片段“看起来有希望”之后,立刻用“阅读段落”工具读完整段,确认细节、提取关键实体(比如从“Numb是Rihanna专辑里的歌”这个片段中,确认《Unapologetic》属于Rihanna)。拿到这个“桥接实体”后,再用关键词搜索精确锁定与这个实体直接相关的文档(比如搜索“Eminem vocals Unapologetic”)。如果关键词搜索结果不够理想,就退回到语义搜索,换一个更宽泛的查询方式重新出发。如果关键词搜索找到了一个“看起来靠谱”的结果,就再用一次阅读段落工具核实全文,然后给出最终答案。
研究者指出,这个模式和人类阅读专业文献时的行为惊人地相似:先快速浏览(skimming)找到大致相关的段落,再精细扫读(scanning)提取具体信息,然后针对找到的线索做精确关键词检索。这套策略完全是AI通过试错自发习得的,研究团队并没有显式地编程告诉它“你应该先语义搜索再阅读段落”。
八、消融实验:少了哪块拼图,影响有多大?
为了验证设计中每个组件的必要性,研究团队做了一系列“拆零件”实验——每次只去掉一个工具,观察性能下降幅度。
去掉关键词搜索工具后,精确匹配率从0.510降到0.498,F1分从0.631降到0.621,影响相对有限。这说明关键词搜索有贡献,但AI在某种程度上可以通过调整语义搜索来部分弥补。
去掉语义搜索工具后,精确匹配率降到0.438,F1分降到0.567,下降幅度明显更大。这与前面的行为分析一致——语义搜索是整个推理流程的“起点”,承担着宏观探索的功能,失去它会让AI在面对需要概念关联的问题时寸步难行。
最大的打击来自去掉“阅读段落”工具,也就是退回到只能看片段摘要、无法读完整段落的模式。在这种情况下,精确匹配率跌到0.388,F1分跌到0.484,远低于完整版GRASP。研究团队分析,原因在于:当AI只能看到片段而无法读完整段落时,它生成的后续查询质量会大幅下降。因为片段里出现了太多的实体名词和关系词,AI无法判断哪个才是真正值得追查的“桥接线索”,查询方向就会变得杂乱无章,往往只是在原始问题上做小修小改,而不是真正基于已找到的中间证据去构建下一步查询。
九、归根结底,GRASP说明了什么?
说到底,这项研究揭示了一个在AI问答领域长期被忽视的真相:检索不仅仅是技术问题,更是策略问题。
给AI一个检索工具,它可以查资料。给AI两个不同类型的检索工具,它能做到互补。但如果你同时给它控制“阅读深度”的工具,让它自己决定什么时候看片段、什么时候读全文,并通过强化学习训练它在不同情境下做出正确的选择,这时候它的表现会产生质的飞跃。
这对我们理解AI未来的发展方向有实际意义。当AI助手被用于回答需要多步查找的复杂问题时——比如法律研究、医学诊断支持、深度新闻调查——它绝不能只是一个“单次查询、给出答案”的简单机器。它需要像人类研究者一样,有计划地、有策略地在信息海洋中导航,既要知道何时宽泛探索,又要知道何时精确锁定,还要知道何时停下来仔细阅读。
当然,GRASP也并非没有局限。它目前依赖于标注了“黄金支撑段落”的数据集才能计算奖励信号,这在现实中并不总是容易获取的。此外,它有时还是会“过早收手”,在还没有找到所有关键证据时就给出答案,这个问题有待进一步研究。训练所用的模型规模(3B参数)也相对较小,更大的模型是否会产生不同的学习动态,目前还不清楚。
未来的研究方向非常清晰:一方面是扩展工具箱,让AI不只能“查”,还能“计算”、“比较”、“验证”;另一方面是减少对人工标注数据的依赖,探索用模型自身的一致性来替代人工标注的奖励信号;最后是让AI的检索粒度更加灵活,从单句到段落到整篇文章,根据推理需要动态调整。
对于任何在日常工作中需要借助AI做复杂信息检索的读者来说,GRASP所代表的这个方向——让AI学会更像人类一样“分层阅读、策略检索”——是非常值得持续关注的。有兴趣深入了解完整技术细节的读者,可以通过arXiv编号2607.10463查询完整论文。
Q&A
Q1:GRASP框架中的“粒度感知”具体是指什么?
A:GRASP的“粒度感知”是指AI可以自主决定检索信息的“详细程度”。具体来说,语义搜索和关键词搜索只返回句子级别的简短片段,而“阅读段落”工具可以返回完整的段落全文。AI在推理过程中会根据情况判断:这个片段已经够用了,还是需要读完整段落才能确认细节?这种“先看摘要、需要时再读全文”的分层策略,帮助AI避免在思考过程中被大量无关文本干扰。
Q2:强化学习训练在GRASP中起到了什么作用?
A:强化学习是GRASP能够有效工作的核心。实验中有一个非常说明问题的对比:同样配备三种检索工具,但不经过强化学习训练的“基础版”AI,召回率只有0.36左右,远低于单步检索。这说明仅仅“给AI工具”是不够的,必须通过强化学习让AI反复试错、从奖励信号中学会什么时候用哪种工具,才能真正发挥出多工具协同的优势。
Q3:GRASP的奖励设计为什么要同时考虑答案准确性和检索行为?
A:如果只奖励最终答案的准确性,AI可能会走弯路——比如随机猜测几个常见答案来碰运气,或者重复调用同一个工具刷高某个中间指标。通过同时奖励“有根据的阅读”(读相关段落而非干扰段落)、“互补搜索”(两种工具都找到关键证据)和“步骤效率”,研究团队引导AI学会了更健康的推理习惯,同时通过设置答案准确性不加权的上限,确保最终目标始终是答对题而非钻制度空子。
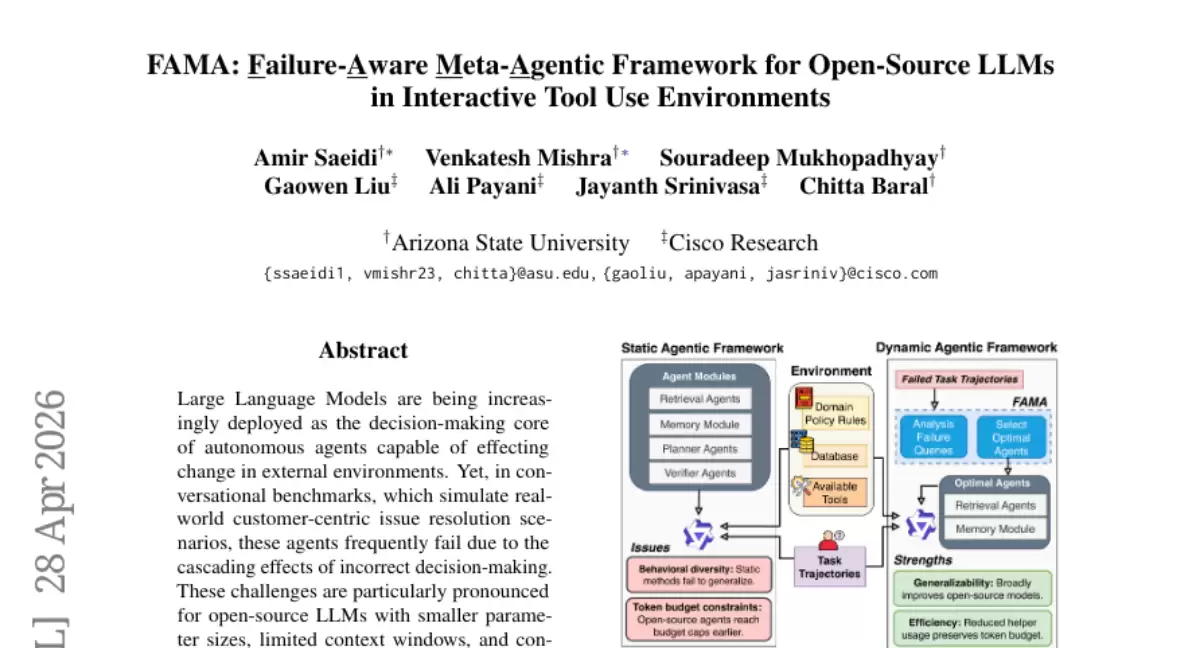
亚利桑那州立大学与思科研究院提出FAMA框架,通过分析失败案例将错误归纳为四类,并据此动态选择针对性辅助模块,以提升开源大模型在复杂任务中的可靠性。实验表明,精准配置少量模块比启用全部模块效果更好,尤其节省上下文资源,为增强小型模型实用性提供了新路径。

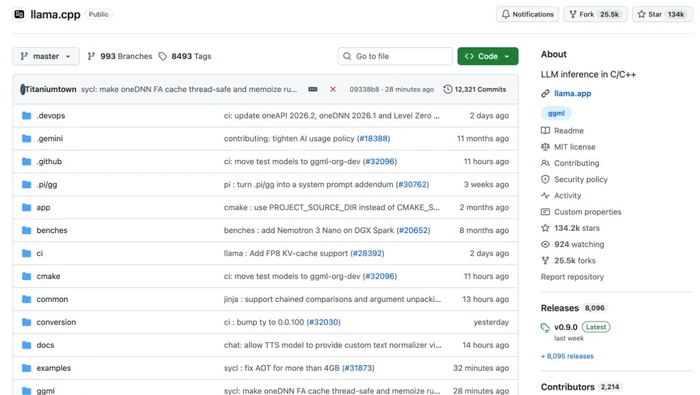
llama.cpp b12489、b12490、b12491、b12492、b12493、b12494、b12496、b12497、b12498 均为预发布构建,分别涉及服务器、语音模型及特定后端;适用范围须按模型、硬件和请求条件区分。
MiniMax-H3-Image新增DiffSynth-Studio文档推荐后,配置选择应围绕具体推理配方和独立训练流程展开。文档中的24GB GPU方案分别配合32GB或8GB主机RAM,所用量化、CPU或磁盘卸载方式不同;新增文档入口本身没有发布模型新权重或标注一个新的框架版本。
识别Ollama完整rc0预发布标签,区分MLX并发、Vulkan集成显卡mmap、llama.cpp b12257与CLI集成更新边界。
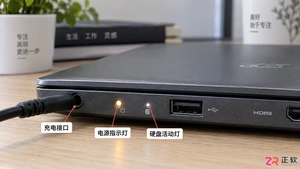
宏基笔记本遇到开机没反应、电源灯亮但屏幕黑屏,或者按下电源键完全无反应的情况该怎么办?本文通过界面与状态指示灯的观察,分步骤介绍静电释放、内存重插及外接显示器测试等实用方法,助你自行解决常见启动故障。
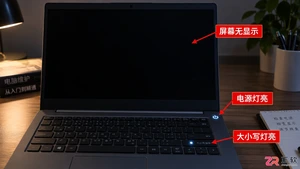
惠普笔记本开机时电源键和大小写锁定键亮起,但屏幕无反应?这通常是嵌入式控制器(EC)逻辑错误或静电干扰所致。本文详解如何通过移除外设、长按电源键进行硬件复位来恢复正常启动,并提供BIOS恢复及进一步硬件检测的建议。
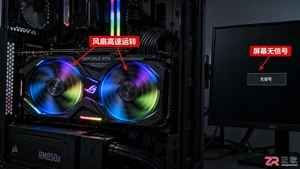
遇到电脑黑屏伴随显卡风扇狂转?这往往是显卡过热保护、供电不足或驱动崩溃的信号。本文详解如何通过观察指示灯、重置驱动、检查线缆及清理灰尘来解决该问题,避免盲目更换硬件。
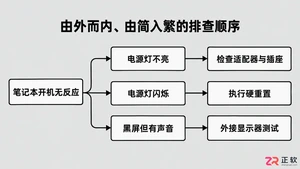
惠普笔记本无法开机、电源灯异常或屏幕黑屏?本文详解通过移除外设、执行硬重置(静电释放)、检查适配器及内存重插等步骤,快速定位并解决常见启动故障。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



