

用方差阈值过滤掉“惰性特征”
机器学习实战中,大家往往把精力花在调参和选模型上,却忽略了一个更基础的问题:喂给模型的数据里,有多少特征是真正有用的? 刚开始学机器学习那会儿,很多人特别喜欢堆特征——不管有用没用先一股脑全塞进去,总觉得特征越多模型越聪明。直到有一次跑练习数据集,X_train.shape 直接干到了 (50000
机器学习实战中,大家往往把精力花在调参和选模型上,却忽略了一个更基础的问题:喂给模型的数据里,有多少特征是真正有用的?
刚开始学机器学习那会儿,很多人特别喜欢堆特征——不管有用没用先一股脑全塞进去,总觉得特征越多模型越聪明。直到有一次跑练习数据集,X_train.shape 直接干到了 (50000, 1024),训练速度慢得像蜗牛,内存还经常告警。耐着性子把每列统计信息看了一遍才意识到问题所在:"产权年限" 这一列5万条数据全是70,"是否配备灭火器" 99.8%都是1。这些在所有样本上几乎不变的列,就是所谓的“惰性特征”——对预测没有任何贡献,却实实在在占内存、拖慢训练,有时候还会让线性模型数值不稳定。
方差阈值过滤,正是帮模型在起跑前甩掉这些“无用包袱”的最简利器。
如何过滤
过滤的原理特别简单:方差为0的特征,信息量就是0,直接删掉就行。方差衡量数据离散程度,方差越大越可能包含区分样本的信息;方差为零就意味着这个特征对所有样本都一样,模型从它身上什么都学不到。
基于这个思路,封装了一个 class,代码遵循了 scikit-learn 的 Fit-Transform API 设计模式。
 复制代码    def fit(
        self,
        X: Union[pd.DataFrame, np.ndarray],
        feature_names: Optional[List[str]] = None,
    ) -> "VarianceThresholdSelector":
        """
        在训练数据上拟合筛选器,学习哪些特征应当保留。        Returns:
            self: 返回自身以支持链式调用。
        """
        # ---------- 统一提取数值矩阵与列名 ----------
        if isinstance(X, pd.DataFrame):
            col_names = X.columns.tolist()
            matrix = X.values.astype(float)
        else:
            matrix = np.asarray(X, dtype=float)
            if feature_names is not None:
                col_names = list(feature_names)
            else:
                col_names = [f"特征_{i}" for i in range(matrix.shape[1])]        if matrix.ndim != 2:
            raise ValueError(f"输入数据必须为二维矩阵,当前维度为: {matrix.ndim}")        # ---------- 计算方差得分并生成筛选掩码 ----------
        scores = self._compute_scores(matrix)
        keep_mask = scores > self.threshold        # ---------- 记录拟合结果 ----------
        self.retained_cols_ = [name for name, kept in zip(col_names, keep_mask) if kept]
        self.dropped_cols_ = [name for name, kept in zip(col_names, keep_mask) if not kept]
        self.variance_scores_ = dict(zip(col_names, scores))        return self    def transform(self, X: Union[pd.DataFrame, np.ndarray]) -> Union[pd.DataFrame, np.ndarray]:
        """
        根据拟合结果移除低方差特征。

        Returns:
            筛选后的特征矩阵,类型与输入保持一致。
        """
        if self.retained_cols_ is None:
            raise RuntimeError("筛选器尚未拟合,请先调用 fit() 方法。")        if isinstance(X, pd.DataFrame):
            return X[self.retained_cols_]        # ndarray 场景:通过列名映射回索引位置
        all_cols = [f"特征_{i}" for i in range(X.shape[1])]
        indices = [all_cols.index(name) for name in self.retained_cols_]
        return X[:, indices]    def fit_transform(
        self,
        X: Union[pd.DataFrame, np.ndarray],
        feature_names: Optional[List[str]] = None,
    ) -> Union[pd.DataFrame, np.ndarray]:
        """
        拟合并立即转换,等价于依次调用 fit() 和 transform()。        Returns:
            筛选后的特征矩阵。
        """
        return self.fit(X, feature_names).transform(X)
和 scikit-learn 原生的 VarianceThreshold 使用方法一样,没有学习成本,改进之处在于:
- 内置归一化:解决了多量纲特征混合时的阈值设定难题
 复制代码    def _compute_scores(self, data_matrix: np.ndarray) -> np.ndarray:
        """
        计算每个特征的方差得分(内部方法)。        Args:
            data_matrix: 纯数值型的二维数组,形状为 (n_samples, n_features)。        Returns:
            一维数组,长度为 n_features,表示每个特征的方差得分。
        """
        raw_variance = np.var(data_matrix, axis=0)        if not self.use_normalized:
            return raw_variance        # 计算极差 (max - min),作为归一化的分母
        feature_ranges = np.ptp(data_matrix, axis=0)        # 安全处理:将极差为0的位置替换为1,避免除零错误
        # 此时该位置原始方差也为0,归一化结果仍为0,不影响后续筛选逻辑
        safe_ranges = np.where(feature_ranges == 0, 1.0, feature_ranges)
        normalized_scores = raw_variance / (safe_ranges ** 2)        return normalized_scores
- Pandas原生支持:保持了列名索引,提升了易用性
- 可解释性报告:让特征筛选过程透明可追溯
 复制代码    def get_selection_report(self) -> pd.DataFrame:
        """
        生成特征筛选的详细报告。        Returns:
            包含特征名、方差得分、是否保留等信息的DataFrame,
            按方差得分降序排列。
        """
        if self.variance_scores_ is None:
            raise RuntimeError("筛选器尚未拟合,请先调用 fit() 方法。")        records = []
        for feat_name, score in self.variance_scores_.items():
            is_retained = feat_name in self.retained_cols_
            records.append({
                "特征名称": feat_name,
                "方差得分": round(score, 6),
                "是否保留": is_retained,
                "筛选状态": " 保留" if is_retained else " 移除",
            })        report = pd.DataFrame(records)
        return report.sort_values("方差得分", ascending=False).reset_index(drop=True)
VarianceThresholdSelector 的核心机制是计算各特征的方差,并可选用“方差除以极差平方”的归一化方式消除量纲差异,再根据预设阈值标记并移除低方差特征。在拟合阶段,它自动记录保留与移除的列名及对应得分,并通过 transform 按此记录对 DataFrame 或 ndarray 进行列筛选,同时提供 get_selection_report 生成详细筛选报告。
测试效果
下面,模拟一个房价预测的场景,看看使用 VarianceThresholdSelector 带来的效果。
首先创建一个模拟数据,模拟主要特征和一些无关紧要的特征。
 复制代码# ==================== 数据集构造 ====================
np.random.seed(42)
n_samples = 150  # 适中样本
n_sparse = 200  # 稀疏噪声
n_cont = 50  # 伪连续噪声# 5 个真实特征
rooms = np.random.randint(2, 8, n_samples)
distance = np.random.uniform(1, 30, n_samples)
crime_rate = np.random.beta(2, 5, n_samples)  # 归一化方差 ≈ 0.039,高于阈值
age = np.random.uniform(1, 100, n_samples)
tax = np.random.normal(400, 100, n_samples)df_real = pd.DataFrame(
    {
        "房间数": rooms,
        "市中心距离": distance,
        "犯罪率": crime_rate,
        "房龄": age,
        "房产税": tax,
    }
)# 100 个稀疏二值噪声 (p=0.995,归一化方差 ≈ 0.005,低于阈值)
sparse_cols = [
    pd.Series(np.random.choice([0, 1], n_samples, p=[0.995, 0.005]), name=f"稀疏_{i}")
    for i in range(n_sparse)
]
# 50 个伪连续噪声:大部分为0,偶尔有极端值
# 归一化方差 ≈ 0.01,低于阈值 0.02,会被正确过滤
pseudo_cols = []
for i in range(n_cont):
    col = np.zeros(n_samples)
    n_outliers = np.random.randint(1, 3)
    outlier_idx = np.random.choice(n_samples, n_outliers, replace=False)
    col[outlier_idx] = np.random.uniform(100, 1000, n_outliers)
    pseudo_cols.append(pd.Series(col, name=f"伪连续_{i}"))df_noise = pd.concat(sparse_cols + pseudo_cols, axis=1)
n_noise = n_sparse + n_contX = pd.concat([df_real, df_noise], axis=1)
然后分别用三种方式(全特征,不归一化筛选和归一化筛选)来训练这个数据集。
 复制代码# 1. 全特征
rmse_full, t_full = evaluate(X, y)
print(
    f"【全特征】       特征数 {X.shape[1]:3d} | RMSE: {rmse_full:.2f} 万 | 耗时: {t_full:.3f}s"
)# 2. 不归一化筛选(阈值 0.1)
sel_raw = VarianceThresholdSelector(threshold=0.1, use_normalized=False)
X_raw = sel_raw.fit_transform(X)
rmse_raw, t_raw = evaluate(X_raw, y)
print(
    f"【不归一化筛选】 特征数 {X_raw.shape[1]:3d} | RMSE: {rmse_raw:.2f} 万 | 耗时: {t_raw:.3f}s"
)
print(
    f"  被误删的有用特征: {[c for c in df_real.columns if c not in sel_raw.retained_cols_]}"
)# 3. 归一化筛选(阈值 0.02,恰好剔除稀疏噪声)
sel_norm = VarianceThresholdSelector(threshold=0.02, use_normalized=True)
X_norm = sel_norm.fit_transform(X)
rmse_norm, t_norm = evaluate(X_norm, y)
print(
    f"【归一化筛选】   特征数 {X_norm.shape[1]:3d} | RMSE: {rmse_norm:.2f} 万 | 耗时: {t_norm:.3f}s"
)
print(f"  保留的特征: {sel_norm.retained_cols_}")
运行结果:
 复制代码样本数: 150, 特征数: 255 (5 真实 + 250 噪声)【全特征】       特征数 255 | RMSE: 12.78 万 | 耗时: 0.062s
【不归一化筛选】 特征数  54 | RMSE: 11.87 万 | 耗时: 0.028s
  被误删的有用特征: ['犯罪率']
【归一化筛选】   特征数   5 | RMSE: 5.81 万 | 耗时: 0.024s
  保留的特征: ['房间数', '市中心距离', '犯罪率', '房龄', '房产税']
从结果可以看出,做了特征筛选之后,耗时明显下降;归一化之后,防止特征误删,RMSE 更小(也就是效果更好)。最后,只用了 5 个特征,将 RMSE 从 12.78 万美元降至约 5.81 万美元,降低了 54%,显著提升了模型泛化能力。
注意事项
方差阈值最大的优势是快且安全。它是纯无监督操作,不需要标签、不依赖模型假设,毫秒级即可完成数万维特征的粗筛,且完全不存在数据泄露风险。在文本 tf-idf 矩阵、用户行为 one-hot 编码等超高维稀疏场景中,它往往是特征工程 pipeline 的第一道防线。
但它也有明确的能力边界:方差≠预测力。一个低方差特征可能对某个稀有类别有极强的区分度(比如“是否vip”仅5%为真,但精准标识高价值用户),方差阈值会误杀它;而一个高方差的自增id与目标变量毫无因果关系,方差阈值却无法识别。因此,它只适合做“粗筛”,精细选择仍需交给互信息、lasso等有监督方法。

机器学习奠基人MichaelJordan认为AGI是公关炒作,AI的真正挑战在于让系统学会协调。他主张机器学习必须与经济学结合,关注不确定性、激励机制和数据流动等社会系统性问题,而非单纯追求模型能力。

持续坚持原创输出,点击蓝字关注我吧 ❝ 沉淀、分享、成长,让自己和他人都能有所收获! ❞ 目录 一、前言二、面试题三、线程池讲解1. 先看个例子2. 手写一个线程池3. 线程池源码分析四、总结五、系列推荐一、前言人看手机,机器学习!正好是2020年,看到这张图还是蛮有意思的。以前小时候总会看到一些科

当前数字时代,deepseek入口智能助手凭借前沿技术架构为用户带来革新体验 在如今这个数字浪潮翻涌的时代,deepseek入口智能助手凭借其前沿的技术架构,为用户带来了真正意义上的革新体验。这个平台巧妙融合了自然语言处理与知识图谱技术,能够精准解析那些看似复杂的语义需求,已然成为提升工作效率的智能
刚开始学机器学习时,我也像大部分人 一样,有个很朴素的想法:特征越多,模型能学到的信息就越多,效果自然越好。 所以每次拿到数据,我就拼命往模型里塞特征——能算出来的统计量全加上,能衍生出来的比率全拼上。 一个原本 20 列的数据集,经常被我搞到七八十列。 然后我就发现事情不太对劲了: 训练时间明显变
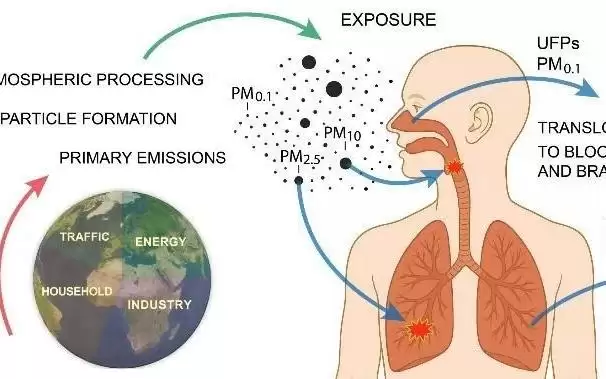
空气中直径小于100纳米的超细颗粒物每年导致约199万人早逝,其中近半因心血管疾病。该颗粒物主要来自化石燃料,可通过呼吸进入血液,引发氧化应激和内皮功能紊乱,是未被充分认识的心血管危险因素。若年均浓度控制在每立方厘米5000个以下,全球超额死亡率可降低约45%。
这项研究来自Ezgi Korkmaz,论文以预印本形式发布于2026年7月8日,编号为arXiv:2607.07769,发表于cs.LG(机器学习)领域,并将出版于2026年人工智能促进协会(AAAI)会议论文集。有兴趣深入了解的读者可以通过arXiv编号2607.07769查询完整论文。 深度强化
机器人编程侧重硬件组装与程序驱动,编程受限于特定机器人;少儿编程系统化教授编程知识,从Scratch启蒙延伸至Python、C++等高级语言。两者各有侧重,选择取决于希望孩子提升的能力方向。
少儿编程分为软件与硬件两大方向。软件编程侧重逻辑与代码能力,含图形化、Python、C++,适配学业竞赛;硬件编程侧重动手与工程实践,含乐高搭建与机器人。选择应基于孩子兴趣与年龄。

PHP-ML是纯PHP编写的机器学习库,需通过Composer安装,依赖PHP7.4以上及ext-gmp等扩展。phpEnv仅提供PHP环境,不直接支持安装。失败原因包括ext-gmp未启用、PATH未关联正确PHP版本、未初始化composer.json。启用gmp扩展、使用phpEnv的PHP执行composerinit和require即可解决。注意CL





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



