

韩国科学技术院:当机器人学会用"自己的眼睛"看世界
韩国科学技术院团队提出“机器人视角点图”,将摄像头图像转换为机器人自身坐标系下的三维坐标,消除视角变化影响。实验表明,该方法在随机摄像头视角下成功率仅下降0.3个百分点,而纯RGB方案下降9.6个百分点,在大型机器人模型上平均成功率提升7.6个百分点。
这项来自韩国科学技术院(KAIST)人工智能学院与Holiday Robotics公司合作的研究,于2026年7月以预印本形式发布,论文编号为arXiv:2607.11498。想深入了解的读者,可以直接用这个编号在arXiv上检索完整论文。
一、从一个让机器人困惑的难题说起
想象一下,你蒙着眼睛,别人用手机从不同角度拍了张桌上杯子的照片发给你,然后问你:杯子在你面前哪个方向、距离多远、你的手该往哪伸?
这对你来说几乎不可能。照片告诉你杯子长什么样,却没告诉你它在你身体坐标系里的确切位置。而现代机器人每天面对的,正是类似的困境。
目前最先进的机器人控制系统,学名是“视觉-语言-动作模型”(Vision-Language-Action Model,简称VLA)。你可以把它想象成机器人的大脑:它同时读取摄像头画面和人类发出的语言指令,然后决定机械臂下一步怎么动。但这里有个深层的矛盾:机器人的手臂是在以自身为中心的三维坐标系里运动的,可大脑看到的画面却来自摄像头——而摄像头通常被固定在旁边的架子或手腕上,它看世界的角度和机器人自身的角度完全不同。
这就好比,你坐在驾驶座上,却要靠副驾驶座位上的摄像头画面来判断方向盘该往哪打。如果摄像头固定不动,你虽然视角别扭,但至少每次画面和方向盘动作之间的对应关系是固定的,记住了就行。可如果每次开车,摄像头都被放在不同位置——有时在后排,有时在车顶,有时在引擎盖上——那你就得每次都重新摸索画面和方向盘之间的关系,极其困难。
现代机器人训练数据面临的正是这种“摄像头位置各不相同”的困境。为了训练一个通用的机器人,研究者们会收集来自世界各地的操作演示数据,而这些数据是用不同位置、不同角度的摄像头拍摄的。于是机器人大脑面临一个极其繁重的学习任务:不仅要学会如何完成任务,还要同时学会“从这个摄像头角度看到这个画面,对应的动作应该是什么;从那个摄像头角度看到相似画面,对应的动作又是什么”。
KAIST的研究团队提出了一个简洁而有效的解决方案,他们称之为“机器人视角点图”(robot-centric pointmap)。核心思路很直接:既然机器人的手臂是在以自身为中心的坐标系里运动的,那何不干脆把摄像头看到的世界也转换到这个坐标系里再喂给大脑?这样一来,不管摄像头放在哪里,机器人大脑看到的都是“以我自身为中心,目标物体在我的前方0.4米、左方0.1米、上方0.3米”这样直接明了的信息,而不是“从某个角度的摄像头画面里,那个东西在画面的左上角某个位置”这种需要大量转换的间接信息。
二、点图究竟是什么,它和普通照片有什么不同
要理解点图,可以先从普通照片和深度图说起。
普通RGB照片,就是手机拍出来的那种彩色图片,每个像素记录的是颜色信息:红色多少、绿色多少、蓝色多少。它告诉你每个位置“看起来像什么”,但完全不告诉你那个位置的东西“距离你有多远、在哪个方向”。
深度图是在此基础上的一步改进。现在很多机器人摄像头都是RGB-D摄像头(比如研究中用到的英特尔RealSense系列),可以同时拍摄彩色图像和深度图像。深度图的每个像素不记录颜色,而是记录该位置的物体距离摄像头有多远。这让机器人知道了“远近”,但问题是,这个距离是以摄像头为中心量的,跟机器人自身的坐标系还是不一样。
点云是更进一步的表示方式。通过深度图加上摄像头的内参(焦距、光心位置等参数,决定了像素和射线方向的对应关系)以及外参(摄像头相对于机器人基座的位置和角度),可以把每个像素对应的物体位置计算成机器人坐标系下的三维坐标,得到一堆散乱的三维点,称为点云。点云直接在机器人自身坐标系里描述了世界,是机器人动作所需要的信息格式,但它有个致命缺点:散乱的点集没有规则结构,无法直接被为处理图像而设计的神经网络使用,而且通常需要对原始数据进行下采样(只保留部分点),会丢失细节。
点图则综合了两者的优势,回避了各自的缺点。点图在外形上和普通图片一模一样,是同样高度乘以宽度的规则网格,每个“像素”的位置和原始彩色图片完全对应。但每个像素里存储的不是颜色,而是该位置对应的物体在机器人坐标系下的三维坐标,即x、y、z三个数值。
具体的计算过程分两步:第一步,利用摄像头内参和深度值,把每个像素“反投影”到摄像头坐标系下的三维点;第二步,再用摄像头外参(旋转矩阵和平移向量),把这些点从摄像头坐标系变换到机器人基座坐标系。这样,同一个物体上的某个点,不管从哪个方向的摄像头拍摄,在点图里存储的三维坐标都是一样的——因为它在机器人坐标系里的位置就是固定的。
这个性质极其关键。从摄像头A拍到的杯子某个角点,和从摄像头B拍到的同一角点,在各自的点图里存储的机器人坐标完全相同。这就彻底消除了摄像头视角变化带来的不一致性。
三、还差一步:以末端执行器为中心的精妙设计
研究团队在点图的基础上还做了一个额外的精妙处理:把整张点图再减去机器人末端执行器(也就是机械手的当前位置)的坐标,得到所谓“以末端执行器为中心的点图”。
为什么要这么做?可以通过一个场景来理解。假设机器人要完成的任务是“把杯子抓起来”,这个动作本质上是“把手移动到杯子所在位置”。在以机器人基座为原点的坐标系里,如果杯子在厨房水槽旁边,它的坐标可能是(0.4, 0.5, 0.3);如果杯子在微波炉旁边,坐标可能是(0.6, 0.1, 0.8)。尽管两种情况下机器人需要执行的是几乎一样的“手向目标靠近”动作,但以基座为中心看,目标物体的位置却完全不同,大脑需要分别记忆两种情况下的操作策略。
但如果改成以当前机械手位置为原点呢?当机械手已经接近杯子准备抓握时,不管杯子是在水槽旁还是微波炉旁,杯子相对于手的坐标都接近(0, 0, 0)——因为手就在杯子附近。这样,两种看似不同的场景在以末端执行器为中心的点图里看起来几乎一样,大脑只需要学会一种“手在目标附近时如何抓取”的通用策略。
研究团队用实验数据验证了这一设计的价值。以机器人基座为原点的点图,在固定摄像头评估时成功率是34.7%,换成随机摄像头评估时下降到32.7%,下降了2.0个百分点。而换成以末端执行器为中心后,固定摄像头时成功率提升到36.9%,随机摄像头时成功率是36.6%,几乎完全没有下降,只差0.3个百分点。这说明末端执行器中心化的点图对摄像头视角变化具有更强的鲁棒性。
四、如何把点图“喂”给已有的机器人大脑
解决了“点图是什么”的问题之后,研究团队还需要解决“怎么用”的问题。现有的VLA模型都是用普通RGB图片训练的,直接把点图塞进去不一定有效。
研究团队的解决方案巧妙地利用了点图与图片结构相同这一特性。他们为点图单独配备了一个图像编码器(神经网络模块,负责把图片转换成机器人大脑能处理的特征向量),这个编码器的架构和处理RGB图片的编码器完全相同,初始权重也直接复制自RGB编码器。然后,将点图编码出来的特征,与同位置RGB图片编码出来的特征,按照像素对应关系直接做加法叠加。
这个“加法融合”而非“拼接融合”的选择也很关键。如果把两套特征拼接在一起(即把点图特征排在RGB特征后面),那么点图特征和RGB特征就变成两个独立的序列,它们之间的空间对应关系就丢失了。而加法融合则让每个位置的RGB信息和该位置的三维空间信息直接叠加成一个统一的表示,保留了空间对应关系,也不增加任何额外的信息序列长度,对已有的VLA架构改动极小。
实验证明了这个设计的优越性。用加法融合的点图方法成功率是34.7%,用拼接融合的则下降到30.7%,相差4个百分点。
五、为什么不直接用点云,或者直接给机器人看摄像头参数
研究团队系统地比较了几种看似合理的替代方案,回答了两个关键问题。
第一个问题是:与其预先计算好三维坐标,不如直接把深度图和摄像头参数一起给机器人大脑,让它自己学会转换,是否可行?
研究团队测试了几种方案,从最简单的纯RGB图片(不给任何深度或摄像头信息)开始,逐步增加信息量。纯RGB成功率是27.9%。加上“普吕克射线”(一种把每个像素对应的三维射线方向和摄像头位姿编码进来的六维向量)后,成功率升至28.7%。再加上深度信息(此时大脑已经拥有计算点图所需的全部原材料),成功率提升到31.6%。而直接给机器人预计算好的点图,成功率则达到34.7%,比有相同原始信息但需要大脑自己转换的方案高出3.1个百分点。
这个对比说明,提供深度和摄像头参数作为线索是有帮助的,但直接把机器人坐标系下的三维几何预先计算好再输入,比让大脑自己从原始参数里推算效果更好。
第二个问题是:点图和点云都携带相同的三维信息,为什么要用点图而不直接用点云?
研究团队测试了两种点云方案:一种用简单的MLP(多层感知机,一种基础神经网络)处理1024个点,成功率只有24.2%,甚至低于纯RGB基准;另一种用专为三维点云设计的Point Transformer v3这个专业架构,成功率提升到32.8%,但仍然低于点图的34.7%。
差距的来源很清晰:点云不保留与RGB图片像素对应的规则网格结构,因此它编码出来的特征无法和RGB特征进行按位置对应的加法融合,只能用拼接方式,损失了空间对应关系。此外,处理点云需要专门的三维编码器,无法复用VLA已有的图像编码器的预训练权重,相当于从头学习,而点图编码器可以直接继承图像编码器的预训练知识。
六、随着摄像头位置越来越多变,点图的优势越来越大
研究团队做了一组精心设计的对照实验,直接量化了摄像头视角变化程度对两种方案的不同影响。
实验在RoboCasa这个机器人仿真平台上进行,设置了三个级别的摄像头随机化程度:完全固定(每次演示摄像头位置完全一样)、低随机化(每次演示摄像头位置和角度在5厘米、3度范围内随机浮动,对应RoboCasa默认设置)、高随机化(浮动范围扩大到10厘米、6度)。
结果形成了鲜明的对比。对于纯RGB方案,随着随机化程度从无到高,成功率从34.5%直线下滑到24.9%,跌幅高达9.6个百分点。而加入点图后,随机化从无到高,成功率只从37.6%小幅下滑到35.8%,跌幅仅1.8个百分点。当随机化为零(固定摄像头)时,两种方案的差距只有3.1个百分点;当随机化为高时,差距扩大到10.9个百分点。这直接证实了研究团队的核心假设:摄像头视角变化越大,点图的相对优势就越大。
七、在真正的大型机器人模型上的测试结果
上面的实验都在一个相对基础的架构上进行,目的是隔离变量、验证设计原则。在最终评估阶段,研究团队把点图方案移植到两个真正大型的预训练VLA模型上测试。
第一个是π0.5,这是一个在大量机器人操作数据上预训练过的大规模VLA模型。加入点图后,它在RoboCasa 24个任务上的平均成功率从55.3%提升到62.9%,在所有五个任务类别(开关门、开关抽屉、咖啡机操作、拿放物品、旋转物品)上都有提升,整体提升7.6个百分点。在最能体现精确空间判断能力的咖啡机任务中,某个子任务的成功率从46%跃升到76%,提升幅度非常显著。
第二个是SmolVLA,一个更轻量级的VLA模型,加入点图后平均成功率从37.2%提升到41.4%,提升4.2个百分点。
研究团队还将他们的方法与当时该领域的代表性对比方法进行了全面比较。这些对比方法分三类:专注于摄像头感知的VLA(OC-VLA和KYC)、附加了专用三维模块的VLA(GeoVLA和PointVLA),以及完全独立的点云策略(FP3)。所有使用π0.5底层架构的对比方法中,KYC(59.1%)和PointVLA(57.3%)是最强的,但两者都低于加了点图的π0.5(62.9%)。FP3作为一个完全不共享π0.5底层架构的独立三维点云方案,只达到42.8%,明显落后于所有基于π0.5架构的方法,说明大规模视觉语言预训练的知识迁移对机器人任务仍然很有价值。
八、在真实机器人上的验证,包括摄像头移到没见过的位置
仿真实验的结果再好,也需要在真实世界里验证。研究团队使用Franka Research 3机械臂进行了真实机器人实验,配备了一个固定在手腕上的D405深度摄像头,以及一个可以移动位置的外部D435i深度摄像头。
训练数据用三个不同的外部摄像头摆放位置各收集了15条演示,每个任务共45条,四个任务(拿放物体、叠积木、开抽屉、关抽屉)共180条演示数据。
评估时设置了两种场景:一种是把摄像头放在训练时见过的三个位置之一(称为“已见视角”),另一种是把摄像头移到一个训练时从未见过的位置(称为“未见视角”)。
在已见视角评估中,点图版π0.5平均成功率78.3%,比纯RGB版π0.5的73.3%高5.0个百分点,也高于从零训练的三维点云方法DP3的63.3%。说明在正常情况下,点图就已经是有帮助的。
更能说明问题的是未见视角的结果。当外部摄像头移到训练时没见过的位置,纯RGB版π0.5的成功率从73.3%骤降到55.0%,下降了18.3个百分点,受摄像头位置变化的影响很大。而点图版π0.5的成功率从78.3%降到66.7%,只下降了11.6个百分点。换算成两者之间的差距:在已见视角时差距是5.0个百分点,到了未见视角时,差距扩大到11.7个百分点。这说明越是在训练时没见过的摄像头视角下,点图的优势越大——这正是点图要解决的核心问题。
DP3这个三维点云方案也展现了三维信息对抗视角变化的一定效果:它从63.3%下降到48.3%,降幅是15.0个百分点,比纯RGB的18.3个百分点下降略少。但DP3整体成功率仍然明显低于点图版π0.5,说明图像形式的三维信息加上预训练VLA的组合,比单纯的点云方案更强。
九、这项研究有哪些局限,未来还能怎么改进
研究团队在论文中坦诚地指出了几个尚未解决的问题。
首先,点图需要精确的摄像头内参和外参(也就是摄像头本身的光学参数,以及摄像头相对于机器人的精确位置和角度)。在实验室或工厂环境中,这些参数可以通过精确的手眼标定来获取,但在更随意的日常使用场景中,标定可能不够精确或者难以实施,这限制了点图在那些环境中的应用范围。
其次,研究团队在点云对比实验中只使用了固定数量的点,没有测试用更多点是否能缩小与点图的差距。
再者,研究对摄像头变化的测试主要集中在摄像头位置和角度的变化上,没有测试摄像头数量变化或者视野范围变化的情况。
此外,研究没有系统探讨点图注入方式与VLA内部动作专家模块之间的相互作用,也没有深入分析点图与VLA预训练数据的最佳配合方式。这些都是未来可以继续深入的方向。
说到底,这项来自KAIST和Holiday Robotics的研究做了一件看似简单却切中要害的事:既然机器人在自己的坐标系里行动,就应该在自己的坐标系里观察世界。点图把摄像头画面和机器人坐标系之间那道始终存在的隔阂,在数据输入环节就提前弥合了,而不是让机器人大脑在学习过程中自己慢慢摸索怎么跨越这道隔阂。效果是实实在在的:在摄像头位置多变的训练环境下,任务成功率显著提升;更重要的是,当摄像头被移到训练时从未见过的位置,点图方法的性能下降幅度远小于不使用点图的方案。
这对机器人领域意味着一个清晰的原则:当摄像头标定信息可以获取时,应该先把观察数据转换到机器人行动所在的坐标系,再交给策略模型,而不是把这个转换的负担留给模型自己去学习。一个有趣的思考方向是:如果未来出现不需要精确标定、能从图像中自动估算三维坐标的技术,这套框架是否可以和那些技术结合,进一步降低对标定的依赖?这或许正是未来研究值得探索的路径。有兴趣深入了解这项研究所有细节的读者,可以通过arXiv编号2607.11498查阅完整论文。
Q&A
Q1:机器人视角点图和普通深度图有什么区别?
A:深度图记录的是物体距离摄像头的远近,坐标是以摄像头自身为中心的,当摄像头位置变化时,同一个物体的坐标值也会跟着变。点图则在深度图基础上进一步做了坐标变换,把每个像素对应的三维位置转换到机器人基座坐标系下表示,同一个物体不管从哪个摄像头拍摄,点图里存储的坐标值都是一样的。这个差别让点图在摄像头视角多变的情况下,能给机器人提供更稳定一致的空间信息。
Q2:点图方法需要额外添加专门的三维处理硬件吗?
A:不需要。点图本质上是一张和普通图片尺寸完全相同的“图像”,每个像素存的是三维坐标而不是颜色,它可以直接用和处理普通图片一样架构的神经网络来处理。研究团队的方案只是在现有的VLA模型旁边增加了一个图像编码器(初始参数还是从原有图像编码器复制过来的),对原有模型架构改动极小,不需要专用的三维点云处理硬件或者特殊的编码模块。
Q3:末端执行器中心化的点图在实际使用中需要实时知道机器人手的位置吗?
A:是的,需要。末端执行器中心化点图的计算方式是用机器人坐标系下的三维点坐标减去当前机械手的位置坐标,所以在每一时刻生成点图时,都需要知道机械手当前的位置。不过这并不是额外的负担,因为机械手的当前位置(本体感知信息)本来就是机器人控制系统会持续追踪并提供给策略模型的基础信息,获取它不需要额外的传感器或计算步骤。
认识AI Agent、Genie 4与机器人的区别:任务输入不等于完成结果,世界模拟不等于现实执行,装载机动作展示也不能替代完整工程验收。
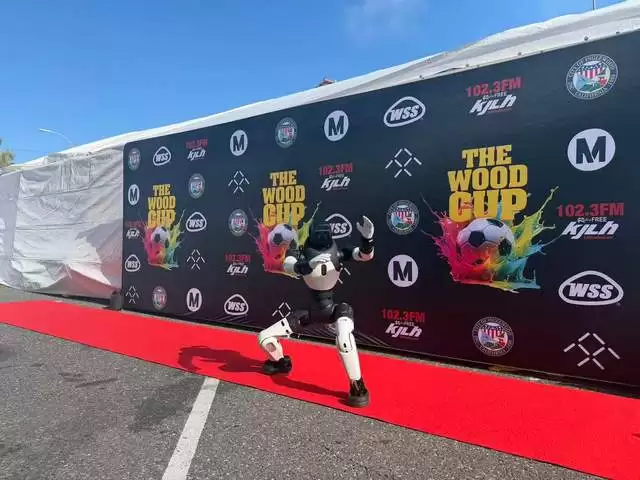
法拉第未来EAI机器人亮相洛杉矶世界杯庆典,被CBS报道,实现零广告费破圈。目前推出三大系列机器人,截至5月累计交付137台,年度目标上调至1500台。近期获7000万美元融资,将发布机器人教育生态战略,加速物理AI领域布局。
启元机器人加速线下布局,亚洲首店已在深圳卓悦中心设围挡,上海全球首店同步筹备,西安等地也在推进中。作为上纬新材在消费级具身智能领域的核心载体,其聚焦个人机器人赛道,研发投入同比增长超500%。
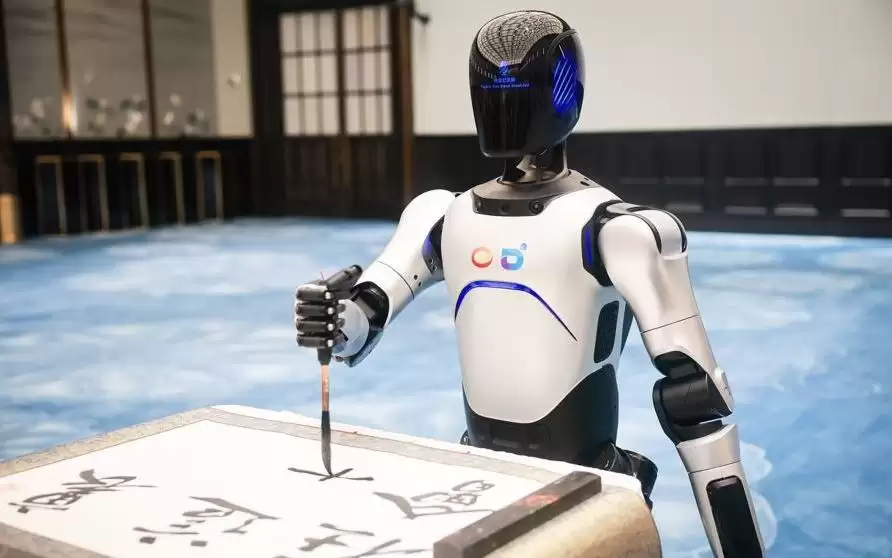
6月16日,世界会客厅迎来首位智能导览员——编号001的人形机器人正式上岗。它身高约1.7米,通体银白,可提供多语种讲解、智能引导与互动问答,致力于提升智慧化参观体验。同日,世界会客厅举办了年度品牌日暨首秀5周年纪念活动。
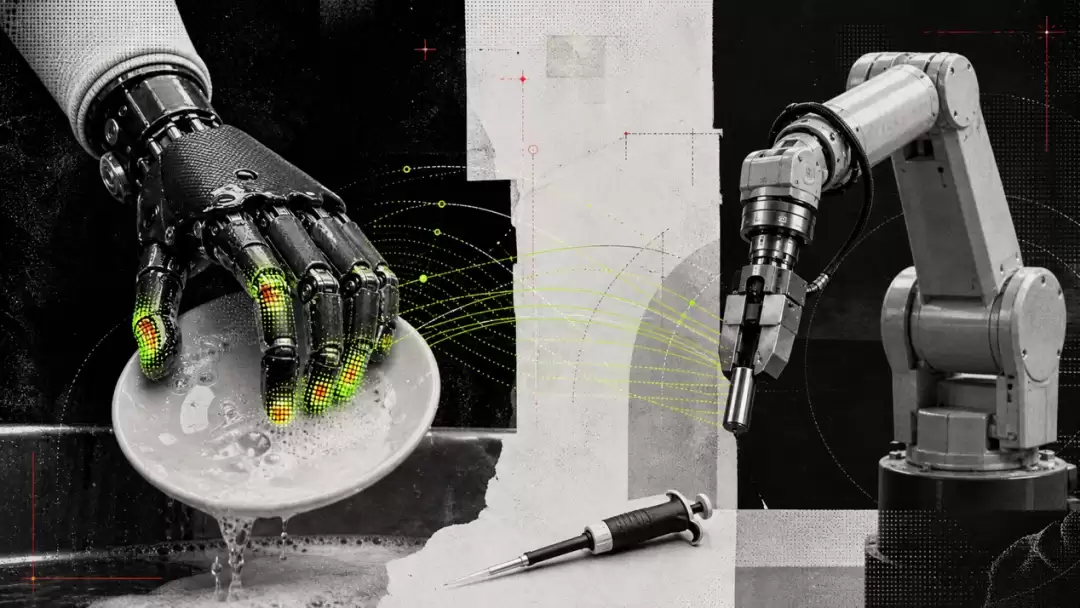
约300名截肢患者日常使用仿生手产生的触觉与运动数据,被PSYONIC用于机器人灵巧手训练,通过“真实到真实”迁移绕过仿真环节,将人类操控经验直接迁移至机器人。已与ABB、NVIDIA合作探索汽车制造等工业场景,但数据规模与可靠性仍需验证。
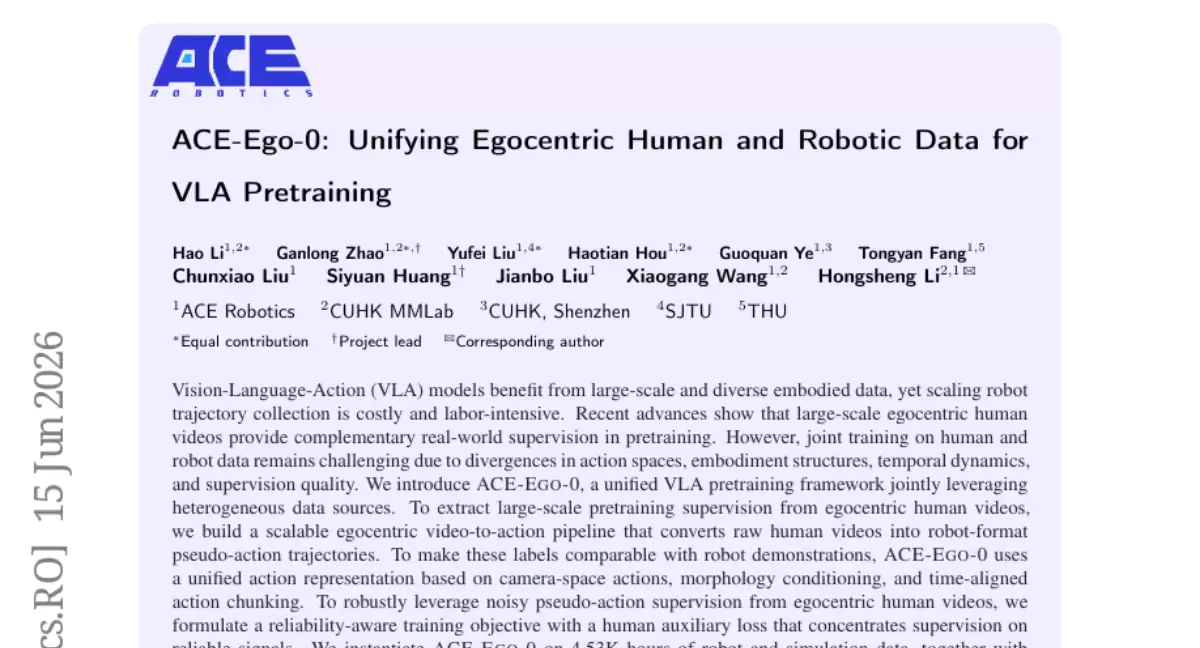
ACE-Ego-0框架将人类双手视频与机器人数据统一到头部摄像头坐标系,通过形态条件化和可靠性加权损失处理结构差异与噪声。在超6000小时数据上预训练,于仿真和真实双臂机器人测试中刷新多项基准,平均成功率72.8%,真实任务达78.3%。
暑期科技研学聚焦北京、上海、深圳、杭州,项目涵盖京东智能物流、小米汽车工厂、火箭制造、3D打印、机器人、无人机、航天及大飞机总装等,让孩子深入体验智能制造,实现沉浸式职业启蒙。
顺丰同城上线机器人末端运力,与肯德基“车速取”合作,实现即停即取。机器人独立承担门店与路边取餐点间短途接驳,替代店员跑腿,推动无人物流从室内走向室外场景,拓宽服务半径。
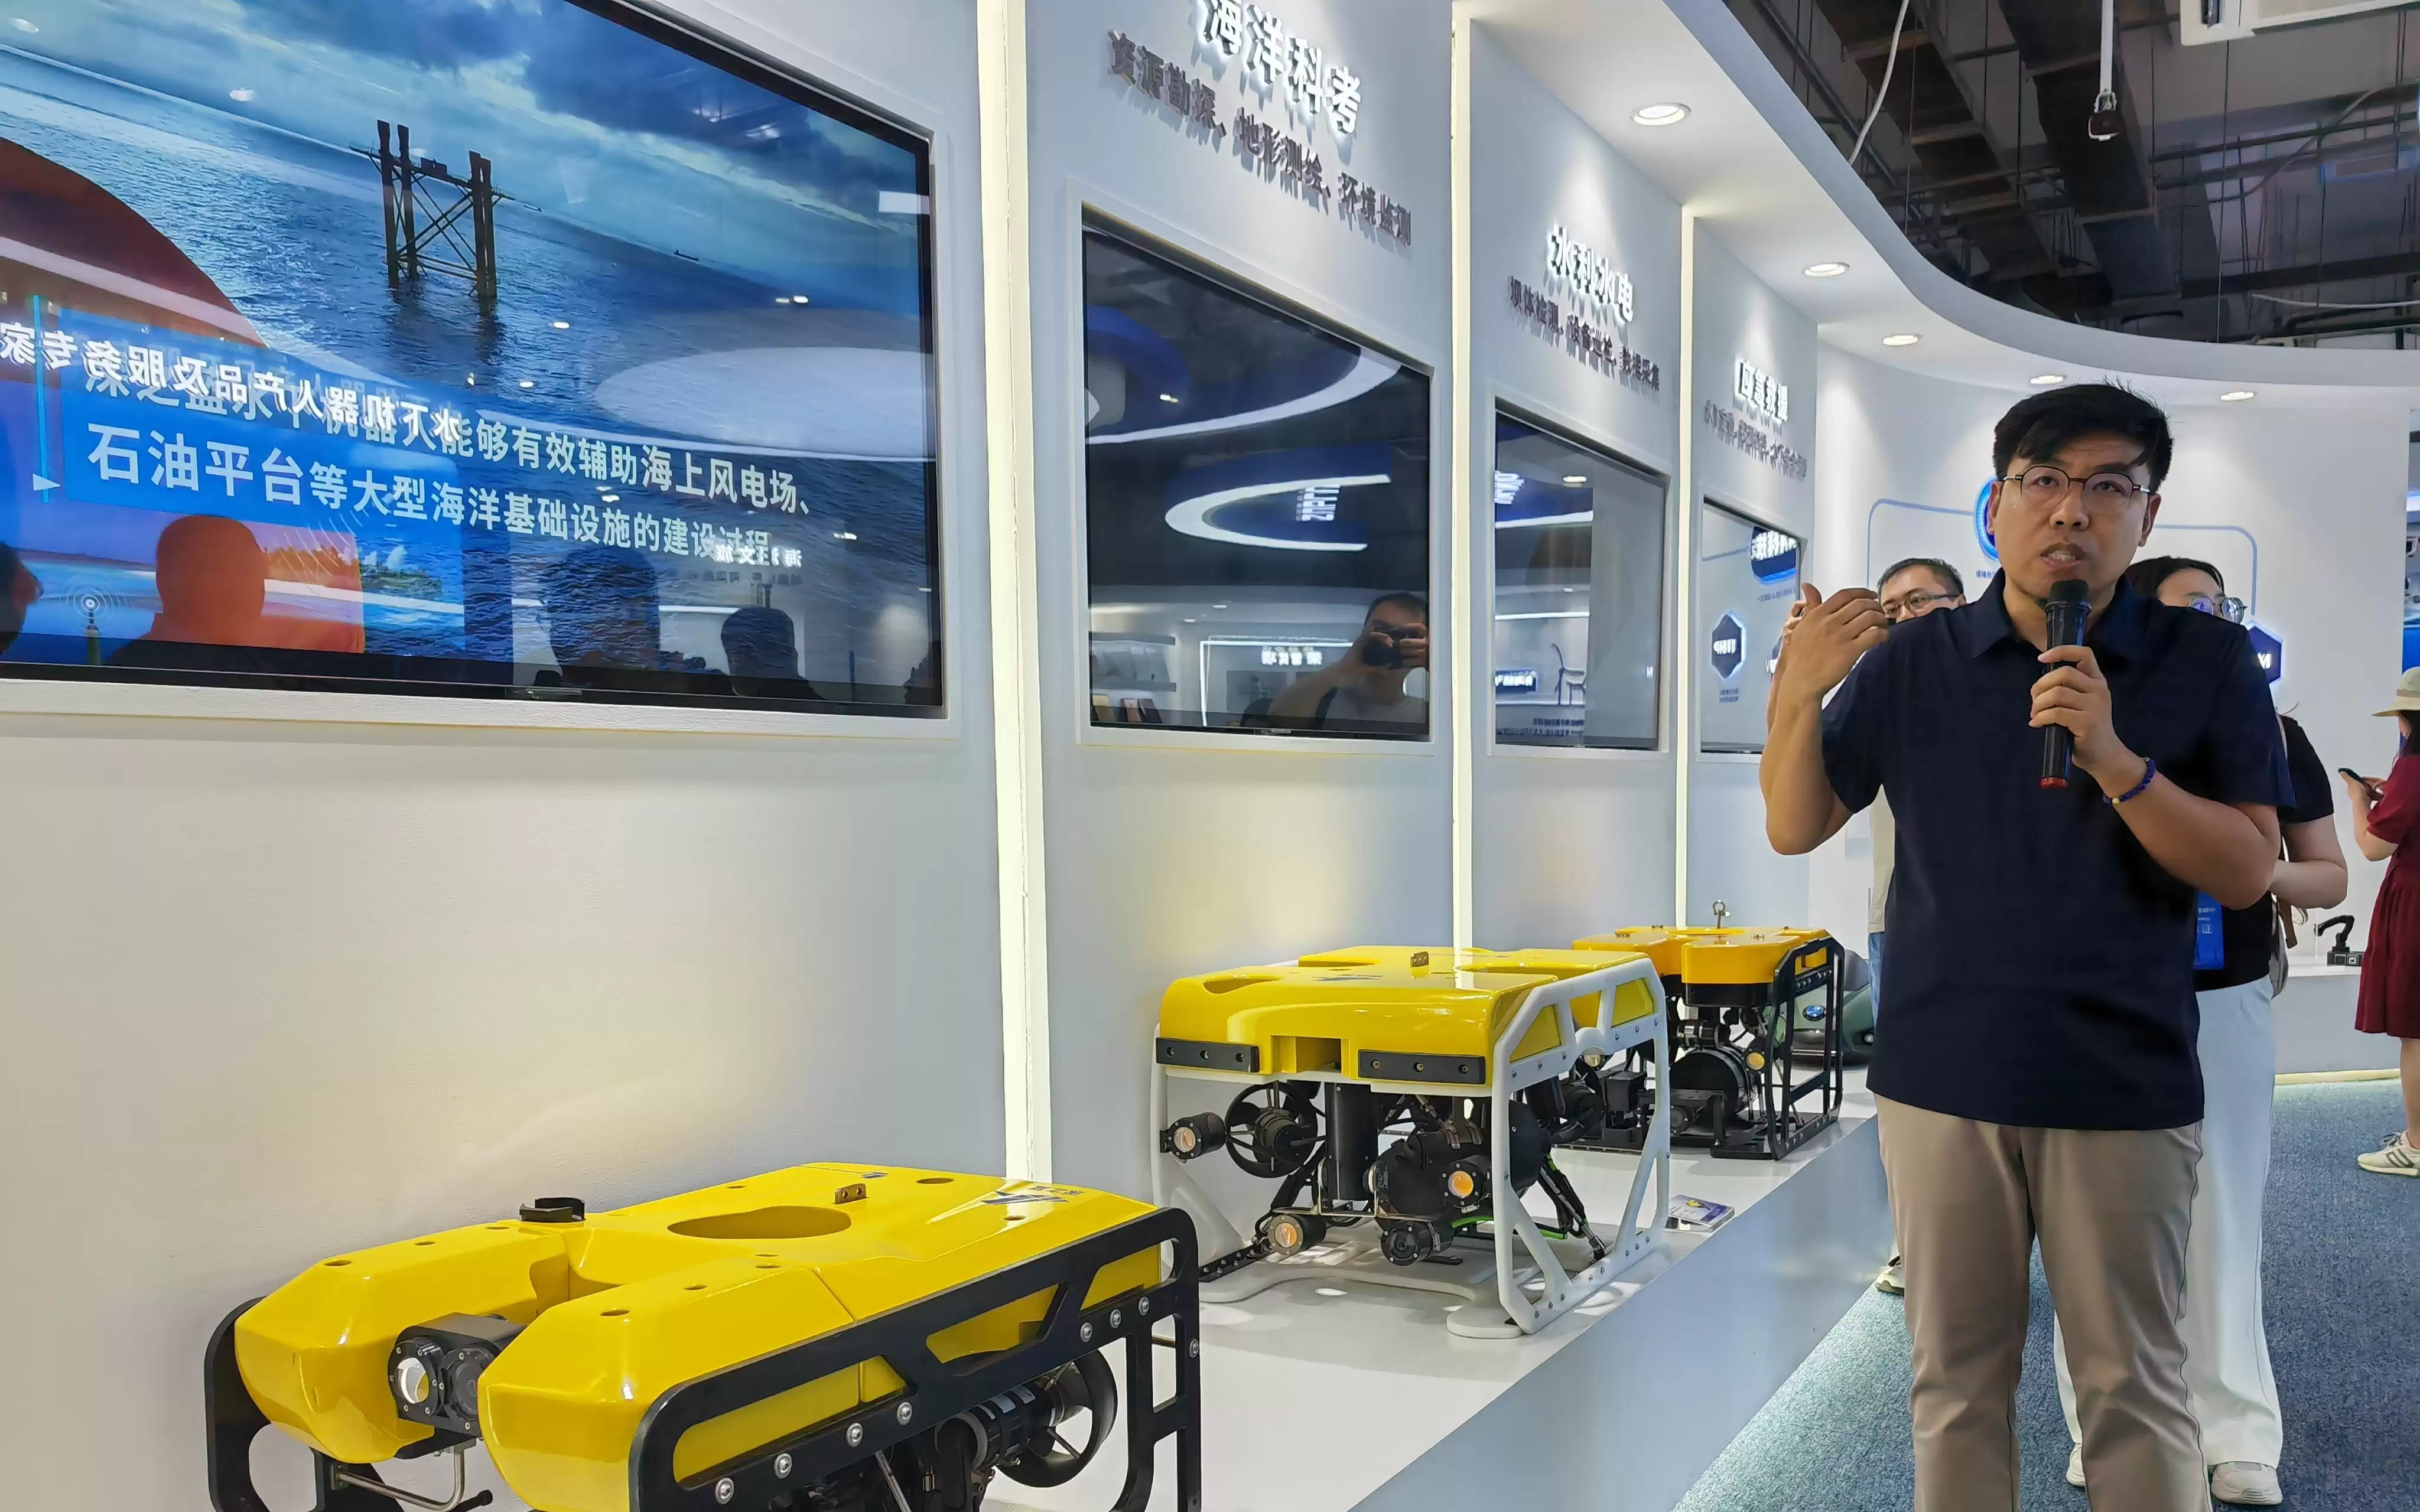
天津机器人产业加速爆发,水下助推器、高速分拣并联机器人及人形取货机器人等应用场景涌现。智能机器人已列重点产业链,前4个月规上企业产值同比增长12.8%,产业生态逐步构建。
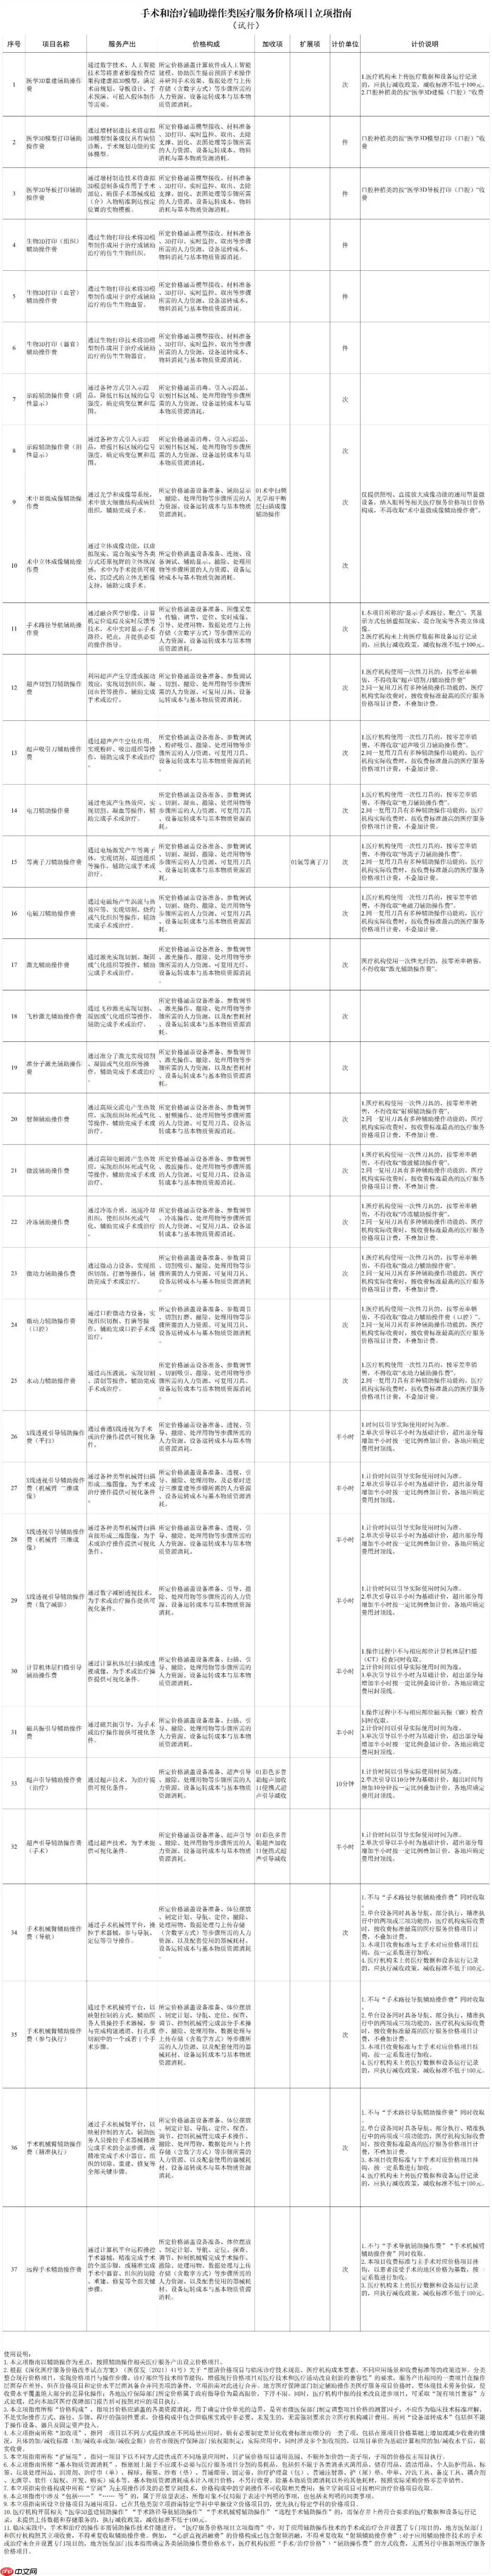
国家医保局发布指南,为3D打印、手术机器人、远程手术等辅助操作统一价格立项,按技术精度分类定价,鼓励用于高难度手术。机械臂耗材费用纳入定价,降低患者支出;首次设立远程手术辅助操作费;要求医疗数据及设备日志本地存储并实时上传,否则核减价格。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



