

东京科学大学造出了一个"懂语言"的语音AI
Air Explorer Pro是一款跨平台多网盘管理工具,可实现一站式完成不同网盘间文件的互传、搜索和同步等操作。任务管理和过程控制会更完整,持续下载、批量同步或需要稳定传输流程的场景会更适合它。
东京科学大学团队提出SylReg方法,让语音AI以音节为单位理解语言,通过说话人扰动和分块回归训练,使模型忽略嗓音特征并聚焦内容。实验显示,音节边界检测F1达72.2%,TED降至9.91%,有效解决了说话人主导问题。
最近,东京科学大学和日本国立情报通信研究机构联手搞了个大项目,研究结果已经挂到了arXiv上,编号是2607.04064。目前这篇论文正在IEEE期刊的审稿流程中,DOI预设为10.1109/XXXX.2024.1234567。有兴趣深入了解的读者,可以通过上面的编号直接去查原始论文。
你平时用AI语音助手,有没有想过一个事儿:它到底在“听”什么?是你说的话本身——那些词语和句子——还是你这个人?你的声音特质、说话的腔调?这个问题听起来有点哲学,但其实是当前语音AI领域一个非常棘手的工程难题。东京科学大学的研究团队花了很长时间琢磨这个问题,最后提出了一套新方法,让语音AI在理解语言内容时,能真正做到“只听内容,不辨其人”。
在深入了解他们的解决方案之前,咱们不妨先看看这个问题为什么这么重要。
一、语音和文字之间隐藏的“速度鸿沟”
人类说话的速度和写字的节奏完全是两码事儿。你打出“我今天去了超市”这句话,它只是一个短短的文字序列。但当你把这句话说出来,AI需要以每秒五十帧的速度去“听”每一个细微的声音片段,产生的数据量远远大于对应的文字。
这就好比你要把一段长达一小时的电影转换成一本薄薄的剧本——电影帧率很高,每秒24到30帧,但剧本只需要描述关键对话和动作。语音AI面临的,正是类似的“压缩”问题。
现有的语音AI,比如GPT风格的大型语言模型,是在文字上训练出来的。文字天然就是高度压缩的信息,一个词代表一个完整的意义单位。但语音的“词”——也就是语音学家说的音素(每个发音的最小单位,比如“猫”这个字拆开来就是声母“m”和韵母“ao”)——粒度太细,产生的序列太长,语言模型处理起来效率极低,而且和文字的颗粒度完全对不上。
为了解决这个“速度鸿沟”,研究者们想到了一个优雅的方案:何不让AI学会以“音节”为单位来理解语言?音节在中文里对应一个字,在英文里大概对应一个发音单元,比如“sub-mit”就是两个音节。音节比单个音素大,比单词小,正好处于一个“粒度适中”的甜蜜点。用音节作为基本单位,既能保留足够的语言信息,又不会产生过于冗长的序列。
这就是这篇论文要解决的核心任务:教会AI自动把连续的语音流,切割成一个个有意义的音节片段,并给每个片段贴上标签。这个过程叫做“音节化分词”(Syllabic Tokenization)。
二、前人的努力与意想不到的副作用
在这个研究团队之前,已经有人提出了一种叫SD-HuBERT的方法。要理解这个方法,得先知道HuBERT这个基础模型。
HuBERT是一种自监督语音表示学习模型,可以把它理解成一个经过大量语音数据“听力训练”的AI耳朵。它能把每一帧语音转换成一个数字向量,这个向量包含了那帧语音的声学特征。经过训练,HuBERT的向量在语音学上具有很强的意义——相似的发音会得到相似的向量。
SD-HuBERT在HuBERT的基础上,借用了一种来自计算机视觉的自蒸馏技术(DINO)。这种技术的思路是:让一个“学生模型”去预测一个“教师模型”的输出,教师模型是学生模型参数的滑动平均版本,更加稳定。通过这个过程,SD-HuBERT能让模型在内部自发地把连续语音帧“组织”成音节状的块状结构。
这个技术最初在图像识别里展示了一个神奇现象:用类似的方法训练视觉模型,模型会自动学会把图像分割成有意义的区域,比如把一张猫的照片自动分割出头部、身体、背景。SD-HuBERT把这个思路搬到语音上,期望模型也能自动识别音节边界。
从实验结果来看,SD-HuBERT确实让语音的内部表示出现了块状结构,音节边界检测效果也比原始HuBERT好了不少。
然而,研究团队在深入分析时发现了一个令人头疼的副作用。他们测量了一个统计指标——说话人身份与模型预测类别之间的互信息(可以理解为“模型的预测结果在多大程度上泄露了说话人是谁”)。结果显示,这个值高达0.61,接近满分1.0,意味着模型预测的类别有六成以上的信息量其实来自说话人身份,而不是语言内容本身。
这意味着什么?假设你和你的朋友李明说完全相同的一句话“今天天气不错”,SD-HuBERT对你们两人的音节切割结果可能会不一样——不是因为你们说的内容不同,而是因为你们声音不同。这对于一个应该关注“说了什么”的语言模型来说,是一个严重的污染。
研究团队把这个问题称为“说话人主导问题”——模型的注意力被说话人特征劫持了。
他们认为这个问题的根源在于SD-HuBERT的训练方式:它用一整个句子的全局表示来做分类预测。而一个人在整句话中的声音特征——音调、语速、音色——是基本不变的,这些全局统计特征天然就是说话人身份的强烈信号。模型学着用这些信号来做预测,反而忽略了局部变化的语言内容。
此外,SD-HuBERT还存在另一个叫“有效原型坍塌”的问题。模型有2048个分类类别,但实际上只有大约32%的类别会被激活使用,大量类别变成了“僵尸”。这就好比一个有一百个抽屉的柜子,实际上只往三十二个抽屉里放了东西,剩下的全是空的——空间利用率极低,而且把不同语言内容的句子塞进同一个类别会产生混淆,损害音节表示的质量。
三、一个聪明的解题思路:让AI学会“忽略嗓音,只听内容”
研究团队提出的解决方案叫SylReg,全称“音节化分块回归”(Syllabic Tokenization via Chunk-wise Regression)。这个名字拆解开来很好理解:音节化是目标,分块是操作手段,回归是训练方式。
核心思路可以用一个生动的类比来理解。假设你是一位音乐课老师,你想教学生识别不同的乐器——钢琴、小提琴、长笛——而不是识别是谁在演奏。为了训练学生的辨别力,你不让他们听同一个演奏者的同一段音乐,而是让他们把不同演奏者演奏相同乐段的两个版本进行对齐匹配。这样,学生就必须关注音乐本身的结构,而不是演奏者的个人风格。
SylReg做的事情与此异曲同工。在训练时,模型同时接收两段语音:原始语音和经过声音变换的语音(相当于“换了一个人来演奏同一段音乐”)。声音变换采用了一种叫“说话人扰动”的技术,通过调整共振峰(影响元音音色的关键频率)和音调,把男声转换成女声,或者把女声转换成男声。研究团队做了一个重要的改良:不是随机乱变,而是只做男女互换,并根据每段语音的平均音调来判断性别——均值音调超过155Hz就认为是女声。这样做是为了保证变换后的语音听起来仍然自然,而不是频率乱跳的怪声。
原始语音送给“教师模型”,变换后的语音送给“学生模型”。学生的任务是:尽管输入的声音特征已经改变了,但仍然要产生和教师尽可能相似的内部表示。这就迫使学生必须提取声音变换前后不变的东西——也就是语言内容,而不是说话人特征。
更关键的是“分块”这个设计。之前提到的帧级回归(C=1,每帧都单独匹配)虽然也能去除说话人信息,但粒度太细,没有给模型足够的上下文来理解音节层面的结构。而全局匹配(把整句话压缩成一个向量)又走向了另一个极端,重新引入了说话人主导的问题。
SylReg采用了一个中间方案:把语音分成固定长度的“块”(Chunk),每块包含C=100帧(默认值)。对每个块进行平均池化后,再进行回归匹配。这个块大小大约对应2秒左右的语音,覆盖几个音节的长度,恰好处于“能感知音节层面结构”的合适颗粒度。
在训练框架上,SylReg沿用了BYOL(Bootstrap Your Own Latent)的设计:有学生和教师两套模型,教师参数是学生参数的指数移动平均,训练时只更新学生,教师自然跟随。损失函数是l2归一化后的均方误差(MSE),相比分类交叉熵,回归目标天然避免了有效原型坍塌的问题。
模型结构方面,SylReg在预训练好的HuBERT Base基础上进行微调。借鉴了前人的发现,去掉了HuBERT后三层Transformer层(这三层被证明会阻碍模型学习音节级别的粗粒度表示),保留前九层。在学生侧额外添加了投影头(Projector)和预测头(Predictor),都是两层MLP,隐藏维度2048,输出维度256。CNN特征提取层在训练中保持冻结,只更新Transformer层及投影/预测头。
训练在四块NVIDIA A6000 GPU上进行,共10000步,使用AdamW优化器,批次大小1024,学习率0.0001。前2000步只更新随机初始化的投影和预测头,让这两个新模块先适应HuBERT的特征,之后再解冻Transformer层进行联合微调。
四、从声波到音节标签:三步完成切割和编码
训练好的SylReg模型,它的内部表示已经自发地呈现出块状音节结构——用数学语言说,就是特征向量之间的自相似矩阵呈现出块对角形状,块与块之间的边界正好对应音节边界。这一点可以从论文中的Figure 1看出:原始HuBERT的自相似矩阵是连续平滑的,SD-HuBERT稍有块状但不清晰,而SylReg的矩阵呈现出非常清晰的块状对角结构,红线标注的真实音节边界与块的边界高度吻合。
有了这样的内部表示,如何把它转换成实际的音节标签呢?研究团队采用了一个三步流程。
第一步是音节边界检测。给定语音帧特征序列,计算帧间自相似矩阵,然后用最小割算法(Minimum Cut Algorithm)把这个矩阵分割成M个片段,M的值根据语音时长和预设的最高音节帧率(6.67Hz)来确定。为了处理语速较快的情况,先做适度过分割,然后把余弦相似度超过阈值τ的相邻片段合并,最终达到大约6.25Hz的音节帧率(也就是平均每个音节约160毫秒)。
第二步是片段级平均池化。找到边界后,对每个音节片段内的所有帧特征做平均,得到一个代表该音节的向量。
第三步是两阶段聚类编码。先用K-Means聚类(24576个中心点,50轮迭代,5次随机初始化取最优)得到细粒度的中心点,再用层次聚类(凝聚聚类)把这24576个中心点进一步合并成8192个最终类别。每个音节片段被分配到最近的类别中心,得到一个离散的标签编号——这就是音节token。
五、蒸馏升级版:SylReg-Distill,用更好的“耳朵”
SylReg本身的音节边界检测已经相当不错,但研究团队注意到,另一个预训练模型data2vec 2.0的特征表示在音节聚类质量上比HuBERT更好——用data2vec 2.0提取的特征做聚类,同一个音节的帧会更集中在同一个类别,不同音节之间的区分度也更高。
于是他们设计了一个两阶段流程:先用SylReg切割出音节边界,然后把这些边界作为“伪音节标注”,用它来训练一个以data2vec 2.0为骨干的新模型,这个过程叫做“自分割蒸馏”(SylBoost)。得到的模型叫做SylReg-Distill。
自分割蒸馏的具体过程相当精妙。教师模型(data2vec 2.0)提供帧级特征,然后在每个伪音节片段内做平均,得到片段级表示作为回归目标。学生模型(同样以data2vec 2.0初始化并去掉最后一个Transformer层)则接收说话人扰动后的语音,任务是让每一帧的输出逼近该帧所在音节片段的平均表示。这样,学生模型被迫把同一音节内的所有帧“拉向”同一个表示,从而强化音节内的聚合性和音节间的可分性。
这个蒸馏过程分五个阶段迭代进行:第一阶段200步,后续四个阶段各50步。每个阶段结束后,学生模型的参数直接复制给教师,教师用新的参数重新切割和平均,产生更精准的回归目标,供下一阶段使用。这种迭代自精化的设计,让音节结构逐步收敛到更准确的形态。
去掉了data2vec 2.0的最后一层Transformer层,SylReg-Distill使用第11层(倒数第二层)的特征做音节表示,而SylReg本身使用第8层(倒数第二层,因为SylReg只保留了9层)。
六、实验结果:数字背后的故事
研究团队在LibriSpeech(一个大规模英文有声书数据集,包含来自数百个说话人的数千小时录音)上进行了全面的评估。
在音节边界检测方面,评估指标包括精确率(Precision,检测到的边界有多少是真实边界)、召回率(Recall,真实边界有多少被检测到了)、F1分数(两者的调和平均)以及R值(一个同时惩罚过度分割和漏检的综合指标)。SylReg以60.3%的精确率、89.8%的召回率、72.2%的F1分数取得了相当亮眼的表现,R值达到54.1。相比于原始HuBERT(F1仅58.7%,R值39.1),提升非常显著。
在音节token质量方面,研究团队用三个指标来衡量:音节纯度(SP,一个token里面大多数帧属于同一个真实音节的程度)、聚类纯度(CP,同一个真实音节的帧大多落入同一个token的程度)和音节归一化互信息(SNMI,token与真实音节之间信息共享的程度)。SylReg在同等词汇量(4096)下,SP达到70.5%、SNMI达到86.0%,均高于SD-HuBERT(SP 54.1%,SNMI 73.4%)。
另一个直观的指标是TED(Token Edit Distance,token编辑距离)——把同一段话的原始语音和说话人扰动后的语音都做音节化,然后比较两个token序列有多不同。如果一个模型真的在学语言内容,那么同一段话无论谁说,产生的token序列应该差不多;如果模型其实在学说话人特征,则两个序列会有较大差异。SylReg的TED为9.91%,而SD-HuBERT高达19.4%——差了整整一倍。这有力地证明了SylReg的音节token确实更关注语言内容,而非说话人特征。
SylReg-Distill在词汇量8192的设置下进一步提升了各项指标,F1达到74.7%,SP 79.5%,SNMI 91.5%,TED降至7.66%,全面超越同类的SylBoost模型。
七、消融实验:每一个设计选择都有它的道理
研究团队还做了一系列细致的消融实验,逐一验证每个设计选择的必要性。
用DINO替换BYOL(回到分类损失而非回归损失)后,所有指标均有所下降,F1从72.2%降至68.9%,TED从9.91%升至11.9%,这验证了BYOL+MSE比DINO+交叉熵更适合这个任务。同时确认了只有32%的softmax类别被激活,印证了有效原型坍塌的存在。
去掉说话人扰动后,TED进一步升至13.9%,说明说话人扰动是降低说话人依赖的关键机制。而用随机扰动替换针对性的男女互换扰动,各项指标也有一定下降,证明了有约束的扰动设计比随机扰动更有效。
关于块大小C的选择,研究显示边界检测性能随C增大单调提升,在C=100时基本饱和。但token纯度(SP和SNMI)在C=20时就达到峰值——C=20大约对应90分位数的音节时长,再往上则略有下降。C=1(帧级)和全局池化(C=T)都比中间值差,这说明恰好在音节时长量级上做分块是取得最佳效果的关键。这个现象直观上也很好理解:块太小,模型没有足够上下文感知音节结构;块太大,又重新引入了说话人特征的污染。
从训练动态来看,10000步时召回率达到峰值,整体F1在12000步后开始下降,自相似矩阵也开始从清晰的块状结构向均匀分布退化。因此10000步是防止表示坍塌的合理训练步数。
对各层特征的分析显示,第8层Transformer的召回率最高,第9层精确率最高但召回率略低,综合考虑选择第8层用于音节化。第9层的精确率则可以在后续的自分割蒸馏阶段进一步提升。
八、从音节标签到会说话的语言模型
有了高质量的音节token,研究团队进一步构建了一个完整的语音语言模型系统SylReg-LM,验证音节token在下游任务中的价值。
语音语言建模的训练策略借鉴了SpiRit-LM的“交错训练”思路。SpiRit-LM的核心创意是:不把语音和文字模型分开训练,而是在同一个语言模型里,把语音token和文字token交错混合。比如,一段话可以被编码成“Surely(文字)〈67〉(音节token)we(文字)〈317〉(音节token)can(文字)”这样的混合序列。这样,模型在学习语音理解时,也能同时从文字中获取语义知识,实现知识迁移。
SylReg-LM在Qwen2.5 7B这个大型文字语言模型的基础上进行继续训练,扩充了词汇表以包含音节token,训练数据包含129000小时的英文语音(LibriSpeech、Librihea vy、Emilia-Large等多个数据集),以及文字数据(Cosmopedia v2,用于防止灾难性遗忘)。语音token和文字token的采样比例约为3:3:4(语音独立、文字独立、交错混合),音节token的采样概率约为0.3(其余选文字)。
在理解能力评估上,研究团队使用了三类测试:sWUGGY(词汇测试,判断真实词汇与伪词汇的可能性高低,考察词汇知识)、sBLIMP(句法测试,判断语法正确句子与错误句子的可能性高低,考察语法知识)、StoryCloze(语义测试,从两个结局中选出正确的故事结局,考察常识理解)。
SylReg-LM 7B在sBLIMP上得分63.2%,spoken StoryCloze得分67.1%,topic StoryCloze得分85.4%。相比SpiRit-LM(sBLIMP 58.3%,spoken StoryCloze 61.0%,topic StoryCloze 82.9%),在语法和语义理解上实现了平均7%的相对提升。在计算量上,SylReg-LM 7B使用了约1.3×10^18 FLOPs(浮点运算次数),远低于SpiRit-LM的4.0×10^18 FLOPs,效率优势显著。
有一个有趣的细节:SylReg-LM在词汇层面的sWUGGY测试上并不如预期——分数略低于SyllableLM。这说明音节化方法的改进主要体现在高层语言理解(语法、语义)上,而不一定能同步提升细粒度的词汇辨别能力。研究团队坦诚地指出,语音合成训练数据(TinyStories通过TTS合成)可能是SylReg-LM 7B在sBLIMP上较85M版本略低的一个原因,因为合成语音有时会影响模型对自然语音句法的感知。
九、让AI把音节“变回”语音:合成实验的发现
研究团队还训练了一个从音节token合成语音的系统,验证这些离散token保留了多少语音内容信息。
合成系统采用了条件流匹配(Conditional Flow Matching)框架下的扩散Transformer(DiT)架构,配合BigVGAN-v2声码器(把梅尔频谱转换成波形的神经网络)。系统以音节token作为输入,经过长度调节器(预测每个音节对应的帧数)展开后,通过DiT生成梅尔频谱,再由声码器还原为语音波形。
在LibriSpeech测试集的重合成评估中,SylReg-Distill系统的字符错误率(CER)为2.53%,词错误率(WER)为5.46%,UTMOS感知质量评分达到4.31分(满分5分)。对比基准TWIST(基于音素token的合成系统,CER 2.59%,WER 5.65%,UTMOS 3.85),SylReg-Distill在错误率上持平甚至略优,在音质上则明显更好——尽管SylReg-Distill的token比特率(76.8 bits/s)仅为TWIST(174.8 bits/s)的44%,也就是用更少的信息量实现了相当甚至更好的语音质量。
另一个发现是,SylReg-Distill系统对背景噪声有很强的鲁棒性,能从包含雨声等环境噪音的语音中重合成出干净的语音。这可能是因为音节token只保留了语言内容相关的信息,过滤掉了噪声成分。
从不同方法的对比来看,Sylber系统(基于连续特征,比特率理论上无限大)有最低的错误率,但这是以不做离散化为代价的。在做了离散化的系统中,SylReg-Distill的表现是最好的。
说到底,这项研究做了一件看似简单实则困难的事:它教会了AI学会“忘记”说话的人,只记住说话的内容。这不是一个孤立的技术突破,而是语音AI走向真正语言理解的一个重要环节。
归根结底,语音AI要真正“听懂”人说话,不能只是在声音表面打转——识别出这是男声还是女声,或者这段话出自哪个说话人——而是必须穿透声音的物理特性,理解其中承载的语言结构。东京科学大学的这套SylReg框架,通过强制性的说话人不变训练和恰当粒度的分块匹配,在这个方向上迈出了一步。音节token的编码效率和语言纯洁度,使得下游的语言模型训练更加高效,也更能捕捉到语法和语义层面的抽象结构。
当然,研究团队也坦诚地指出了未来的方向:如何在保持语言纯净度的同时,也纳入音调、情感等表达性信息;如何把这套框架扩展到多语言场景;以及如何在更大规模的数据和模型上继续探索。这些都是开放的问题,也是这个领域持续演进的动力所在。如果你对完整的技术细节感兴趣,可以通过arXiv编号2607.04064找到原始论文。
Q&A
Q1:SylReg方法和SD-HuBERT方法有什么本质区别?
A:SD-HuBERT用整句话的全局表示来做分类预测,这导致模型容易学到说话人的声音特征而非语言内容,而且分类类别大量闲置。SylReg改用固定长度块的回归匹配方式,同时强制学生模型对原始语音和变声后的语音产生相近的表示,从而迫使模型关注声音不变的语言内容部分。简单说就是:SD-HuBERT听整句话猜类别,SylReg分块比对内容、忽略音色差异。
Q2:音节化分词对语音AI的实际应用价值体现在哪里?
A:语音AI通常基于文字预训练的语言模型来理解语言,但语音的信息密度比文字低很多,帧率高达每秒50帧,而文字一个词才算一个单位。音节处于两者之间的粒度,用音节token代替音素token可以把序列长度大幅压缩,减少计算量,同时让语音和文字的粒度更匹配,便于知识迁移。SylReg-LM的实验证明,基于音节token的语言模型在语法和语义理解上比基于音素token的模型好约7%。
Q3:SylReg的块大小C为什么选100帧而不是其他值?
A:研究团队做了系统实验,测试了C从1到整句话长度的各种取值。结果显示,边界检测精度随C增大而提升,在C=100时基本饱和。而token纯度在C=20左右达到峰值,C=20约对应90%音节时长的上限。C=100在边界检测和整体性能上取得了最好的综合表现。过小的C(如C=1,帧级)缺乏上下文无法感知音节结构;过大的C(如整句)重新引入说话人全局特征的污染。C=100是二者之间的工程折中点。
发现显卡风扇不转先别慌,这很可能是正常的智能启停功能。本文详解如何区分待机静音与硬件故障,提供从软件检测到物理清理的完整解决思路。
笔记本加装新内存后遇到黑屏或无法开机?不要慌张,本文通过重新插拔、清洁金手指、单根测试等具体操作步骤,帮你快速判断是安装失误还是硬件不兼容,并给出相应解决办法。
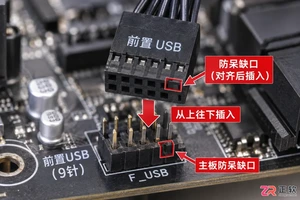
针对电脑主机前置USB接口无法识别设备的问题,本文提供一套基于因果逻辑的排查流程。涵盖检查机箱内部USB针脚连接、验证BIOS中USB控制器状态、更新芯片组驱动以及排除供电不足等常见原因,帮助用户快速恢复接口功能。
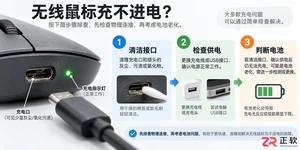
遇到无线鼠标充不进电的问题,不要急于更换设备。本文详解从清理接口氧化层、更换数据线到检测电池电压的完整排查流程,帮助你判断是临时故障还是硬件损坏。
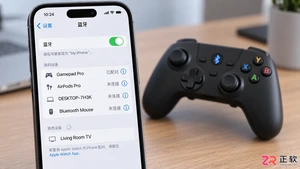
想知道如何用蓝牙手柄玩吃鸡游戏?本文详细讲解手机蓝牙手柄的连接步骤、主流映射软件的使用方法以及实战中的键位布局技巧,助你提升射击手感,同时解析外设玩家的匹配机制与注意事项。
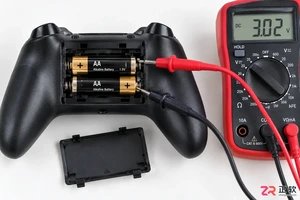
本文深入分析游戏手柄蓝牙频繁断开且需重连的根本原因,涵盖电池电压检测、操作系统电源管理策略及驱动冲突。通过具体的系统设置调整和固件更新步骤,解决蓝牙握手失败问题,恢复手柄的稳定连接状态。
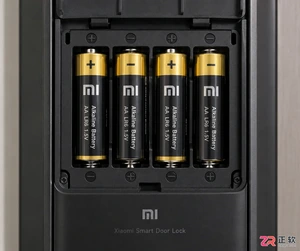
小米智能门锁更换新电池后无法开机或屏幕不亮?本文详解电池极性检查、金属触点清洁及强制重启方法,帮你快速解决供电问题,让门锁恢复正常使用。
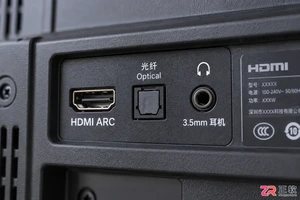
想让电视声音更震撼?本文详解如何通过HDMI ARC、光纤、蓝牙和3.5mm接口将电视连接至外置音响,包含具体设置步骤与常见问题排查,助你轻松打造家庭影院。




WPS Office是一款面向macOS用户的综合办公套件,将文字处理、电子表格、演示文稿、PDF工具、模板与云协作整合在同一应用中。它兼容常见Microsoft Office格式,支持Intel及Apple芯片Mac,基础功能可免费使用,

Shapr3D是一款面向工业设计、机械工程、建筑概念和三维打印工作流的CAD软件。Mac版采用Parasolid建模内核,支持草图约束、实体建模、工程图、可视化渲染及常见CAD格式交换,并可通过账户在多台设备之间同步项目。

REAPER是Cockos开发的数字音频工作站,提供多轨音频与MIDI录制、剪辑、处理、混音和母带制作工具。Mac版兼容Intel与Apple芯片,支持AU、VST、VST3、CLAP等插件格式,并提供高度可定制的工作流程。

Adobe Photoshop 是面向摄影师、设计师和内容创作者的专业图像处理工具,可在 Windows 上完成照片修饰、选区抠图、图层合成、文字排版、绘画及生成式编辑。软件采用订阅授权,由 Creative Cloud 管理安装、更新与许

Adobe InDesign 是面向印刷与数字出版的专业页面排版工具,可制作书籍、杂志、宣传册、海报、交互式 PDF 和电子书。它提供精细的文字样式、多页面管理、印前检查及多格式输出能力,并能与 Photoshop、Illustrator

Adobe Illustrator 是用于绘制矢量图形、插画、图标、徽标和版式的专业设计工具。它以路径和锚点为核心,作品放大后仍能保持清晰,并提供画板、文字、渐变、图像描摹及精确变换等功能,适合品牌视觉、印刷物料、数字界面和商业插画创作。