

为什么"老方法"在高维数据搜索中反而越来越好用?
多探针网格搜索在高维数据搜索中展现出独特优势:维度增加时性能退化比其他方法更温和,索引建立仅需数秒,远快于图搜索方法。该算法将候选查找与精确评分解耦,在索引频繁更新的场景中具有显著竞争力。
这项由加州大学伯克利分校、多伦多大学圣乔治校区、卡内基梅隆大学及滑铁卢大学等多所机构研究人员共同完成的研究,发表于2026年7月1日的HiLD 2026(第四届高维学习动态研讨会),论文编号为arXiv:2607.01283v1。有兴趣深入了解原始研究的读者,可通过该编号在arXiv平台查阅完整论文。
**当图书馆的书越来越多、书架越来越复杂,你该怎么找书?**
假设你管理着一座不断扩张的图书馆,馆藏书籍数量从几千本增长到几百万本,而每本书的"描述标签"也从十几个变成了两百个。你的任务是:每当读者说出一个大致需求,你要在几毫秒内找出最符合需求的十本书。
这就是"近似最近邻搜索"(Approximate Nearest Neighbor Search,简称ANN)要解决的问题。在真实的机器学习系统里,这个"图书馆"可能是一个存储了数百万条词语含义的数据库,每条记录都用一串数字向量表示;读者的"需求"则是一个查询向量;而"找书"的过程,本质上是在高维空间里找到最靠近查询点的几个数据点。
实际上,ANN搜索不只用于检索。最近几年,研究人员发现大型语言模型(比如ChatGPT背后的Transformer架构)里的"注意力机制",在数学本质上也是一种ANN操作——模型在处理文字时,需要快速找到上下文中最相关的词语。因此,ANN算法效率的提升,直接关系到这类大模型运行的速度和成本。
然而,当这座图书馆的规模和复杂度同时增长时,麻烦就出现了。现有的主流搜索方法——不论是基于图结构的、树结构的,还是分区分块的——在数据量(N)增大或者标签维度(d)增高时,都会以不同方式出现性能下降。研究团队发现,在所有这些方法的大规模对比测试里,有一类古老的方法几乎从未被认真纳入现代性能分析:基于网格划分的方法。
研究团队的核心问题是:这种看似"过时"的网格搜索方法,在数据量和维度同时变化时,究竟表现如何?它是否存在某些被忽视的优势?
一、什么是"多探针网格搜索"?把图书馆分成格子来找书
要理解这个研究,首先得搞清楚网格搜索是怎么运作的。回到图书馆的比喻——传统的网格搜索,就像是把图书馆的地板划分成一个个方格子,每本书都根据它的标签特征被放进某个格子里。当读者来查询时,你先确定查询对应哪个格子(主格子),然后只检查那个格子里的书,而不必翻遍整个图书馆。
这种方法简单直接,但有一个经典难题:如果读者要找的那本书,恰好放在主格子隔壁,该怎么办?"多探针"的思路就是为了解决这个问题而生的——它不只看主格子,还会根据读者需求与格子边界的距离,从近到远依次检查邻近的格子,直到找到足够好的结果。
不过,这项研究里的多探针网格搜索有一个关键的聪明设计:它并不在原始的高维空间(比如200个标签维度的空间)里划格子,而是先用一种叫做PCA(主成分分析)的技术,把数据压缩到一个低维子空间(比如只有6个维度)里进行格子划分,然后在这个压缩版的"简化地图"上决定要查哪些格子,最后再用完整的200维原始数据做精确比较。
这个设计的意义非常关键。"决定查哪些格子"这件事,只需要在低维压缩空间里做,完全不受原始高维数据的影响;而最终的精确排名,虽然在高维空间做,但因为候选集已经被大幅缩小,计算量也是可控的。换句话说,这个方法把"找到候选人"和"精确评分"这两步彻底解耦了,让维度的增长对第一步几乎没有伤害。
在实现细节上,研究团队还为这个网格添加了一个"兜底机制":用广度优先搜索(BFS)预先计算好每个空格子离最近的非空格子有多远。这样,当查询落在一个恰好没有数据的格子时,系统可以立刻找到替代方案,而不会崩溃。
二、从数学到直觉:为什么查询速度会随召回率"指数级下降"?
研究团队不只是做了实验,他们还建立了一套数学模型来预测这个算法的行为,并从理论上解释了实验中观察到的现象。
模型的核心思路其实很符合直觉。假设格子总数是固定的,数据总量是N,那么每个格子平均放了N/(格子总数)条数据。每检查一个额外的格子,候选集的大小就线性增加这么多。与此同时,越靠近主格子的邻居格子,越可能包含查询的真正最近邻;离得越远的格子,包含真正答案的可能性呈指数级衰减——就像你找钥匙时,距离你最后放钥匙的地方越近,找到的概率越大,而且这个概率随距离的增加会很快变小。
把这两点结合起来,就得到一个数学上很清晰的结论:查询速度(每秒能处理多少次查询,即QPS)与召回率(找到真正最近邻的比例)之间,在对数坐标系下呈现近似直线关系。也就是说,如果你画一张图,横轴是召回率,纵轴是查询速度的对数,那么多探针网格的表现应该是一条向下倾斜的直线。召回率越高,需要探针的格子越多,速度越慢,这个"慢"是以指数级的代价换取线性的精度提升。
研究团队在实验中验证了这一点,结果与理论预测高度吻合——在GloVe-200-angular这个包含118万个词向量的标准数据集上,多探针网格的性能曲线确实呈现了预测的对数线性形状。
值得一提的是,当召回率超过90%时,这个方法的查询速度会急剧下降,趋近于暴力搜索(遍历所有数据)的水平。这是因为要找到几乎所有真正的最近邻,要么需要把所有数据塞进很少的几个大格子里,要么就必须检查绝大多数格子,本质上等于全库搜索。这是网格方法固有的局限,并非实现上的缺陷。
三、数据量扩大十倍,速度就慢十倍——这个代价公平吗?
研究团队用GloVe-200数据集(保持维度d=200不变,把数据量N从一万增加到118万)和SIFT-128数据集(图像描述符,d=128)做了系统的N-scaling(数据量缩放)实验。
实验方法是:对每个算法、每个数据量级,找出在某个固定召回率目标下的最优配置,然后测量对应的查询速度,画出"速度-数据量"的双对数图,用直线的斜率来衡量"数据量增大时速度下降的快慢",这个斜率被称为N-缩放指数αN。αN越接近-1,说明数据量增大一倍时速度几乎减半,是"线性"代价;αN越接近0,说明数据量增大时速度几乎不变,是"亚线性"代价。
在GloVe-200上,召回率目标为0.80时,多探针网格的αN为-0.94(R²=1.00,拟合极为精确),非常接近-1,意味着数据量增大时速度几乎线性下降。相比之下,其他四种算法的αN在-0.44到-0.59之间,也就是说它们在数据量增大时速度下降得相对较慢。
这是否意味着多探针网格更差?并不那么简单。αN接近-1,是因为多探针网格在每个数据量级下几乎已经达到了"完全线性"的理论极限——它的设计决定了每多一条数据,候选集就线性增大,没有任何"捷径"可以压缩。而其他方法(比如图搜索)通过构建复杂的索引结构,实现了亚线性增长,但代价是建立这些索引需要大量时间和资源。
在SIFT-128上,同样的规律完整保留:多探针网格的αN为-0.83,而其他算法在-0.27到-0.39之间。两个完全不同的数据集(一个是词向量、角度相似性,另一个是图像描述符、欧氏距离)得出了一致的结论,说明这种N-scaling模式是算法本身的内在特性,与数据类型无关。
四、最令人意外的发现:维度越高,它反而越有竞争力
研究中最出乎意料的发现,来自d-scaling(维度缩放)实验。研究团队利用GloVe词向量家族(同一批词,但分别用25、50、100、200个维度表示),在数据量保持不变(均为118万条)的情况下,测试了所有算法随着维度增加时的速度变化。
对于图搜索方法(Voyager和PyNNDescent),以及树方法(Annoy)和分区方法(FAISS-IVF),维度增加的结果是明显的:召回率目标越高,维度增加对速度的伤害就越大。到了召回率0.9附近,这四种算法的d-缩放指数αd急剧变陡,降到-1.6甚至-2.0的水平,意味着维度翻番时速度会下降到原来的四分之一甚至更少。这正是所谓"维度诅咒"的体现——在高维空间里,几何结构变得"均匀化",原本高效的剪枝和导航技巧会失效,算法被迫检查越来越多的数据。
而多探针网格的αd表现截然不同:在整个召回率范围内,αd保持相对平稳,没有出现其他方法那种"高召回率时急剧变陡"的现象。当召回率超过0.7时,其他方法的αd纷纷急跌,而多探针网格的αd曲线依然基本平缓。这个"交叉点"被研究团队称为d-scaling crossover(维度缩放穿越),是整篇论文中最核心的实证发现。
为什么会这样?原因正是前面提到的设计——格子划分在低维压缩空间里进行,不受原始高维度的直接影响。当原始维度从25增加到200时,PCA压缩能保留的方差比例确实在下降(从GloVe-25中m=8的压缩可以保留40%方差,到GloVe-200中同样m=8只能保留约8%方差),但算法会自动适应:在更高维度下,超参数优化会选择更少的格子总数(更大的格子),让每个格子里包含更多候选点,以此保住召回率。由于最终的精确排名是线性增长的,整体查询代价对维度的依赖比其他方法要温和得多。
研究团队也诚实地指出了这个发现的局限:整个d-scaling实验受限于GloVe家族的最高维度200,这是ann-benchmarks框架内唯一提供d变化系列的数据集。未来是否在d≥512的现代Transformer嵌入向量上同样成立,是一个明确提出但尚未回答的开放问题。
五、建索引的时间:这才是网格方法真正的竞争优势所在
理解了查询性能之后,研究团队进一步分析了完整的"总拥有成本",也就是不只看查询有多快,还要看建索引(建立搜索结构)有多慢、内存占用有多大。
在GloVe-200全量数据集(N=118万)、召回率目标0.80时,各算法建索引时间的测量结果差距惊人。多探针网格在最小配置(m=2,G=4)下只需4秒,最大配置(m=7,G=7)也只需36秒,平均约8.4秒。而FAISS-IVF需要206秒,Annoy需要333秒,PyNNDescent需要500秒,Voyager(HNSW变体)则需要惊人的1569秒——将近26分钟。
为什么网格方法建索引这么快?因为它的索引建立过程只需要三步:做一次PCA降维、把数据点分配到对应格子、预计算一次广度优先搜索。这三步都不需要任何数据点之间的相互比较。相比之下,图搜索方法的索引建立过程,本质上是通过反复执行"找最近邻"来插入每一个数据点,是一个递归依赖自身的过程,自然慢得多。
不过,快速建索引是有代价的:多探针网格的每次查询延迟约76.98毫秒,而Voyager只需约0.62毫秒,相差约120倍。查询速度慢很多。那么,什么情况下网格方法的低建索引成本能够弥补这一劣势?
研究团队通过一个简单的经济学模型给出了答案。设fI为索引重建的频率,fC为查询的频率,当"每次重建所节省的索引时间"超过"每次查询多花费的时间"时,网格方法的总成本更低。以与Voyager相比为例,重建一次网格索引节省了约1560秒,每次查询多花费约76毫秒,因此只要每次索引重建之间的查询次数少于约20432次(即约一次重建对应不超过两万次查询),网格方法的总成本就更低。与FAISS-IVF相比,这个临界值是约2591次查询。
研究团队指出,这个"高重建频率"的场景在实践中并不罕见。推荐系统需要随着用户行为持续更新候选库,检索增强生成(RAG)系统需要随着文档库的更新频繁重建索引,Transformer的KV缓存在处理长文本时每增加一个新词就需要更新一次索引。这些场景的共同特点是"写多读少"或"索引更新频繁",正是网格方法的舒适区。
六、算法的性能是真实的还是Python实现的"假象"?
研究团队的实现坦诚地承认了一个潜在问题:对比实验中,四种基线算法(Voyager、PyNNDescent、Annoy、FAISS-IVF)都是经过多年打磨的C++高性能实现,而多探针网格是一个Python概念验证版本。Python程序通常比C++慢十倍甚至更多,这会不会导致网格方法的绝对查询速度被低估,从而影响结论?
研究团队用cProfile工具对网格搜索的每个步骤做了详细的计时分析,在GloVe-200数据集上,跨越三个数量级的数据量(10万到118万)进行了追踪。结果显示,整个查询过程的时间开销几乎完全由两类NumPy/BLAS计算主导:候选向量的收集(从格子里取数据)和精确重排名(计算真实距离)。这两步直接调用底层C库,不受Python解释器影响。而纯Python的"开销部分"(查找格子编号、枚举邻居格子、组装候选列表等),由于每次查询只需处理固定数量的格子(最多2^m个),与数据量N无关,在N=118万时只占总查询时间的0.01%以下。
这意味着,即使未来用C++重写网格搜索,绝对速度会提升,但缩放指数(αN和αd)不会改变,因为它们反映的是算法本质,不是实现语言。换句话说,本文报告的所有相对性能趋势,都是真实的算法行为,而非Python开销造成的假象。
七、这一切对大型语言模型意味着什么?
研究团队在最后专门讨论了这些发现对Transformer架构的含义。如果把注意力机制理解为ANN搜索,那么上下文长度对应数据量N,每个注意力头的维度(通常64到128维,恰好在本研究覆盖的范围内)对应d,KV缓存的更新(每处理一个新词就要往缓存里加一条记录)对应索引更新频率。
在这个映射下,网格方法的特性——低索引更新成本、维度缩放表现平稳——恰好对应了长文本推理中KV缓存频繁增长、每次只插入一条记录(而非重建整个索引)的场景。研究团队指出,网格方法插入一条新数据时,只需要做一次格子分配操作,远比图搜索方法的插入(需要更新整个邻居图)便宜。当然,这个每次插入的具体成本以及它与预计算BFS兜底机制的交互效果,研究团队明确列为待解决的未来工作。
另一个未解问题是:d-scaling crossover在Transformer的Key向量分布上是否依然成立?GloVe向量有相对均匀的分布特性,而Transformer的注意力Key向量通常具有更强的非均匀性和更重的尾部分布,这可能会影响网格方法中均匀分格的假设成立程度。
归根结底,这项研究做了一件看似简单却颇有价值的事:把一个几十年前就存在、后来被边缘化的算法思路,放进现代标准化评测框架里,认真量化它在数据量和维度两个维度上的表现,并与当前主流方法做了全面对比。
结果发现,它在"N-scaling"这一维度上的表现(接近线性的代价)在某些应用场景里是完全可以接受的,而在"d-scaling"这一维度上,它随维度增加的性能退化明显比其他方法温和——这个发现在现代高维嵌入盛行的背景下,具有实际意义。与此同时,它极低的索引建立成本,使其在数据频繁更新的系统里具备了真正的竞争窗口。
这并不是说网格方法要取代HNSW或FAISS,而是说:当你面对的系统需要频繁重建索引、数据维度持续增高、对每次查询的绝对延迟不那么敏感时,有一个被遗忘的老方法值得重新考虑。
Q&A
Q1:多探针网格搜索在数据量很大时速度会变慢,为什么还值得使用?
A:多探针网格搜索在数据量增大时确实接近线性减速(每多一倍数据,速度大约慢一倍),这比图搜索方法的亚线性代价要差。但它的优势在于建立索引极快——在118万条数据的测试中只需约8秒,而图搜索方法需要几百甚至一千多秒。当一个系统需要频繁更新索引(比如推荐系统实时加入新内容,或者语言模型处理长文本时不断扩展缓存),每次重建索引的时间节省可以弥补查询速度上的劣势,使整体总成本更低。
Q2:多探针网格搜索为什么在高维数据上的性能退化比其他方法慢?
A:核心原因是"格子划分"这个决策步骤在低维压缩空间(通过PCA降维后的空间,通常只有几个维度)里进行,完全不受原始高维度的影响。原始维度增加时,只有最终的精确排名步骤会受到影响,但这一步的计算量与候选数量线性相关,并不因维度增高而产生指数级膨胀。相比之下,图搜索方法需要在完整的高维空间里构建和遍历邻居图,维度越高,图中每个节点的"邻域"越难精确定义,需要检查的节点就越多。
Q3:多探针网格搜索的三个超参数m、G、nprobe分别控制什么?
A:m是PCA压缩的目标维度数,决定把原始高维数据压缩到几维来做格子划分,m越大格子分得越细但候选区域也越多;G是每个维度上划分的格子数量,G越大单个格子越小、里面的候选点越少;nprobe是每次查询时检查的格子数量,nprobe越大召回率越高但速度越慢。这三个参数共同决定了算法在召回率和查询速度之间的权衡点,研究团队通过多目标优化算法(NSGA-II)系统地搜索了它们的最佳组合。

llama.cpp b12489、b12490、b12491、b12492、b12493、b12494、b12496、b12497、b12498 均为预发布构建,分别涉及服务器、语音模型及特定后端;适用范围须按模型、硬件和请求条件区分。
MiniMax-H3-Image新增DiffSynth-Studio文档推荐后,配置选择应围绕具体推理配方和独立训练流程展开。文档中的24GB GPU方案分别配合32GB或8GB主机RAM,所用量化、CPU或磁盘卸载方式不同;新增文档入口本身没有发布模型新权重或标注一个新的框架版本。
识别Ollama完整rc0预发布标签,区分MLX并发、Vulkan集成显卡mmap、llama.cpp b12257与CLI集成更新边界。
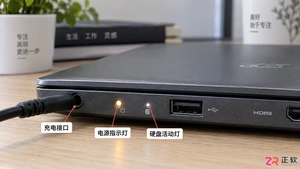
宏基笔记本遇到开机没反应、电源灯亮但屏幕黑屏,或者按下电源键完全无反应的情况该怎么办?本文通过界面与状态指示灯的观察,分步骤介绍静电释放、内存重插及外接显示器测试等实用方法,助你自行解决常见启动故障。
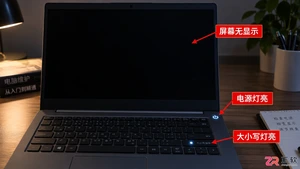
惠普笔记本开机时电源键和大小写锁定键亮起,但屏幕无反应?这通常是嵌入式控制器(EC)逻辑错误或静电干扰所致。本文详解如何通过移除外设、长按电源键进行硬件复位来恢复正常启动,并提供BIOS恢复及进一步硬件检测的建议。
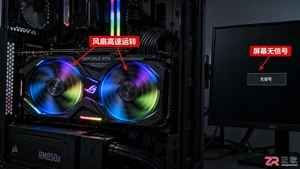
遇到电脑黑屏伴随显卡风扇狂转?这往往是显卡过热保护、供电不足或驱动崩溃的信号。本文详解如何通过观察指示灯、重置驱动、检查线缆及清理灰尘来解决该问题,避免盲目更换硬件。
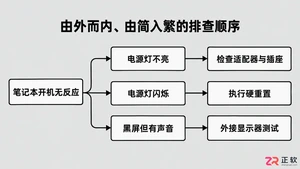
惠普笔记本无法开机、电源灯异常或屏幕黑屏?本文详解通过移除外设、执行硬重置(静电释放)、检查适配器及内存重插等步骤,快速定位并解决常见启动故障。
笔记本电脑突然黑屏,按电源键无反应,连接充电器指示灯也不亮?别急着送修。本教程通过释放静电、检查适配器、重置EC等实操步骤,帮你解决笔记本“假死”问题。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



