

python中jieba库、PyInstaller库、基本NumPy库使用真题
一、jieba库(中文分词) 1.jieba库是什么? 在英文中,单词之间用空格分隔,而中文句子中,词与词之间没有明显的分隔符。jieba库就是用来解决这个问题的,它能将一段中文文本切分成一个个有意义的词语。 在计算机二级考试中,主要考察的是jieba库的精确模式分词,以及对分词结果进行处理和统计。
一、jieba库(中文分词)
1.jieba库是什么?
在英文中,单词之间用空格分隔,而中文句子中,词与词之间没有明显的分隔符。jieba库就是用来解决这个问题的,它能将一段中文文本切分成一个个有意义的词语。

在计算机二级考试中,主要考察的是jieba库的精确模式分词,以及对分词结果进行处理和统计。
2. 核心考点 ——jieba.lcut()函数
这是考试中出现频率最高的函数,几乎逢考必用。
2.1 函数功能
jieba.lcut(s) 将字符串 s 进行精确模式分词,并返回一个列表类型的结果。
2.2 基础语法
import jieba

text = "我来到北京清华大学"
words_list = jieba.lcut(text)
print(words_list)
# 输出:['我', '来到', '北京', '清华大学']
在这个例子中,jieba.lcut() 将句子最精确地切分开,没有冗余词,非常适合文本分析。
2.3 二级考试真题演练
真题1:计算平均词语长度
题目:键盘输入一段文本,利用jieba库对其进行分词,并计算平均词语长度(即总字符数除以词语数)。
import jieba
txt = input("请输入一段中文文本:")
ls = jieba.lcut(txt)  # 考点:使用lcut进行分词,返回列表
print("{:.1f}".format(len(txt)/len(ls)))  # 考点:len(txt)字符数,len(ls)词语数
老师解析:
- 第一空:我们需要将分词结果赋值给变量
ls,因此是jieba.lcut(txt)。 - 第二空:
len(txt)是字符串的字符总数,len(ls)是分词后列表的长度(即词语总数),两者相除即为平均词长。
真题2:分词后逆序输出
题目:键盘输入一句话,用jieba分词后,将切分的词组按照在原话中逆序输出到屏幕上,词组中间没有空格。
import jieba
txt = input("请输入一段中文文本:")
ls = jieba.lcut(txt)   # 考点:分词
for i in ls[::-1]:     # 考点:列表切片逆序
    print(i, end="")   # 考点:end="" 取消换行
老师解析:
- 如果输入“我爱妈妈”,
ls = ['我', '爱', '妈妈']。 ls[::-1]将列表逆序为['妈妈', '爱', '我']。- 通过
print(i, end="")将它们连续输出,得到“妈妈爱我”。
3. 了解即可 —— 其他分词模式
虽然考试最常考精确模式,但你还需要了解另外两种模式,以防在选择题中出现概念辨析。
3.1 全模式
把句子中所有可以成词的词语都扫描出来,速度非常快,但是不能解决歧义,有冗余。
import jieba
seg_list = jieba.lcut("我来到北京清华大学", cut_all=True)
print("全模式: " + str(seg_list))
# 输出:['我', '来到', '北京', '清华', '清华大学', '华大', '大学']
# 可以看到,“清华大学”被切成了“清华”、“华大”、“大学”、“清华大学”等多个词,存在冗余。
3.2 搜索引擎模式
在精确模式的基础上,对长词再次切分,提高召回率,适合用于搜索引擎分词。
import jieba
seg_list = jieba.lcut_for_search("我来到北京清华大学")
print("搜索引擎模式: " + str(seg_list))
# 输出:['我', '来到', '北京', '清华', '华大', '大学', '清华大学']
# 相比于精确模式,它将“清华大学”这种长词又进行了更细粒度的切分。
3.3 模式对比表
| 模式 | 对应函数 | 特点 | 冗余 |
|---|---|---|---|
| 精确模式 | jieba.lcut(s) | 最常用,适合文本分析 | 无 |
| 全模式 | jieba.lcut(s, cut_all=True) | 扫描出所有可能的词 | 有 |
| 搜索引擎模式 | jieba.lcut_for_search(s) | 在精确模式上对长词再切分 | 有(针对长词) |
4. 进阶考点 —— 词频统计与文件操作
在考试的综合应用题中,经常会将 jieba 分词与文件读写、字典操作结合起来考察。
4.1 真题:统计关键词并排序
题目:对文件
data.txt进行分词,找出长度大于等于3个字符的关键词,统计出现次数,并按照次数由大到小输出到文件out.txt。
老师解析:
这道题是二级考试的经典压轴题,融合了分词、条件筛选、字典统计、列表排序、文件IO五大考点。
代码实现:
import jieba

# 1. 读取文件
fi = open("data.txt", "r", encoding="utf-8")
data = fi.read()
fi.close()

# 2. 精确模式分词
words_list = jieba.lcut(data)

# 3. 筛选长度>=3的词并统计词频
d = {}  # 创建空字典用于统计
for word in words_list:
    if len(word) >= 3:  # 考点:筛选条件
        d[word] = d.get(word, 0) + 1  # 考点:字典词频统计方法

# 4. 对统计结果排序
ls = list(d.items())  # 将字典转为列表,例如 [('科学家', 2), ('达特茅斯', 1)]
ls.sort(key=lambda x: x[1], reverse=True)  # 考点:按词频降序排序

# 5. 写入文件
fo = open("out.txt", "w", encoding="utf-8")
for item in ls:
    fo.write("{}:{}n".format(item[0], item[1]))
fo.close()
重点语句讲解:
d.get(word, 0) + 1:这是词频统计的标准写法。如果word在字典中,返回其值(次数)并加1;如果不在,返回0并加1。ls.sort(key=lambda x: x[1], reverse=True):lambda x: x[1]指定以列表元素(元组)的第二个分量(即词频)作为排序依据,reverse=True表示降序排列。
5. 课程总结
为了应对计算机二级考试,关于 jieba 库你需要掌握以下三点:
- 核心函数:牢牢记住
jieba.lcut(s)的作用——精确分词并返回列表。这是考试代码填空题的绝对主力。 - 模式辨析:清楚精确模式、全模式、搜索引擎模式的主要区别,能根据输出反推模式。
- 综合应用:掌握 “分词 + 筛选 + 字典统计 + 排序” 的组合套路,这是综合应用题的高频考法。
二、PyInstaller 库(打包工具)
1. PyInstaller 是什么?
PyInstaller 的核心价值,在于它能将 Python 程序打包为独立的可执行文件。它会自动分析程序依赖的模块,把 Python 解释器、源代码以及依赖库全部打包在一起,最终生成一个无需安装 Python 环境即可直接运行的文件。
1.1 为什么要用 PyInstaller?
- 在没有 Python 环境的计算机上运行程序
- 方便分发和部署
- 保护源代码(打包后的文件难以直接查看源码)
1.2 安装 PyInstaller
pip install pyinstaller
2. PyInstaller 的基本用法
2.1 命令行语法
pyinstaller [选项] 脚本文件.py
2.2 常用选项
| 选项 | 说明 |
|---|---|
-F 或 --onefile | 打包成一个单文件(推荐) |
-D 或 --onedir | 打包成一个文件夹(默认) |
-i 或 --icon | 指定可执行文件的图标(需 .ico 文件) |
-w 或 --windowed | 隐藏控制台窗口(适用于图形界面程序) |
-c 或 --console | 显示控制台窗口(默认) |
-n 或 --name | 指定生成的可执行文件名 |
--upx | 使用 UPX 压缩可执行文件(需安装 UPX) |
--clean | 清理临时文件 |
-y 或 --noconfirm | 覆盖输出目录而不询问 |
2.3 示例
示例1:打包一个简单的 Python 脚本
pyinstaller -F hello.py
生成一个单独的 hello.exe 文件,默认放在 dist 文件夹中。
示例2:指定程序图标
pyinstaller -F -i myicon.ico hello.py
生成带自定义图标的可执行文件。
示例3:打包图形界面程序(不显示控制台)
pyinstaller -F -w gui_app.py
示例4:指定输出文件名
pyinstaller -F -n MyApp hello.py
生成 MyApp.exe。
3. PyInstaller 的二级考试考点
在计算机二级 Python 考试中,PyInstaller 一般出现在选择题中,考查以下知识点:
3.1 基本概念
- PyInstaller 是第三方库,需要安装。
- 作用:将 Python 程序打包成独立可执行文件。
- 打包后的文件可以在没有 Python 环境的机器上运行。
3.2 常用选项
-F:生成单个文件。-D:生成一个文件夹(包含多个文件)。-i:指定图标。-w:不显示控制台窗口。
3.3 典型考题
题目:要将 Python 程序
myapp.py打包成一个独立的可执行文件,并指定程序图标为app.ico,以下命令正确的是?A.
pyinstaller -D -i app.ico myapp.pyB.
pyinstaller -F -i app.ico myapp.pyC.
pyinstaller -w -i app.ico myapp.pyD.
pyinstaller -i app.ico -D myapp.py
答案:B(-F 生成单文件,-i 指定图标)
4. 注意事项
- 文件路径:打包时,脚本中使用的文件(如图片、数据文件)需要特殊处理,否则可能找不到。可以使用
sys._MEIPASS获取临时路径,或者使用--add-data选项添加额外文件。 - 模块依赖:PyInstaller 会自动分析 import 语句,但某些动态导入的模块可能漏掉,可以使用
--hidden-import手动添加。 - 打包大小:默认打包包含 Python 解释器和所有依赖,文件较大(几十 MB)。使用
--upx可以压缩。 - 跨平台:PyInstaller 可以在 Windows、Linux、macOS 上运行,但生成的可执行文件只能在对应的平台上执行。
5. 课程小结
| 知识点 | 核心内容 |
|---|---|
| PyInstaller 作用 | 打包 Python 程序为独立可执行文件 |
| 安装 | pip install pyinstaller |
| 常用选项 | -F 单文件、-D 文件夹、-i 图标、-w 无控制台 |
| 输出位置 | 默认在 dist 文件夹中 |
| 考试考点 | 基本概念、常用选项、命令格式 |
三、NumPy 库(科学计算)
1. NumPy 是什么?
1.1 基本概念
NumPy 是 Numerical Python 的简称,也是 Python 做科学计算时绕不开的一套核心库。它最关键的能力,在于提供了一个高效且灵活的 N 维数组对象(ndarray),同时还配备了大量专门用于处理这类数组的函数。
1.2 为什么需要 NumPy?
与 Python 原生的列表相比,NumPy 数组有以下优势:
| 对比项 | Python 列表 | NumPy 数组 |
|---|---|---|
| 存储效率 | 每个元素都是独立的对象,占用内存大 | 所有元素类型相同,内存连续,占用小 |
| 计算速度 | 需要逐元素遍历,速度慢 | 底层用 C 语言实现,计算速度快 10-100 倍 |
| 数学功能 | 基本没有内置数学函数 | 丰富的数学、统计、线性代数函数 |
| 语法简洁 | 需要循环实现向量运算 | 支持矢量化计算,一行代码完成 |
1.3 安装与导入
# 安装 NumPy
pip install numpy
在代码中导入 NumPy(约定俗成的别名是 np):
import numpy as np
2. NumPy 的核心对象——ndarray
2.1 什么是 ndarray?
ndarray(N-dimensional array) 是 NumPy 的核心数据结构,用于存储同类型的多维数组。它可以是一维(向量)、二维(矩阵)或更高维度的数组。
2.2 创建数组的基本方法
方法1:从列表创建——np.array()
import numpy as np

# 从列表创建一维数组
arr1 = np.array([1, 2, 3, 4, 5])
print(arr1)                     # [1 2 3 4 5]

# 从嵌套列表创建二维数组
arr2 = np.array([[1, 2, 3], [4, 5, 6]])
print(arr2)
# [[1 2 3]
#  [4 5 6]]

# 指定数据类型
arr3 = np.array([1.5, 2.8, 3.2], dtype=np.int32)
print(arr3)                     # [1 2 3]
方法2:创建全零数组——np.zeros()
# 创建一维全零数组
zeros_1d = np.zeros(5)
print(zeros_1d)                 # [0. 0. 0. 0. 0.]

# 创建二维全零数组 (3行4列)
zeros_2d = np.zeros((3, 4))
print(zeros_2d)
# [[0. 0. 0. 0.]
#  [0. 0. 0. 0.]
#  [0. 0. 0. 0.]]

# 指定数据类型
zeros_int = np.zeros((2, 3), dtype=np.int32)
print(zeros_int)
# [[0 0 0]
#  [0 0 0]]
方法3:创建全一数组——np.ones()
# 创建一维全一数组
ones_1d = np.ones(4)
print(ones_1d)                  # [1. 1. 1. 1.]

# 创建三维全一数组 (2x3x4)
ones_3d = np.ones((2, 3, 4))
print(ones_3d.shape)            # (2, 3, 4)
方法4:创建等差数组——np.arange()
# 从0到9
arr1 = np.arange(10)
print(arr1)                     # [0 1 2 3 4 5 6 7 8 9]

# 指定起始值和结束值 (5到14)
arr2 = np.arange(5, 15)
print(arr2)                     # [ 5  6  7  8  9 10 11 12 13 14]

# 指定步长 (0到30,步长为3)
arr3 = np.arange(0, 30, 3)
print(arr3)                     # [ 0  3  6  9 12 15 18 21 24 27]

# 创建浮点数序列
arr4 = np.arange(0, 2.5, 0.5)
print(arr4)                     # [0.  0.5 1.  1.5 2. ]
方法5:创建等间隔数组——np.linspace()
# 0到10之间生成5个等间隔数
arr1 = np.linspace(0, 10, 5)
print(arr1)                     # [ 0.   2.5  5.   7.5 10. ]

# 0到1之间生成10个等间隔数(包含端点)
arr2 = np.linspace(0, 1, 10)
print(arr2)
# [0.         0.11111111 0.22222222 0.33333333 0.44444444
#  0.55555556 0.66666667 0.77777778 0.88888889 1.        ]

# 不包含端点
arr3 = np.linspace(0, 1, 10, endpoint=False)
print(arr3)
# [0.  0.1 0.2 0.3 0.4 0.5 0.6 0.7 0.8 0.9]
方法6:创建单位矩阵——np.eye()
# 3x3 单位矩阵
eye_matrix = np.eye(3)
print(eye_matrix)
# [[1. 0. 0.]
#  [0. 1. 0.]
#  [0. 0. 1.]]

# 非方阵的对角矩阵
rect_eye = np.eye(3, 4)
print(rect_eye)
# [[1. 0. 0. 0.]
#  [0. 1. 0. 0.]
#  [0. 0. 1. 0.]]
方法7:创建随机数组——np.random
# 创建0到1之间的随机数数组 (3x3)
rand_arr = np.random.rand(3, 3)
print(rand_arr)
# 输出示例:
# [[0.5488135  0.71518937 0.60276338]
#  [0.54488318 0.4236548  0.64589411]
#  [0.43758721 0.891773   0.96366276]]

# 创建标准正态分布随机数组 (均值为0,标准差为1)
randn_arr = np.random.randn(2, 4)
print(randn_arr)

# 创建指定范围内的随机整数 (10到30之间,形状3x2)
randint_arr = np.random.randint(10, 30, size=(3, 2))
print(randint_arr)
# 输出示例:
# [[20 29]
#  [24 22]
#  [27 19]]
3. ndarray 的重要属性
每个 NumPy 数组都有以下属性,用于获取数组的基本信息:
| 属性 | 说明 | 示例 |
|---|---|---|
shape | 数组的形状(各维度大小),返回元组 | (3, 4) 表示 3 行 4 列 |
ndim | 数组的维数 | 一维返回 1,二维返回 2 |
size | 数组中元素的总个数 | 3×4=12 |
dtype | 数组元素的数据类型 | int64、float64 等 |
itemsize | 每个元素占用的字节数 | int64 为 8 字节 |
import numpy as np

# 创建二维数组
arr = np.array([[1, 2, 3, 4],
                [5, 6, 7, 8],
                [9, 10, 11, 12]])

print(f"形状: {arr.shape}")      # (3, 4)
print(f"维数: {arr.ndim}")       # 2
print(f"元素数量: {arr.size}")   # 12
print(f"元素类型: {arr.dtype}")  # int64
print(f"元素字节数: {arr.itemsize}")  # 8
4. 数组的基本操作
4.1 索引与切片
import numpy as np

arr = np.array([10, 20, 30, 40, 50, 60])
print(arr[0])       # 10 - 第一个元素
print(arr[-1])      # 60 - 最后一个元素
print(arr[1:4])     # [20 30 40] - 索引1到3
print(arr[::2])     # [10 30 50] - 步长为2
print(arr[::-1])    # [60 50 40 30 20 10] - 反转
4.2 二维数组的索引与切片
import numpy as np

# 创建二维数组
arr_2d = np.array([[1, 2, 3],
                   [4, 5, 6],
                   [7, 8, 9]])

print(arr_2d[0, 0])     # 1 - 第0行第0列
print(arr_2d[1, 2])     # 6 - 第1行第2列
print(arr_2d[0, :])     # [1 2 3] - 第0行所有列
print(arr_2d[:, 1])     # [2 5 8] - 所有行第1列
print(arr_2d[0:2, 0:2]) # 左上角2x2子矩阵
# [[1 2]
#  [4 5]]
4.3 数组形状变换
import numpy as np

arr = np.array([1, 2, 3, 4, 5, 6])

# reshape:改变形状(不改变原数组)
arr_2d = arr.reshape(2, 3)
print(arr_2d)
# [[1 2 3]
#  [4 5 6]]

# -1 表示自动计算该维度大小
arr_auto = arr.reshape(2, -1)
print(arr_auto)
# [[1 2 3]
#  [4 5 6]]

# 展平为一维
arr_flat = arr_2d.flatten()
print(arr_flat)         # [1 2 3 4 5 6]
4.4 转置
import numpy as np

arr = np.array([[1, 2, 3],
                [4, 5, 6]])

print(arr.T)    # 转置
# [[1 4]
#  [2 5]
#  [3 6]]
5. 数组运算——矢量化计算
NumPy 的核心优势是矢量化计算,可以直接对数组进行数学运算,无需循环。
5.1 数组与标量的运算
import numpy as np

arr = np.array([1, 2, 3, 4])

print(arr + 10)     # [11 12 13 14]
print(arr * 3)      # [3 6 9 12]
print(arr ** 2)     # [1 4 9 16]
5.2 数组与数组的运算
import numpy as np

a = np.array([1, 2, 3])
b = np.array([4, 5, 6])

print(a + b)        # [5 7 9] - 逐元素相加
print(a * b)        # [4 10 18] - 逐元素相乘
print(a / b)        # [0.25 0.4 0.5]
print(a ** b)       # [1 32 729]
5.3 一元通用函数
| 函数 | 说明 | 示例 |
|---|---|---|
np.sqrt(arr) | 平方根 | np.sqrt([1,4,9]) → [1,2,3] |
np.square(arr) | 平方 | np.square([1,2,3]) → [1,4,9] |
np.exp(arr) | e 的 x 次方 | np.exp([0,1,2]) → [1, 2.718, 7.389] |
np.log(arr) | 自然对数 | np.log([1, e, e**2]) → [0,1,2] |
np.log10(arr) | 以 10 为底的对数 | np.log10([1,10,100]) → [0,1,2] |
np.abs(arr) | 绝对值 | np.abs([-1,2,-3]) → [1,2,3] |
np.sin(arr) | 正弦 | np.sin([0, np.pi/2]) → [0,1] |
np.ceil(arr) | 向上取整 | np.ceil([1.2, 2.7]) → [2., 3.] |
np.floor(arr) | 向下取整 | np.floor([1.2, 2.7]) → [1., 2.] |
5.4 二元通用函数
| 函数 | 说明 | 示例 |
|---|---|---|
np.add(a, b) | 加法 | np.add([1,2], [3,4]) → [4,6] |
np.subtract(a, b) | 减法 | np.subtract([5,6], [3,4]) → [2,2] |
np.multiply(a, b) | 乘法 | np.multiply([2,3], [4,5]) → [8,15] |
np.divide(a, b) | 除法 | np.divide([4,6], [2,3]) → [2.,2.] |
np.power(a, b) | 幂运算 | np.power([2,3], [3,2]) → [8,9] |
np.maximum(a, b) | 逐元素取最大值 | np.maximum([2,5], [4,3]) → [4,5] |
np.minimum(a, b) | 逐元素取最小值 | np.minimum([2,5], [4,3]) → [2,3] |
6. 统计方法
| 方法 | 说明 | 示例 |
|---|---|---|
arr.sum() | 求和 | np.array([1,2,3]).sum() → 6 |
arr.mean() | 平均值 | np.array([1,2,3]).mean() → 2.0 |
arr.max() | 最大值 | np.array([1,2,3]).max() → 3 |
arr.min() | 最小值 | np.array([1,2,3]).min() → 1 |
arr.std() | 标准差 | 衡量数据分散程度 |
arr.var() | 方差 | 标准差的平方 |
arr.argmax() | 最大值索引 | 返回最大值的下标 |
arr.argmin() | 最小值索引 | 返回最小值的下标 |
arr.cumsum() | 累积和 | np.array([1,2,3]).cumsum() → [1,3,6] |
6.1 轴向统计(axis 参数)
在二维数组中,可以通过 axis 参数指定统计方向:
axis=0:按列统计(沿着行方向)axis=1:按行统计(沿着列方向)
import numpy as np

arr = np.array([[1, 2, 3],
                [4, 5, 6],
                [7, 8, 9]])

# 按列求和(每列的和)
col_sum = arr.sum(axis=0)
print(col_sum)          # [12 15 18]  (1+4+7=12, 2+5+8=15, 3+6+9=18)

# 按行求和(每行的和)
row_sum = arr.sum(axis=1)
print(row_sum)          # [6 15 24]

# 按列求平均值
col_mean = arr.mean(axis=0)
print(col_mean)         # [4. 5. 6.]

# 按行求最大值
row_max = arr.max(axis=1)
print(row_max)          # [3 6 9]
7. 广播机制
广播(Broadcasting) 是 NumPy 的一个重要特性,允许不同形状的数组进行运算。
7.1 基本规则
当两个数组形状不同时,NumPy 会尝试将较小的数组“广播”到较大数组的形状,使它们能够进行逐元素运算。
import numpy as np

# 二维数组与一维数组相加
arr_2d = np.array([[1, 2, 3],
                   [4, 5, 6]])
arr_1d = np.array([10, 20, 30])

# 一维数组被广播到每一行
result = arr_2d + arr_1d
print(result)
# [[11 22 33]
#  [14 25 36]]
7.2 广播示例
# 二维数组与标量运算(标量广播到所有元素)
arr = np.array([[1, 2], [3, 4]])
print(arr * 2)
# [[2 4]
#  [6 8]]

# 列向量广播
col = np.array([[1], [2]])   # 2x1 列向量
arr = np.array([[10, 20], [30, 40]])
print(arr + col)
# [[11 21]
#  [32 42]]
8. 综合案例——学生成绩分析
import numpy as np

# 学生成绩数据:4名学生,3门课程(语文、数学、英语)
scores = np.array([[85, 92, 78],
                   [88, 90, 85],
                   [79, 88, 92],
                   [92, 85, 88]])

print("原始成绩表:")
print(scores)
print()

# 1. 计算每个学生的总分(按行求和)
student_total = scores.sum(axis=1)
print(f"学生总分: {student_total}")

# 2. 计算每个学生的平均分
student_mean = scores.mean(axis=1)
print(f"学生平均分: {student_mean}")

# 3. 计算每门课程的平均分(按列求平均)
course_mean = scores.mean(axis=0)
print(f"课程平均分(语文、数学、英语): {course_mean}")

# 4. 找出总分最高的学生
max_score = student_total.max()
max_index = student_total.argmax()
print(f"总分最高分: {max_score},是第{max_index+1}号学生")

# 5. 找出每门课程的最高分
course_max = scores.max(axis=0)
print(f"各科最高分(语文、数学、英语): {course_max}")

# 6. 统计及格情况(>=60分为及格)
pass_mask = scores >= 60
pass_count = pass_mask.sum()
print(f"及格总人次: {pass_count}")

# 7. 将成绩标准化(减去均值后除以标准差)
# 注意:这里使用广播,每一列减去该列的均值
normalized = (scores - scores.mean(axis=0)) / scores.std(axis=0)
print("标准化后的成绩:")
print(normalized)
输出示例:
原始成绩表:
[[85 92 78]
 [88 90 85]
 [79 88 92]
 [92 85 88]]

学生总分: [255 263 259 265]
学生平均分: [85.         87.66666667 86.33333333 88.33333333]
课程平均分(语文、数学、英语): [86.   88.75 85.75]
总分最高分: 265,是第4号学生
各科最高分(语文、数学、英语): [92 92 92]
及格总人次: 12
标准化后的成绩:
[[-0.21320072  0.68041382 -1.25831551]
 [ 0.31980108  0.22680461 -0.1020418 ]
 [-1.52067351 -0.22680461  0.96939709]
 [ 1.41407315 -0.68041382  0.39096022]]
9. 课程小结
| 知识点 | 核心内容 |
|---|---|
| NumPy 是什么 | Python 科学计算的基础库,提供 N 维数组 ndarray |
| 数组创建 | np.array()、np.zeros()、np.ones()、np.arange()、np.linspace()、np.eye()、np.random |
| 数组属性 | shape、ndim、size、dtype |
| 索引与切片 | 类似 Python 列表,支持多维索引 |
| 形状变换 | reshape()、flatten()、T(转置) |
| 矢量化运算 | 数组与标量、数组与数组的逐元素运算 |
| 通用函数 | sqrt、exp、log、sin 等一元函数;add、multiply 等二元函数 |
| 统计方法 | sum、mean、max、min、std、var,支持 axis 参数 |
| 广播机制 | 不同形状数组自动扩展后运算 |
总结
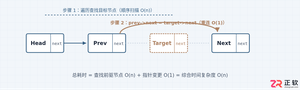
详细分析链表删除节点的时间复杂度,深入探讨单链表与双向链表在不同已知前提下的查找与删除开销,并结合完整代码与清晰图解进行对比总结。
想知道如何让AI写出的代码更贴合你的习惯?本文手把手教你在VS Code中调整Codex相关模型参数,通过修改配置文件优化温度值和令牌限制,解决代码建议不准确或响应慢的问题。
通过实测展示Claude Code在终端中如何理解自然语言指令、自动修改代码文件并处理复杂编程任务,帮助开发者评估其实际辅助能力。
本教程详细讲解如何使用Visual Studio创建WinForms项目,通过添加按钮和标签控件并编写点击事件代码,实现一个基础的计数器功能,适合C#初学者快速上手Windows窗体应用开发。
详解Cursor编辑器中自动补全功能的开启与优化设置,涵盖Tab触发机制、上下文窗口调整及模型切换,帮助开发者解决补全延迟、干扰大等问题,提升编码流畅度。
详解Pandas中数据格式转换的核心方法,包括astype强制转换、to_numeric容错处理及日期解析技巧,解决常见类型错误并提升数据处理效率。
详细介绍在Visual Studio Code中安装Chinese (Simplified)语言包的方法,包括通过扩展市场搜索、安装及自动重启切换至简体中文界面的完整步骤,帮助开发者快速将编辑器本地化。
针对Cursor安装包默认锁定C盘且无路径选择界面的问题,提供通过手动移动文件并创建目录联结(Symbolic Link)的解决方案,实现将软件安装在其他磁盘分区。
详解Windows系统下Rust语言的安装步骤,重点解析rustup工具链管理机制,解决环境变量配置错误及MSVC链接器缺失问题,提供可复制的命令验证方法与常见报错的因果排查思路。
详解VS Code中Chat插件的安装与核心配置步骤,重点解决API连接失败、响应慢等常见问题,通过优化上下文设置提升代码生成质量,适合希望集成AI辅助工具的开发者阅读。



Blender 是一款免费开源、跨平台的专业 3D 创作软件,集建模、动画、渲染、视频编辑与视觉合成等功能于一体,广泛应用于影视动画、游戏设计和建筑可视化等领域。软件支持 Cycles 物理渲染器与 Eevee 实时渲染引擎,并提供多边形建模、骨骼绑定、物理模拟等专业工具。Blender 兼容 Windows、macOS 和 Linux 系统,安装包轻巧、运行流畅,依托活跃的全球开发者社区持续更新,是从初学者到专业创作者都值得选择的正版 3D 创作工具。


赤友清理大师是一款为 Mac 设计的智能清理优化工具,可精准扫描垃圾、大文件、重复文件等,释放磁盘空间。做扫描整理、文字提取和表格转换时,它能把识别后的处理步骤接得更顺,资料录入这类场景会省下不少时间。
Blender 是一款免费开源、跨平台的专业 3D 创作软件,集建模、动画、渲染、视频编辑与视觉合成等功能于一体,广泛应用于影视动画、游戏设计和建筑可视化等领域。软件支持 Cycles 物理渲染器与 Eevee 实时渲染引擎,并提供多边形建模、骨骼绑定、物理模拟等专业工具。Blender 兼容 Windows、macOS 和 Linux 系统,安装包轻巧、运行流畅,依托活跃的全球开发者社区持续更新,是从初学者到专业创作者都值得选择的正版 3D 创作工具。

Windows 10 是一款微软推出的经典操作系统,拥有硬件兼容性与多任务处理能力。它更偏向把系统状态查看和常用调节动作放在一起,适合需要持续观察和微调设备状态的场景。

极度公式是一款跨平台专业LaTeX公式识别编辑软件,支持OCR公式识别和多平台编辑。和使用说明,避免使用,享受完整功能与稳定支持。做扫描整理、文字提取和表格转换时,它能把识别后的处理步骤接得更顺,资料录入这类场景会省下不少时间。