

7.2.1 Android XML数据解析
Android Studio 是 Google 面向安卓应用开发提供的官方集成开发环境,基于 IntelliJ IDEA 构建。它整合智能代码编辑、Gradle 构建、界面预览、设备模拟、性能分析、调试测试及 APK 分析等工具。
本节引言: 前两节已经把 Android 自带的两种 HTTP 请求方式——HttpURLConnection 和 HttpClient——过了一遍。原本还以为 OkHttp 已经默认集成进系统里了,打算顺势把 OkHttp 的基础用法也一起讲掉,结果一看,还是得额外导入第三方库。那就先不着急,放到
本节引言:
前两节已经把 Android 自带的两种 HTTP 请求方式——HttpURLConnection 和 HttpClient——过了一遍。原本还以为 OkHttp 已经默认集成进系统里了,打算顺势把 OkHttp 的基础用法也一起讲掉,结果一看,还是得额外导入第三方库。那就先不着急,放到后面的进阶部分再展开。先把眼前这块内容吃透:这一节重点来看 Android 提供的三种 XML 数据解析方案,分别是 SAX、DOM 和 PULL。接下来,就按这三种方式逐个了解一遍。
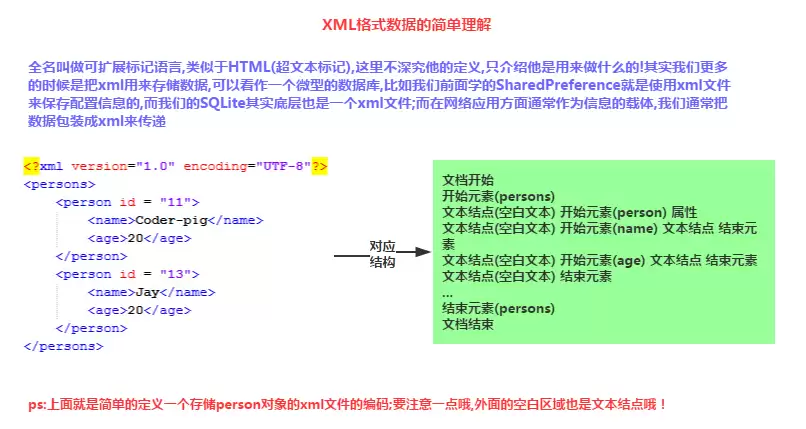
1.XML数据要点介绍
首先我们来看看XML数据的一些要求以及概念:
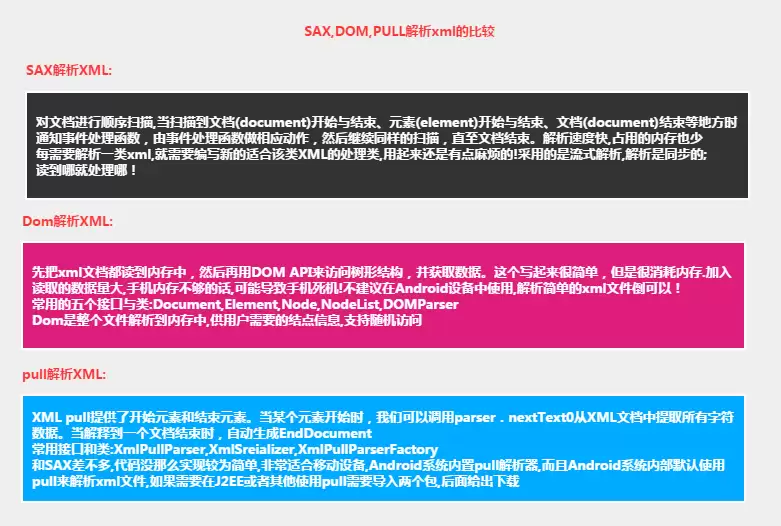
2.三种解析XML方法的比较
3.SAX解析XML数据
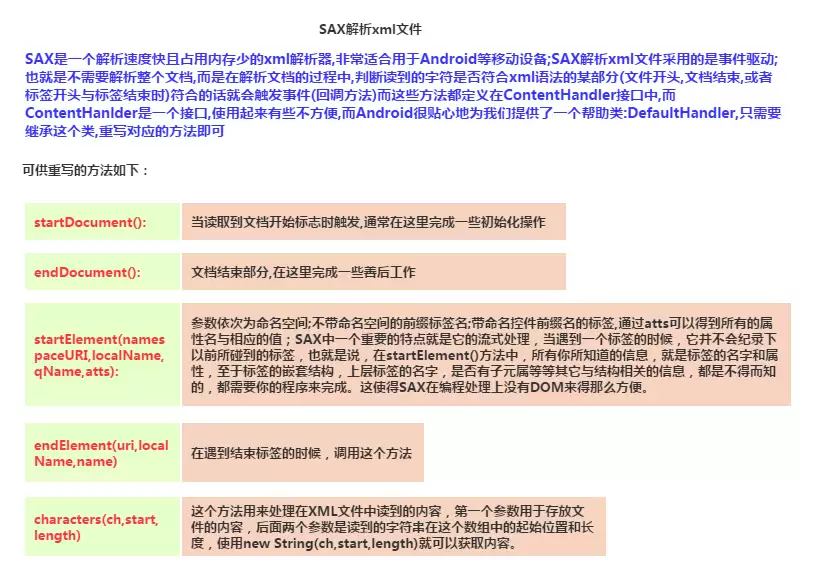
核心代码:
SAX解析类:SaxHelper.ja va:
/**
 * Created by Jay on 2015/9/8 0008.
 */
public class SaxHelper extends DefaultHandler {
    private Person person;
    private ArrayList persons;
    //当前解析的元素标签
    private String tagName = null;
/**
     * 当读取到文档开始标志是触发,通常在这里完成一些初始化操作
     */
    @Override
    public void startDocument() throws SAXException {
        this.persons = new ArrayList();
        Log.i("SAX", "读取到文档头,开始解析xml");
    }
/**
     * 读到一个开始标签时调用,第二个参数为标签名,最后一个参数为属性数组
     */
    @Override
    public void startElement(String uri, String localName, String qName,
                             Attributes attributes) throws SAXException {
        if (localName.equals("person")) {
            person = new Person();
            person.setId(Integer.parseInt(attributes.getValue("id")));
            Log.i("SAX", "开始处理person元素~");
        }
        this.tagName = localName;
    }
/**
     * 读到到内容,第一个参数为字符串内容,后面依次为起始位置与长度
     */
@Override
    public void characters(char[] ch, int start, int length)
            throws SAXException {
        //判断当前标签是否有效
        if (this.tagName != null) {
            String data = new String(ch, start, length);
            //读取标签中的内容
            if (this.tagName.equals("name")) {
                this.person.setName(data);
                Log.i("SAX", "处理name元素内容");
            } else if (this.tagName.equals("age")) {
                this.person.setAge(Integer.parseInt(data));
                Log.i("SAX", "处理age元素内容");
            }
}
}
/**
     * 处理元素结束时触发,这里将对象添加到结合中
     */
    @Override
    public void endElement(String uri, String localName, String qName)
            throws SAXException {
        if (localName.equals("person")) {
            this.persons.add(person);
            person = null;
            Log.i("SAX", "处理person元素结束~");
        }
        this.tagName = null;
    }
/**
     * 读取到文档结尾时触发,
     */
    @Override
    public void endDocument() throws SAXException {
        super.endDocument();
        Log.i("SAX", "读取到文档尾,xml解析结束");
    }
//获取persons集合
    public ArrayList getPersons() {
        return persons;
    }
}
然后我们在MainActivity.ja va中写上写上这样一个方法,然后要解析XML的时候调用下 就好了~
private ArrayList readxmlForSAX() throws Exception {
    //获取文件资源建立输入流对象
    InputStream is = getAssets().open("person1.xml");
    //①创建XML解析处理器
    SaxHelper ss = new SaxHelper();
    //②得到SAX解析工厂
    SAXParserFactory factory = SAXParserFactory.newInstance();
    //③创建SAX解析器
    SAXParser parser = factory.newSAXParser();
    //④将xml解析处理器分配给解析器,对文档进行解析,将事件发送给处理器
    parser.parse(is, ss);
    is.close();
    return ss.getPersons();
} 一些其他的话:
嗯,对了,忘记给大家说下我们是定义下面这样一个person1.xml文件,然后放到assets目录下的! 文件内容如下:person1.xml
        SAX解析
        18


        XML1
        43
我们是把三种解析方式都糅合到一个demo中,所以最后才贴全部的效果图,这里的话,贴下打印的Log, 相信大家会对SAX解析XML流程更加明了:
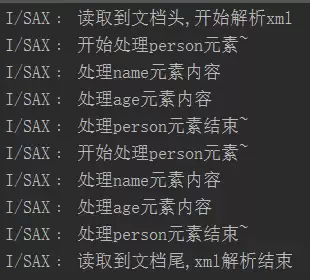
另外,外面的空白文本也是文本节点哦!解析的时候也会走这些节点!
4.DOM解析XML数据
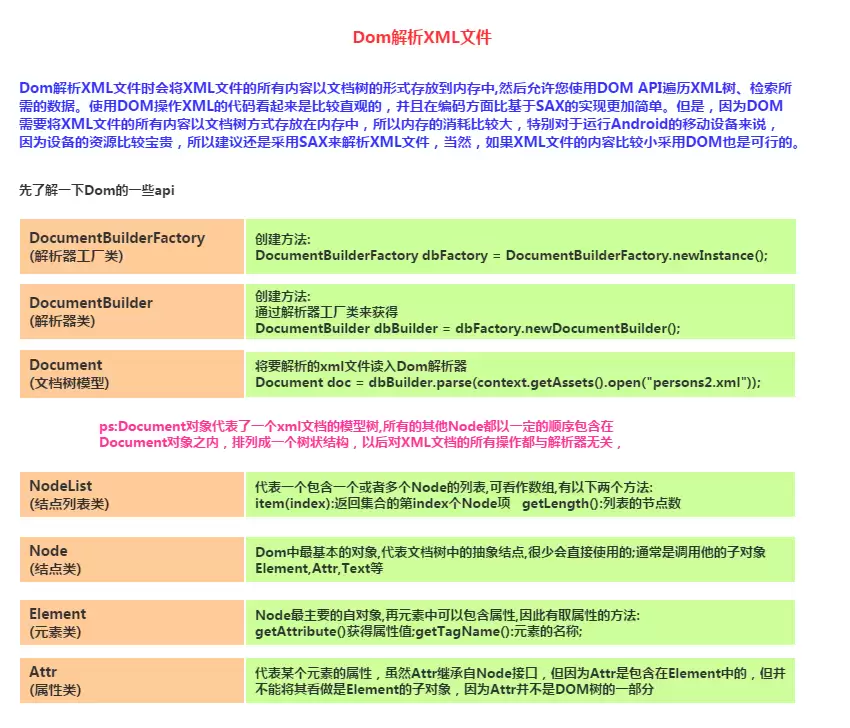
核心代码:
DomHelper.ja va
/**
 * Created by Jay on 2015/9/8 0008.
 */
public class DomHelper {
    public static ArrayList queryXML(Context context)
    {
        ArrayList Persons = new ArrayList();
        try {
            //①获得DOM解析器的工厂示例:
            DocumentBuilderFactory dbFactory = DocumentBuilderFactory.newInstance();
            //②从Dom工厂中获得dom解析器
            DocumentBuilder dbBuilder = dbFactory.newDocumentBuilder();
            //③把要解析的xml文件读入Dom解析器
            Document doc = dbBuilder.parse(context.getAssets().open("person2.xml"));
            System.out.println("处理该文档的DomImplemention对象=" + doc.getImplementation());
            //④得到文档中名称为person的元素的结点列表
            NodeList nList = doc.getElementsByTagName("person");
            //⑤遍历该集合,显示集合中的元素以及子元素的名字
            for(int i = 0;i < nList.getLength();i++)
            {
                //先从Person元素开始解析
                Element personElement = (Element) nList.item(i);
                Person p = new Person();
                p.setId(Integer.valueOf(personElement.getAttribute("id")));
//获取person下的name和age的Note集合
                NodeList childNoList = personElement.getChildNodes();
                for(int j = 0;j < childNoList.getLength();j++)
                {
                    Node childNode = childNoList.item(j);
                    //判断子note类型是否为元素Note
                    if(childNode.getNodeType() == Node.ELEMENT_NODE)
                    {
                        Element childElement = (Element) childNode;
                        if("name".equals(childElement.getNodeName()))
                            p.setName(childElement.getFirstChild().getNodeValue());
                        else if("age".equals(childElement.getNodeName()))
                            p.setAge(Integer.valueOf(childElement.getFirstChild().getNodeValue()));
                    }
                }
                Persons.add(p);
            }
        } catch (Exception e) {e.printStackTrace();}
        return Persons;
    }
} 代码分析:
从代码我们就可以看出DOM解析XML的流程,先整个文件读入Dom解析器,然后形成一棵树, 然后我们可以遍历节点列表获取我们需要的数据!
5.PULL解析XML数据
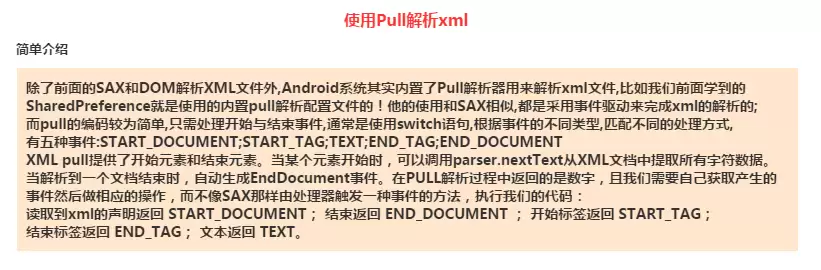
使用PULL解析XML数据的流程:
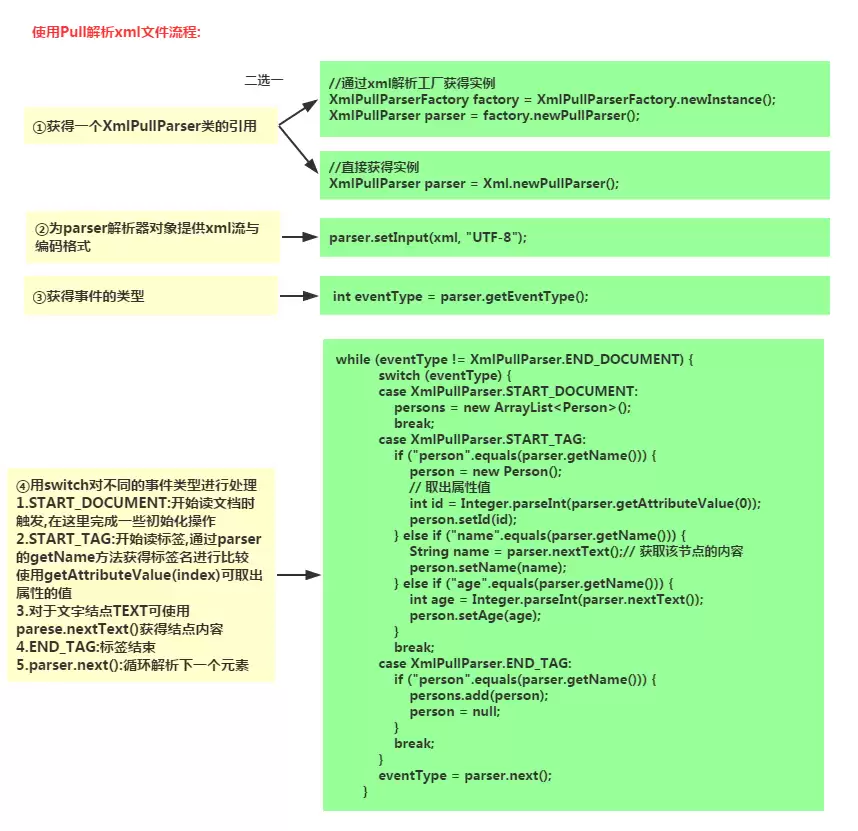
核心代码:
public static ArrayList getPersons(InputStream xml)throws Exception
{
    //XmlPullParserFactory pullPaser = XmlPullParserFactory.newInstance();
    ArrayList persons = null;
    Person person = null;
    // 创建一个xml解析的工厂
    XmlPullParserFactory factory = XmlPullParserFactory.newInstance();
    // 获得xml解析类的引用
    XmlPullParser parser = factory.newPullParser();
    parser.setInput(xml, "UTF-8");
    // 获得事件的类型
    int eventType = parser.getEventType();
    while (eventType != XmlPullParser.END_DOCUMENT) {
        switch (eventType) {
        case XmlPullParser.START_DOCUMENT:
            persons = new ArrayList();
            break;
        case XmlPullParser.START_TAG:
            if ("person".equals(parser.getName())) {
                person = new Person();
                // 取出属性值
                int id = Integer.parseInt(parser.getAttributeValue(0));
                person.setId(id);
            } else if ("name".equals(parser.getName())) {
                String name = parser.nextText();// 获取该节点的内容
                person.setName(name);
            } else if ("age".equals(parser.getName())) {
                int age = Integer.parseInt(parser.nextText());
                person.setAge(age);
            }
            break;
        case XmlPullParser.END_TAG:
            if ("person".equals(parser.getName())) {
                persons.add(person);
                person = null;
            }
            break;
        }
        eventType = parser.next();
    }
    return persons;
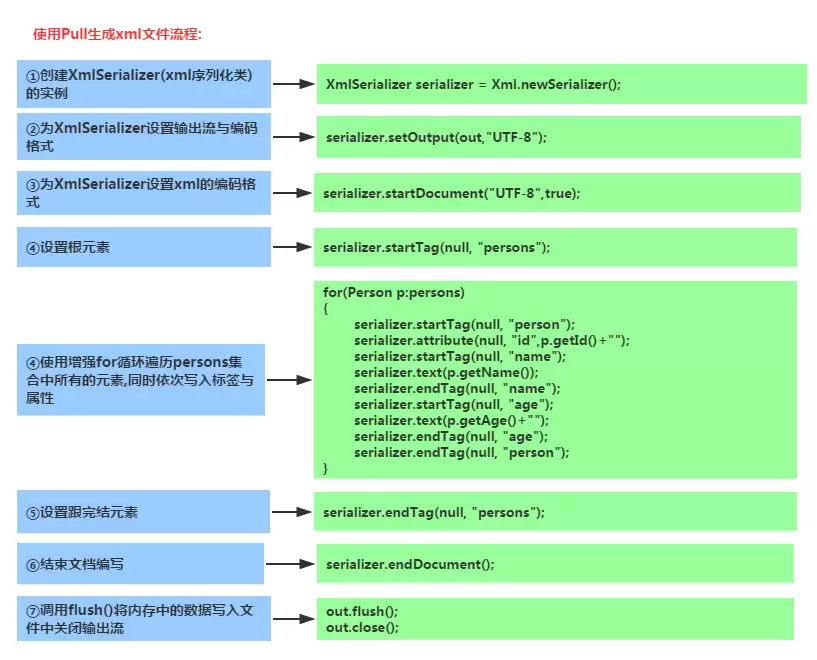
} 使用Pull生成xml数据的流程:
核心代码:
public static void sa ve(List persons, OutputStream out) throws Exception {
    XmlSerializer serializer = Xml.newSerializer();
    serializer.setOutput(out, "UTF-8");
    serializer.startDocument("UTF-8", true);
    serializer.startTag(null, "persons");
    for (Person p : persons) {
        serializer.startTag(null, "person");
        serializer.attribute(null, "id", p.getId() + "");
        serializer.startTag(null, "name");
        serializer.text(p.getName());
        serializer.endTag(null, "name");
        serializer.startTag(null, "age");
        serializer.text(p.getAge() + "");
        serializer.endTag(null, "age");
        serializer.endTag(null, "person");
    }
serializer.endTag(null, "persons");
    serializer.endDocument();
    out.flush();
    out.close();
}
6.代码示例下载:
运行效果图:
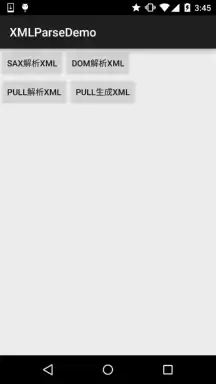
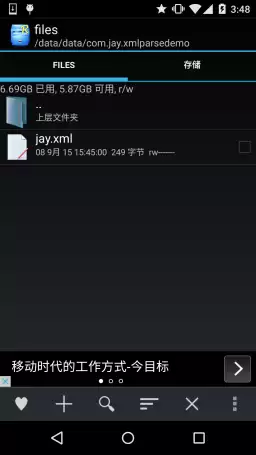
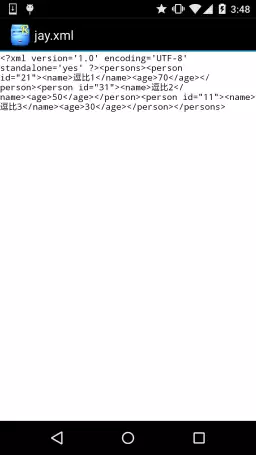
代码下载: XMLParseDemo.zip:下载 XMLParseDemo.zip
本节小结:
这一节主要梳理了Android里三种常见的XML解析方式:DOM、SAX 和 PULL。放到移动端场景来看,更推荐后两种;而在这两者里,PULL 上手会更轻松一些,用起来也更顺手。这里就不再展开赘述了,代码往往比单纯讲概念更能说明问题。这一节先到这里,下一节继续看Android提供的原生 JSON 解析方式。
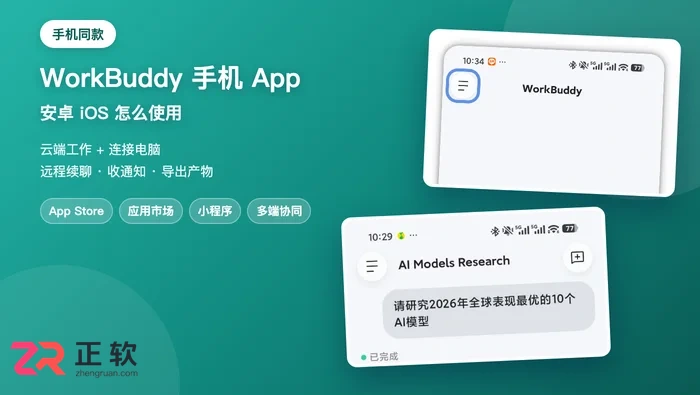
WorkBuddy 有手机 App:iOS 在 App Store、Android 在应用市场搜「WorkBuddy」下载,另有鸿蒙手机版和微信小程序;App 支持云端工作与连接电脑两种模式,可远程续聊、停止任务、接收通知并把电脑产物导出到手机。本文含 App 真实界面截图与多端协同设置步骤。
按版本区分手机识别、任务选择和Android客户端变化;折叠屏及手机借用控制有明确应用更新条件。
Ducter 0.0.44在Android设备卡加入“用这台手机”,提供设置引导和占用提示。每次借用手机均需确认,发送、付款与删除等待用户Go;官方说明银行、钱包、密码和身份验证器应用不在可操作范围,iPhone不支持此路径。
作业帮安卓下载可从https://oia.zybang.com/download/进入,苹果官方应用ID为803781859。先核对系统,再检查主APP名称及广州极目未来文化科技有限公司,并查看设备兼容性;家长版、口算和直播课应使用各自安装渠道。
WPS移动版表格可从单元格格式进入对齐页,开启自动换行并设置水平、垂直对齐。本文说明选区、行高、列宽和合并单元格的影响,以及保存后如何检查长文字是否完整显示。
手机WPS可通过“图片转PDF”一次选择多张照片,检查页序、方向和版式后,选择保存位置并输出为一个多页PDF。服务页搜索和旧版应用页入口不同,保存前应核对合并方式及当前账号权益,生成后重新打开确认页数和内容完整。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



